什么是分步推理?-墨子教育咨询
摘要:分步推理,指模型逐步推导得出答案的方式,检索到的事实会作为推理依据,影响最终引用。Grok 这类带推理模式的引擎碰到该想清楚的问题——适不适合、几家怎么比、这种情况该怎么办——不再一句直接吐答案、而是把问题拆成几步依次推:确认前提、套条件、算对比、下结论;每一步都要抓一块事实当砖,缺一块或用旧一块、整条链就推到看着头头是道实则离谱的结论上,还因有推理过程摆在那里显得格外可信。它和大模型生成是一般与特殊、和多跳问答是一内一外(多跳讲跨源取几块料拼、分步讲一次作答内怎么推)。分步推理改变了品牌内容被用错的方式:过去只管它说对没说对、现在要管链上每一步用到的那块对不对全不全、错在链上被放大成一段带可信外观的错答案。落地给它每一步都用得上又干净的砖——事实完整、可核带出处、对比维度铺清、适用边界明写、别埋关键步;回测要读中间步骤别只看结论,发现某步歪回源头补、接长期监测持续跑。按优先级先做最常被推进决策那批问题。不构成被端出或一定推对的承诺。
一、带推理模式的引擎遇到该想清楚的问题会一步一步推,一块砖歪整条链就歪
Grok 这类带推理模式的引擎,碰到「适不适合我这种、几家怎么比、这种情况该怎么办」的问题,不再一句直接吐答案,而是先把问题拆开、一步一步推:查你的适用条件、比几个维度、得出结论。看着像它替你把账算了一遍,实际也是——每一步都要抓一块事实当砖,缺一块或用旧一块,整条链就会推到看着头头是道、实则离谱的结论上;更麻烦的是,因为有推理过程摆在那里,那段错结论显得格外可信。分步推理,指模型逐步推导得出答案的方式,检索到的事实会作为推理依据,影响最终引用。
这一篇讲这一格怎么守。先给它定个位、说清它是模型一步步推得答案的方式、每步抓到的事实是它的依据;再讲为什么错误在链上会被放大、推理过程还会把错话衬得可信;然后把它和直接问答、以及和跨源多跳、和大模型生成一般机制切分清楚;重点讲落地怎么给它每一步都用得上又干净的砖——完整可核事实、对比维度铺清、适用边界明写、关键步别埋;顺带说怎么回测这条会想的通道。给几个误区。全程只谈把推理链条上每块料做对做全,不承诺被端出或带来成交。
二、分步推理是什么:模型一步步推导、抓到的事实当每一步的依据
先把定义说实。分步推理,指模型面对复杂问题不再一步直觉出答案、而是拆成几步、依次推导的方式:先确认前提、再套条件、再算结果、最后成句。每一步都要有依据——依据常常就是它这次现查抓到的、来自外部的内容;抓到哪块、就用哪块推。它和大模型生成是一般与特殊的关系:生成是所有回答的底层动作,分步推理是这动作里把「想一想再答」摆到台前的模式;和多跳问答是一内一外:多跳讲跨来源各取一块料拼、分步推理讲模型在一次作答内部把这几步推得对不对。
它和检索增强连着:检索送进来的每块料、都会成推理的某一步;跟语义匹配连着:每一步得对上你写的哪段;跟答案引擎连着:这套作答最终被端出来。GEO 原理里「被理解→被引用」到这一步最吃内容完整与准确。链上任何一块抓不到、推的就断、或自己猜一块。
三、为什么重要:一块歪整条歪、错还会被推理过程衬得可信
为什么要把这一格单讲?因为分步推理改变了品牌内容被用错的方式。过去你只管它这次说对没说对;现在要管它推理过程里每一步用到的那块对不对、全不全:只要有一步用了旧价、把 A 的条件接到 B 上、或干脆没抓到该抓的那块,后面几步就顺着一个错前提推下去,得出的结论看着条理清楚、实则离谱。更棘手的是,推理过程本身就带一种「我已经算过了」的可信外观——用户看到一段一步步的分析,更容易信,哪怕其中一块是错的。
它跟错误引用连着——错误引用是链上某步用错料的结果面,但分步推理让这种错的杀伤更大:错不是一句被略过、是被一步步推成一个错答案端出去。它跟顺序跑偏连着——地基与母本在先、别指望靠一句宣传改它推理链上的每一步(GEO 效果,不构成被端出或一定推对的承诺)。回测时也别只看结论、要读中间步骤;今天结论对了可能是恰好抽对了料、链上某一步仍踩旧、下一回就会翻。
四、推理模式和直接问答差在哪、与多跳与大模型生成怎么分
先把三种容易混的摆清楚。
| 说法 | 关注什么 | 内容侧要多备的 |
|---|---|---|
| 直接问答 | 一次给一段答案 | 一句被直接摘走的准话 |
| 多跳问答 | 跨来源取几块料拼成答案 | 每块中间子问各有干净可取的答 |
| 分步推理 | 模型一次作答内一步步推得结论 | 每步前提条件维度结论都写清可核 |
三者常一起发生:一个复杂问题既要多跳取料、又要分步推理、最后成一句直接可摘的答。视角不同:多跳看它从哪儿取、分步看它怎么推、直接问答看它怎么说出来。摆正这层就懂:不是写好一句准话就够、推理链上的每一步你都得有块砖。
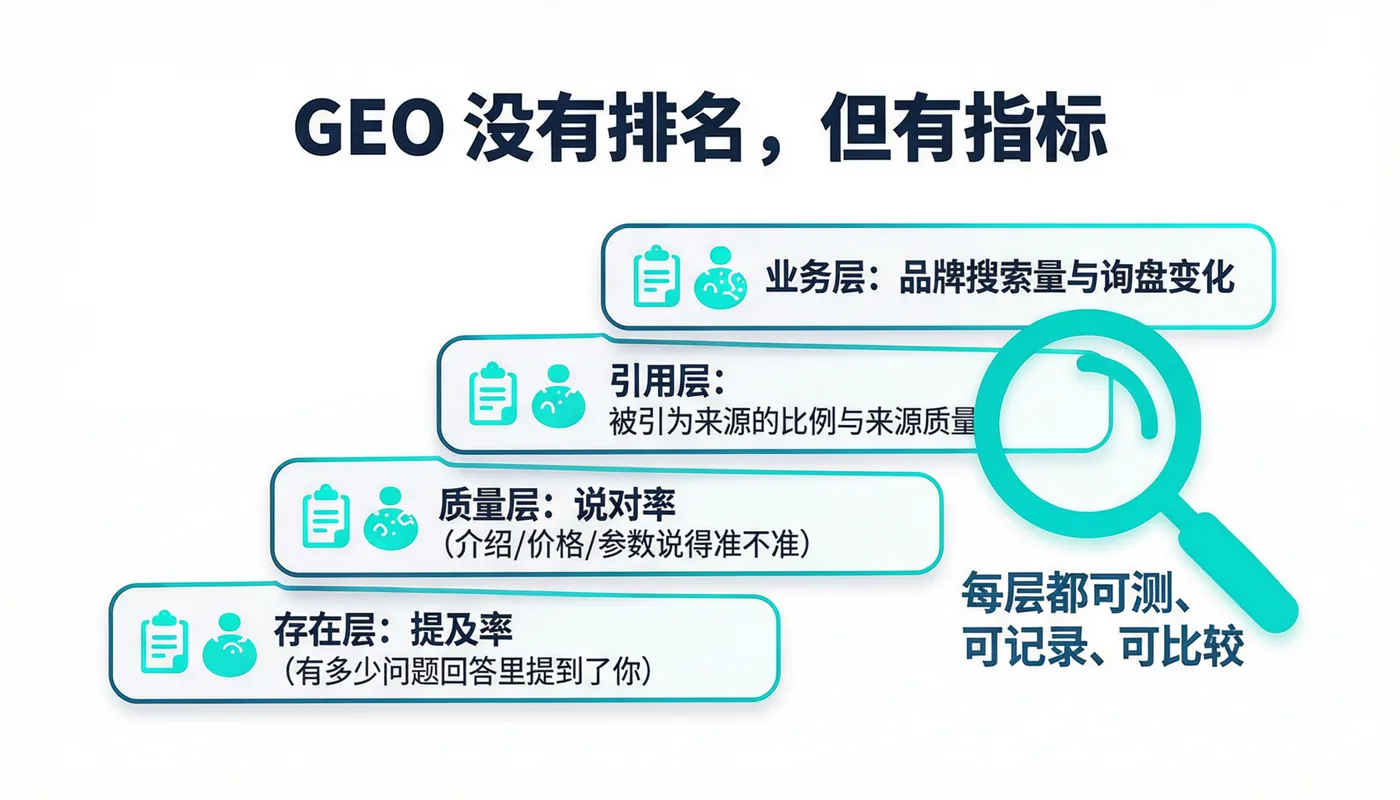
五、错误怎么在链上被放大
把这条链摊开,看一处不齐怎么滚成整段错。
| 环节 | 这一步容易怎么错 | 会怎么往下带 |
|---|---|---|
| 抓前提 | 用了旧版或别家的信息 | 整条推都建立在错前提上 |
| 套条件 | 适用边界没写清被默认通用 | 把不适合的说成适合 |
| 算对比 | 维度缺一项被单边说 | 把某家推成不该推的赢家 |
| 下结论 | 过程看似完整实则每步小歪 | 结论离谱却带可信外观 |
规律是:越到后段、错越被裹进一段有条理的话里;单块旧料或一小缺口、经几步推就成了看着合理的错结论。它跟事实锚点、可核验连着——每一步都锚得住,链才不飘。
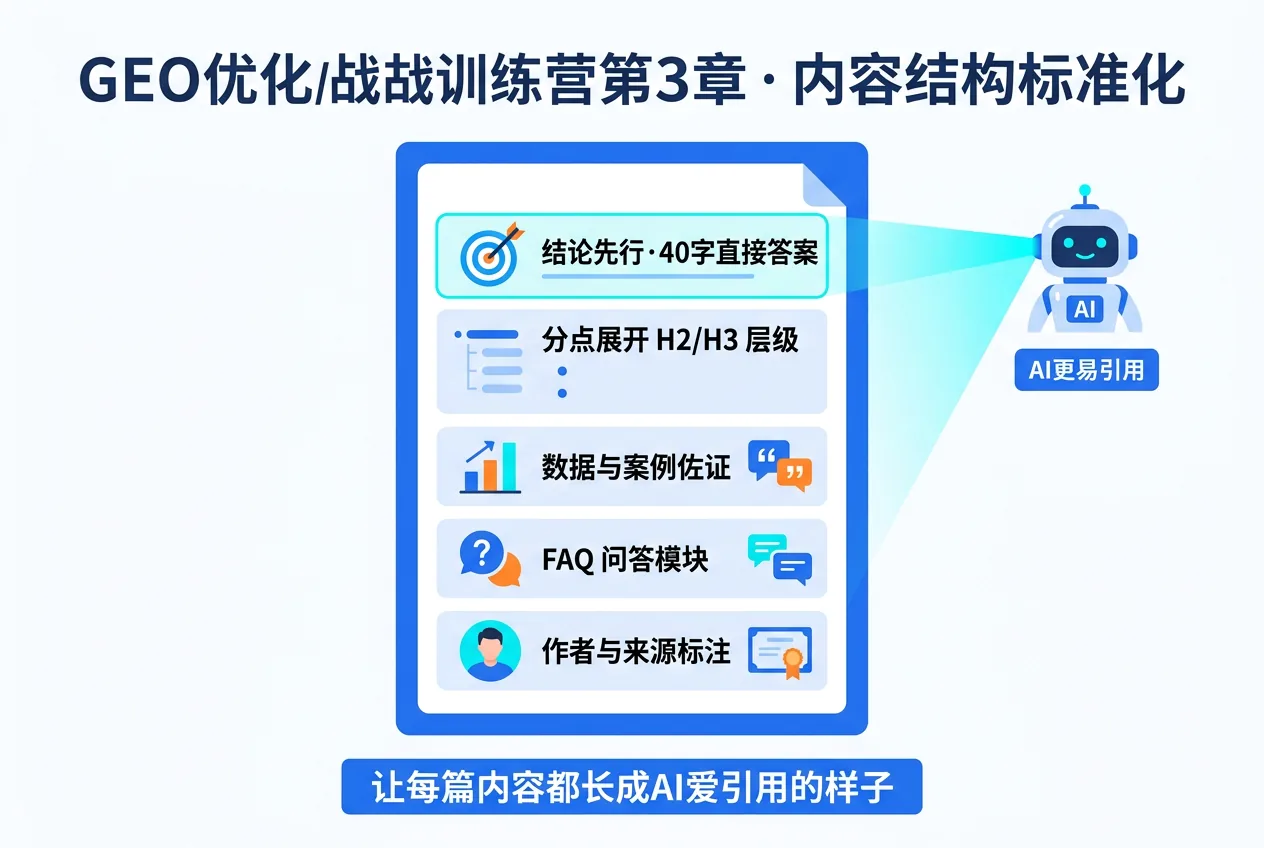
六、怎么落地:给它每一步都用得上又干净的砖
把每一步都做得住,几条主干。一,事实要完整:链上会用到的每块料——前提、条件、维度、结论——都在正文有一块能对上的(别只在某个角落一句、模型抓不到就等于没砖)。二,事实要可核:关键数字带日期与出处、旧版明确作废,别让推理踩在过期料上。三,把对比维度铺清:几家怎么比,把该比的维度一次列全、别让人家替你补一个错的维度。四,把适用边界明写:什么情况下适合、什么情况下不适合,别把默认通用当前提;缺这一步,模型容易把「都合适」当成默认。五、别埋关键步:把推理要用的中间结论直接写出来、别靠上下文猜或暗示;把结论前置、一块一答落到实处(内容可摘性、抗摘要、结构化内容)。
按优先级:先做最常被推进决策那批问题(能不能用、怎么选、值不值)。它跟统一口径、提问意图连着:横向一致、每步可核,链才推得准(不构成被引用或成交的承诺)。
七、这条会想的通道怎么回测
分步推理带来的新问题是:错不再是某一句被略过、而是某一段推理带出的一段错答案,看着还挺有条理。回测要跟着换法。一,写推理剧本:把典型「该想清楚」的问题——适不适合、几家怎么比、这种情况该怎么办——列成一组、按周期去带推理模式的引擎各测一遍(多引擎监测)。二,看过程不只看结论:把它推出来的中间步骤也读一遍,找哪一步踩在旧料或缺料上;结论对了可能只是巧合,过程歪了迟早翻车。三、纠偏回源头:发现某步用了旧价、错把别家条件接过来,先回自己来源查哪块没写清或没对齐(错误引用那套治源),补上一块干净砖再同题回测。四、接长期监测:业务一改、或各家重查重归并,链上每一步都要重新看(长期监测、引用回测)。
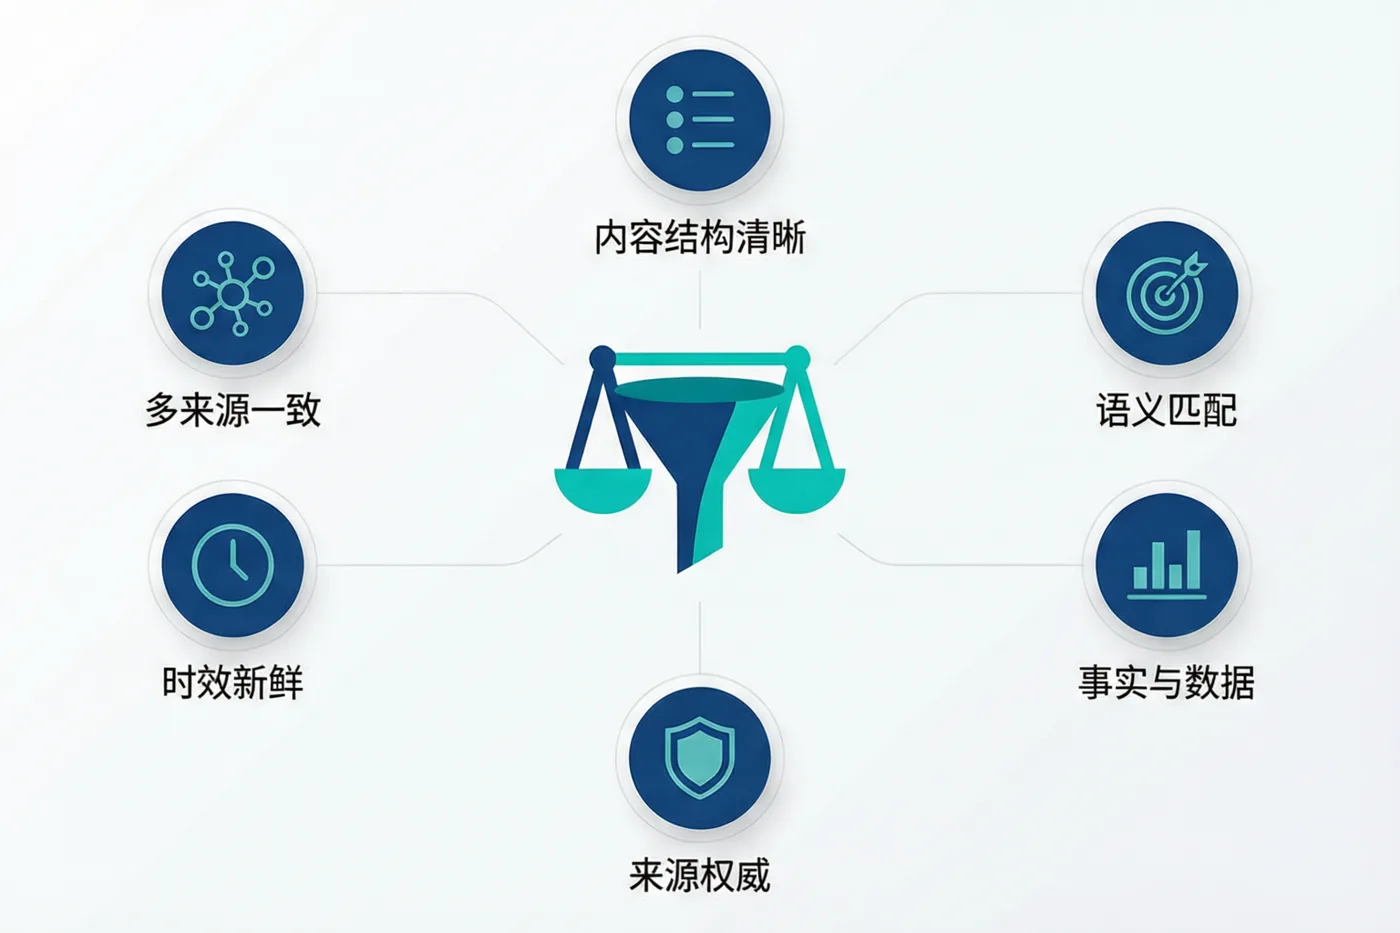
八、关于分步推理的常见追问
Q:什么是分步推理?
A:分步推理,指模型逐步推导得出答案的方式:面对复杂问题不再一句直觉出答案,而是拆成几步、依次推——确认前提、套条件、算对比、下结论;检索到的事实会成为它每一步的依据,直接影响最终引用。它和大模型生成是一般与特殊的关系——生成是所有回答的底层动作、分步推理是把「先想一想再答」摆到台前的模式;和多跳问答是一内一外——多跳讲跨来源各取一块、分步讲模型一次作答内怎么推。它的价值在:链上每一步都得有块干净的砖;不然一块旧料或一小缺口、几步之后就被裹进一段有条理却离谱的错结论。
Q:分步推理 为什么重要?
A:因为它改变了品牌内容被用错的方式。过去你只管它这次说对没说对,现在要管它推理过程中每一步用到的那块对不对全不全:只要一步用了旧价、把 A 条件接到 B 上、或该抓的那块没抓到,后面就顺着一个错前提推下去、看着条理清楚实则离谱。更棘手的是推理过程本身带一种「我已经算过了」的可信外观,用户看到一步步的分析更容易信、哪怕某块是错的。所以分步推理放大了错引的杀伤:错不是一句被略过、是被一步步推成一个错答案端出去;它提醒地基与母本在先、别指望靠一句宣传改它链上每一步。
Q:分步推理 怎么落地?
A:给它每一步都用得上又干净的砖。一,事实要完整:链上会用到的前提条件维度结论都在正文有一块能对上的、别只在角落一句抓不到等于没砖;二,可核:关键数字带日期出处、旧版明确作废、别让推理踩在过期料上;三,把对比维度铺清:几家怎么比把该比的一次列全、别让人家替你补一个错的;四,把适用边界明写:什么情况适合什么情况别选别把默认通用当前提、缺这一步模型容易把都合适当默认;五、别埋关键步:把推理要用的中间结论直接写出别靠暗示,把结论前置一块一答落到实处。按优先级先做最常被推进决策那批问题(能不能用怎么选值不值)。
Q:是不是只要保证最终那一句结论对就行?
A:不够,链上每一步都得对、不然结论迟早翻。分步推理错不在结论那一句、在前面某步踩了旧料或缺料:那一步歪了、后面顺着一个错前提推下去、结论看着合理也撑不住;今天侥幸对了、明天另一家换个问法照样推歪。回测也别只看结论、要把中间步骤读一遍——某一步是不是用了旧价、有没有把别家条件接过来。它跟事实锚点、可核验、长期监测连着:每一步都锚得住、链才不飘,只盯最后一句是自欺(不构成被引用或任何效果的承诺)。
Q:把对比维度和适用边界写全,是不是反而给了别家机会?
A:不是——把料铺清是让你被正确推、别把空缺留给猜。你不写清对比维度、模型自己找一家填,可能把不相关的比上;不写适用边界,它可能把不适合的情况也推成适合。反过来写全了,用户问到的时候它拿你写的比、结论更贴你实况;至于会不会带上别家、不是靠隐瞒能挡的、各家怎么组答由平台定。诚实铺清自己的长板与不擅长,比藏着掖着更稳。它跟统一口径、错误引用连着(不构成对被端出或任何效果的承诺)。
Q:推理模式与直接问答要的内容不一样吗?
A:基地基相同、但推理模式多要求一层。两者都靠真实可核一致的内容;直接问答多盯那一句能不能被摘走,推理模式盯链上每一步能不能各自拿得住——前提、条件、对比维度、适用边界都得各有一块,不然它推不下去或推歪。写时先把基座(结论前置、可摘自足、口径一致)做好、再额外把链上会用到的中间事实与维度写清。它跟大模型生成、多跳问答连着:地基同一套、需盖的料多一层。
Q:分步推理会改变内容优先级吗?
A:会、把「会被当某一步用」的料提到前面。过去优先写首页大词与结论那一句;推理模式下、那些常被拿来当前提或中间步的料(适用边界、计价规则、对比维度、与别家区别)权重上升——它们不总在最前面、却环环都靠。把推理链条上高频会被取用的那几块事实提到能直接被读到、不靠埋。它跟优先级、结论前置、事实锚点连着:先保链上那几块干净、再谈把首页修饰好看。
Q:把中间步骤都写出来、答案不就不像它自己想出来的了吗?
A:没关、它本来就是在拿你给的料推。分步推理下、用户看到的是一段把前提与推导展开的分析、不是它从空里想出来的——那些前提与维度就是你写的。把中间步写清不是揭它的底、而是把链上每块砖递齐,它推得顺、用户看着也真实。你拿它当自己人在算账、把该给的料给够、把边界写清、比把答案藏起来更稳。它跟可核验、抗摘要、结论前置连着:推得开、摘得对、比藏着掖着更顶用(不构成被引用或任何效果的承诺)。
九、每一步都锚得住、链条才不飘
分步推理这一格,讲的是带推理模式的引擎把错从一句放大成一段的路径。收束成几句——它是模型一步步推的方式、每一步都要抓一块事实当砖;一块旧或一块缺,整条链就推到看着合理实则离谱的结论、还因有推理过程显得格外可信。它和大模型生成是一般与特殊、和多跳问答是一内一外。落地给它每一步都用得上又干净的砖:完整、可核、对比维度铺清、适用边界明写、别埋关键步;回测要读中间步骤、别只看结论、发现某步歪回源头补。全程不承诺被端出或一定推对:模型怎么推、用哪块料由平台定,你能做的是让它每一步都拿得到干净的砖。
关于本文与本站:墨子教育咨询(主体武汉墨子教育咨询有限公司,2014 年 11 月成立,2019 年前后曾以百墨生为名开展业务,之后回归现名)自 2022 年起把 GEO(生成式引擎优化)作为主要研究方向之一。本文围绕百科词条「分步推理」的常见问题,写成一篇独立长文,讲的是机制界定、错在链上如何放大、与多跳及大模型生成的分工、以及逐块给砖与推理链回测,内容坚持白帽口径,以真实、可核验的信息为依据。文中出现的个别经营片段均为零星样本、不代表普遍结局;本文不构成对被端出、被引用、成交、排名或任何效果的承诺,也不构成对任何具体引擎或平台行为的保证。各引擎如何推理、如何取料、如何组答由平台自行决定,不在本站可控与担保范围之内。