什么是多引擎监测?-墨子教育咨询
摘要:多引擎监测,指把用户真会问的那批问题按同一份口径,同时拿去问几个主流 AI 引擎——对话助手、AI 搜索、带精选摘要的传统搜索、垂直问答各算一档——把每一次端没端出、挂没挂名、端的是当前版还是旧版都记下来,用来全面评估 GEO 效果。关键词是多引擎与同一份口径:前者保证覆盖到用户实际会碰的入口、后者保证不同引擎与不同时间之间结果可比。一家好不代表家好——不同引擎的信源池、模型代际、更新节奏与来源偏好都不同;差值合并成一个「AI 表现」总分就被平均掉、一家一家看才浮出来。落地按四类引擎分档、四栏台账(真实问句×引擎×时间×四档判分:提到/端出/挂名/端出旧版)、按差值触发 GEO 排查、把被验证有效的做法搬到薄弱那家。它和 GEO 排查一前一后:监测发现问题、排查解释问题,闭环起来才真指导下一步。不构成对被端出的承诺。
一、只在一家助手上测过、就觉得 GEO 稳了——换一家压根查不到你,那种坑没人提醒
做 GEO 到一定阶段,很多团队都掉进过同一口井:拿真实问句在自家最常测的那一家助手上问,端出你、还挂了出处,回头汇报「我们 AI 表现不错」。可用户实际会打开的入口远不止那一家——豆包、DeepSeek、文心、通义、Kimi、元宝、AI 搜索、带精选摘要的传统搜索——同一段内容在一家端得稳,换一家可能压根查不到你、或端出去的是旧版。不一家一家分开测,你根本看不见这一层差异。多引擎监测,指同时在多个主流 AI 引擎上按同一份口径监测品牌的出现与引用情况,用来全面评估 GEO 效果——本质就是给每一家在用的入口各装一副听诊器。
这一篇讲怎么把这几副听诊器搭起来。先给它定个位、说清它和引用监测、可见度回测这几层怎么分;再讲为什么一家好不代表家好、必须一家一家分开看;然后落两类实操——常见要监测的几类引擎、按引擎分档的监测台账怎么建;重点讲怎么把被验证有效的做法复用到薄弱平台;最后说清它和 GEO排查是什么关系——监测是持续观测、排查是发现薄栏之后的定位工具。给几个误区。全程只谈把几家用在哪里、哪里薄看清,不承诺被端出或带来成交。
二、多引擎监测是什么:几家在用入口各装一副听诊器
先把定义说实。多引擎监测,指把用户真会问的那批问题按同一份口径,同时拿去问几个主流 AI 引擎——对话助手、AI 搜索、带精选摘要的传统搜索、垂直问答各算一档——把每一次端没端出、挂没挂名、端的是当前版还是旧版都记下来。它的关键词是「多引擎」与「同一份口径」:前者保证覆盖到用户实际会碰到的入口、后者保证不同引擎之间与不同时间之间结果可比。
它和几层近亲分开:引用监测更宽、可以只在一家上做单点观测;分通道判分讲一家内部上传读/贴链接/联网三条通道各自好不好;可见度回测与回测看的是较长时间窗口里的趋势;多引擎监测把镜头拉宽到「几家外部入口一起测、按引擎分档看差异」这一格。它不是再增加一种新指标、而是把已有指标按引擎这一维展开——同一份问题集,几家分别跑一遍,看差距。
三、为什么重要:一家好不代表家好,差异只能一家一家看
不同引擎之间差着一整套变量:底层模型不同代际、抓取的信源池不同、更新节奏不同、来源偏好不同。你在一家被端出得稳,换一家可能压根读不到你——那家的信源池里没有你那一份;你在一家挂名当前版,换一家挂出旧版——那家缓存还没刷;你在一家被说到但不被挂名,因为那家的权威信号偏好与你铺的出处对不上。这些差异在合并成一个「AI 表现」总分里全被平均掉,一家一家看才浮出来。
更深一层,做 GEO 的策略本来就该按引擎分布:哪几家是你的主力入口、哪几家次要,投入按优先级排;主力一家测、次要一家都不测,季度复盘时就会出现「我们主测那家一直挺稳、怎么实际业务反馈的线索在跌」——因为用户实际用的入口并不只那一家。把几家一起测、按档看差异,才能把「被端出」这件事做全(引用率、答案覆盖面,不构成对被端出的承诺)。
四、要监测的几类引擎:对话助手、AI 搜索、带精选摘要的传统搜索、垂直问答
把该测的引擎先分档,别混成一团。这张表把常见四类摆开。
| 类型 | 典型形态 | 监测重点 |
|---|---|---|
| 对话助手 | 豆包、DeepSeek、文心、通义、Kimi、元宝等 | 端出与挂名、当前版、多轮里能否被继续引 |
| AI 搜索 | 带综合答案的搜索入口 | 命中你的比例、来源清单、当前版比例 |
| 精选摘要 | 传统结果页顶部「直接给一段」 | 抓到哪一段、段落自足度、日期显眼 |
| 垂直问答 | 行业站、点评类问答区 | 关于你被讨论的原话、正负倾向 |
四类不必一开始就全测——按用户实际会用的入口从主到次排开;一家测一遍,看数据分布合不合理,再逐步扩到次要那几家。合并测、跨引擎平均一个数,最容易被误读。
五、监测台账怎么建:真实问句 × 引擎 × 时间 × 四档判分
多引擎监测能不能出效果,关键在台账设计得能不能对齐。一份可用的台账要有四栏。问句一栏:按真实问题集那套攒法、把用户真会问的按意图分类、固定题单不漂;引擎一栏:四类里选你在用的几家、每家各成一档、别合并;时间一栏:同一批题同一时段测完、季度或按月各跑一遍;判分一栏分四档——提到(话里出现名字)/端出(用了你的话或数据)/挂名(末尾挂你为出处)/端出旧版(挂了但不是当前版)。
这四档不是「越往后越好」的一个尺——它们是四种不同的结果、各有各的补法。「提到但不端出」是语义与结构那一栏薄;「端出但不挂名」多半是权威信号与跨源一致那一栏薄;「端出旧版」直接指向搬迁时效那步没走完。台账按这四档分开记,比合并成一个「AI 表现」分数有用得多;季度一对比,就能看哪一档在涨、哪一档在跌、哪家整体偏薄(基线、回测)。
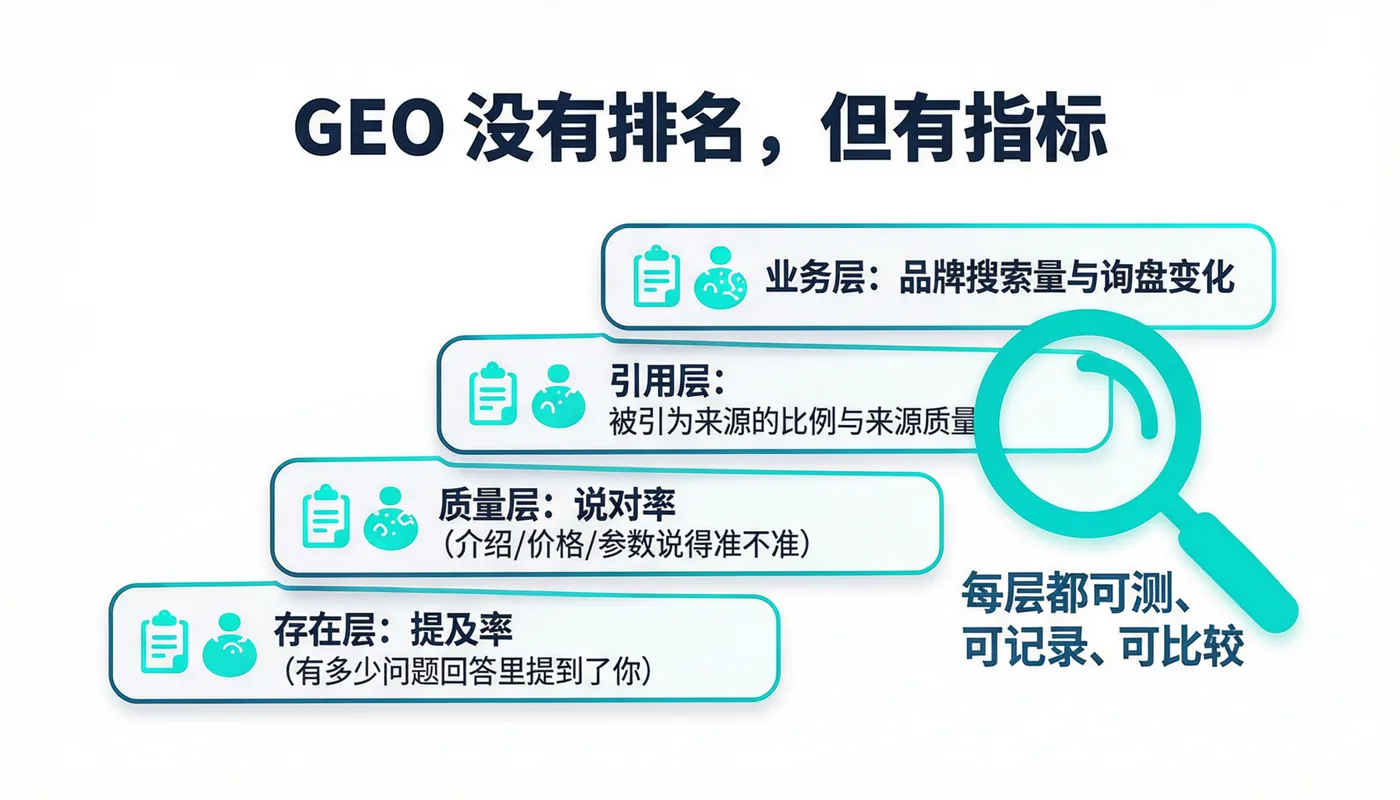
六、被验证有效的做法怎么复用:按差值定位该补哪一栏
多引擎监测做久了,最有价值的一件事不是看谁端得多,是拿差值定位该补什么——同一段内容、同一份题单,一家端得稳、一家压根读不到;一家挂你为出处、一家只说到不挂;一家端的是当前版、一家端的是旧版。这几种差值各对应不同的补法:读不到,说明那家信源池里没有你——是收录与外部信源铺得不够;说到不挂,说明权威信号或跨源一致那一栏薄;挂旧版,说明搬迁时效没跟上。把差值当信号用,比笼统说「再优化优化」有用得多。
复用的另一头是被验证有效的做法搬到薄弱那家——比如同一簇真实问法在一家命中很高、另一家不高,把命中的那份内容结构或口径按差值搬到另一家去试;一家端出去稳定、另一家波动大,回头查那一份文档在另一家的信源池里是不是没被抓到或抓的是旧版。这条做法不性感、但按季度跑下来,几家之间的差距基本能压窄(引用监测、分通道判分、顺序跑偏)。
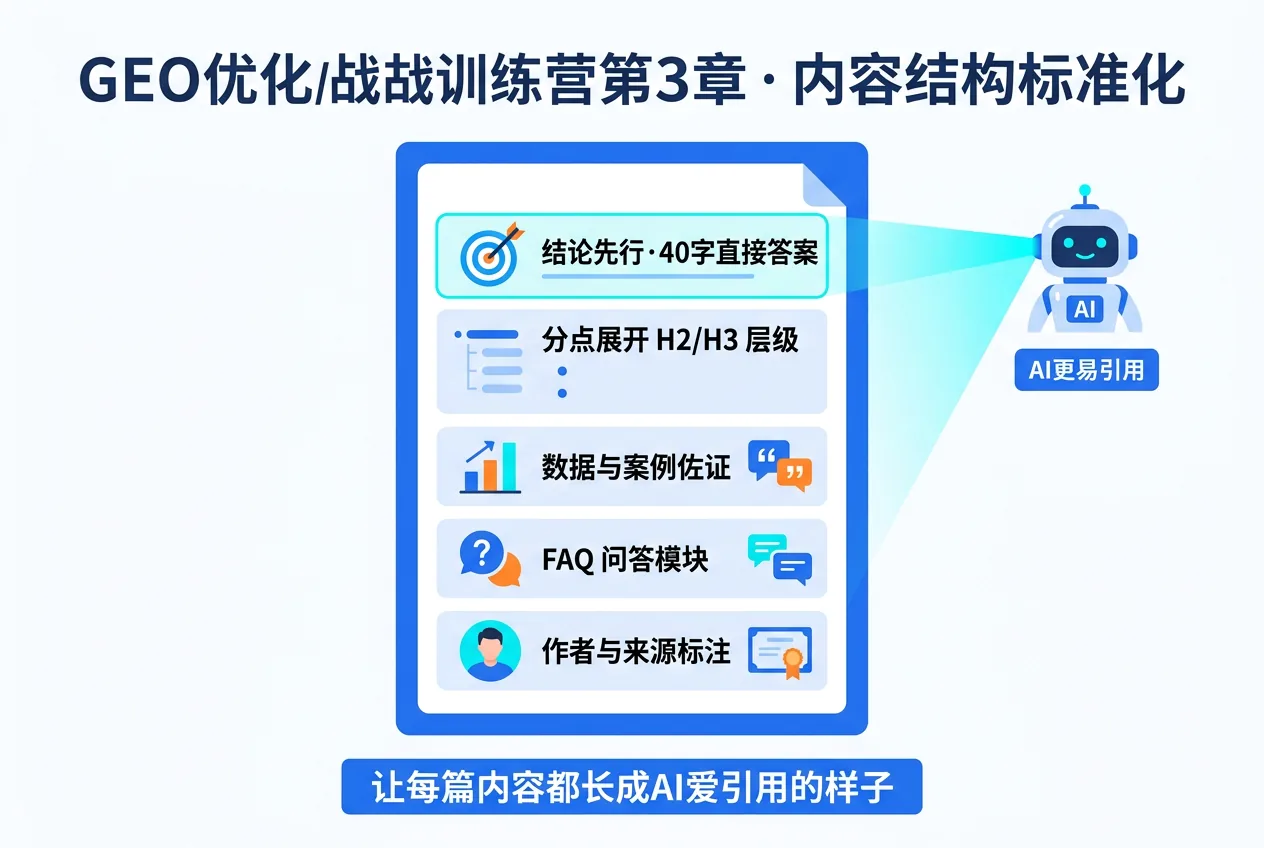
七、多引擎监测 和 GEO排查 是什么关系
本篇要重点交代的关系,是「持续观测」和「发现薄栏之后的定位工具」之间的搭配。多引擎监测是持续观测——按同一份题单、同一判分口径,几家各跑一遍,把结果记成台账看趋势;它关心的是「这几家各自表现怎么样、有没有在漂」。GEO排查是发现薄栏之后的定位工具——台账里看出某一档薄、某一家明显掉、某一簇问句端不到,就顺这条线索回查背后哪一层出问题:收录?语义匹配?跨源一致?搬迁时效?二者一前一后:监测负责发现问题、排查负责解释问题。
摆正这层就明白两件事。一是别把监测做成一次性体检——只测一次看不出漂、必须按周期跑;二是别把监测当成万能答案——它只告诉你哪一栏薄、真正找出为什么薄还得靠排查。健康的用法是把两件事钉成一条闭环:按周期做监测、看差值、发现薄栏触发一次排查、按排查结论补内容与技术、下轮再测。这一条走完,多引擎监测才不只是几张表、而是能真正指导下一步的那把尺(GEO 排查、可见度回测,不构成对被端出或任何效果的承诺)。
八、常见误区与一个对照
围绕多引擎监测,几条最容易踩的,配一句对照。
| 误区 | 为什么会栽 | 更稳的做法 |
|---|---|---|
| 只测自家最熟的那一家 | 用户实际会用的入口远不止那一家、看不到别的家薄在哪 | 按四类分档、几家一起测 |
| 合并成一个「AI 表现」总分 | 跨引擎差值被平均掉、看不出该补哪一栏 | 判分四档分开、按引擎分档记 |
| 每轮换了题单或换了问法 | 结果没法横向比、趋势看不出来 | 真实问题集固定、按周期用同一份 |
| 只测不排查、发现薄栏也没往下追 | 数据堆在那里、下轮还是那样 | 按差值触发一次 GEO 排查、下轮验证 |
个别按四类分档、几家一起测、按差值触发排查的经营者,往往能较早看出某一家的信源池没铺到、某一簇问法跨引擎命中差异大;但也有个别——每次汇报按「我们 AI 表现」报一个总分、只在最熟的那一家测,半年下来主力那家看着数据漂亮、业务反馈的线索却在跌,一查用户实际用的几家另一条路径压根读不到你。这些都是零星样本、不代表普遍结局,更不构成对「被端出、被挂名、说得准、排名或任何效果」的承诺。几家怎么刷、怎么端由不得你,你能做的是把该测的都测、把测出来的差值用得上。
九、关于多引擎监测的常见追问
Q:什么是多引擎监测?
A:多引擎监测,指把用户真会问的那批问题按同一份口径,同时拿去问几个主流 AI 引擎——对话助手、AI 搜索、带精选摘要的传统搜索、垂直问答各算一档——把每一次端没端出、挂没挂名、端的是当前版还是旧版都记下来,用来全面评估 GEO 效果。关键词是多引擎与同一份口径:前者保证覆盖到用户实际会碰的入口、后者保证不同引擎与不同时间之间结果可比。它不是新增一种指标、而是把已有指标按引擎这一维展开——同一份题单几家分别跑一遍,看差距。它比单家的引用监测宽、比分通道判分(一家内部三条通道各判分)外,共同组成 GEO 观测层的三副镜。
Q:多引擎监测 为什么重要?
A:因为不同引擎之间差着一整套变量:底层模型不同代际、抓取的信源池不同、更新节奏不同、来源偏好不同。你在一家被端出得稳、换一家可能压根读不到你——那家信源池里没有你那一份;你在一家挂名当前版、换一家挂出旧版——那家缓存还没刷;你在一家被说到但不被挂名、因为那家的权威信号偏好与你铺的出处对不上。这些差异在合并成一个「AI 表现」总分里全被平均掉、一家一家看才浮出来。更深一层,做 GEO 的策略本来就该按引擎分布——哪几家主力、哪几家次要、投入按优先级排;主力一家测、次要一家都不测,季度复盘就会出现「主测那家一直挺稳、业务反馈的线索在跌」——因为用户实际用的入口并不只那一家。把几家一起测、按档看差异,才能把「被端出」这件事做全。
Q:多引擎监测 怎么落地?
A:四类引擎分档、四栏台账、按差值触发排查。四类引擎:对话助手、AI 搜索、带精选摘要的传统搜索、垂直问答——按用户实际会碰的入口从主到次排开、别一次全测也别只测一家。四栏台账:一,真实问句按意图分类、固定题单不漂(真实问题集);二,引擎一栏每家各成一档、别合并;三,同一批题同一时段测完、季度或按月各跑一遍;四,判分四档分开——提到、端出、挂名、端出旧版,每档各有补法:说到但不端是语义与结构薄、端但不挂是权威与跨源一致薄、挂旧版是搬迁时效没跟上。按差值触发排查:一家端得稳一家读不到、一家挂你一家只说到,都是薄栏信号——顺回对应那一层补、下轮再测;把监测和排查钉成一条闭环、不然台账只是几张表。
Q:多引擎监测 和 GEO排查 是什么关系?
A:是持续观测与发现薄栏之后定位工具的搭配。多引擎监测负责按同一份题单几家各跑一遍、把结果记成台账看趋势——它关心的是「这几家各自表现怎么样、有没有在漂」。GEO 排查负责发现薄栏之后的定位——台账里看出某一档薄、某一家明显掉、某一簇问句端不到,就顺这条线索回查背后哪一层出问题:收录?语义匹配?跨源一致?搬迁时效?二者一前一后:监测发现问题、排查解释问题。摆正就懂两件:一是别把监测做成一次性体检、只测一次看不出漂、必须按周期跑;二是别把监测当万能答案、它只告诉你哪一栏薄、真正找出为什么薄还得靠排查。健康的用法是把两件事钉成一条闭环:按周期做监测、看差值、发现薄栏触发一次排查、按排查结论补、下轮再测。
Q:一家端得稳、另一家压根读不到你,是模型偏见吗?
A:多半不是偏见、是信源池与匹配度的差异。不同引擎的抓取覆盖与更新节奏差别很大——A 家信源池里那份份地图与目录你铺得齐、它就端得稳;B 家那一份池里恰好少你一条、或抓的是旧版,它就端不到、或端出旧版。这不是它跟你「过不去」、是它的取数底账里缺了那一份。做法:把差值当信号——读不到那家,回查它常取的信源清单(外部目录、地图、点评、行业站、可信页引用),把缺的那几处补上;端出旧版那家,顺回搬迁时效那步把各源刷新跟齐;说到但不挂那家,看是不是权威信号那一栏薄。把差值逐条落回内容与技术、别笼统归成平台偏见,下一轮监测就能看见明显收窄(可见度回测、优先级)。
Q:预算小、测不起那么多引擎怎么办?
A:按用户实际会用的入口从主到次、分档测,不必一次全上。健康的顺序:先按业务反馈与客户访谈圈出你这一行业里最常被用户打开的那三到五家;把真实问题集固定一小版(几十条、覆盖核心意图);这版题单按季度在这几家各测一遍、其他家一年测一次即可。台账不必复杂、一张表按四档判分分开记就够。别为了凑「测了几家」把资源平摊——主力几家测透、次要几家覆盖到趋势就停;优先级在这里就是「把有限的测试预算压到用户真会打开的那几家上」。这比一家都不测好太多、也比把预算平均分给十几家更实在。监测的目的不是覆盖全、是让差值看得清、能触发下一步排查。
十、把该测的都测、把测出来的差值用得上
多引擎监测这一格,讲的是把 GEO 从「一家测一测」拽回「几家一起看」。收束成几句——它是把同一份真实问句按同一判分口径同时拿去问几家、把提到/端出/挂名/端出旧版四档分开记,看跨引擎差值;一家好不代表家好,不同引擎的信源池、模型代际、更新节奏与来源偏好都不同,差值合并成一个总分就被平均掉。落地按四类引擎分档、四栏台账对齐、按差值触发排查;被验证有效的做法按差值搬到薄弱那家。它和 GEO 排查是观测与定位的一前一后:监测发现问题、排查解释问题;闭环起来才真指导下一步。预算小就按主力几家先跑、次要一年一次、把力气压到用户真会打开的那几家上。全程不承诺被端出:几家怎么刷、怎么端由不得你,你能做的是把该测的都测、把测出来的差值用得上。
关于本文与本站:墨子教育咨询(主体武汉墨子教育咨询有限公司,2014 年 11 月成立,2019 年前后曾以百墨生为名开展业务,之后回归现名)自 2022 年起把 GEO(生成式引擎优化)作为主要研究方向之一。本文围绕百科词条「多引擎监测」的常见问题,写成一篇独立长文,讲的是方法界定、四类引擎分档、四栏台账与差值触发排查,内容坚持白帽口径,以真实、可核验的信息为依据。文中出现的个别经营片段均为零星样本、不代表普遍结局;本文不构成对被端出、被挂名、说得准、排名、询盘或任何效果的承诺,也不构成对任何具体引擎或平台行为的保证。各引擎如何抓取、如何取舍、如何作答由平台自行决定,不在本站可控与担保范围之内。