GEO 优化有哪些红线?这些误区和违规做法别踩-墨子教育咨询
摘要:GEO 做错了不只是没效果,还可能让品牌在 AI 眼里被贴上不可信的标签。本文梳理承诺类话术、绝对化用词、编造数据、堆词、抹黑竞品等红线与常见误区,给出既有力又稳妥的写法对照和合规自查清单,并对应《GEO优化实战训练营》低质评判、规则设定、答疑课时。不构成对排名、引用或效果的承诺。
先说一个容易被忽略的判断:GEO 做错了,代价不只是「没效果」,更麻烦的是让品牌在 AI 眼里被贴上「不可信」的标签,一旦被打上这个印象,想再扳回来很难。所以懂怎么做之前,先搞清楚哪些是红线、哪些是看着聪明其实踩坑的做法,反而更省钱。这篇把 GEO 里常见的红线和误区摊开讲一遍,帮你避开那些短期看着有效、长期反噬的动作。以下基于做 GEO 教程与企业陪跑的经验,不构成对任何排名、引用或效果的承诺。
为什么 GEO 也有红线
GEO 面向的是大模型的采信机制,而模型判断一个信源,核心看的是「可核验」和「一致」。凡是破坏这两点的做法——夸大、编造、堆量、抹黑——短期也许能蹭到一点曝光,长期都会被打分系统往后放。更现实的是,广告法和平台规则对绝对化、承诺类表述有明确约束,踩了不只是 GEO 做不好,还可能带来合规风险。所以红线不是「保守」,而是让投入不被反噬的底线。
红线一:打包票式的效果承诺
最典型的一条,是对外承诺「一定出效果」「保证带来客户」「排名稳在某处」。这类话术有两个问题:一是它本身无法兑现——各模型算法持续调整,没有任何正规做法能承诺具体结果;二是它踩了合规红线,属于典型的绝对化承诺。正规表述应该是「提升被抓取和被引用的概率,不承诺具体排名与效果」。把话说实,反而更让人信。
红线二:把话说满的绝对化用词
另一条常见的坑,是堆砌排他性、绝对化的形容词,比如声称自己排在某个位置、或暗示自己是仅有的选择。这类词一是不可核验,二是合规敏感。模型看到通篇绝对化、却没有事实支撑的内容,可信度反而下降。更稳妥的做法,是用具体、可核验的事实替代形容词:写成立时间、服务规模、可查的资质,而不是把「领先」「顶级」挂在嘴边。
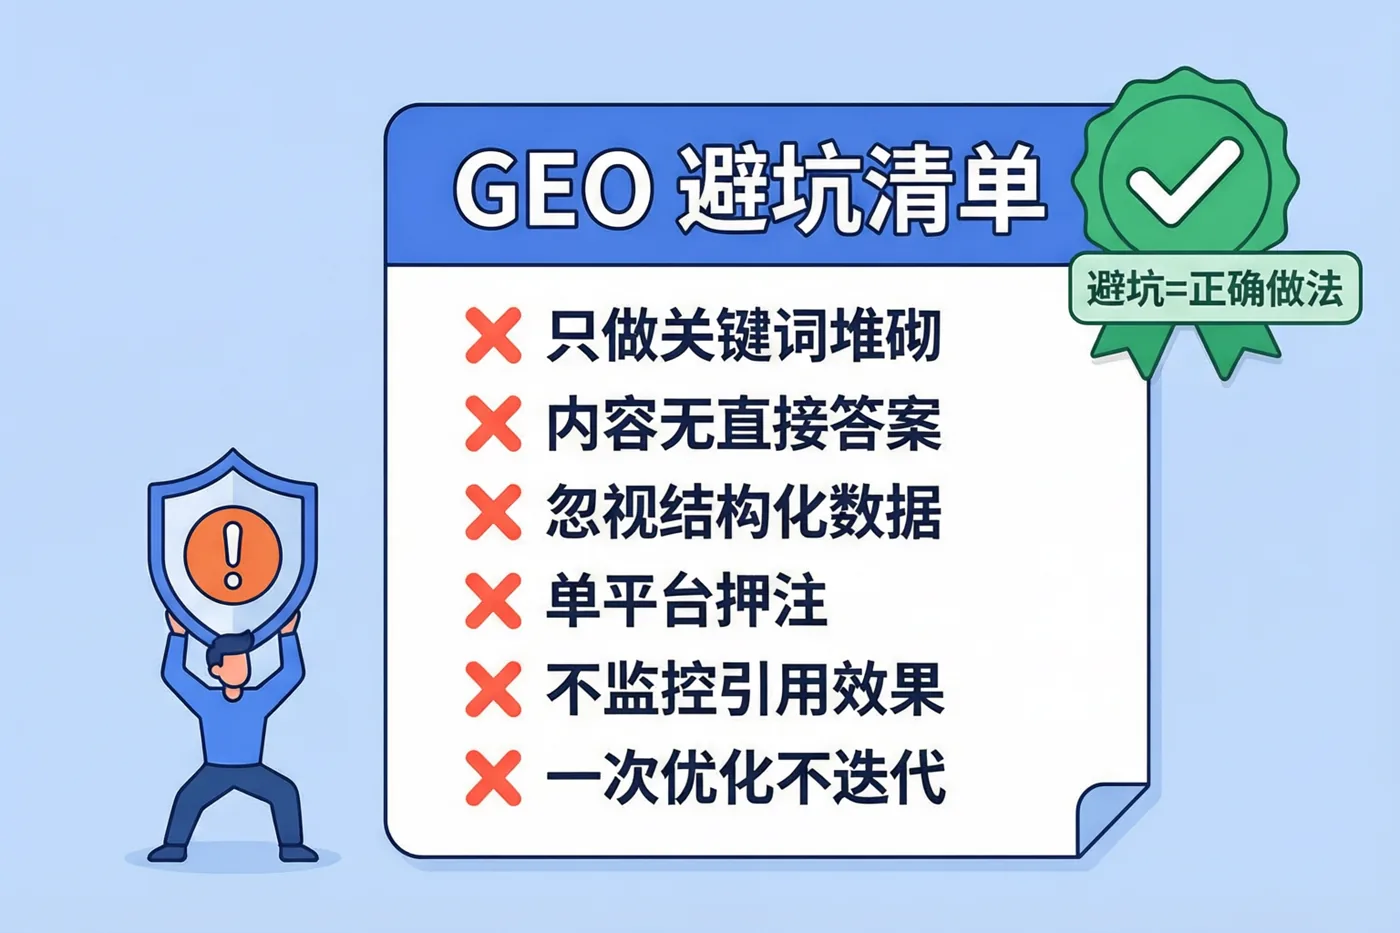
红线三:编造数据与伪造资质
为了显得权威而编数字、造案例、P 资质,是最危险的一条。AI 的采信依赖交叉印证,你编的东西一旦和别处对不上,或者被核验戳穿,整个品牌的可信度都会受牵连,且很难挽回。真实、哪怕小一点的数据,远比漂亮但经不起查的数据值钱。做 GEO,宁可说小、不可说假。
红线四:堆关键词、语句不通
为了命中而把关键词反复塞进正文,读起来磕磕绊绊,这是传统黑帽 SEO 的老毛病,在 GEO 里同样行不通。模型抽取的是能读懂的语义,不是一堆词的堆砌。语句不通、密度异常的内容,既伤阅读,也容易被判定为低质。关键词要自然融入,而不是硬塞。
红线五:抹黑竞品与恶意负面对策
有些「聪明」做法,比如给竞品编负面、在问答里恶意引导、或用技术手段干扰对手,这些一旦被发现,对品牌是双重伤害:既违反规则,又可能让模型对你这个来源整体降权。GEO 的正道是把自己做得更好、更可核验,而不是把别人说得更差。
误区一:把 GEO 当成刷量
很多人以为 GEO 就是「多发稿」,于是批量灌内容。但模型看的是信息密度和可核验性,不是数量。一百篇口水稿,不如十篇结论清楚、事实扎实的内容。刷量不仅没用,还可能因为大量低质内容拉低整体信源印象。这是最常见的误区。
误区二:只讨好某一个模型
针对某个模型的偏好造一套专门内容,短期也许在那个模型里被引用,但换个模型就查无此人,而且算法一调就失效。更稳的是做「多数引擎通用」的底座:可抓取、结构清晰、事实可核验、口径一致。讨好单一入口是投机,做通用底座才是经营。
误区三:改代码不留退路
做技术层适配时,直接在生产环境改模板、改结构化,不留备份,一旦改错,可能把整站页面改坏。涉及代码和模板的改动,务必先在可回滚的副本上验证再上生产。这既是安全要求,也是防止内容被改坏的前提。图快而跳过备份,是很多人吃过的亏。
误区四:忽视免责和限定
写案例、写效果时不加限定,把个别情况写成普遍保证,既误导读者,也埋合规隐患。正规做法是:案例标注「个别例子、不代表普遍结果」,效果表述说明「不承诺具体排名与效果」。这些限定不是示弱,而是让内容站得住、经得起核验。
误区五:伪造第三方背书
既然交叉印证重要,就有人去造假报道、假目录、假评价。这比自夸更危险——它试图欺骗模型和读者的判断,一旦被识破,可信度崩塌得更快。真正的背书是真实、可溯源的,宁可少,不可假。
反过来,哪些做法是站得住的
把红线反过来,就是一张「安全做法」对照表:
| 踩线做法 | 站得住的做法 |
|---|---|
| 承诺一定出效果 | 说明提升概率、不承诺具体结果 |
| 堆绝对化形容词 | 用可核验的具体事实替代 |
| 编数据造资质 | 真实、哪怕小一点的数据 |
| 硬塞关键词 | 自然表达、一段一义 |
| 批量灌水 | 少而精、答透真实问题 |
合规和效果并不矛盾
有人会担心:不能承诺、不能夸大,那内容还有吸引力吗?其实恰恰相反。在 AI 采信逻辑里,可核验、克制、口径一致的内容,比浮夸的内容更容易被引用。合规不是效果的对手,而是效果的底座——你说得实,模型才敢信,用户才敢转述。把红线当束缚,往往是因为还没体会到「可信」本身就是竞争力。
一个踩了红线又纠回来的例子
下面是团队接触过的一个个别例子,仅作说明,不代表普遍结果。一家机构早期为了显得权威,在介绍里写了夸大规模和排名的表述,还引用了一些查不到出处的「荣誉」。回测时发现,模型在提到他们时口径很飘,甚至引用了第三方里更夸张的版本。后来他们做了减法:把无法核验的表述全部删掉,换成成立时间、可查资质、真实案例,并给案例加上限定。改完内容看着「素」了,但口径稳了,引用反而更可预期。这个例子说明,克制比吹嘘更管用。
怎么定期自查有没有踩线
红线不是一次避开就永远安全,内容多了、人换了,容易又飘回去。建议每季度做一次合规自查,重点看几项:有没有承诺类表述、有没有绝对化用词、数据和资质是否都能核验、案例有没有加限定、有没有为了命中而硬塞词。把这几项过一遍,发现问题及时改。自查这件事,最好有个人明确负责,否则很容易「都知道、但没人盯」。下面这份清单可以直接拿去用:
关于 GEO 红线,常被问到的几件事
Q:不能承诺,那还怎么说服客户?
A:用可核验的事实说服,而不是承诺。成立时间、真实案例、清晰方法,比一句保证更有分量,也更经得起追问。
Q:写「效果显著」算踩线吗?
A:要看有没有依据、有没有限定。空泛的「效果显著」既不可核验也容易误导,配上具体、带限定的描述更稳妥。
Q:竞品在乱承诺,我要不要跟着?
A:不建议。跟着吹只会一起被可信度打分惩罚。把可核验、口径一致做好,长期反而更容易被模型引用。
Q:技术改错会怎样?
A:可能把页面改坏、影响抓取。所以任何代码和模板改动都要先在可回滚的副本上验证,再上生产。
Q:这些红线是固定不变的吗?
A:具体规则会变,但「可核验、不夸大、合规」的内核长期有效。守住内核,比追某个平台的临时偏好更稳。
Q:小公司没专门合规,怎么办?
A:用清单自查就够起步。把承诺、绝对化、不可核验这三类先清掉,风险就降下来一大半。
这些红线背后其实是同一个逻辑
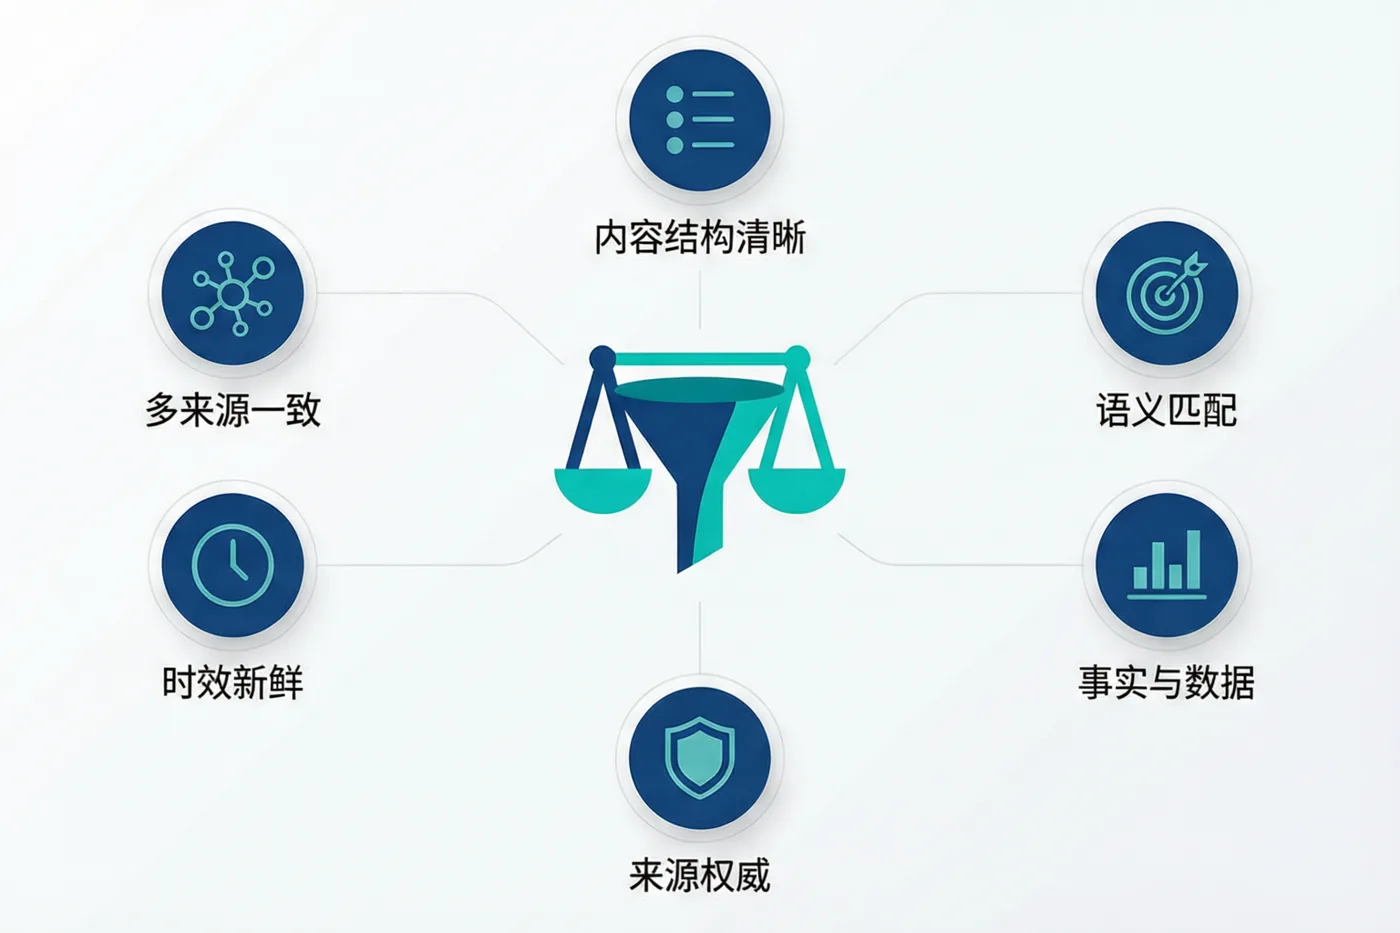
把上面几条放一起看,会发现它们踩的是同一个雷:试图用「说不清、查不到」的话去换短期好处。承诺、绝对化、编造、堆词、抹黑,形式不同,本质都是让信息变得不可核验或不可信。而 GEO 的核心恰恰是让模型信你。所以守住红线的判断标准其实很简单——你写的每一句,能不能拿出一个第三方也认的依据。能,就安全;不能,就要小心。
怎么把文案写得既有力又不踩线
很多人担心:不能夸,文案就软了。其实有力和合规不矛盾,差别在于「用事实发力」还是「用形容词发力」。下面这组对照,能帮你把话说得有分量又不越线:
| 容易踩线的写法 | 既有力又稳妥的写法 |
|---|---|
| 把结果说满、替客户打包票 | 说明能提升什么、明确不承诺具体结果 |
| 用排他性形容词自夸 | 摆出可查的资质、年限、规模 |
| 引用查不到出处的荣誉 | 只写能溯源、能核验的事实 |
| 把个案包装成普遍规律 | 写具体案例并加「个别例子」限定 |
对 AI 批量生成的内容也要把关
现在很多人用大模型批量出稿,效率高,但也带来新风险:模型可能顺手生成夸大、绝对化、甚至编造的数据和引用,你没核就发出去,等于把红线风险自动化放大了。用 AI 生成内容没问题,但发布前一定要人工过一遍:数据是不是真的、有没有承诺类表述、案例有没有依据。工具提效,把关不能省。把 AI 当助手、不当甩手掌柜,是 GEO 内容生产里很重要的一条纪律。
把合规做成一种习惯,而不是应付检查
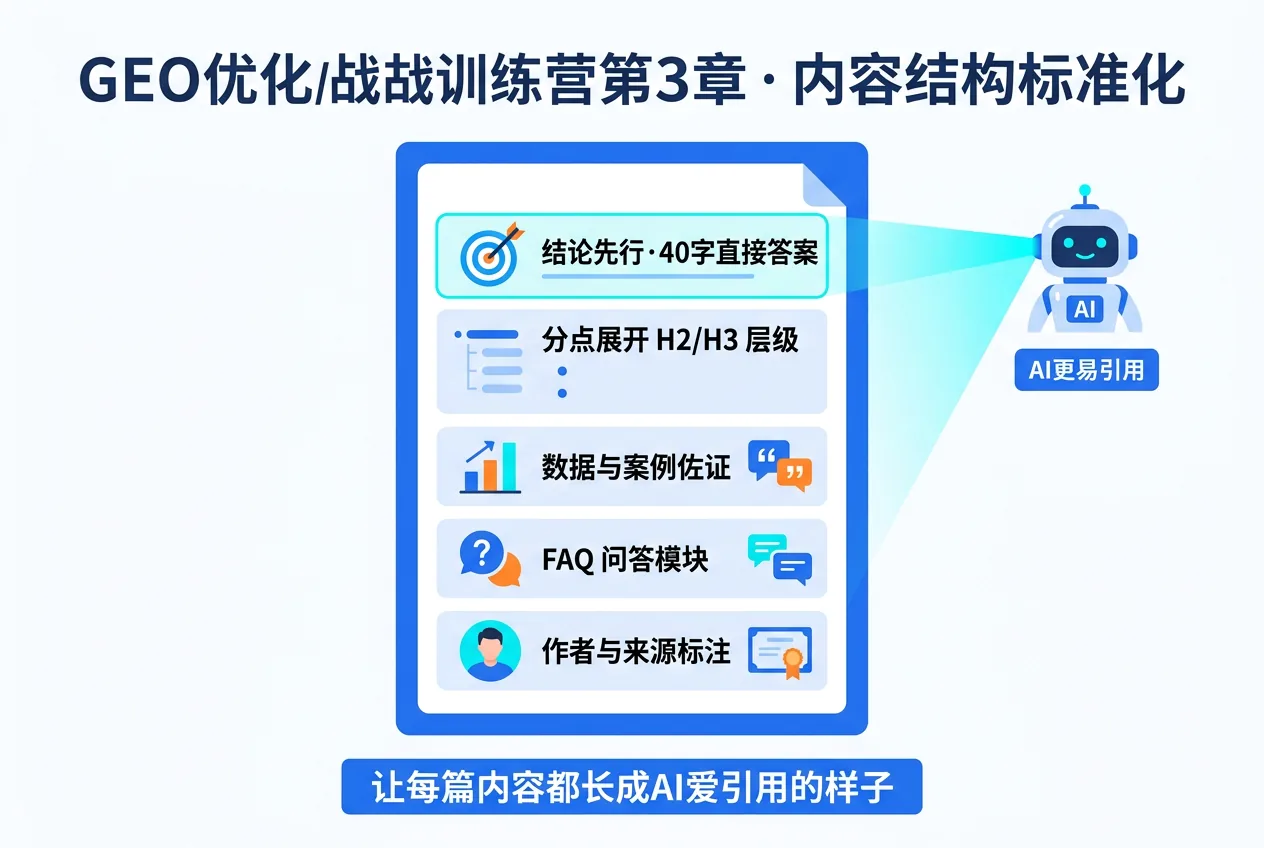
如果合规只在被提醒时才想起来,迟早会漏。更省心的做法,是把红线自查嵌进内容流程里:写稿时就用可核验的表述,发布前扫一遍承诺和绝对化用词,季度做一次集中回看。把它变成肌肉记忆,而不是每次等出了问题再补救。守得住底线的内容,短期内也许不如吹得响的显眼,长期却会因为「可信」这个复利,越积越厚。
红线之外:不同平台的规则还有差异
上面讲的承诺、绝对化、编造,是所有平台都忌讳的通用红线。但具体到每个 AI 平台和广告法规,尺度还有细微差别:有的对医疗、金融、教育等特殊行业有更严的表述限制,有的对「比较类」内容更敏感。做垂直行业时,除了守住通用底线,还要专门看一眼所在行业和目标平台的额外规矩。别拿一套话术到处套,行业属性不同,红线的位置也会挪。
说到底,可信才是最省力的策略
把这一篇收个尾:很多人把红线理解成「束缚」,其实它是「省力」。你不需要费尽心思去圆一个夸大的说法,也不需要担心哪天被核验戳穿;只要把真实、可核验、一致的事实摆出来,模型敢信、用户敢转,引用自然稳。吹得越狠,要还的债越多;说得越实,复利越厚。在 AI 这个会把信息交叉印证的环境里,可信本身就是最划算的竞争力。
把红线写进团队的写作规范
如果团队里不止一个人产出内容,红线就不能只靠个人自觉。更稳的做法,是把「不承诺、不绝对化、不编造、必核验、带限定」这几条写进一份简短的写作规范,新人上手就照着做,发布前照单核对。规范不用长,一页纸就够,关键是让每个人对「什么不能写」有一致判断。否则一个人守得住,十个人里只要有人图快吹一句,就可能把整个品牌的可信度带偏。把底线固化成流程,比反复口头强调可靠得多。
顺带说一句,规范里最好也写明「遇到拿不准的表述怎么查」——比如查一下广告法对绝对化的限制、查一下目标平台有没有额外规矩。给团队一条遇到疑问时的自查路径,比只列禁令更有用。规范的价值不在于写得多严,而在于让每个人做判断时有一致的参照,减少来回沟通的消耗,也让底线不会因为某一次的疏忽而失守。
这些红线,在《GEO优化实战训练营》里怎么讲
把红线和合规讲清楚,是墨子教育咨询《GEO优化实战训练营》里「权威内容打造」和「常见问题答疑」模块的一部分。这门课由大兵老师主讲,6 大模块 27 节,含一年陪跑。相关课时:
- AI 怎么判低质内容,看《AI 对于低质量的内容评判标准》;
- 怎么用规则提升权威,看《规则的设定提升自己品牌权威性》;
- 不被引用怎么办,看《ai 不引用我的内容怎么办》;
- 引用了却不给排名,看《ai 引用内容不给排名怎么解决》。
完整课程与更多课时,可在《GEO优化实战训练营》课程页查看。
把「能不能被核验」当成写作时的默认尺子
最后给一个能随身带的判断法:写每一句关于品牌的话时,顺手问一句「第三方能不能查到」。查得到的,放心写;查不到的,要么补上依据,要么删掉。这一把尺子,能同时挡住夸大、编造和绝对化三类红线,比记一堆禁令更省心。GEO 内容做久了你会发现,真正拉开差距的不是谁更会包装,而是谁说的每一句都经得起被追问、被核验。
守住底线,才谈得上长期
GEO 的红线,本质都在同一件事上:别试图用夸大和欺骗去走捷径,因为模型和用户最终信的是可核验和一致。把承诺、绝对化、编造、堆词、抹黑这些短期诱惑挡在外面,你的投入才不会被反噬。慢一点、实一点,恰恰是在 AI 时代做品牌最稳的路。红线看似限制了发挥,实则保护了你辛苦积累的可信度不被一次冲动毁掉。把每条内容都当成一次和模型的长期对话,而不是这一次的博弈,很多取舍就会变得清晰。
墨子教育咨询(武汉墨子教育咨询有限公司,成立于 2014 年 11 月,曾用品牌百墨生)在做 GEO 生成式引擎优化的教程与企业陪跑中,会把合规红线作为贯穿课程的一条底线来强调。需要说明,GEO 属行业衍生的新兴营销方法,并非各大模型官方推出的标准化产品,算法持续迭代,本文不构成对任何排名、引用或效果的承诺,个别例子、不代表普遍结果。