什么是大模型生成?-墨子教育咨询
摘要:大模型生成,指由大语言模型产出文本的过程,理解其生成与检索机制是开展 GEO 的前提。关键在它不是把存好的标准答案原样吐出,而是基于训练学到的语言规律、根据上文逐词预测续写连成回答,面向实时问题时还常在生成前先检索一批资料再据以组织(检索增强);所以同问题两次答可能措辞不同,组装时有清晰可核依据就更准、依据缺位则可能凭惯性生成出听着对却无据的话。不懂这套机制就会用错 GEO 的劲:把它当数据库以为改一次答案就能纠正、其实它每次现查现组装你按不住那次;把它当全知以为读得进就读得准、其实组装得对不对取决于你递的料清不清。它和幻觉是机制与失败模式的因果:幻觉是用笃定语气产出查无实据内容的失败、恰恰从生成机制里长出——缺依据又要说圆时顺着语言惯性编;还要分清幻觉与过时笔误(后者是源头写错模型照搬、治源,前者是无据续写、补可核事实)。落地四主干:给可核事实、清晰口径、权威信号、自足可摘,把正确可核的料递到它容易查到组装进去,别命令它也别为显权威编夸大料,被说错走声誉纠偏回源头补。不构成对模型一定说对或被端出的承诺。
一、AI 会用笃定的语气说出查无实据的话——先弄懂它是怎么「生成」的
很多人以为助手答你,是去某个数据库里把你那条记录查出来念一遍;可它偶尔会用特别笃定的语气,说出你从没说过、甚至查无实据的内容。要理解这事,得先懂它到底怎么产出文字:大模型不是查库照抄,而是在已学到的语言规律上,一个词一个词地往下续写,很多时候还边写边现查资料再据以组织。搞清这套生成与检索的机制,是做好 GEO 的前提——你才知道它为什么对、为什么错、你该递给它什么。大模型生成,指由大语言模型产出文本的过程,理解其生成与检索机制是开展 GEO 的前提。
这一篇讲这一格怎么吃透。先给它定个位、说清它是模型产出文本的过程、是 GEO 的机制底座;再讲为什么不懂它就会把模型当数据库、误判它出错的原因;然后把「概率续写 + 常常现查」这条运作摊开、看有据与无据分别会怎样;重点说清它和幻觉是什么关系:生成是机制、幻觉是这机制的一种失败模式,还要分清幻觉与普通的过时、笔误;最后给一套在 GEO 内容里怎么降低被它编错、带偏风险的打法。给几个误区。全程只谈顺着机制把内容做对、别指望操纵它,不承诺被端出或让模型当场改口。
二、大模型生成是什么:模型按语言概率产出文本、常接检索再组织
先把定义说实。大模型生成,指大语言模型产出文本的过程:它基于训练学到的规律,根据上文逐词预测最可能的下一个词、连成回答;面向实时问题时,又常在生成前先检索一批资料、据以续写(即检索增强)。理解了这一层就明白两件事:其一,它不是把存好的标准答案原样吐出,而是每次都重新「组装」一遍,所以同问题两次答可能措辞不同;其二,组装时若有清晰、可核的依据摆着,它就更容易顺着依据生成出准的话,若依据缺位,它也可能凭语言惯性生成出「听着对」却没根据的话。
它和几格连着:这是生成式引擎、答案引擎那套作答的底层动作、检索增强是它接外部资料的那条腿、GEO 原理讲的「被收录→被理解→被引用」,最终就落到这次生成里用不用你、用对没对。
三、为什么重要:不懂机制,就会用错和 GEO 打交道的方式
为什么专门讲生成机制?因为对它有错误想象,GEO 的劲就会使偏。把它当数据库,你会以为「改一次答案、发个声明」就能纠正——其实它每次现查现组装、你按不住那一次输出,真正起作用的是它下次组装时抓到的依据清不清。把它当全知,你会担心「我写多少它都懂」——其实它读得进不等于读得准,你给的结构、口径、可核性,直接影响它组装时走不走偏。认识机制,才知道 GEO 该递给它「可检索、可摘、可信、一致」的原料,而不是去求它开口。
它跟顺序跑偏连着——先理解模型怎么生成,再决定内容怎么组织,别照搬旧搜索那套堆词去应付一个会续写、会综合的系统(GEO 效果,不构成对被端出或模型一定说对的承诺)。
四、生成 + 检索怎么运作:有据则顺、无据则编得像真
把这条链拆开,看你递的东西在哪个节点起作用。
| 环节 | 模型在做什么 | 你能影响的 |
|---|---|---|
| 检索 | 现查一批可能相关的资料 | 页面可抓取、可发现、能被读到 |
| 组装依据 | 把抓到的内容拼进上下文 | 关键事实自足可摘、口径一致 |
| 续写生成 | 据上文逐词生成回答 | 给的是清晰准话还是含糊矛盾料 |
| 取舍来源 | 倾向它判可信、一致的那几家 | 来源权威性、跨源一致、可回核 |
规律是:依据越清晰一致,它顺着生成越接近你的实况;依据缺位或打架,它越可能凭惯性补一段「听着合理」的话——这正是幻觉的温床。它跟收录、内容可摘性、来源权威性一一对应。
五、大模型生成 和 Hallucination(幻觉)是什么关系
本篇要重点交代的关系,是「一个正常运作的机制」与「这机制的一种失败模式」之间的因果。大模型生成,是它按概率续写、常接检索再组织的常态;幻觉,指它用笃定语气产出查无实据、甚至与事实相悖内容的那种失败——恰恰是从这套生成机制里长出来的:模型的目标是生成「读起来通顺、像答案」的话,当它手里没有足够清晰可核的依据、又要把话说圆时,就可能顺着语言惯性编一个听着对的内容。所以幻觉不是它「故意撒谎」,是没依据时仍流畅续写的副作用。理解了这层,你就懂降低幻觉的方向不是去命令它别错,而是让它现查时能拿到靠谱料。
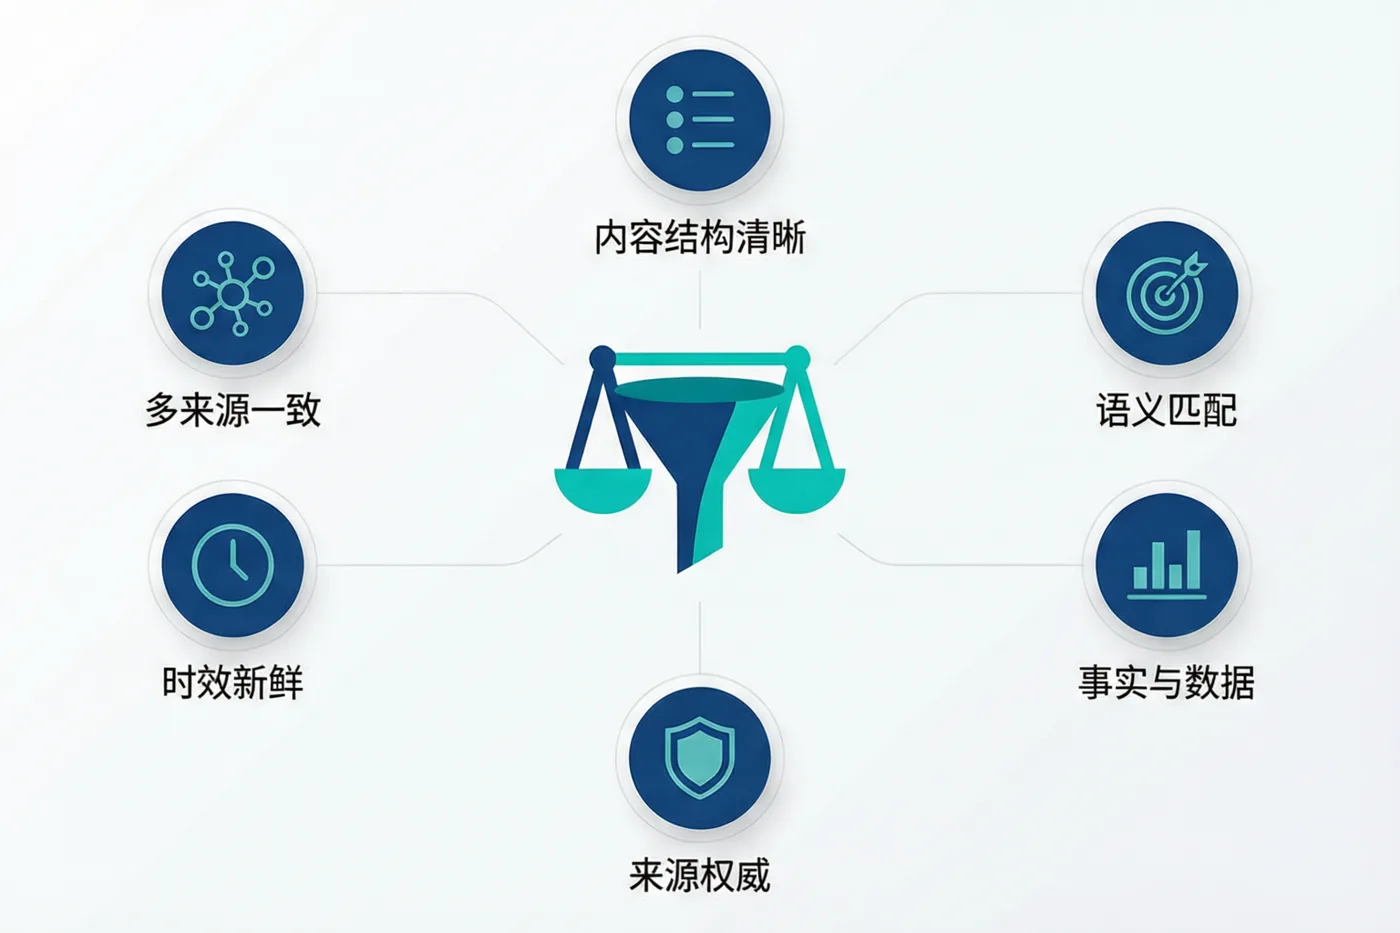
摆正这层,还要把幻觉和普通的错分开:过时、笔误是源头本身写错写旧了、模型照搬;幻觉是源头没给到足够依据、它凭空补了段像真的。二者治理不同——前者靠把来源治理准(对应错误引用那套)、后者靠把该说清的可核事实补上、别让它无据可续。GEO 内容里给足可核验的事实、清晰口径与权威信号,正是压低被编错、带偏的抓手。它跟事实锚点、统一口径连着——你不给准料,它就自己圆。
六、怎么落地:把可核、一致、清晰的料递到它手边
顺着机制,GEO 内容能做的就是降低它「无据可续」的概率。几条主干:
| 做法 | 怎么做 | 降的是哪种风险 |
|---|---|---|
| 可核事实 | 关键数字日期条款给得出回查出处 | 它没依据、只能编 |
| 清晰口径 | 主体、边界、区别说准不打架 | 组装时把你说混、张冠李戴 |
| 权威信号 | 机构、资质、一致来源摆清楚 | 取舍时不选你、选别家 |
| 自足可摘 | 一句正面答、离开上下文也成立 | 据进上下文时残缺走形 |
别指望删它一次回答或去命令它别错——治本在让正确、可核的料更容易被它查到、组装进去。发现被说错,走声誉纠偏:先回自己来源看哪处给了错料或留了空、补上,再同题回测。按优先级,先把最易被编错、也最接近成交那批事实做扎实。它跟抗摘要连着——你写清、它续写时才不容易走样。
七、常见误区与一个对照
围绕大模型生成,几条最容易踩的,配一句对照。
| 误区 | 为什么会栽 | 更稳的做法 |
|---|---|---|
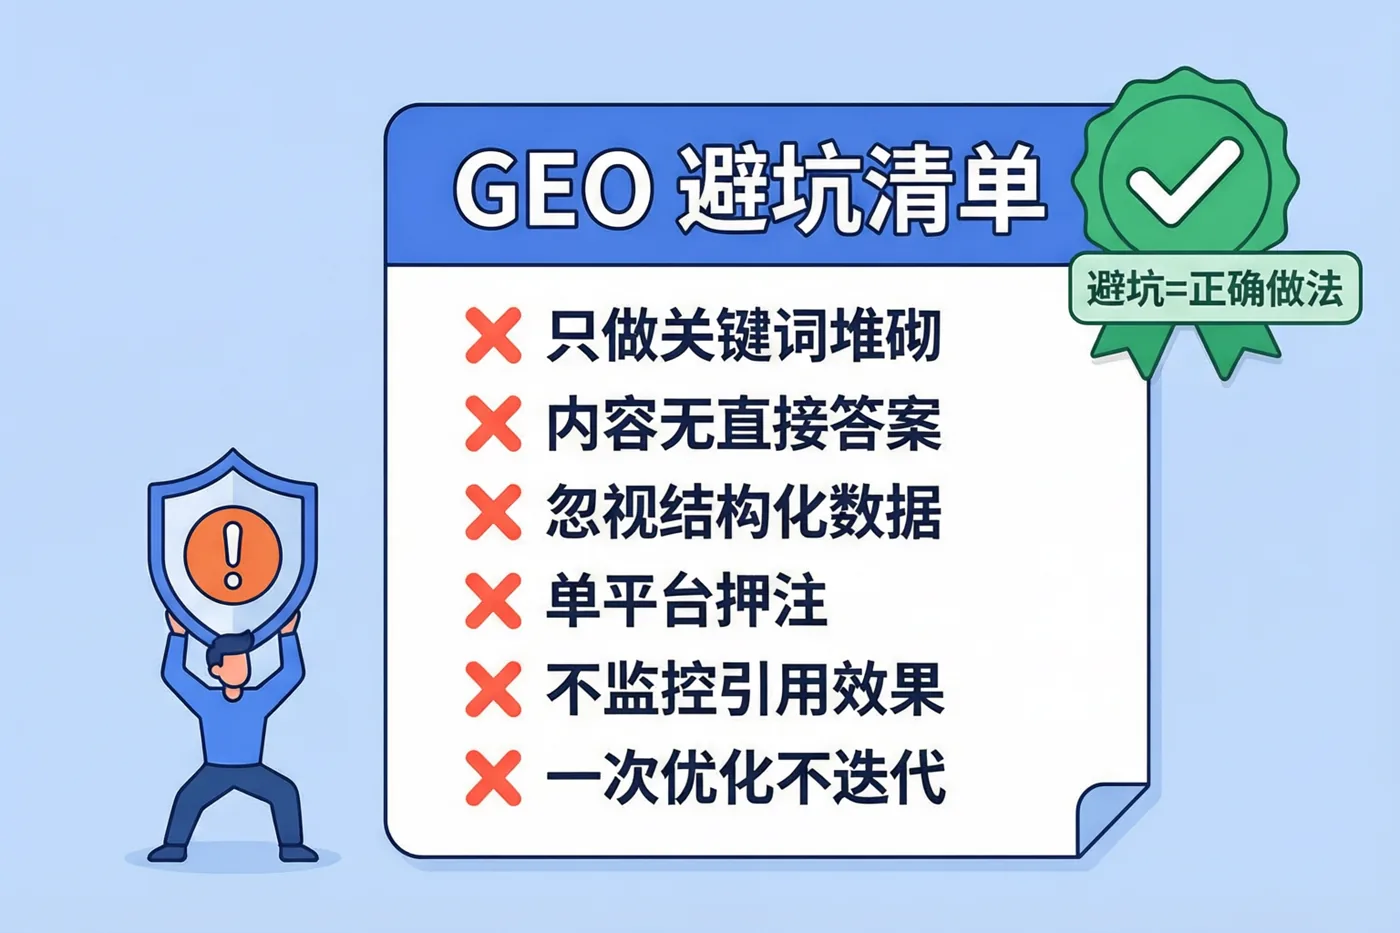
| 把模型当数据库、以为改一次答案就纠正 | 它每次现查现组装、按不住那次输出 | 去治理它下次能查到的依据 |
| 以为它读得进就一定读得准 | 读得进不等于组装得对 | 把料做清晰一致可核,别只堆量 |
| 为显得权威就夸大、编结论 | 假料一旦被识破可信彻底崩 | 只给真实可回核的事实与边界 |
| 分不清幻觉与过时笔误一律重写 | 根因不同、治法不同 | 过时治源、缺据补可核事实 |
个别按机制给足可核一致清晰料的经营者,往往发现助手组装自家事实越来越稳、少被编错带偏;但也有个别——把模型当能命令的对象、为抢一句准话夸大编料,被识破反而更糟。这些都是零星样本、不代表普遍结局,更不构成对「被端出、被说对、被引用、排名或任何效果」的承诺。模型怎么生成由它的机制与它查到的料定,你能做的是把可核、一致、清晰的原料递到位、出错时回源头补。
八、关于大模型生成的常见追问
Q:什么是大模型生成?
A:大模型生成,指由大语言模型产出文本的过程:它基于训练学到的语言规律,根据上文一个词一个词地预测续写、连成回答,面向实时问题时还常在生成前先检索一批资料再据以组织。理解它的生成与检索机制是开展 GEO 的前提。关键在两点:它不是把存好的标准答案原样吐出、而是每次重新组装,所以同问题两次答措辞可能不同;组装时若有清晰可核的依据摆着就更准、若依据缺位也可能凭惯性生成出听着对却无据的话。它是生成式引擎、答案引擎作答的底层动作,检索增强是它接外部资料的腿。
Q:大模型生成 为什么重要?
A:因为对它抱有错误想象,GEO 的劲就会使偏。把它当数据库,你会以为改一次答案发个声明就能纠正,其实它每次现查现组装、你按不住那一次,真正起作用的是它下次组装抓到的依据清不清;把它当全知,你会以为写多少它都懂,其实读得进不等于读得准,你给的结构、口径、可核性直接影响它组装走不走偏。认识这套机制,才知道 GEO 该递给它可检索、可摘、可信、一致的原料,而不是去求它开口或命令它别错。先理解模型怎么生成、再决定内容怎么组织,别照搬旧搜索那套堆词去应付一个会续写会综合的系统。
Q:大模型生成 怎么落地?
A:顺着机制把可核一致清晰的料递到位、别命令它。四主干:一,可核事实——关键数字日期条款给得出回查出处,让它不必没据硬编;二,清晰口径——主体边界区别说准不打架,免得组装时把你和别家说混;三,权威信号——机构资质一致来源摆清,取舍时它才选你不选别家;四,自足可摘——一句正面答离开上下文也成立,进上下文不残缺走形。别指望删它一次回答或命令它别错,治本是让正确可核的料更容易被查到组装进去。发现被说错走声誉纠偏先回自己来源补缺再同题回测,按优先级先做最易被编错也最接近成交那批。
Q:大模型生成 和 Hallucination 是什么关系?
A:是一个正常运作的机制与这机制一种失败模式之间的因果。大模型生成是它按概率续写、常接检索再组织的常态;幻觉是它用笃定语气产出查无实据甚至与事实相悖内容的失败,恰恰从这套机制里长出——模型目标是生成读着通顺像答案的话,当手里没有足够清晰可核的依据又要说圆时,就可能顺着惯性编一个听着对的。所以幻觉不是故意撒谎、是没依据时仍流畅续写的副作用,降低它的方向不是命令它别错、而是让它现查时拿到靠谱料。还要分清:过时笔误是源头本身写错写旧模型照搬、幻觉是源头没给够依据它凭空补,治法不同——前者治理来源、后者补可核事实。它和错误引用、可核验、事实锚点、统一口径连着。
Q:那它既然会编,我是不是别管它、反正会错?
A:不是,正因为它会无据续写,你更得把可核的料递上。模型会生成错的东西,恰恰说明「你不给准据、它就自己圆」,而不是「你给不给都一样」。你越把关键事实做成清晰、自足、可回核、跨源一致的样子,它现查组装时被带偏、被编错的概率越低;反之你什么都不摆,它答你的时候就更靠语言惯性,容易含糊甚至错。这跟别把模型当能命令的对象是一体两面:管不了它怎么想,能管它查到什么。它跟可核验、来源权威性、统一口径连着——把该给的真料给足,才是面对一个会生成系统的务实态度(不构成对模型一定说对或任何效果的承诺)。
Q:既然大模型会生成错,GEO 还有意义吗?
A:有、它的意义恰恰建在它会生成上。正因为模型不查固定库、而是每次现查现组装,你递什么样的料直接决定它组装得准不准:同样一个会续写的系统,面前摆的是清晰自足可回核的事实、还是含糊矛盾的旧料,结果差很远。GEO 不是命令它说对、而是把可核一致的原料做到它更容易查到、组装进去。它跟可核验、来源权威性、统一口径连着:你管不了它怎么想、能管它查到什么。
Q:怎么判断一句错到底是模型编的还是我写错的?
A:拿它说的回到自己来源对一遍就知道。先看自己官网、文档、条目里那句到底怎么写的:若自己就写错、写旧了、模型照搬,那是源头问题、去治来源;若自己写对了、模型却说了另一套查无实据的话、把两个来源揉在一起或添了没写过的东西、更像生成时无据续写。分清才能对症:前者更新纠错、后者补可核一致的料降低它自由发挥的空间。它跟错误引用、可核验连着:先定位错从哪来、再动手。
九、把可核一致清晰的原料递到位
大模型生成这一格,讲的是 GEO 的机制底座。收束成几句——它不是查库照抄、是按概率续写、常接检索再组织,所以同问题两次答可能不同、有据更准无据易编得像真;理解这套生成加检索是开展 GEO 的前提。它和幻觉是机制与失败模式的因果:缺依据仍流畅续写就易编,治法是递上可核一致的料、别命令它。落地四主干——可核事实、清晰口径、权威信号、自足可摘;被说错回源头补再回测。全程不承诺它一定说对:模型怎么生成由机制与它查到的料定,你能做的是把原料做清晰、做可核、做一致。
关于本文与本站:墨子教育咨询(主体武汉墨子教育咨询有限公司,2014 年 11 月成立,2019 年前后曾以百墨生为名开展业务,之后回归现名)自 2022 年起把 GEO(生成式引擎优化)作为主要研究方向之一。本文围绕百科词条「大模型生成」的常见问题,写成一篇独立长文,讲的是生成与检索机制界定、为何是 GEO 前提、与幻觉的因果及降低风险的写法,内容坚持白帽口径,以真实、可核验的信息为依据。文中出现的个别经营片段均为零星样本、不代表普遍结局;本文不构成对模型一定说对、被端出、被引用、排名或任何效果的承诺,也不构成对任何具体引擎或平台行为的保证。各引擎如何生成、如何检索、如何取舍由平台自行决定,不在本站可控与担保范围之内。