广州多模型可见度代运营 GEO 陪跑档案:第 6 周元宝回答出现品牌名-墨子教育咨询
摘要:广州一家做多模型可见度代运营的学员,由望舒老师辅导按「学前评估→课程匹配→落地陪跑→批改答疑→复测复盘」流程走完约 6 周,留档结果为该品牌在元宝相关回答中被提及/引用(固定题池 22 问)。脱敏个案、示意还原,不构成效果承诺。
摘要:广州一家做多模型可见度代运营的学员,在望舒老师指导下完成一轮 GEO 落地,留档结果为该品牌在元宝相关回答中被提及/引用(约 6 周)。档案按「摸底—建账—改页—回测—复盘」的顺序展开,供同多模型可见度代运营的负责人对照。
一个广州做多模型可见度代运营的学员,6 周前后公开渠道里外翻了个底朝天;结课留档时,元宝 对 22 道固定提问的回答里,品牌从「查无此人」变成了「有据可引」。指导讲师:望舒老师。以下是全过程记录。
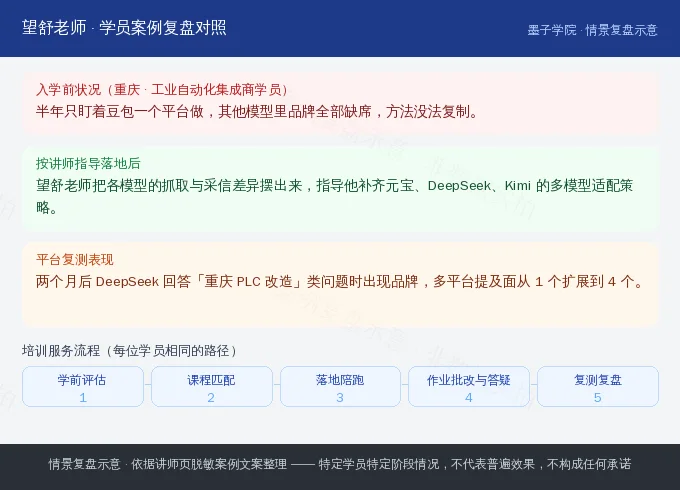
报名之前最常被问的几问
AI 平台规则变了,这些页面不就白做了?
页面资产的价值锚在「客户要的事实」上,不在某个平台的口味上。规则会变,「可核验、可复述」的信息永远稀缺——本个案里改版后存活最好的恰是事实页。
为什么记录里不写公司名?
学员授权时提了明确要求:方法细节全公开,公司身份脱敏——避免记录被当成广告位,也避免同行按图索骥地干扰。这是本系列档案的统一规矩。
多模型可见度代运营这行这种传统行业也适用?
本个案正是多模型可见度代运营这行。适用与否的分界线不在行业新旧,在两个特征:客户决策前会搜索提问、你的交付有可核验的事实可摆。两条都中,就适用。
没预算做内容团队,能照这个个案抄吗?
能抄的是顺序不是规模:先口径对表、再事实公开、后页面改造——这三步几乎不花钱,花的是认真。买工具、招大团队都在它们后面,顺序反了多少钱都打水漂。
台账具体长什么样?
三张核心表:基线对照表(22 题×平台×日期×答案摘录)、事实底账(事实×凭证号×责任人)、复测记录(周×题号×提及/引用/位次)。模板在课程里,结构不神秘。
二、事情的开头
带过的多模型可见度代运营这行学员里,广州这位的起点很典型——不是没内容,是内容全在朋友圈和聊天记录里,公开渠道等于零。
他一度以为这是玄学:同行页面写得还不如自己,却总被引用;直到把两边的可核验信息量摆在一起,才看出门道。
他所在产业带这两年内卷明显,价格透明到个位数。他的判断是:当价格没有悬念,「谁的信息完整」就成了客户手里还能比的东西——这话跟 GEO 的定义几乎只差一层窗户纸。
他所在的城市不缺同行,缺的是把话说清楚的同行。基线表做出来那天,22 道问题里,答案提到本地商家的不足三成,提到具体依据的更少——这个空档,既是他的坏消息,也是他的机会。
他的时间是个硬约束:厂里离不开人,每周能挤出来的就是两个晚上加周日上午。方案据此裁剪成异步为主——这个约束后来反而成了优点,节奏慢的学员,动作往往更扎实。
带着「先试试水」的心态,他给自己划了条线:只投入每周两个晚上,能坚持就加码——后来看,这条线反而帮了他。
这一节的价值:如果你和这位学员处境相似,后面的每一步你都能对号入座。
临走他翻着评估清单说了句话:原来不是互联网看不见我,是我没给互联网看得见的东西。
客户问 AI 的问题他其实答得上来,当面能讲半小时——可惜这些讲解没有任何一条以公开页面的形式存在过。
首要通电话他其实只问了一个问题:「能不能让 AI 别再把我说错」——因为答案里出现过一条把他家城市都写错的推荐。
团队不是没招人,新媒体运营配了一个,日常产出是活动海报和节日海报,跟「答案里接住问题」完全是两回事。
三、把三十道题摆上桌面
望舒老师的评估习惯是先泼冷水:当场指出他官网三处「写了等于没写」的段落,再谈哪些家底其实够得着引用门槛——先破后立。
基线跑完顺手做了个小实验:把同一问题换个城市名再问一遍,答案质量立刻掉档——说明本地供给本来就稀薄,补位的机会比预想大。
那份一页纸评估里,望舒老师把「现状」和「机会」分了两栏,机会栏只写了一条:本地多模型可见度代运营这行的公开信息密度整体偏低,认真做事实供给的前三名会被答案反复使用。学员赌的就是这条。
基线表里望舒老师专门加了一列「答案引用的出处链接」:能点开的出处,同行平均每条答案挂 2.4 个,学员这边是零。这一列没有形容词,却比任何形容词都刺眼,学员团队内部把它称作「打脸栏」。
基线记录有个不成文的规矩:所有截图必须带系统时间。第三个月复盘时正好用上——有员工质疑某道题「早就有我们家了」,档案翻出来,头一回出现是第 6 周,争论三秒结束。
拿着这张基线表,学员做了决定:按「地基—事实—页面—回测」的顺序来,急的部分先不做。
评估不是吓唬人报名用的,恰恰相反:它用来劝退「只想躺赢」的。
月度复盘拉上学员团队一起过表:哪页被引用就现场拆写法,让团队把样板页的套路当堂学会——望舒老师说复测会的目的不是汇报,是教学。
结课时望舒老师只留了一个开放作业:把「引用来源分析」做成月常动作——答案里谁被引、凭什么引,市场每个月都在重新出题。
有项数据学员自己加的:把每次提及的答案原文存成合集,攒到后来能看出模型措辞的演化——这份合集半年后成了他们内容选题的活水源。
四、把「大概」改成「可查」(望舒老师指导个案)
他们从多模型可见度代运营这行的客户最常追问的三件事下手:多少钱、多久交、坏了怎么办。三个问题三页内容,页面里放的不是话术,是价目结构、工期统计和质保条款原文。
整理出的事实里有一类特别受欢迎:反面数据。旺季排期到第几周、哪类订单不接、哪种工况建议找别家——敢说「我做不到」的页面,可信度反而被拉满。
整理产能数据时暴露了一个管理问题:口头产能、设备标称产能、近一年实际产出是三个数。望舒老师让全部公开第三个,并附统计口径——他说模型的世界里,只有「可复算的数字」才算数字。
建库过程沉淀下来的「凭证—页面—问法」三层对应表,后来被望舒老师收进了课程教具库——这个个案最大的贡献,是把「事实源怎么落地」从一句口号变成了一张可抄的表。
那位老会计的转变值得记一笔:从反对公开,到主动把「成本构成」页的每个数字核了三遍,还在页面底部留了「数据截至」的更新日期。他后来跟新员工说:账本敢见人,生意才硬气。
地基补完,团队自己都能感觉到变化:客服报数据不用再喊「大概」,直接甩页面链接——内部口径顺了,外部引用才有抓手。
这一节最不能打折的动作是凭证——没有凭证的公开,只是换地方说大话。
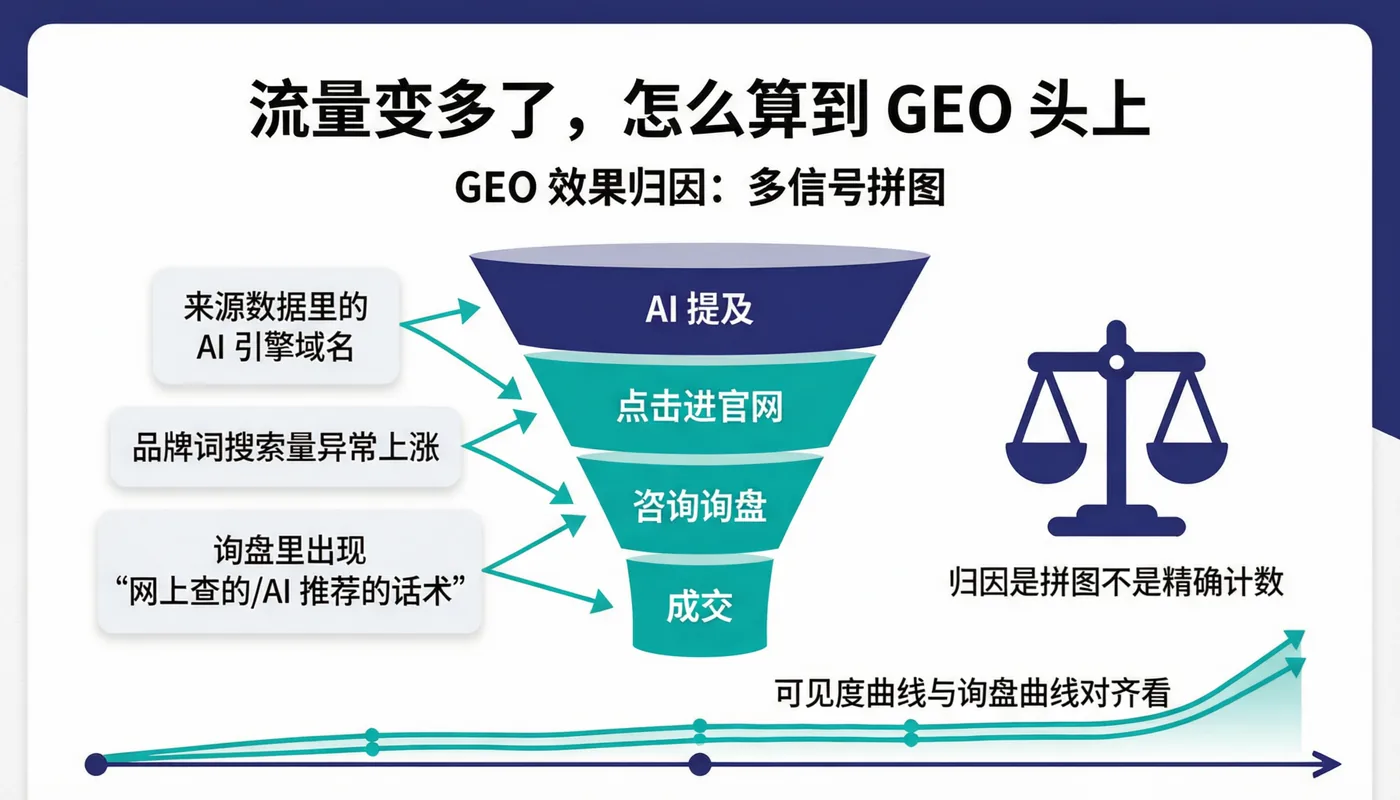
这份公开底账后来成了全公司的单一事实源:市场部、售后、老板本人,对外说话都从这儿取数——「三个版本」的历史彻底翻篇。
案例页的改造最见功夫:原来一页放二十个项目名,现在一页只放一个项目,背景、交付物、验收结果、客户反馈截图,一页一事说得完。
阶段复盘只讨论一个问题:哪些事实本来就该公开却拖了这么多年。会议室沉默了一会儿,没人答得上来——这大概就是大多数企业的通病。
五、删掉实力雄厚之后·多模型可见度代运营这行侧的实录
内容改造撞到的最大阻力不是技术,是习惯:销售习惯夸大,工程习惯保守,两边写的数字对不上。望舒老师的裁决是拿台账说话——页面从此以单据为准。
页面结构统一后,新问题浮出来:各页更新时间乱。望舒老师让在页脚加「信息截至」并纳入巡检表——引用可信度的一半,来自「这是新鲜的」这四个字。
这个多模型可见度代运营这行个案后来贡献了一条课程级的经验:页面改造的收益排序是「结构>事实>文采」——团队曾把文采最好的那页排进被引预测前三,结果垫底;结构最朴素的那张参数表,反而被三家平台轮流引用。
这个个案里改得最狠的是「联系我们的页面」:原来只有一张地图和一个表单,现在加上了「上门需要提前准备什么、看厂流程、接待时段」——望舒老师说,成交前最后一道题也是题,也得有答案等着。
改版期间望舒老师坚持不追「当日收录」:每页上线后至少观察两周再评价。他的理由——抓取、清洗、入索引各有各的脾气,快慢不是质量指标,稳定才是。这份定力在项目群里被学员转述成了一句方言:急啥,让子弹飞一阵。
页面这层完工后,基线表里那 22 道题仍大多没动静——一切在预料内,望舒老师在台账上写下:候选素材已就位,进入复测周期。
页面改造的判断标准只有一条:这句话敢不敢让客户拿去问 AI、AI 念出来变不变味。
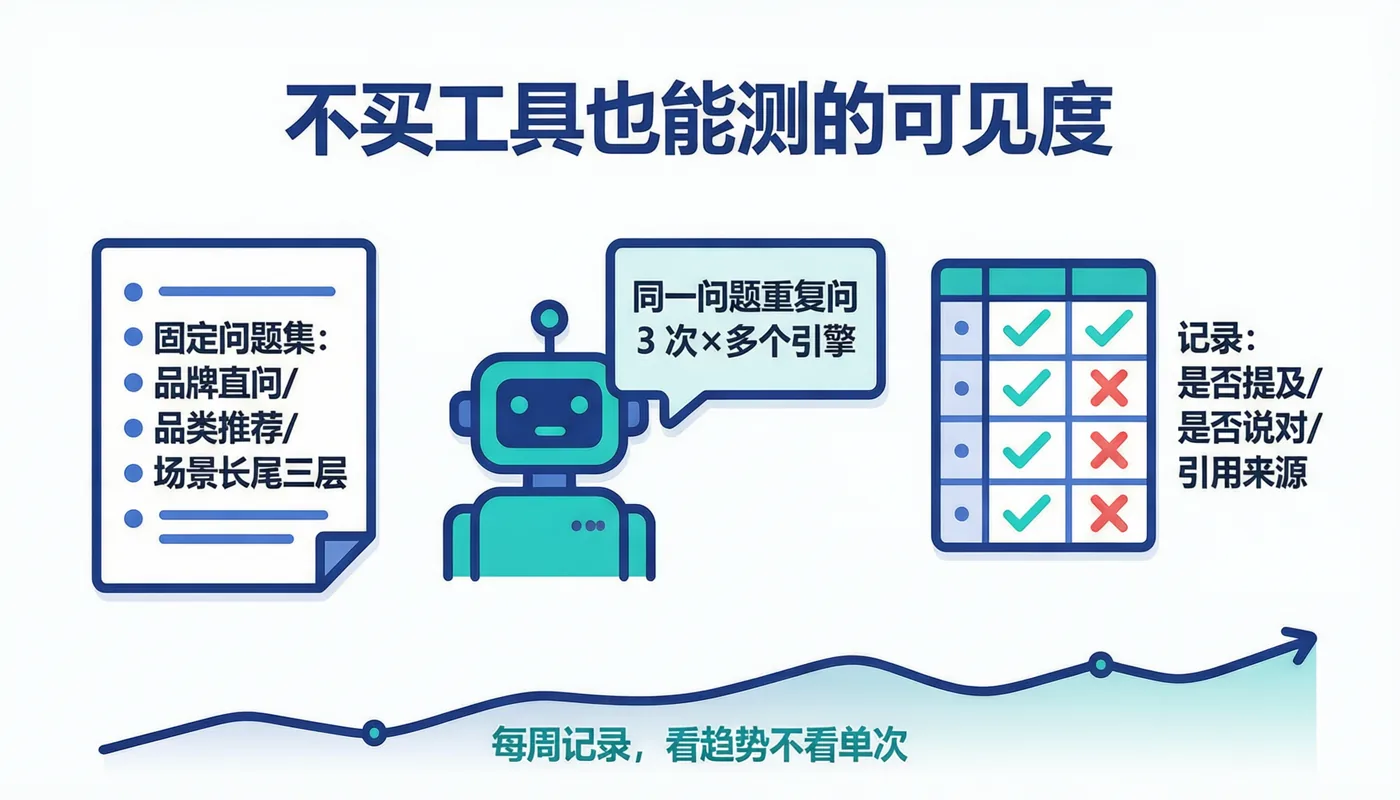
评估报告刻意控制在一页纸:现状差在哪、能立刻改什么、什么不该碰,望舒老师的规矩是「学员读不完两页纸,动作就不会发生」。
评估阶段超出预期的是收录问题,望舒老师把它排进了头一周任务:地基不补,后面写得再多也是给搜索引擎的回收站打工。
三查做完,问题清单浓缩成一句:公开信息太少,仅有的几条还互相打架。模型不是不想引,是不敢引。
基线出来后他没焦虑,反而踏实:问题全在预料内,且每一条都有对应的改法——这大概就是方法给从业者的底气。
六、交付之外的那条线·多模型可见度代运营这行侧的实录
服务过程全程留痕:批改记录、会议纪要、复测表格都随项目档案走——学员团队后来换人接手,翻档案两周就接上了进度。
批改量最大的一周是事实库联调:十四页逐页对凭证,望舒老师连续五晚批到十一点。他后来说,陪跑陪跑,重点不在跑,在陪——关键节点人在,学员就不散。
群里有过一次「深夜改稿」:学员老板自己半夜把质保页重写了三遍发到群里——望舒老师第二天批了八个字:「三遍值得,但制度更值」,随后把「老板亲自改稿」列进了反面案例:说明职责没分干净。服务好一个项目,有时得拦住太热情的人。
服务期里最动人的一小幕:结课前最后一次周会,学员团队把 6 周台账做成了一本翻页册子送给望舒老师,扉页写着「从查无此人对到有的每一页」。望舒老师把它放在书架最顺手的位置,说是「教案之外的教案」。
答疑库积累到第四十条时,望舒老师做了个偷懒的决定:把高频问题写成公开问答页——学员以后先查页再提问。结果提问量降了四成,问题质量翻了一倍:把服务做成内容,一鱼两吃。
这条服务线上没有英雄故事,全是当天批、按时会、留痕、卡验收这些笨事——但学员都承认:笨事不断,才是他们付钱买的东西。
好的陪跑关系像驾校副驾:刹车在我脚下,方向盘在你手里。
移交清单最后签字时,店长问了句「以后没人催,我们还会交作业吗」。半年后的回访台账回答了她——作业还在交,只是批改人换成了市场。
项目档案里存着一份「最忙的一周」记录:学员出差,作业眼看要断——团队年轻人主动接了代发权,望舒老师照批照退。断档没发生,协作惯性就是这么养成的。
结课那天望舒老师在群里发了最后一条批改:「本群转为季度回访群,消息密度降十倍,标准不降」——后来那个群真的又活了两年。
七、零到首次提及的六周——来自广州的档案
结果页的展示方式也讲过规矩:截图必须带提问原文和日期,「AI 说你家靠谱」这种没有出处的夸奖,一律不许进台账。
回测节奏后来遇到学员公司年会撞档,望舒老师的处理是提前一周跑、备注「错峰样本」——规矩是死的,数据的可比性是活的。
复测档案移交那天,望舒老师把表格的编辑权限设为「学员公司只读副本+自建主表」——数据可以给你们,但从现在起,笔要在你们自己手里。这个动作被项目经理私下称为「毕业考最后一题」。
第 6 周台账汇总时望舒老师做了一道「减法演示」:把三个月所有动作按「对引用的直接贡献」排序,排在前三的居然都是枯燥动作——口径统一、出处补全、页面静态化。团队围观后自发把「搞个大专题」的提案撤了。
复测期出过一次让全组脸红的记录:元宝 引用了竞品页面里描述他家的一段话,而那段话的口径比自家页面写得更清楚。望舒老师没批评任何人,只把竞品那段拆成模板让团队照着重写——把羞辱变成教材,是他带项目的固定动作。
复盘会散会前,店长问了个所有人想问的问题:「这算做成了吗?」望舒老师把台账推过去:「每个数你都能自己重跑一遍——你说算不算。」
长尾题先松动、热门题后开花,是本地生意个案的普遍曲线,别拿大厂的节奏焦虑自己。
| 阶段 | 主要动作 | 留档产出 |
|---|---|---|
| 第 1 周 | 建 22 道基线题池,逐平台录答案 | 基线对照表 + 截图档案 |
| 第 2–3 周 | 口径对表,事实底账建档 | 单一事实源底账(凭证编号制) |
| 第 3–6 周中 | 核心页面按「结论—依据—出处」改造 | 改版页面 + 出处链接巡检表 |
| 第 4 周起 | 每周固定题池复测,月度复盘 | 复测台账(提及/引用页/位次) |
| 第 6 周 | 结课复盘,档案移交 | 全案档案 + 季度例行计划 |
改版后出现过一次反复:某页被平台抓到了新旧两个版本,答案里口径混着说。望舒老师带人把旧链接做了重定向并清缓存,顺带立了「一页一址、改版留档」的规矩。
六周,十四页,删掉的字数比新增的多——这大概是多模型可见度代运营这行这个行业里,头一回有人花钱做「减法」,而减法恰恰是引用逻辑里最贵的那部分。
页面图片全部补了文字说明:原来一张车间照片配一句「先进设备」,现在写明设备类型、数量口径与投用年份——图片是给人看的,说明是给机器摘的。
八、结课不结账(望舒老师指导个案)
学员团队自己总结的变化最说明问题:以前写内容先想「怎么写得好看」,现在先问「这句话客户拿去问 AI,模型查得到出处吗」——提问顺序变了,就是最大的收获。
学员爱观察,也观察出了方法之外的一课:望舒老师批改作业时把「不确定」标成「待核」而非直接删——对待未知的诚实态度,比任何技巧都先被学到。
望舒老师在移交会上说过一段不太像讲师的话:这套方法三年后大概率要改——模型在变、规则在变,最不用重学的是「把话说清楚、把证据留好」这门基本功。把功课押在不变的事上,是这门课给所有焦虑行业的建议。
复盘材料里有一页对比图:第 1 周和第 6 周,同一道「怎么选」题的答案。左边通篇泛泛而谈,右边出现了他家页面里的两个具体说法——这页图被销售拿去用了无数次,每次结尾都是那句:AI 不偏心,它只是读到过谁。
如果非要在这个个案里挑一个「最大功劳」,望舒老师给了那页「不适合清单」:它没带来最多提及,却带来了最像样的客户——引用质量决定询盘质量,这条链路在这个多模型可见度代运营这行企业身上闭合了。
这个多模型可见度代运营这行个案教给课程的最后一课:方法的生命力不在课件里,在学员结课九十天后还在不在跑台账——目前看,在跑。
多模型可见度代运营这行行业看这篇记录,重点看动作清单,别盯效果数字——数字是别人家的果,动作是自己家的肥。
记录到此为止。所有数字可复验,所有动作可复盘,所有边界已写明——剩下的,是每位读者自己厂里的事。
被问到「值不值」时,学员给过一笔账:6 周投入约等于半台设备的钱,换来的是全公司对外说话的方式——这笔账怎么划算看各人,但账本本身是真实的。
最后把话说回边界:这份记录里的一切,请以「一家账本对得上的多模型可见度代运营这行企业,在 6 周里认真做完了课程动作」来理解——除此之外,它不承诺任何事。
九、先对照这几条再动手
- 有没有一张「客户会问 AI 的原题」清单?没有的话,先做 22 道再说其他。
- 页面关键信息是不是藏在图片、折叠区或脚本渲染里?是就全部提出来——机器读不到的等于不存在。
- 旧页面有没有人认领?没人认领的旧信息比没有信息更危险,先清理再新建。
- 对外发布的每个数字,有没有人知道原件在哪?没有,先建凭证编号制。
- 团队发布新页面前,有没有「照页念一遍」的互检动作?没有的话,把质量关设在嘴皮上。
- 有没有「不适合我们」的坦白页?没有就补一页——敢划边界的信源才有人敢引。
- 复测有没有固定题池、固定节奏、固定判据?三者缺一,你的「效果」就只是心情。
- 官网每页能不能找出至少三个可核验事实句?找不出,先补事实再谈改版。
- 页脚的「信息截至日期」在更新吗?三个月没动过的日期,正在替你贬值。
记录边界:本个案为特定城市、特定行业、特定执行团队条件下的结果,方法可参考,数字不可外推;所有平台表现以留档截图为准。