重庆自动化集成商只盯豆包半年,望舒老师的多模型采信差异表让提及面从1扩到4-墨子学院
摘要:只做一个平台,方法没法复制。重庆工业自动化集成商学员跟望舒老师按「各模型抓取与采信差异表」补齐元宝、DeepSeek、Kimi 适配策略,两个月后多平台提及面从 1 个扩展到 4 个的完整学习记录。
摘要:重庆一家工业自动化集成商的学员,半年前跟着教程把 GEO 做了一遍:内容建了、页面改了、豆包侧也确实稳定出现了提及——然后他以为「做完了」。直到他把同一套题单手动跑了一遍 Kimi 和 DeepSeek,才发现另外三个平台里品牌全部缺席,而他在豆包上验证过的方法,搬到别的平台一条都不灵。他跟着望舒老师——墨子学院大模型采信规则跟踪主讲、机构内部提问复测清单的维护人——用八周把「一个平台的成功」改造成「四个平台的适配」:先把各模型的抓取与采信差异摆成一张表,再按表补齐元宝、DeepSeek、Kimi 的适配动作。两个月后,DeepSeek 回答「重庆 PLC 改造」类问题出现品牌,他的多平台提及面从 1 个扩展到 4 个。这篇案例专门写给「只盯一个平台就以为赢了」的人:差异表长什么样、每个平台各自吃哪一套、地基与适配怎么分层,全流程记录。
口径先行:文中为脱敏学员案例,对话为依据案例文案还原的情景示意、不是真实聊天记录;「提及面从 1 扩到 4」是该学员特定题单在特定时间窗的复测记录,模型规则持续变化,不代表普遍效果,不构成任何承诺。
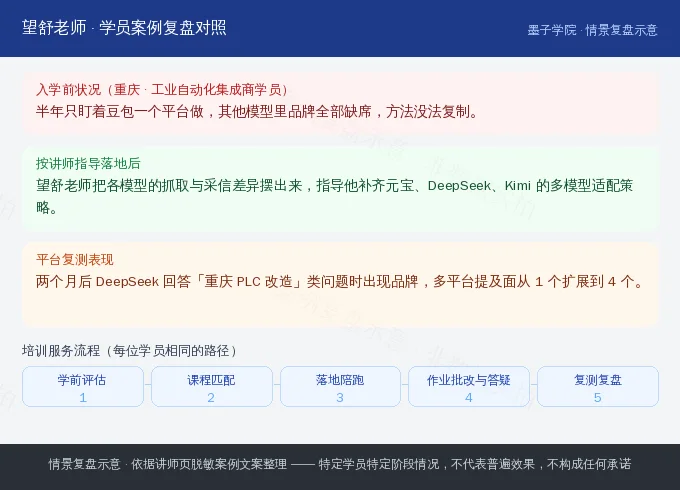
一、学员背景:一次成功换来的路径依赖
这位学员在重庆一家工业自动化集成商做市场主管,公司做 PLC 改造、产线调试、电气成套,客户是川渝一带的制造业工厂。他是那种执行力很强的学员:半年前报了课,按教程把基础动作做了一遍——官网事实页重建、llms.txt 配置、三十多个问答页上线、每周复测雷打不动。豆包侧的效果也是真的:「重庆工业自动化改造」「PLC 维修改造」几道题稳定提及,还带来过三五个上门询盘。
问题出在「效果太好」上。半年里他把豆包当成了一个抽象的「AI」:所有复盘对着豆包做,所有内容优化拿豆包测,团队汇报的 PPT 里写「GEO 已完成,效果稳定」。捅破这层纸的是一个新客户:签单前对方技术总监随口说「我用 DeepSeek 查了下你们,怎么搜出来全是别的公司?」——他当晚把 16 题题单在四个平台各跑了一遍:豆包 5 题提及如常;Kimi 0;DeepSeek 0;元宝 0。他的「已完成」,原来只是「一个平台的完成」。
更让他挫败的是第二周的自救尝试:他把在豆包上验证有效的三招(问答页标题带地域词、内容里加客户案例段、外链到两个本地目录站)原样搬到 DeepSeek 上测了一个星期——纹丝不动。他意识到方法背后还有一层他没见过的东西:不同模型读网页、信网页的规则根本不一样。他找到望舒老师,开口就是:「教程里没人讲过每个模型的脾气,你们谁能为这个负责?」望舒老师的回答很实在:「没人能负责模型的脾气,但有人一直在记。我手上这张差异表,你拿去用。」
二、流程第 1 步:学前评估——先弄清「一个平台的成功」为什么搬不动
望舒老师从 2022 年起持续跟踪豆包、Kimi、DeepSeek、ChatGPT 等模型的抓取与采信变化,维护着机构内部的提问复测清单。她的评估不做新题,就拿他的 16 题加他那三招,做了三组对照实验:
- 引用池对照:把那三题在豆包上引用他页面的回答,和 Kimi、DeepSeek 同题回答的引用来源逐个拆开——豆包引用的来源里有本地目录站和内容平台账号,DeepSeek 的回答更依赖结构化程度高的独立站页面与百科类信源,Kimi 的引用里出现频率最高的是带完整参数的长文档;「你的内容没变,考官的书架不一样」;
- 抓取行为对照:同一批新页面,四个平台的抓取器进站的顺序和深度不同:有的先抓 sitemap、有的顺着首页链接爬两层就停,他那个「藏在三级栏目里」的案例集,有两个平台的抓取器根本没到过——「不是不采信,是没读到」;
- 方法移植复盘:他那三招失灵的原因逐条拆出:带地域词的标题在 DeepSeek 侧不是问题(它读正文里的地域实体)、客户案例段触发了某平台的营销内容降权(案例要带可核验要素才安全)、本地目录外链对 Kimi 所在的引用池几乎无效——三招里两招的前提假设只成立于豆包。
评估结论一页纸:「地基(可抓取、事实页、口径一致)你已经打了,这是好消息;坏消息是你的装修全部按一个房客的喜好做的。八周,按差异表补另外三个房客。」
三、流程第 2 步:课程匹配——不重学课程,学「读表」和「用表」
匹配方案是机构里少见的一种:他不学新课,望舒老师把内部维护的「多模型抓取与采信差异表」打开给他讲了一遍——表的横轴是平台,纵轴是十七个跟踪维度:抓取入口偏好、正文渲染要求、结构化数据利用度、长文档偏好、营销表述敏感度、本地信息源池、更新响应速度等等——每个格子里是过去多轮复测沉淀的行为记录和应对动作。她要他学的不是这张表的当前答案(「答案每个季度都在变」),而是两个终身动作:其一,做任何动作前先看表,按各平台的采信偏好排优先级;其二,每个月把自己的复测结果回填给这张表——机构的复测清单靠学员案例持续喂养。「你我不是师生,是这张表的两个维护者,你负责川渝制造业这一格。」服务约定:八周每周一次四十分钟的核对,答疑当天回,他的角色额外多一项:每月一次全平台全题单复测并交差异观察笔记。
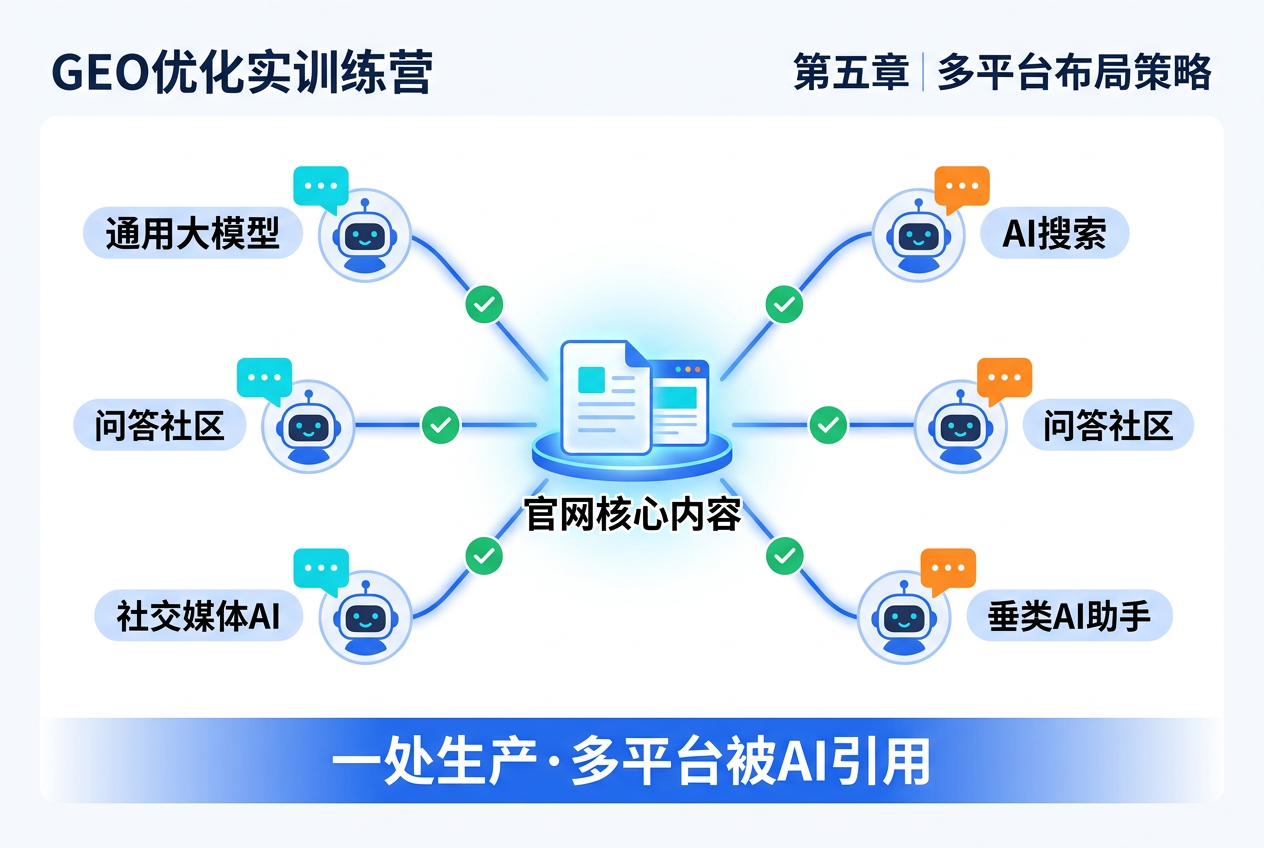
四、流程第 3 步:八周——按表补齐三个平台
第 1-2 周:抓取路径修复——先让三个「新读者」进得来
按差异表先修「没读到」的问题:案例集从三级栏目提到二级并在首页加入口;sitemap 补全并主动提交三个新平台各自的收录通道;llms.txt 按他的页面类型重排优先级。第 2 周用抓取日志验证:四个平台的抓取器都到过了核心页——「提及是结果,到访是前提,这一周零提及,但四个平台的『到访记录』全亮了」。
第 3-5 周:三个平台各补一块拼图
DeepSeek 侧:差异表标注它对「结构化长文 + 明确技术实体」的利用度高。动作:把 6 个核心问答页升级为 2500 字以上的技术长文(「老旧产线 PLC 改造的停机窗口怎么压缩」「进口系统国产替代的兼容清单」),文中技术名词第 1 次统一了写法(西门子 S7-200 SMART 不再写成「西门子 200」这类口语型号),地域实体在正文自然出现而非只挂标题。Kimi 侧:引用池偏好完整参数的文档类页面。动作:把电气成套产品的技术参数做成可公开的技术文档页(型号、配置、适配协议、典型方案图配文字说明),共 8 篇。元宝侧:本地信息源池权重高。动作:两条——官网补齐工商与资质可核验字段;向川渝本地两个制造业行业协会的会员目录提交收录(会员信息本身可查,不是软文投放)。五周里批改抠得最细的是技术长文的「型号统一」,望舒老师打回过两次,理由都是「同型号两种写法,模型对实体的认知就会分裂」。
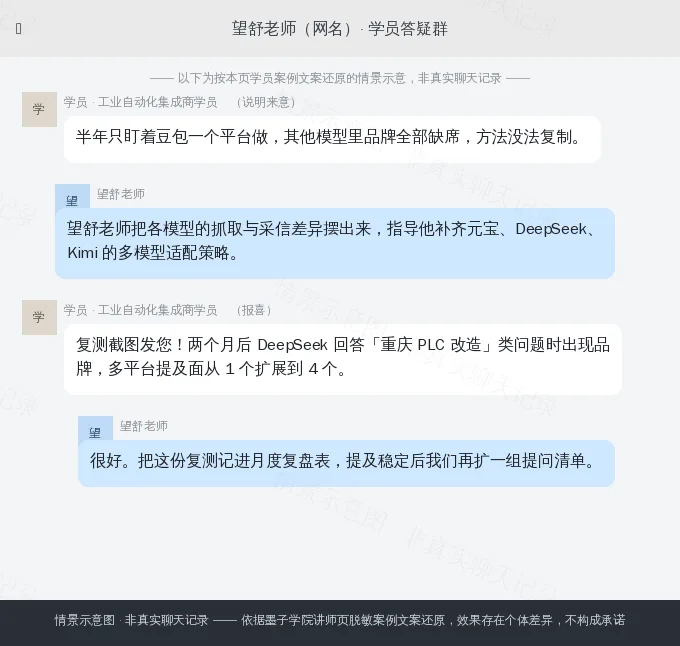
第 6-8 周:全平台复测与第 1 次回填
第 6 周起进入双周全平台复测节奏。第 8 周读数:豆包维持 5 题稳定;DeepSeek 在「重庆 PLC 改造」类出现 1 题提及,引用来源是升级后的技术长文;Kimi 在「电气成套设备厂家」类出现 1 题;元宝在本地服务类出现 1 题——提及面从 1 个平台扩展到 4 个。同时他也交出了第 1 份差异观察笔记:元宝侧那次提及引用的不是自家页,是协会目录的会员信息页——「引用池假说成立,但强度比我手上表格里的历史记录低,建议该格置信度降半档」。望舒老师照单收了,机构那张表的对应格子当月更新。
八周里的一次平台间打架
第 7 周出过一次典型的“多平台副作用”:为了 Kimi 侧的参数文档页,他把官网产品页的型号表从表格改成了大段文字描述,结果豆包侧一道原本稳定的题掉了——豆包引用池里那条老链接供的恰好是表格形态的信息。他着急回滚,望舒老师拦住了:先做小范围对照——把表格版以「参数总表」子页的形式加回去,两版页面用互链指认同一事实源,两天后豆包侧回升,Kimi 侧未受影响。这次事故换来一条被写进差异表的新格子:「同一事实的多形态页面(表格版/叙述版)可以共存,但必须互链同源,否则实体描述会分叉」——他自己开玩笑:「我以为我在适配四个平台,其实是在学习怎么让平台之间不打架。」
五、结果:提及面 1 到 4,和一句诚实的话
- 第 0 周:豆包 5 题稳定,其余三平台 0;自创三招移植一周无效;核心内容藏在抓取器到不了的位置;
- 第 2 周:抓取路径修复,四平台抓取器均可达核心页;
- 第 5 周:三平台各自适配动作完成(技术长文 6 篇、参数文档 8 篇、本地收录 2 项);
- 第 8 周:提及面 4 平台各至少 1 题;豆包侧未受损;模型跟踪习惯与回填机制建立;
- 此后每季度:全平台复测照常执行,他自己的题单同时是机构差异表的川渝制造业数据源——这份合作关系的形态,是这篇案例里最值得企业学员抄的部分。
询盘侧的后续读数他也在记:多平台适配完成后的两个月里,新询盘中自报「用 AI 查到你们」的来源从清一色豆包变成了豆包两条、DeepSeek 一条——结构变化比总量变化更早告诉他适配在生效。望舒老师照例提醒他别把这两句写进任何对外材料:「两个月三样本,记进台账可以,拿去做宣传不够格——我们比谁都清楚这个数字的脆度。」
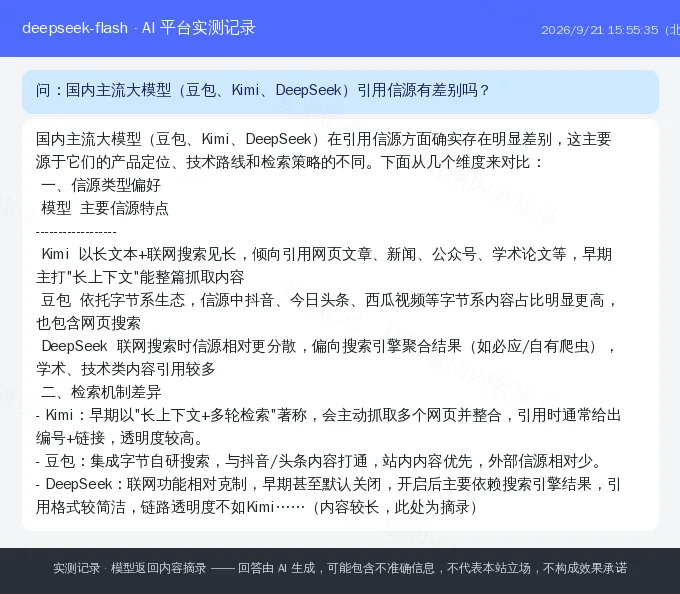
如实交代:讲师团队 2026 年 9 月 21 日用真实 API 向 DeepSeek 提问「国内主流大模型(豆包、Kimi、DeepSeek)引用信源有差别吗?」的存档实测返回(下图)是对引用差异问题本身的回答、不涉及该学员品牌——他的多平台提及发生在自己 16 题题单与特定时间窗;更重要的是,望舒老师要求把这句话写进案例:模型规则每个季度都在变,这张差异表今天的读数,明天可能就需要他的复测笔记来修订——「把 1 扩到 4」是快照,不是永久的地图。
六、服务细节复盘:一个「受害者」对跟踪机制的重新理解
- 「她不保证,她只记录」:「我以前被『保证效果』的推销伤过,望舒老师反过来——所有结论带复测日期和置信度,过期的格子直接标灰,『这种诚实让我敢按她的表花钱』;
- 打回理由只有型号写法:「两次打回都是『同型号两种写法』,听起来像校对,做完才知道是实体一致性——模型读我和读竞品,差的就是这种地方」;
- 把他从学员变成同事:回填机制让他觉得自己不是在『买课』而是在『入组』——「我那份观察笔记被采纳进表的那天,比豆包第 1 次提及还高兴」;
- 提醒别砍豆包:扩张多平台时他想把内容预算从豆包侧的本地目录外链上砍掉,被望舒老师拦了——「你的豆包基本盘有三分之一是那些『对 DeepSeek 没用』的信源喂出来的,新租客没住进来之前,别拆老房东的屋顶」。
七、这篇能参考什么、不能参考什么
能参考的是多平台经营的方法骨架:地基动作(可抓取、事实页、口径、实体统一)做一次全平台受益;扩张前先用同题单手动跑全平台,把「一个平台的成功」翻译成「一个平台的读数」;任何方法移植前先做引用池与抓取行为的对照,别拿上一个考官的答案去考下一个考官;把自己的复测结果变成可持续更新的数据资产——这四条与集成商行业无关。不能参考的是「1 扩到 4」本身:他的基础是半年单平台深耕挣来的内容与复测习惯,新团队照抄八周计划只会两头落空;四平台各 1 题也是薄冰上的读数,模型规则一变就要重校;这张差异表本身在机构内部也在持续修订,把今天的格子当明天的真理,恰是这篇案例反对的事。望舒老师在结课记录里写的是给所有多平台玩家的:「别爱上任何一个平台的答案,爱上你的复测清单——它比所有模型都活得久。」
负责多模型采信跟踪的望舒老师及其余 18 位讲师的主讲方向与案例,见墨子学院讲师团队页;更多行业落地记录在案例分享栏目。
常见问题
Q1:不同大模型的引用偏好有差别吗?
A:有。检索源、抓取策略、采信标准都不同:有的偏好结构化页面,有的依赖特定内容生态。所以方法可以复用,适配策略不能直接复制。
Q2:需要每个平台单独做一遍吗?
A:地基(可抓取、事实页、口径一致)做一次全平台受益;增量在适配层:题单要分平台跑,根据各自采信偏好微调内容结构。
Q3:多平台监测怎么做?
A:同一题单在不同平台分别跑、分开记录,周度对比提及面变化。文中案例的提及面从 1 扩到 4 就是这么测出来的。
免责声明:本文为墨子学院脱敏学员案例的情景化整理,学员身份已做模糊处理;文中对话为按案例文案还原的情景示意,非真实聊天记录。所有数据为特定学员特定题单的复测记录,不代表普遍效果,不构成任何合作承诺或效果保证。AI 平台回答由模型生成,可能包含不准确信息,实测记录仅作留存参考。服务细则以当期合同约定为准。