Claude 没有 Search Console 怎么监测:三条腿的可观测体系-墨子学院
摘要:Gemini 有 Search Console 兜底,轮到 Claude 时很多团队会卡住:公开对话可回测,但企业内网、Claude Code、客户 RAG 里的引用看不见摸不着。本文讲 Claude 的三条腿监测体系——公开对话固定提问集、沙盒 RAG 模拟客户内部通道、客户季度反馈,以及提问集设计、日志表模板、更新频率与团队分工。核心结论:三条腿各留一个可核对的资产,半年就能看出趋势。
摘要:Gemini 有 Search Console 兜底、ChatGPT 有联网浏览与训练语料两条明面上的通道可以观察,轮到 Claude 时很多团队会卡住:公开对话可回测,但企业内网、Claude Code、客户 RAG 里的引用你看不见也摸不着。Claude 的监测不是"接一个工具就好",而是"三条腿一起走"——公开对话固定提问集做基础面,沙盒 RAG 模拟客户内部通道,客户季度反馈拿真实企业场景的一手截图。本文把这三条腿的执行细节、日志模板、提问集设计、频率与分工讲透,帮你搭一份能覆盖 Claude 全场景的最小可观测体系。核心结论:Claude 监测不追求一次做全,三条腿各留一个可核对的资产,半年就能看出趋势。
一句话先说结论:Claude 的可观测度是三家 AI 平台里最"分层"的一档——公开层能问、企业层难看到;把"公开提问集 + 沙盒 RAG + 客户季度回传"三条腿一起跑,才是 Claude GEO 监测的合理形态。
前几篇我们讲了 Claude 的语料层、审慎表述、工具集成、判断链、长文档解析、企业内网通道、跨平台合流、多语言实体。第八篇结尾我们说:Claude 上监测是它自己的学科。这一篇把它讲透——为什么它跟 ChatGPT、Gemini 都不同、三条腿各自怎么执行、日志长什么样、团队怎么分工。
一、Claude 监测为什么和 ChatGPT、Gemini 都不一样
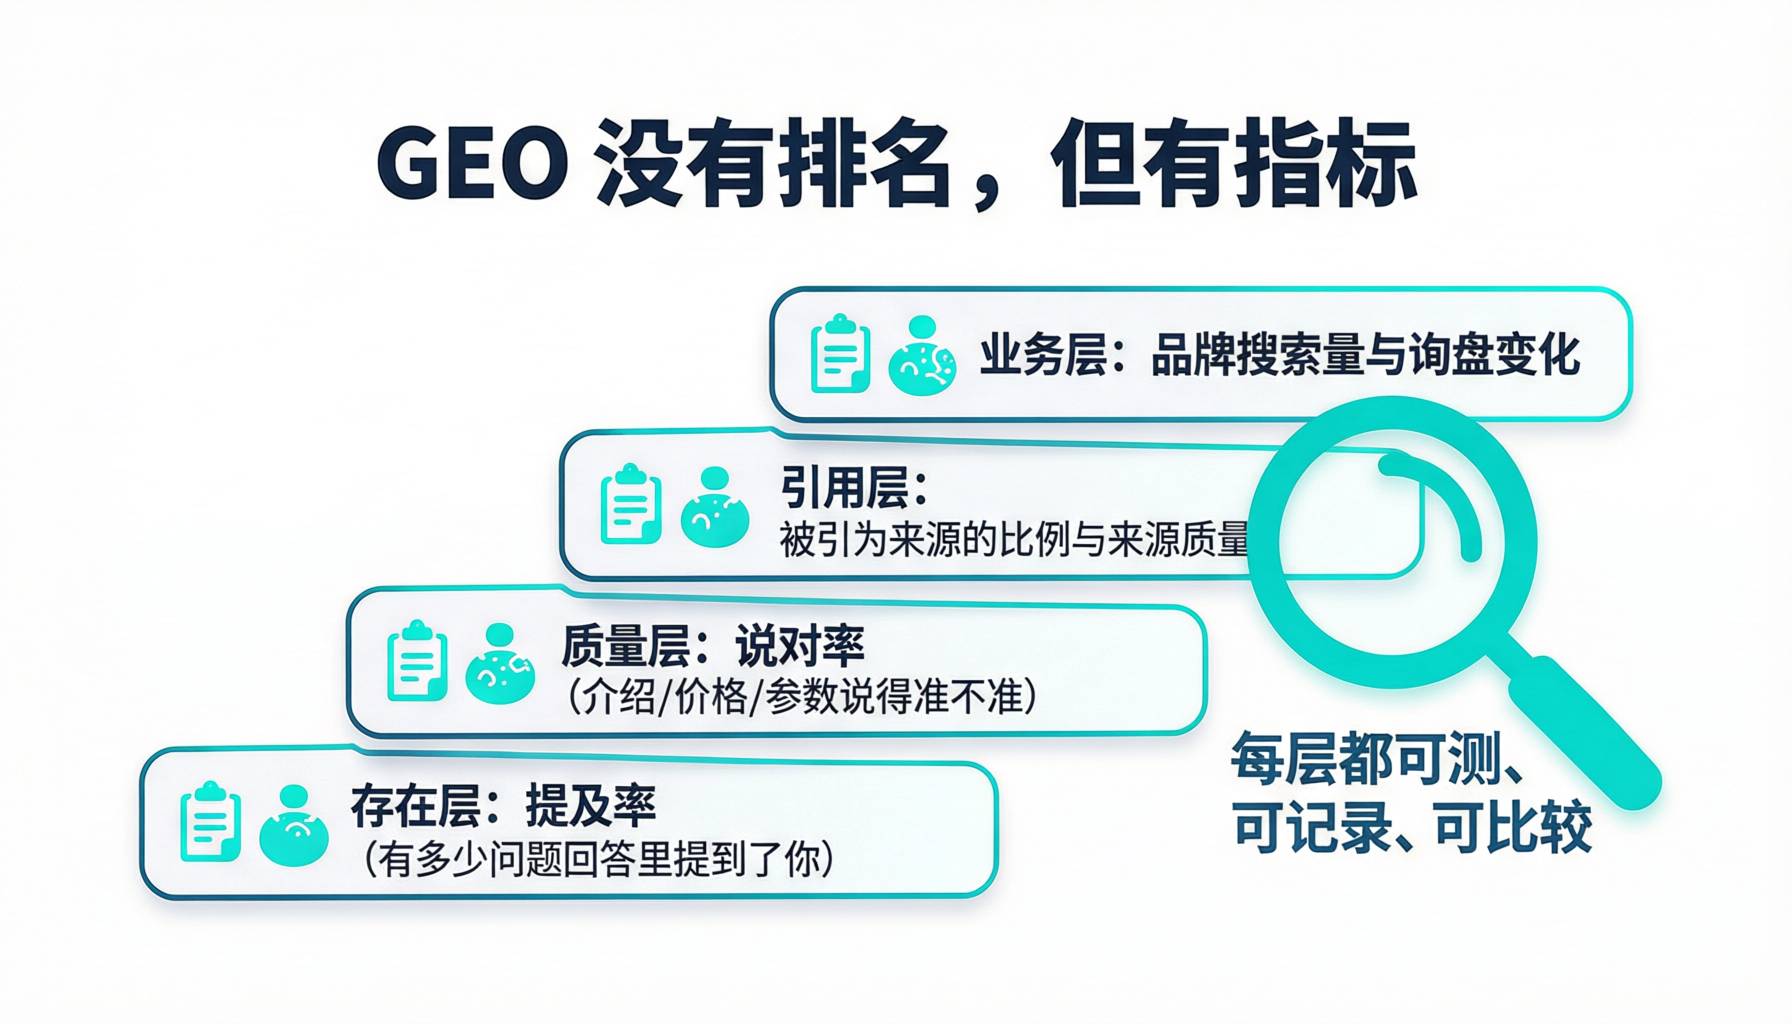
Anthropic 到目前为止没有推出类似 Search Console 的官方监测面板,也不像 Google 会在 AI Overviews 报表里给你看部分曝光数据。Claude 的可观测度是"公开可问、内网不可见":公开对话(claude.ai / API 公开查询)任何人都能问、能截图;企业侧(Claude for Work、Claude Code、客户自建 RAG)由 Anthropic 与客户共同保护隐私,你无法通过外部手段看到员工在里面问什么、Claude 怎么答。这个二元结构决定了:你必须用组合手段做监测,光靠一条腿会漏。相比之下,ChatGPT 主要靠公开对话 + 训练语料的间接信号,Gemini 靠 Google 生态的地基数据 + AI Overviews 报表;三家的可观测度模式不同,工具搭配也不同。
二、头一条腿:公开对话固定提问集
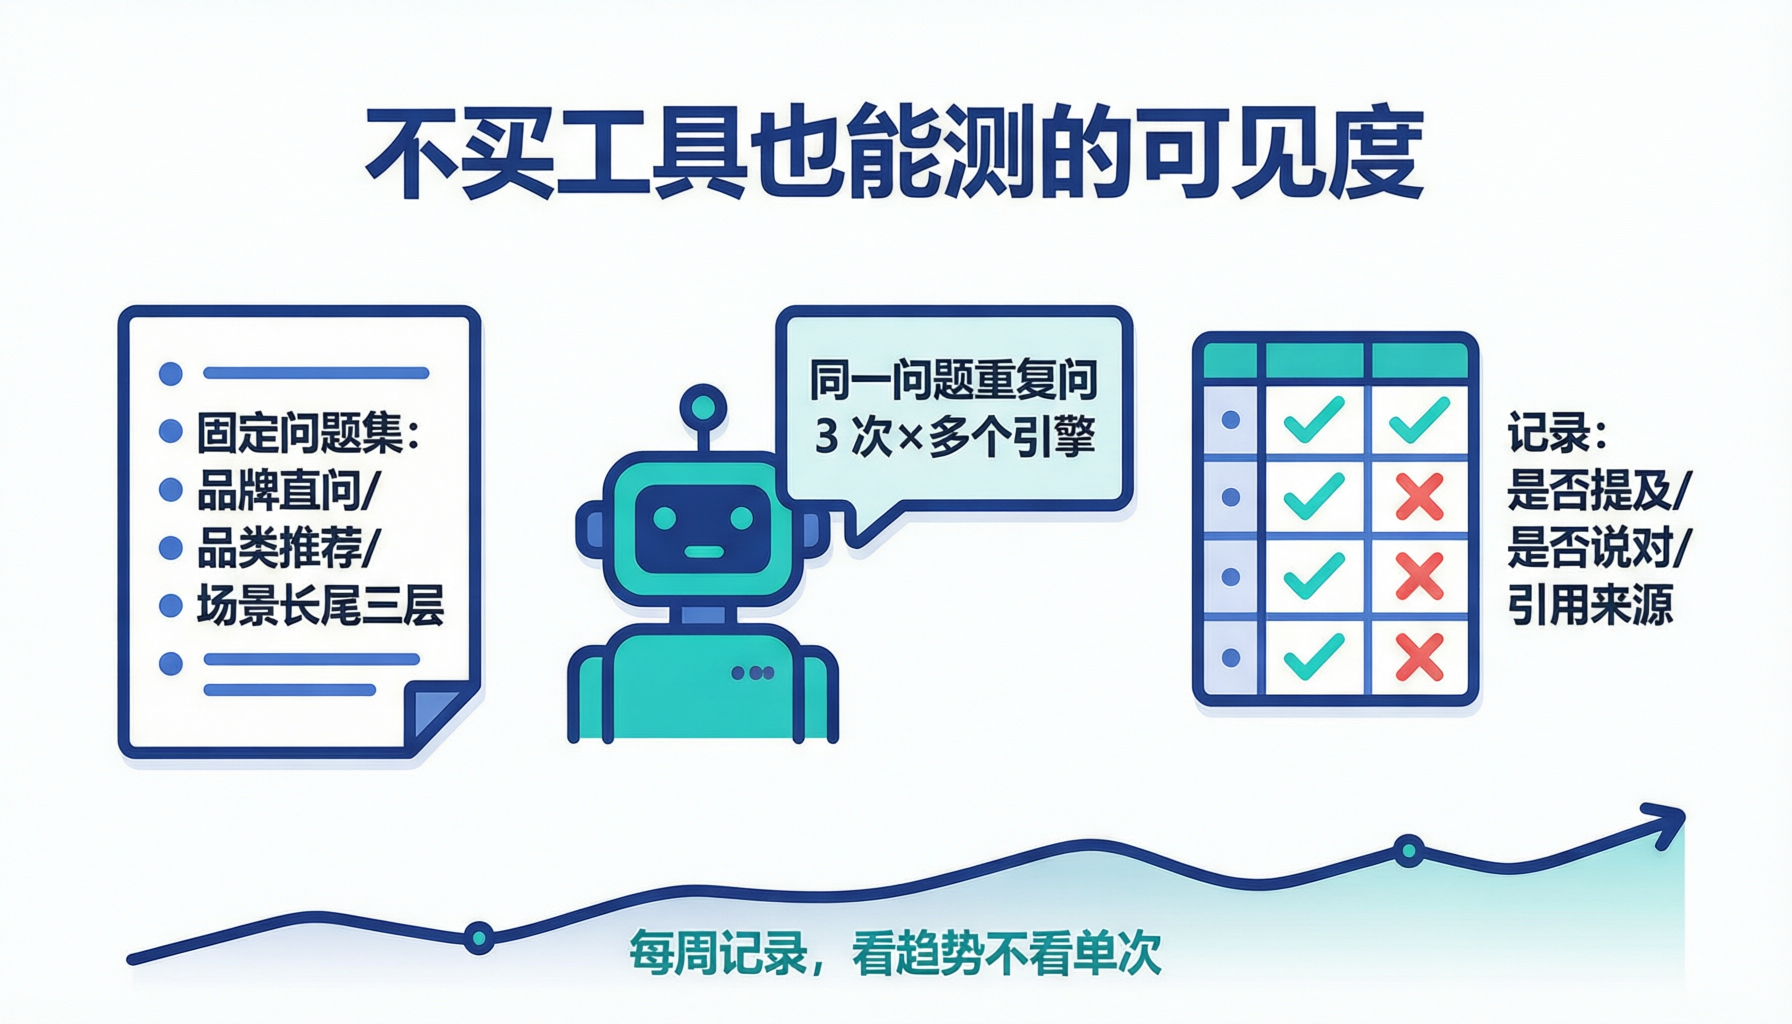
这一条最容易启动。做法和 ChatGPT 系列里讲过的很接近,但问题集要为 Claude 的场景做二次裁剪。准备 30-50 条中英双语提问,覆盖四类意图:介绍类("介绍一下 XX 公司 / tell me about XX")、能力类("XX 的能力清单是什么 / what does XX offer")、比较类("XX 和 YY 差别在哪 / how is XX different from YY")、集成类("如何集成 XX 的服务 / how to integrate XX")。每季度固定日期在 claude.ai 上逐条问一遍,把回答截图 + 复制文本存入日志表。关键动作是"固定"——同一批问题、同一时间窗口、同样的记录格式,才能做时间轴对比。随机问、临时问,只能拿到碎片,看不出趋势。提问集不需要每天跑,季度节奏足够,因为 Claude 的公开对话更新节奏没有 Google 那么快。
三、第二条腿:沙盒 RAG(自己搭一个"客户视角"的 Claude)
企业内网看不到,但你能模拟。用 Anthropic API + 一份向量库(Pinecone / Weaviate / pgvector 都行),把你公开可访问的所有材料——官网重点页、白皮书、集成指南、开发者文档、FAQ——按客户可能的方式切片索引进去,然后在你自己搭的沙盒里问同类问题。沙盒 RAG 不能替代真实客户环境(客户还会加合同、Slack 历史、内部邮件),但它能提前暴露两类问题:一是"你能给的公开材料在切片后是否还能被抽准",二是"如果客户按最常见的方式切片,模型会看到什么样的你"。沙盒每季度跟着公开材料更新一次;跑通后再去看客户回传的真实截图,就能大致推断偏差来自哪一层。
四、第三条腿:客户季度反馈
这一条最"土",也最值钱。跟核心客户约一个季度沟通的常规项:请他们在自己内部 Claude(Claude for Work / 客户自建 RAG)里问你品牌的 3-5 条固定问题,把回答截图回传给你。很多团队不好意思开口,怕客户觉得"你怎么关心这些"。其实反过来——客户愿意帮你截图,说明你们关系够近;不愿意截图的,本来也不会给你真实反馈。回传的截图存进日志表,和沙盒 RAG 的输出对齐看:如果沙盒抽出得挺准、客户看到的却乱七八糟,问题多半在客户切片配置或索引版本;如果沙盒就已经抽不准,问题在你的公开材料本身。这一条腿能覆盖 Claude 少见"看不见的企业战场",值得团队把它当作季度例行日历的固定项。
五、提问集模板:一份能直接抄的中英 30 条
下面这份不是穷举,是给团队起步用的模板。中文 15 条:介绍一下 XX;XX 是哪一年成立的;XX 主要做什么;XX 的服务范围;XX 和 YY 有什么不同;XX 适合什么类型的客户;XX 的定价逻辑;XX 集成方式;XX 的客户案例;XX 的技术栈;XX 的团队规模;XX 的注册主体;XX 的办公地址;XX 是否服务海外客户;XX 的常见问题。英文 15 条:tell me about XX;when was XX founded;what does XX offer;how is XX different from YY;who should use XX;how does XX price;how to integrate with XX;any XX case studies;what stack does XX use;is XX a China-based company;what's XX's legal entity;where is XX located;does XX serve global clients;common questions about XX;any known limits of XX。这 30 条能覆盖介绍、能力、边界、集成、主体、限制六个高频意图,从公开对话到客户内部问答都通用。
六、日志表:一份最小的 Claude GEO 监测表
Claude 场景多、可观测度分层,日志表如果太重,团队跑不动。推荐最小版本,一张表 8 列:日期 / 通道(公开 / 沙盒 / 客户回传)/ 问题编号 / 问题文本 / Claude 回答要点 / 引用来源(如可见)/ 与上次差异(一致 / 漂移 / 错认 / 缺项)/ 处理动作。"与上次差异"这一列最关键——不要每次重新读全文,只判断这条回答相对上次是不是稳。"漂移"指事实变了但方向对、"错认"指品牌被说成别的、"缺项"指某项能力被漏掉——三种异常触发三种处理。日志表用飞书多维表格 / Notion / Google Sheets 都行,重点是团队每季度都往同一张表里灌,半年后回头看趋势就很清楚。
| 通道 | 更新频率 | 能观察什么 | 典型异常 |
|---|---|---|---|
| 公开对话提问集 | 季度 | 模型层面对品牌的整体印象 | 能力清单漂 / 主体信息错 |
| 沙盒 RAG | 季度或大版本迭代 | 公开材料切片后的抽取质量 | 切片断句错 / 版本滞后 |
| 客户季度回传 | 季度 | 真实企业场景的引用形态 | 材料版本老 / 客户切片配置差异 |
七、更新频率与团队分工
Claude 三腿监测不必每天跑,季度节奏足够;但如果发生下列事件,就临时加测一次:品牌改名、能力清单调整、官网改版、白皮书出新版、被第三方大规模误报。团队分工推荐:公开提问集由内容负责人做(因为要判断回答文本的准确性);沙盒 RAG 由技术负责人维护(搭建 + 索引更新);客户回传由客户成功或销售对接(这本来就在他们的沟通节奏里)。三条腿各自有归属,避免"监测是 GEO 团队一个人的事"这种孤岛设定。季度末由 GEO 负责人做一次合并复盘,把三张表叠成一份"本季度 Claude 可见度报告"给管理层。
八、怎么判断"引用漂移"
三腿日志跑一到两次,你会发现 Claude 的回答不是全有全无,而是"部分漂"。常见四种漂:能力漂——某项能力上次说了、这次没说;数据漂——客户数、成立年、覆盖行业等具体数字与官方口径不符;关联漂——把你的品牌错误关联到另一家相似名字的公司;边界漂——上次说了"不适合 X 场景"、这次却推荐你做 X。每种漂的修复路径不同:能力漂与数据漂通常回到"公开材料一致性"这条主线修;关联漂要检查公开语料里是否出现同名歧义并加显式区分;边界漂是最难捉摸的一种,往往说明模型在你给它的材料里读到了矛盾信号。发现漂移先别急着改,回到日志表对照过去两次记录,判定是模型侧变化还是材料侧变化,再动手。
九、常见误区
- "Claude 没有官方面板,那就不监测了。"没有官方面板不等于没有可观测度。三条腿各自跑起来,能覆盖 80% 关键场景。
- "公开对话问一次就行。"问一次只能拿到切片,看不出趋势;提问集的价值在"同一批问题在不同时间点的对比"。
- "客户内部 Claude 我看不到,问了也白问。"客户愿意帮你截图是关系的证明;不愿意帮你的客户,本来也不会给你真实反馈。
- "沙盒 RAG 就是自娱自乐。"沙盒不是完美模拟客户环境,是"提前把公开材料的问题暴露在自己面前",比等客户反馈回来再修便宜得多。
- "日志表越详细越好。"详细到团队不愿填,就等于没有。8 列最小版本比 25 列豪华版更跑得动。
十、两个案例:三条腿跑通后的复利
案例一 · 沙盒先漂,客户回传跟着漂,暴露材料版本问题
一家 B2B 服务商每季度跑一次三条腿。某季度沙盒抽出"客户数 200+",客户回传截图里也是 200+,但官网已经改成 300+ 两个月了。他们顺着这条线查,发现是因为英文版首页改版晚于中文版,客户 RAG 索引按英文版抓的。改英文首页、强制客户重推索引,下季度回传截图就正常了。教训:沙盒与客户回传交叉验证,能提前 1-2 个季度发现问题;单看公开对话完全看不出来。(个例,不代表普遍结果。)
案例二 · 提问集发现"关联漂",及时加显式区分
一家做数据分析的公司名字里含一个高频英文词,公开提问集回测发现 Claude 有时会把它和另一家同词的国际品牌混着说。他们在中英官网首页与关于页加了一段"我们和 XX International 没有关联"的显式说明,同时在白皮书末尾补了主体注册信息。两季度后回测,混淆明显减少。教训:模型不会主动区分同名品牌,你不写它就一直混。(个例,不代表普遍结果。)
十一、关于 Claude 监测与回测的常见疑问
Q:我们预算只够一条腿,先做哪条?
A:先做公开提问集。这一条启动成本最低、能覆盖最广的场景(公开层与训练语料层的印象都会体现),并且能给你的内容团队最直观的反馈。第二档再上沙盒 RAG,第三档做客户回传——客户回传需要一定的商务关系基础,不适合冷启动阶段做。
Q:三个通道结果不一致时以哪个为准?
A:以"离商务决策最近的"为准。客户回传 > 沙盒 RAG > 公开提问集——客户回传最贴近真实企业场景,沙盒是本地可复现的近似,公开提问集是模型印象。三者一致最好;三者分歧时,优先按客户回传的方向修,其次按沙盒,最后再看公开提问集。
Q:提问集能不能自动化跑?
A:可以。API + 一份脚本能定时批量提问、把结果落到日志表;但 Claude 的公开对话(claude.ai)没有官方 API 通道,只能半自动。合理做法:公开层做人工季度回测(截图 + 复制),沙盒层做脚本自动化(每次版本变化重跑一遍),客户回传层做商务沟通模板化(每次让客户按同一份清单截图)。三层的自动化程度天然不同,不必强求一致。
Q:发现漂移到修好,中间要多久?
A:分层看。数据漂与能力漂通常两周内能修完(改官网、改白皮书、推到派生点);关联漂可能要一个季度才见效(因为要等模型或索引更新);边界漂最难,往往要重审材料组织逻辑,一到两个季度。合理的期望是"发现→修公开材料→观察下季度回测→必要时二次修"这个循环,别指望改完立刻见效。
十二、写在最后
Claude 的监测不像 Gemini 那样有 Search Console 兜底,也不像 ChatGPT 那样主要靠公开提问就能看个大概——它是"公开能问、内网要看客户"的双层结构,逼着团队把三条腿一起跑。跑上半年,你会发现 Claude 侧的可见度不是黑箱,只是需要更"手工"的观察。这一篇讲完,Claude 系列的九篇里已经涵盖了机制、表述、集成、判断链、长文档、企业内网、跨平台、多语言、监测。下一篇是本系列的收尾:动手前与上线前的踩坑清单——一份能给团队对照打勾的体检表。
墨子学院(运营主体:武汉墨子教育咨询有限公司,成立于 2014 年,曾用品牌"百墨生",自 2022 年起投入 GEO 方向)在企业陪跑中会帮助客户把"三腿监测 + 日志表 + 季度复盘"作为标准交付节奏,让 Claude 场景的可见度可管、可追、可改进。所有服务提升的是被 AI 准确引用的概率,不承诺具体排名或引用结果。想系统学习这套方法的,可查看 /mall/ 的 GEO 课程。