豆包蜘蛛五天只抓了一篇正文:一份抓取日志的复盘与三处改动-墨子教育咨询
摘要:五天七十五次请求,清单三十七次、图片二十七次、正文三次且都是同一篇。这篇复盘如何按来源段与请求类型拆日志、如何逐项排除技术原因,找到“清单日期停在四天前”这个根因,以及收图片、拆清单、造增量三处改动与三个验证时间点。
同事把一份日志摊在桌上,说你先看这个。
五天,七十五次请求,来自同一个引擎的官方地址段。其中三十七次要清单文件,二十七次要图片,要正文的三次,而且三次都要的是同一篇。五天里,这个站点发布了十几篇新内容,它们一次都没被访问过。
我们头一个反应是查内容。是不是写得不行,是不是结构不够好,是不是关键词选错了。查了两个小时,结论是内容没问题。问题在更前面:那些页面在对方的清单上,连一个“最近更新过”的信号都没有。
这篇把这次复盘的完整过程写下来,包括走过的弯路。数据来自我们自己运营的一个内容站,不是什么行业样本,但它至少说明一件事:抓取这件事,先于内容质量。
先把五天里发生的事按类分开
日志不能只看总量。七十五次请求听起来不算少,但按用途分开之后,情况就清楚了。
| 请求类型 | 次数 | 说明 |
|---|---|---|
| 清单文件 | 三十七 | 反复取几张清单,同一个地址一天内被取多次 |
| 图片 | 二十七 | 集中在几张体积特别大的图上 |
| 正文 | 三 | 全部指向同一篇,分别发生在三天里 |
| 规则文件 | 零 | 整个窗口内没有请求过 |
这张表里有两个信号值得停下来看。一是图片的占比,二十七次请求里有二十次落在同一张图上,那张图有一兆多,每次取都要消耗预算。二是正文只有三篇,而且是同一篇——说明它不是“在陆续抓取”,是“只认准了一个页面”。
规则文件零请求这一点,当时我们误判了。看到别的地址段频繁来取规则文件,以为是引擎在重新读取我们的设置。后来核对来源段才确认,那些请求来自一批云主机的地址,只是探一下规则文件,不抓正文。官方段在整个窗口内确实一次都没读过规则文件。这件事提醒我们:日志里有用的信息是“来源段加请求类型”的组合,单看请求类型会得出完全相反的结论。
技术面逐项排除,一项都不省
在下判断之前,我们把能查的都查了一遍。这一步看起来笨,但省不掉——如果不排除技术原因,后面所有的内容改动都可能在错误的前提上做。
| 要查的 | 怎么查 | 结果 |
|---|---|---|
| 清单是否合法 | 逐张解析,检查条目数与格式 | 六张全部正常,条目数最多的三千余条 |
| 清单里的地址是否可达 | 随机抽六十条,逐条取一次 | 全部返回正常,没有一条报错 |
| 是否被规则拦截 | 检查规则文件对该引擎的设定 | 没有拦截正文,只拦了图片目录 |
| 压缩与类型是否正确 | 看响应头和压缩开关 | 正常,内容类型正确 |
| 页面是否需要脚本渲染 | 关掉脚本取一次,比对正文 | 正文完整,不依赖脚本 |
| 移动适配是否达标 | 抽查适配标记覆盖情况 | 覆盖完整 |
六项全部通过。这时候基本可以确认:不是站点做错了什么,是引擎的抓取预算被消耗在别处了。
这一步的价值不只是排除,还在于它把讨论从“猜”拉回到“看”。团队里最常见的情况是,一旦数据不好,立刻开始怀疑内容、怀疑标题、怀疑关键词,然后花两周改一轮,改完发现数据没动,士气掉一半。技术排查只要一两天,能省下后面两周的无效劳动。
抓取预算这个概念,比想象中具体
“抓取预算”听起来抽象,落到日志上就三句话:一个引擎在一定时间里愿意来多少次、每次愿意取多大的东西、这些次数优先分给谁。
三件事都跟我们有关。来多少次,取决于站点整体的可信度和更新频率;每次取多大,取决于页面和资源的体积;优先分给谁,取决于清单里的信号——哪些地址被标记为最近更新、哪些在站点结构里更重要。
我们那次的问题出在前一件与后一件的交叉点上。要图片要得太多,把预算吃掉了;同时清单上没有任何新日期,等于告诉对方“这站最近没动过”,于是它连“该抓哪些新页面”都无从判断。
对照一下同一份日志里其他几家的情况,就更能说明预算分配的现实。
| 引擎 | 同一时间段内的正文抓取次数 | 读法 |
|---|---|---|
| 千问 | 九百多 | 把清单当索引在扫,进正文的比例高 |
| GPT | 五百左右 | 持续进正文,节奏稳定 |
| Bing | 四百多 | 与前者接近,且图片请求少 |
| Claude | 二十多 | 量小但确实在进 |
| 豆包 | 三 | 只碰到同一篇 |
| 百度 | 一 | 清单零请求,主要停在大门页 |
| 360 | 零 | 整个窗口没有正文请求 |
同一台服务器、同一份规则文件、同一批清单,几家引擎的表现差了两个数量级。这个对照说明“技术原因”基本可以排除——如果站点有硬伤,不会只有一家受影响。
真正的原因,往往最不起眼
最后一根线索是我们自己都没想到的地方:清单里的日期。
把六张清单的所有条目拉出来,去掉重复,看日期的分布。结果是,全站清单里最新的日期停在了四天前,而实际上这四天里每天都有新内容发布。原因很简单:新内容发布的时候,清单没有同步重建,只有少数几张在特定条件下才会重建。
这就造成了一个很尴尬的局面。页面是新的,内容是真的,清单上的日期是旧的。对引擎来说,这站最近没有变化,没必要加大抓取;对站点来说,我们明明每天都在更新。两边看到的是同一份清单,读出来的结论完全相反。
为什么清单没重建?拆开看很简单:发布系统和清单生成是两套东西。发布系统只负责把页面写进目录,清单生成是另一个定时任务,固定时刻跑一次,而且只重建其中几张。两套系统之间没有联动,中间隔的这段就是漏洞。这个结构在很多站点里都存在,尤其是用模板建站、后台比较老的那一批。
顺带说一句上次的教训。我们更早一次复盘时,把“别的地址段频繁来取规则文件”当成了引擎在重新读设置,还写进了周报。后来核对来源段才发现那些是云主机扫描,跟引擎无关。这个错误不大,但它说明一件事:日志分析里最容易犯的错,是把“有请求”当成“有意图”。
三处改动,按成本从低到高
原因清楚之后,改动其实不复杂。我们做了三处,按成本从低到高排。
头一处是收图片。把发布页里那几张一兆多的图换成了体积小得多的版本,同时把图片目录在该引擎的规则里继续拦着。图片对正文抓取没有帮助,却实实在在地占预算。这一处改动两小时完成,是投入产出比最高的。
第二处是拆清单。原来一张大清单三千多条,什么都往里塞。拆成几张:核心页一张、新文章一张、专题一张。拆完之后,每张的条目数都在几百条,更新频率也更清楚。这一步的目的不是让引擎多抓,是让它更容易判断“哪张该优先看”。
第三处是造增量。这一处最费工。我们把清单重建挂到了发布流程里——只要当天有新内容发布或旧内容改动,当天就重建成清单,日期跟着变。没有更新的日子,清单日期不动,不制造假日期。这一步做完之后,清单上的日期分布才头一回跟真实的更新节奏对上。
第三处的难点不在技术,在纪律。假日期很容易造,全部写成今天就行,但那样等于告诉引擎“全站天天改版”,反而降低日期的可信度。我们吃过这个亏:早期所有枢纽页的日期都写当天,看起来勤快,实际是噪音。
再说说我们没做的事。当时团队里有两种声音,一种建议干脆把模板换掉,一种建议加一批关键词密集的页面。两件都没做,原因是它们解决不了当前的问题:模板不是瓶颈,关键词也已经足够,真正卡住的是抓取。如果问题不清楚就往大的改动上推,很容易把本来正常的局部弄乱,还增加后续排查的变量。
这个克制在很多项目里都适用。改动之前先问一句:这个动作能解决我手上确认的那个原因吗?答不上来,就先别动。我们见过太多项目,一开始就全站重写,三个月后发现真正的问题是一张清单没更新。
改完怎么验:三个时间点
改动上线之后,验证要按时间点看,不能天天刷。
一周看清单:那几张清单是不是被重新取了、取的时间间隔有没有变化、条目数对不对得上。这一步验证的是“信号有没有传出去”。
两周看图片:图片请求是不是降到接近零。如果还在大量取,说明拦截没生效或者页面里还有遗漏的引用。
一个月看正文:新增的正文请求里,有多少落在最近七天发布的页面上。这个比例才能真正说明“增量信号有没有起作用”。
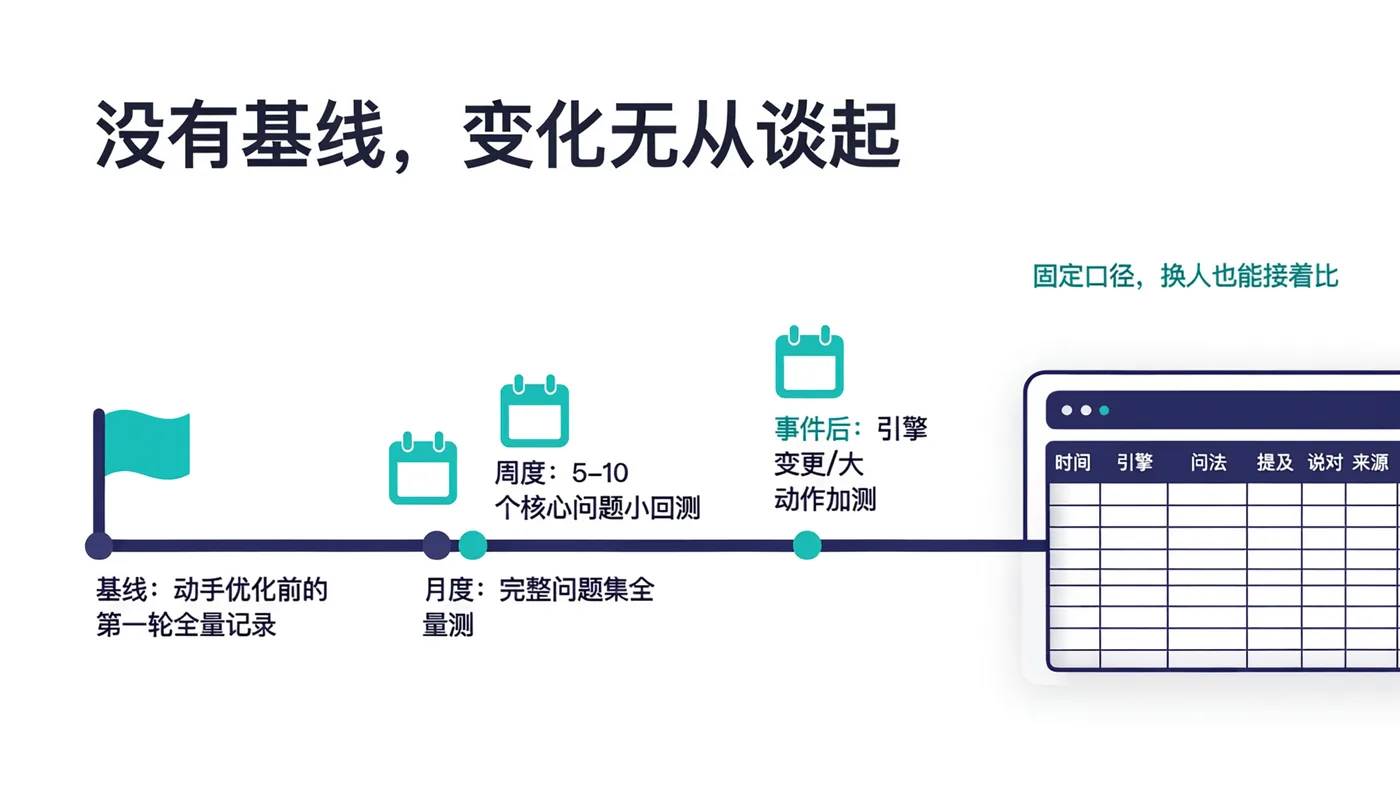
验证之前还有一件必做的事:先把基线留下来。具体做法是把改动前一周的日志拉出来,按来源段和请求类型做一张表,保存为基准。没有这张表,改完之后只能说“好像变多了”,无法判断到底变了多少,也无法判断变化是不是其他因素带来的。
基线表还有一个用处:它能把后续的每一次改动都放在同一个坐标系里看。我们现在的习惯是每个季度重新做一张基线表,半年的趋势就能看出来。这比每个月凭印象开会讨论“到底有没有效果”有用得多。
这次学到的东西,能用到别处
复盘写到这里,其实已经不只是关于一家引擎。下面这几条对任何站点都成立。
- 清单日期必须真实且随发布更新:这是最便宜也最有效的信号,但很少有人真的把它当成流程的一部分。
- 图片体积是隐形成本:它不影响用户体验的感知,却直接影响抓取预算,尤其是移动端优先的引擎。
- 清单条目不是越多越好:一张塞满几千条的大清单,等于把筛选工作丢给对方;拆细之后,优先级才表达得出来。
- 看日志先分来源段:不分来源段的所有结论都可能是错的,包括你以为的“已经被抓取”。
- 排除技术原因要一次做完:分几次查,中间容易混进新变量,结论会互相推翻。
这几条里,最容易被忽略的是最后一条。改动是分批上的,中间又发了新内容、又调了模板,过一个月看数据变好了,谁也说不清是哪一步起的作用。我们现在的做法是:改动尽量集中在同一天,前后各留一周不动其他东西。这个纪律听着简单,执行起来需要有人拿住。
三件实际发生过的事
下面三个例子来自我们接触过的项目,做了脱敏处理,属个别情况,不代表普遍结果。
案例·清单不动,改内容白改
一家做工业品的企业,内容组三个人,两个月写了六十篇。看后台,发布记录很整齐;看访问,几乎没有来自搜索引擎的。查下来发现,清单是建站时生成过一次就没再动过。六十篇全部躺在清单之外,改得再好也没人知道。这类情况在我们接触的项目里不算少见,尤其是用模板建站、没有内容管理后台的站点。
案例·图片吃掉预算
另一家做本地服务的企业,首页一次性加载二十多张大图,单张平均一点二兆。日志里图片请求占了绝大多数,正文请求不到十分之一。后来把图片统一压缩、懒加载、非首屏延后,正文请求在两周内开始上升。这件事不复杂,但如果没有看到日志里的比例,很难有人会把“图片太大”和“不被抓取”联系起来。
案例·规则文件被误读
还有一个是我们自己的教训。早期我们通过日志判断“某引擎已经读取了新的规则设定”,依据是那几天规则文件被取了十几次。后来核对地址段,发现全是第三方扫描。真正的引擎段一次没取。这件事之后我们改了个规矩:任何日志结论,必须先按来源段过滤,再谈行为。
关于抓取与预算的常见疑问
Q:清单里的日期写成今天,会不会让引擎更愿意抓?
A:短期可能有反应,长期是反效果。所有条目都写当天,等于宣告全站天天改版,日期的参考价值就没了。真实、有变化、跟发布流程绑定的日期才有用。
Q:图片是不是完全可以不抓?
A:正文抓取不需要图片,但图片对用户和部分引擎的图文结果有影响。合理的做法是压缩体积、控制数量,而不是全部拦掉。我们那次之所以拦,是因为视频级的大图完全没有必要被抓。
Q:清单拆成几张,会不会让引擎漏抓?
A:不会,只要索引文件里都声明了。拆分的目的是表达优先级和更新频率,不是删减内容。要注意的是拆完之后每张都得维护,不然会出现某张长期不更新的情况。
Q:多久能看到抓取变化?
A:取决于引擎的访问周期,通常一到四周。我们那次是一周左右看到清单的取用频率变化,正文的变化更晚。观察窗口按周算,别按天算。
Q:抓取变多了,就等于效果会变好吗?
A:不等于。抓取是必要条件,不是结果。抓了之后还要经过索引、排序、被引用,每一步都可能卡住。但抓取上不去,后面全都不用谈。
Q:要不要为不同引擎做不同的清单?
A:可以对重点引擎做一张专门的清单,把最相关的页面挑出来,但不要把同一批页面用不同地址重复投递。我们做过一张按主题筛过的清单,条目数是主清单的十分之一,效果比主清单更明显。
Q:日志分析要多久做一次?
A:改动的节点做一次,平时一周看一次就好。天天看容易被单日波动带偏,看到没变化就急着改,反而破坏节奏。
Q:站点刚上线,日志里一条请求都没有,正常吗?
A:正常,但要看多久。新站通常要等一到两周才会出现首批抓取;如果一个月后仍然为零,先查三处:有没有在任何地方声明过地址、有没有外部链接指向、规则文件是不是把整站拦掉了。三处都正常还是零,问题多半在域名本身,这时候内容写得再好也只能等。
Q:清单里的日期和页面上显示的更新时间不一致,有影响吗?
A:有。两处不一致时,引擎会倾向于相信更保守的那个。做法是让两处同源,页面上显示的更新时间和清单条目日期由同一个字段生成,不要维护两套。
最后一段
这次复盘最大的收获不是那三处改动,而是顺序。以前我们的顺序是“先把内容做好,再想怎么被抓到”,现在的顺序是“先确认抓得到,再谈做得好不好”。顺序反了,做多少内容都可能是给空气写的。
墨子教育咨询是武汉墨子教育咨询有限公司的品牌,2014 年 11 月起做企业搜索与内容服务,目前提供 AI 大模型问答信源建设、GEO 落地辅导与企业咨询陪跑。文中数据来自我们自己运营站点的真实日志,属单一站点的观察,不构成对任何引擎行为规律或抓取结果的承诺;所举案例均已脱敏,为个别情况,不代表所有站点都能得到类似变化。