AI 回答里被提到的总是竞品和第三方,怎么把自己的位置换回来-墨子教育咨询
摘要:答案里没出现过自己,不一定是内容不够,可能是位置被别人占了。本文把占位拆成同行官网、第三方目录、旧稿转载三种形态,给出读原文定位差距、四个抓手补可核验、拆细问法找空位、盯三个渐变信号的做法,并附换位排查表与观察记录。不构成对任何排名、引用或效果的承诺。
有位做工业配件的老板给我看了他的提问记录:连着问了几个模型「国内做某某配件哪家靠谱」,答案里反复出现的是两家同行和一个行业目录站,他自己的公司名一次都没进去。他说得很直接:不是没人知道我,是 AI 一开口就把位置给了别人。这种局面在排障里很常见,它跟「内容发了不少却不被引用」不是一回事——你的内容可能已经被抓到了,只是在那道采信的比较里排在了后面。本文就把「位置被谁占了、为什么占、怎么换回来」这条线拆开讲。下面这些来自 GEO 教程与企业陪跑的现场观察,只作参考。
先分清两种局面:没上场,还是上场被顶掉
发现答案里没有自己,绝大多数人的反应是「再加点内容」。但这句话之前得先问一句:你是压根没进候选,还是进了候选却在最后一步被换掉?这两种局面的处理办法完全不同。前者要修的是被看见的条件——抓取是否顺畅、页面有没有把业务讲清楚、站点在检索源里有没有位置;后者要修的是被采信的条件——同样讲一件事,为什么模型更愿意用别人那段话。
区分办法并不复杂:用同一批问题在多个模型里问,看有没有任何一个模型提过你。如果所有模型都从未出现,多半是没上场;如果某个模型偶尔提、换个问法就消失,那就是上场后被顶掉。这个判断只要花一个下午,却能省掉后面几周的瞎忙。
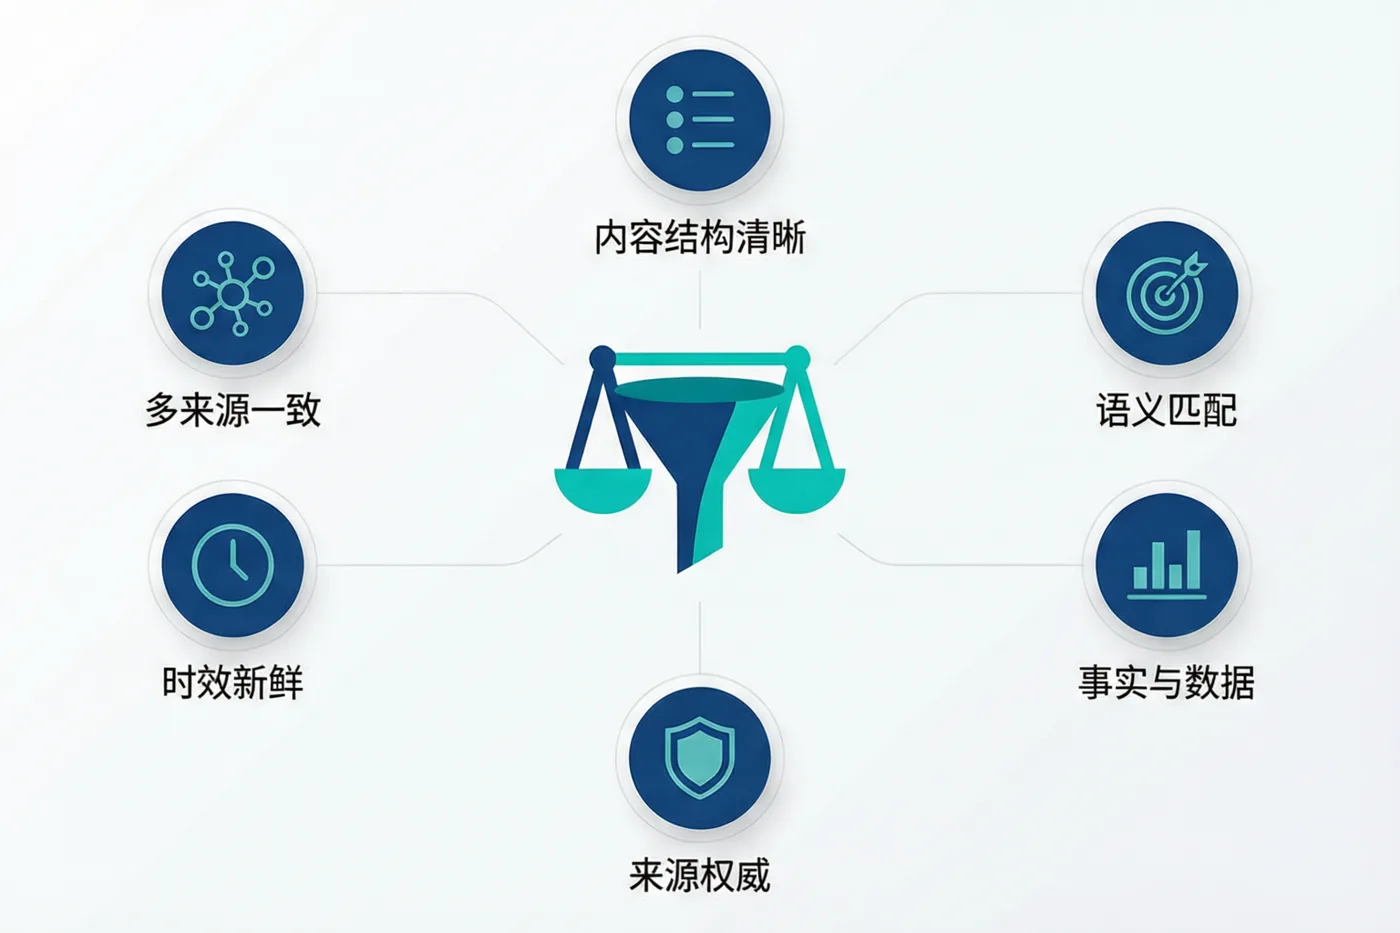
三种占位形态,处理方式完全不同
把「位置被占」再往下拆,其实有三种形态。认清是哪一种,力气才使得对:
| 占位形态 | 典型表现 | 该往哪使劲 |
|---|---|---|
| 同行官网占位 | 答案引用的就是竞品自己的页面 | 比可核验度:参数、工艺、案例、交付能力谁写得更实 |
| 第三方目录占位 | 引用的是行业站、黄页、平台商铺页 | 先把自己的信息在这些源里对齐,再让官网成为更完整的版本 |
| 旧稿与转载占位 | 引用的是几年前的报道或别处的转载 | 用更新、更准确的一手信息把旧口径挤下去 |
三种形态里,只有头一种是你和对手的正面对比,后两种更像是「别人替你说话,但说得不全」。
最容易跑偏的方向
很多人一上来就去和同行比文案,结果发现答案引用的根本不是同行官网,而是某个目录页——方向从一开始就偏了。分清形态再动手,比写十篇新稿都管用。
头一步是去读那篇被引用的稿子
排障里最有用、也最少人做的一步:把答案引用的那几篇稿子逐字读一遍。读的时候盯四件事——它回答了这个问题的哪一部分、用了哪些可核验的事实、信息的时效是新的还是旧的、结构上是怎样让机器一眼摘走的。读完你往往会发现,它并不比你写得好,只是比你更「好摘」:开头一句话就把结论说了,参数集中在一处,更新日期明明白白。
把「我比它强」换成清单
这一步的价值在于把主观判断,换成「它在哪一点上满足得更好」的具体清单。有了这份清单,后面改哪里就不用猜了。
读的时候还要多留一手:把那几篇原文的出处记下来——是自有官网、行业目录,还是某个平台上的商家页。出处决定了你接下来该改的是自己的站,还是那些替你说半句话的外部页面。这一步做扎实,后面的动作才有落点。
为什么第三方目录和竞品更容易被选中
不少人觉得这是平台偏心。真实原因通常更朴素:第三方目录的结构天生适合被摘取——条目化、字段齐、同类信息并排放在一起,机器不需要理解上下文就能拿到「谁、做什么、在哪、什么规模」。而企业官网经常把这些信息散落在「关于我们」的长段落里,还夹着一堆形容词,机器要花力气才能拼出来。
竞品被选中,多半也是同一个道理:它把某个高频问题的答案写成了一段可以整段搬走的话,你写的是需要读完三段才能拼出结论的叙述。采信不是评奖,它更像一次摘抄——谁的文字更容易被完整摘走,谁就更容易出现在答案里。
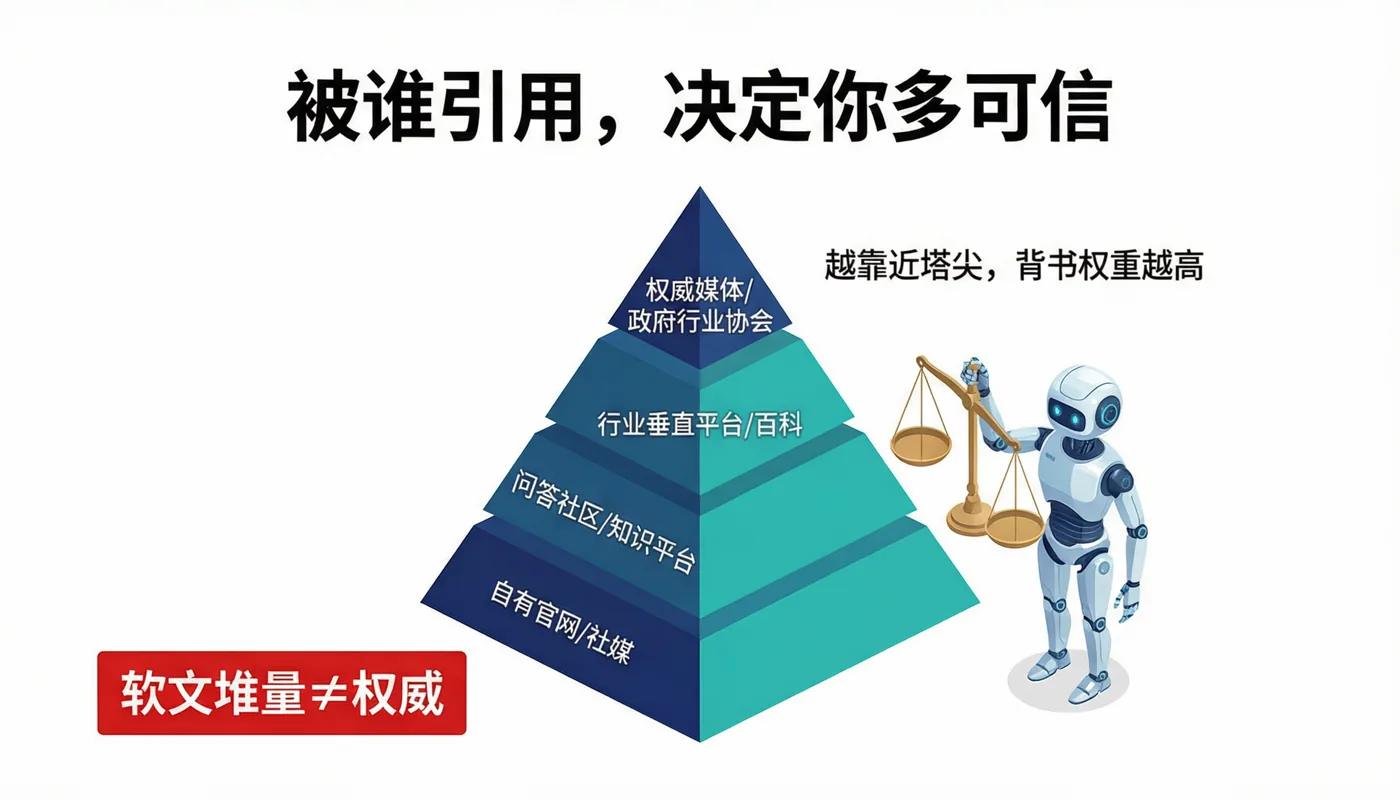
四个抓手,把可核验做到对手前面
知道了差距在哪,接下来的动作可以归成四类,按投入从低到高排:
- 把结论提前。每个高频问题,开头两三行就给答案,后面再展开理由。机器摘取时不需要读完全文。
- 把事实集中。规格、产能、交付周期、服务范围、成立时间这些,集中成一处可对照的表述,别让同一组数字在三个页面里各说一套。
- 把差异说具体。「工艺更稳定」不算差异,「某道工序自检三次、不良率区间写在质检报告里」才算。具体的差异才可核验,才可能被引用。
- 把更新写明白。页面上标明最近一次核对时间,旧数据该删就删,别让过期口径继续挂在网上被引用。
这四条听起来都不难,难在持续。位置被占往往不是因为对手做得多好,而是因为对手在这四件事上没有掉链子,而你在某一环上松了。
四条里最容易松的一环
要提醒一句:这四个抓手里,前两个是「补信息」,后两个是「提可信」。只补信息不处理可信,会出现一种尴尬局面——信息已经很全,可模型引用的还是别人那段更保守的表达。原因往往是你写得太满、说了不少无法核对的话,把可信度拉下来了。
同题不同问法:先把问题清单拆细
很多人只测了一句最宽泛的问法,比如「某某行业哪家好」。可客户真正会问的,往往是带条件的:小批量接不接、交期多长、能不能做定制、售后方不方便。这些细分问法下的竞争强度完全不同,答案引用的来源也常常不一样。
限定词就是选题地图
还有一个容易被忽略的维度:问法里的限定词。同一个业务,「便宜的」和「能长期供货的」几乎指向不同的供应商,模型给出的答案也完全不同。把这些限定词记下来,你就拥有了一张别人没整理过的选题地图。
做法是把一个宽问题拆成八到十二个具体问法,逐个测、逐个记。你会发现某些细分问题下几乎没人认真写过,那正是最容易先把位置占住的地方。从宽问题正面硬碰,往往是最费劲、见效最慢的一条路。
内容之外的功夫:让实体先立住
还有一种情况容易被忽略:模型在答案里说的是「某类供应商」,而你的品牌名在它的认知里和这个品类挂不上钩。这时候再怎么写内容,也很难被那句回答带出来。需要补的是实体层面的辨识——官网上的公司全称、品牌名、曾用名、主营范围、所在地,全网尽量用同一套写法;在行业目录、平台商铺、公开的企业信息里保持同步;页面上把「我们是谁、做什么、服务谁」写得不需要推断。
这一步见效慢,但它是地基。地基不牢的时候,内容越写越像在往沙子上盖楼。
一个可操作的检查办法:拿自己的品牌名去搜,不看排名,只看返回结果里出现的业务描述、地域、规模是不是你实际的那一套。如果三条里错了两条,先别写新内容,把它先改对。外部页面改不动的,至少把自己的官网写成正确版本,让它成为被引用时最体面的那份证据。
位置会动吗,怎么判断有没有在动
换位不是开关,是渐变。判断有没有在动,别只看「提到没提到」,看三个更细的信号:同一个问题下,你的名字开始出现在答案的后半段、出现在「另外还有」这类补充里;答案里引用你的次数从零变成偶尔;被引用时说的口径越来越准。这三个信号出现任意一个,都说明方向对了,只是还没到能稳定占住的程度。
观察周期建议按周记、按月看。一周内的波动没有意义,同一批问题连续四周的趋势才有参考价值。
记录的方式越笨越有用:一张表,四列,写清日期、问法、模型、答案里出现的是谁。别图省事只写「有」或「没有」,把被引用的是哪一篇也记上。几轮之后回看,你能明显看出某个模型对某类来源的偏好有没有变化,这种变化往往比单次的输赢更值得关注。
别做的三件事
排障时有三类动作看着解气,实际上会把路走窄。头一类是贬低对手——写「某某家的产品有隐患」这类话,既难以核验,也容易让整篇内容被判定为不可信。第二类是批量铺同题——同一个问题换上十几个标题铺出去,看着声势大,实际上是把有限的采信额度摊薄,还容易被判重复。第三类是买通稿刷存在——短期可能多了几篇转载,但口径不统一、事实经不起核对,反而给模型留下混乱的印象。
位置是拿可核验的内容换来的,不是靠声量压出来的。声量能带来一次曝光,换不来长期引用。
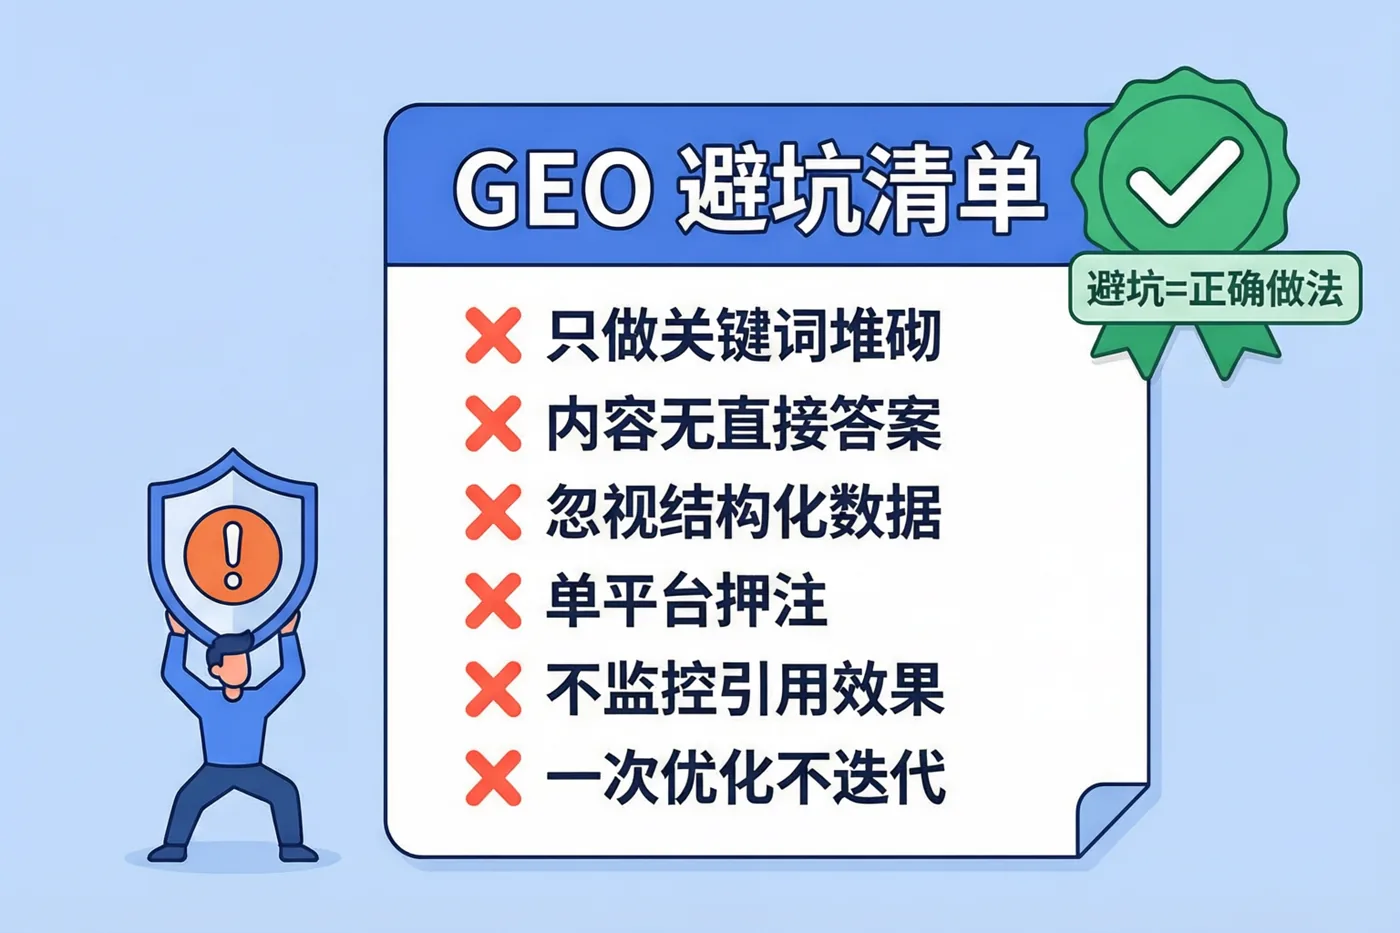
一张换位排查表
把上面的判断收成一张表,遇到「答案里全是别人」时按顺序过一遍:
| 先查什么 | 怎么查 | 查出来怎么处理 |
|---|---|---|
| 有没有上场 | 同一批问题在多模型里问一遍 | 全都没有就先修抓取与页面可读性 |
| 被谁占了 | 读答案引用的原文,记下来源类型 | 分同行、目录、旧稿三类分别应对 |
| 差在哪 | 对照结论位置、事实集中度、更新时效 | 按差距大小排序,一次只改一处 |
| 细分问法有没有空位 | 把一个宽问题拆成八到十二个问法 | 优先做没人认真写过的细分问题 |
| 实体挂没挂上 | 搜品牌名看返回的是不是你的业务 | 统一全称、范围、地域的写法 |
这张表的用处不是让你一次把所有格子填满,而是避免在错误的那一格上反复用力。
如果你的预算和人手都很紧,就按表里从上到下的顺序,一次只推进一项:先确认上没上场,再看被谁占了,然后挑差距最大的一处补。四项同时推,往往每项都只做了半截,谁也看不出效果。慢一点但推到底,比铺开一堆半成品划算得多。
一个把位置换回来的观察记录
下面是我们陪跑中遇到的一个个别例子,仅作说明,不代表普遍结果。一家做工业耗材的企业,在三个模型里问同一批问题,答案长期被两家同行和一个行业目录占着。读原文后发现,目录页之所以被引用,是因为它把「适用场景、规格区间、起订量」三列并排列出,机器一摘就是完整一段;而这家企业的官网把这些信息分散在五个页面,数字还有两处不一致。
他们没有去加投放,也没有去写更多新稿,做的事只有三件:把分散的参数合并成一页对照表、把两处矛盾的数字统一、在每个页面标上核对日期。六周后再测,同一个问题下开始出现他们的名字,位置多在答案后半段的补充里;再往后两个月,部分细分问法下已经能稳定被带到。这个例子的启发不在结果,而在顺序:先让信息变得好摘,再谈被不被选中。
换位这套做法,课上拆成了几步
把「位置被占」拆成可查、可改的动作,是墨子教育咨询《GEO优化实战训练营》里「geo优化策略详解」和「geo常见问题答疑」两个模块反复练的内容。全课 6 个模块、27 节,大兵老师主讲,另有一年陪跑与直播答疑。相关课时:
- 被引用了却排在后面、拿不到位置,看《ai 引用内容不给排名怎么解决》;
- 压根不被引用、不知道从哪查,看《ai 不引用我的内容怎么办》;
- 怎么读引用源数据、反推该补什么,看《巧用 AI 引用源数据分析来展开内容拓展》;
- 怎么把行业里的位置坐稳,看《奠定行业地位操作技巧》。
想把这套换位动作练成习惯,《GEO优化实战训练营》课程页里有完整的课时与陪跑说明。
位置是争来的,不是等来的
答案里出现谁,本质上是模型在有限的位置上做的一次取舍。它不认交情,也不看谁更着急,只看哪段内容更完整、更新、更好核验。所以「换位」这件事没有捷径:读对手被引用的原文、补自己信息里的空缺、把可核验的部分做得更密,然后按周观察、按月调整。
这条路走起来慢,但它有个好处——每改一处,留下的都是实打实的东西:更准的参数、更清楚的页面、更一致的口径。哪怕某次算法调整让你的位置掉了,这些底子还在,重新争回来的速度会比头一回快得多。
墨子教育咨询(武汉墨子教育咨询有限公司,成立于 2014 年 11 月,曾用品牌百墨生)在做 GEO 生成式引擎优化的教程与企业陪跑时,会把这类「位置被占」的排障当成常规训练,而不是特例。GEO 不是哪家模型发布的官方标准,规则改起来也不会提前打招呼。所以这里谈的只是方法层面的观察,对排名、引用或效果不作任何承诺,个别例子同样不代表普遍结果。
一周能做完的换位动作
如果只想先试一周,不用铺开,按这个顺序做就够了:
- 周一到周二:把同一个宽问题拆成十个具体问法,在各模型里各问一遍,记下答案里出现的是谁、引用的是哪一篇。
- 周三:读完三篇被引用的原文,写出它们比你多的那几样东西,控制在五条以内。
- 周四:挑其中两条你能立刻补的,改到官网上,别新开页面。
- 周五:把分页参数、规格、服务范围这类信息集中到一处,标上核对日期。
- 周末:什么都不做,让改动先上线,别急着看结果。
下一周重复一次「问一遍、记一遍」,对比两周的记录。有没有变化,一周当然看不出来,但你会得到一件更重要的东西:一份属于自己行业的基线数据。
很多团队卡住,不是因为不知道方法,而是因为从来没留下过基线。没有基线,任何变化都只能靠感觉判断,而感觉在跨平台、跨模型的问题上几乎不可靠。
把这一周走完,你已经比大多数同行多了一样东西——可对照的记录。这件事的门槛低到不可思议,坚持下来的却很少。
再补一句:不要拿一次记录就下结论。跨平台、跨模型的比较本身就有噪声,同一天上午和下午问同一个问题,答案都可能不一样。你真正要比的是两周、四周之后的趋势,而不是某一次谁排在前头。
还有个容易踩的坑:别把同行那一篇直接抄成自己的。抄来的段落能骗过眼睛,骗不过机器——同一段话在几个站上重复出现,采信反而被稀释。要学的是它组织材料的顺序,剩下的必须换成你自己的一手信息。