内容不差却读不到:从五行响应头看协议层,从路径看语义骨架-墨子教育咨询
摘要:状态码、HSTS、TLS 版本、重定向链、缓存与压缩,这几层人不敏感、机器却会直接放弃。本文逐行拆一份响应头,讲证书链缺失、跳转绕圈、混合内容、缓存失效的判断与修法,再谈语义路径怎么起名、层级为何别超三层,附五个常见错配与改完的三个验证动作。不构成对任何排名或效果的承诺。
HTTP/2 200
content-type: text/html; charset=utf-8
strict-transport-security: max-age=31536000
cache-control: public, max-age=600
x-cache: HIT
上面五行,是请求一个页面时最先回来的东西。多数人扫一眼状态码 200 就关掉了,可这五行里藏着的每一项,都会影响机器能不能把你的正文读完、读全、读得顺。协议层不写内容,却决定了内容有没有机会被读。
这篇按这五行的顺序往下拆,再说说地址本身该怎么起名字。两件事合起来,才是「机器来了之后顺不顺利」的完整答案。
协议层为什么值得单独讲
内容做得好但读不到,是 GEO 里最冤的一种失败。读不到的原因,绝大部分不藏在文字里,而藏在握手、跳转、缓存这几层。
这几层有个共同特点:人几乎感觉不到,机器却会直接放弃。人在浏览器里遇到证书警告,点一下「继续访问」就过去了;机器遇到同样的情况,通常直接断开,连一条记录都不留。
所以这一层的检查方法不是「我打开看看」,而是「用最笨的客户端请求一次」。命令行工具就是最笨的客户端:不会自动补全、不会替你跳过警告、不会缓存。
还有一点值得说:这些检查不需要改代码。多数问题在后台开关、证书管理、跳转规则里就能修,最慢一两个小时。它们属于投入小、回报稳的那一类,只是很少有人专门去看。
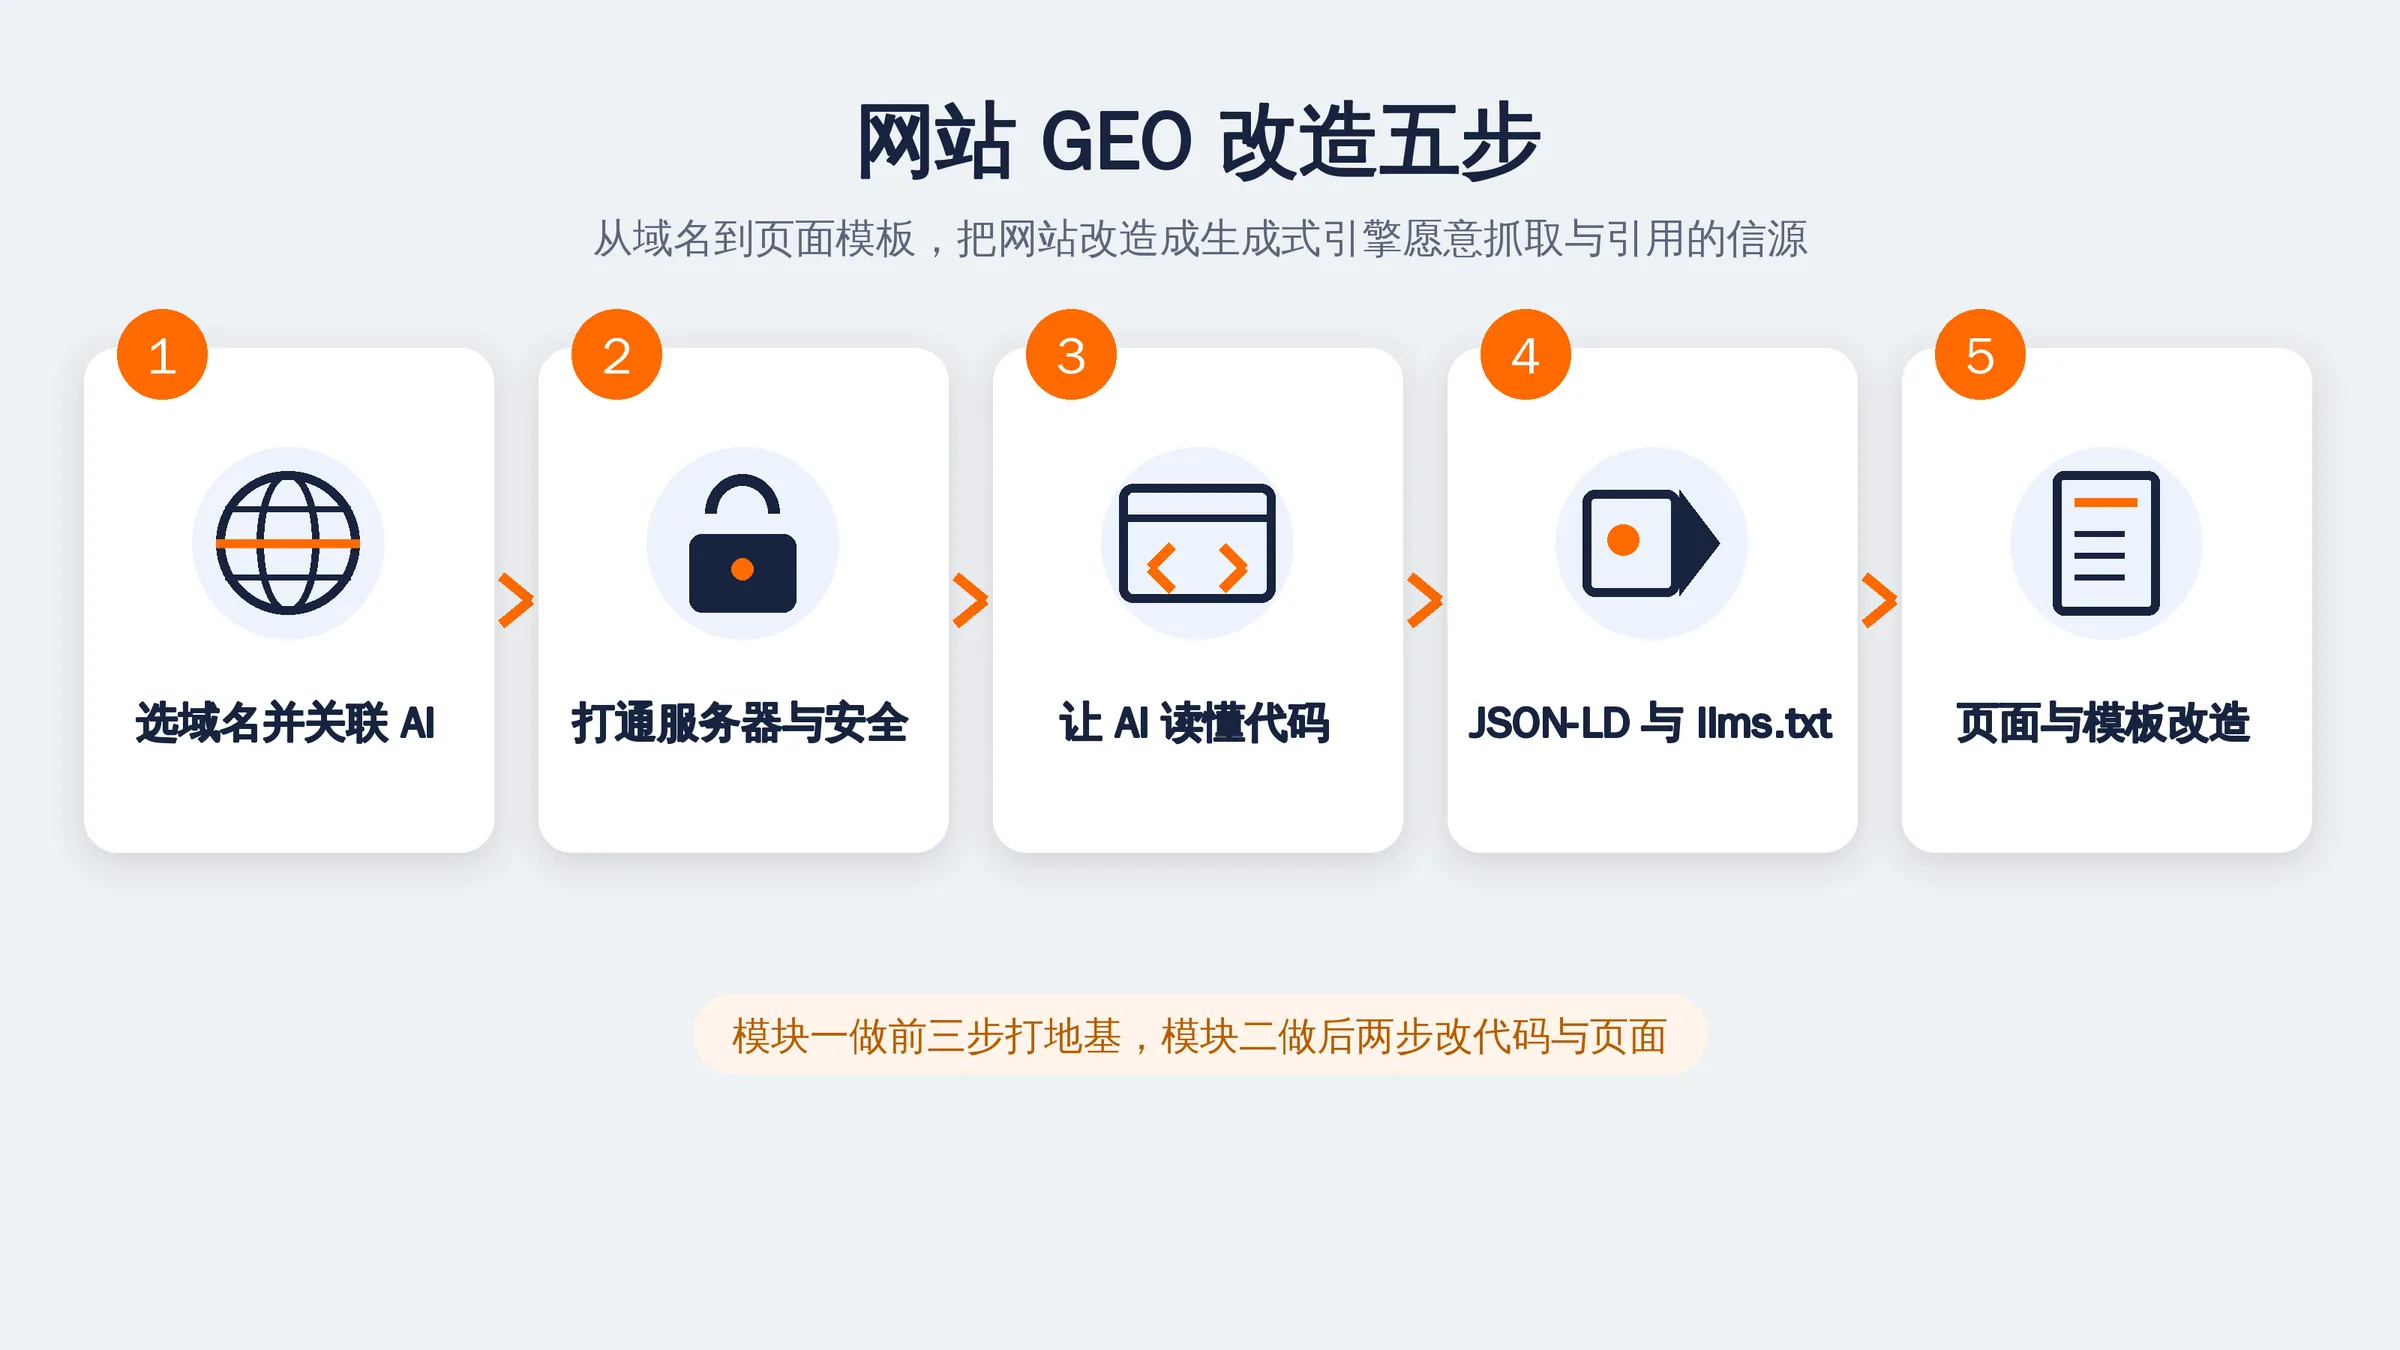
头一行:状态码和协议版本
200 是正常,301 是永久跳转,302 是临时跳转,304 是没改动,403 是拒绝,404 是找不到,429 是请求太多,5xx 是服务端出错。这些不是背单词,而是要分清哪几种会让机器「放弃后续」。
403、429、5xx 属于有攻击性的信号。机器碰到一次可能还会再来,连着碰到几次,通常会把这个地址降级,隔很久才回来看。所以改站期间如果出现成片的 403,别当成小事。
协议版本那一行也值得看。HTTP/2 或 HTTP/3 意味着可以复用连接、并行取资源,抓到同样的内容用的请求次数更少;还停在 HTTP/1.1 的站,遇到资源多的页面就容易超时。这不是必须升级的项目,但在资源重的站上是明显的加分项。
顺便说个经验:状态码 200 也可能有问题。比如返回 200 但正文为空,或者返回一个「系统维护中」的提示页。这种情况光看状态码看不出来,得同时看返回的字节数。
那一行 HSTS,解决的是「头一次之后」
strict-transport-security 这行头的作用,是告诉浏览器与部分客户端:以后访问这个域名,一律走 https,不要再尝试 http。配上较长的有效期,就能把「误走明文」这件事从根上掐掉。
它有个常被误解的地方:管不到头一次。头一次访问时,对方还不知道你有这条规则,仍然可能先走 http,再被跳转。所以 HSTS 不能替代 301,两者要一起配。
还有个小坑:某些环境里 HSTS 的有效期设得过长,后来又想把域名挪到测试环境,会发现浏览器死活只走 https,调试起来很别扭。上线前把有效期想清楚,比事后处理省事。
TLS 版本:别把读方挡在门外
现在的主流配置会禁用太老的协议版本,这是对的。但有些环境为了兼容老设备,只留下一组偏旧的加密套件,结果是新客户端不受影响,某些抓取工具反而握手失败。
| 配置情况 | 谁会受影响 | 建议 |
|---|---|---|
| 只开旧版本协议 | 新客户端可能直接拒绝协商 | 开启新版本,保留一个过渡版本即可 |
| 证书链不完整 | 命令行与部分抓取工具报错,浏览器正常 | 把中间证书装全,用命令行复验一次 |
| 证书与域名不匹配 | 带 www 与不带 www 只有一个能过 | 两个名字都签进证书,或统一跳转到其中一个 |
| 强制跳转但证书先失效 | 先握手失败,跳转根本没发生 | 先保证证书有效,再谈跳转规则 |
这张表里,第二行最容易被忽略:你用自己的电脑访问一切正常,所以从没怀疑过证书。真实的抓取失败,往往就差一个中间证书。
还有一种情况容易误判:证书是好的,但服务器只配了其中一个端口。带 www 与不带 www 分别指向不同环境时,两边的证书与配置未必一致,看起来是同一个站,实际是两套东西。
重定向链:每多一跳,就多一次放弃的机会
一个地址从 http 到 https、从不带 www 到带 www、从旧路径到新路径,如果有三段跳转,机器要走三次才能拿到正文。三次里任何一次出错,结果就是没读到。
所以规则要尽量合并:http 直接一跳到位,不要先跳 www 再跳 https;旧路径直接指向最终地址,不要中途经过一个中间页。合并之后,一条链最多一跳,成功率立刻不一样。
顺带说清 301 与 302 的区别:301 表示永久,机器会把新地址记下来,以后直接去新地址;302 表示临时,机器下次还会先来旧地址。改站迁移用 301,活动页跳转用 302,用错会让机器反复在旧地址上打转。
压缩与缓存头:第二次来靠的是它们
机器读页面,头一次是完整下载,之后可能只想知道「有没有变」。这时 cache-control、ETag、last-modified 这几行头就成了效率工具:没变就返回 304,省一次全文传输。
配置得当的站,抓取频次会明显更充分,因为每次请求的成本低。反过来,如果所有页面都设成禁止缓存,或者每次都返回新的 ETag,机器每次都得重下,能读的页面数自然变少。
压缩同理。开了文本压缩,一篇文章从几百 KB 降到几十 KB,抓取的性价比直接提高。这一项几乎是零成本的,但很多站因为服务端默认没开,一直在浪费。
另外提醒一点:不要给页面设「永久缓存」。内容站迟早会改,永久缓存的结果是老版本被反复读取,新版本反而排不上队。给页面一个偏短的有效期,给静态资源一个偏长的有效期,这个搭配最实用。
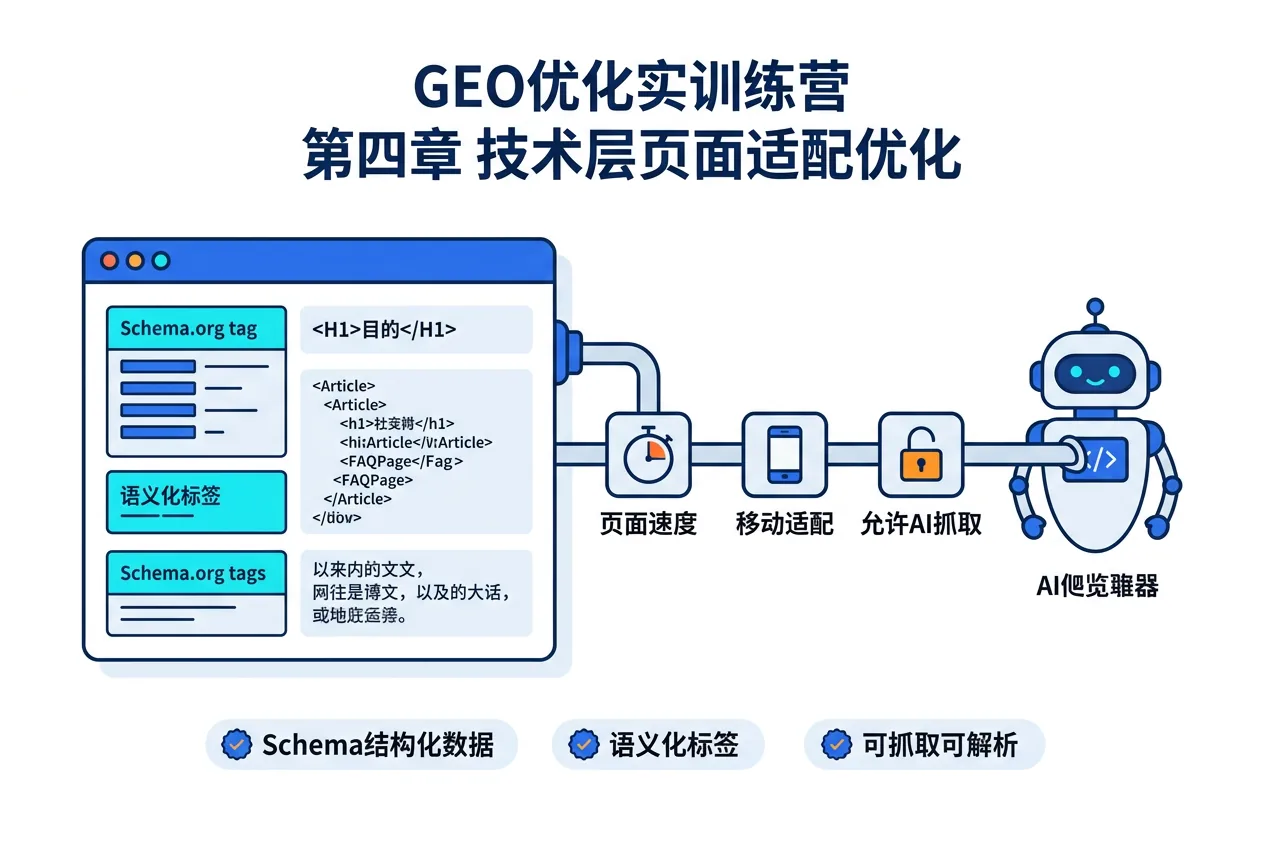
给地址起名字:路径的语义骨架
数字 ID 与语义路径
两种都能用,但效果不同。/article/1234 这种地址,机器只能靠页面内容猜主题;/geo/technical/protocol-path 这种地址,路径本身就带了三层信息:栏目、子类、主题。
语义路径的好处不在「好看」,而在于它让机器在建索引时少猜一步。尤其是栏目多的站,路径里的层级直接等于内容分类,摘取时更容易归位。
当然,已经有大量数字地址的站不必大规模改。改地址的代价是重新积累,收益要算过账。比较稳的做法是:新内容用语义路径,老内容顺着现有结构慢慢收敛。
层级别超过三层
从首页到正文,三层之内最好。四层以上,机器要多跳几次,人也容易迷路。把层级压下来的办法通常是合并中间层:栏目页直接承载列表,不再单独设一个「全部」的空壳页。
还有一个细节:路径里别塞日期和版本号。日期会让人误以为是归档,版本号会在下次改版时变成死链。这两类东西放进地址,几乎都要在后面还债。
语义路径还有一层用处:当同事看日志时,能直接看出哪类页面被读得多。全是数字地址的站,看日志得对一张映射表;语义地址的站,看路径就知道是哪一栏。这个便利会让后面的判断快很多。
IPv6 与 CDN:两条少人提到的路径
两条容易被忽略的链路问题。其一是 IPv6:如果你的域名解析了 IPv6 地址,但服务器那边没配好,部分客户端会优先走 IPv6、超时后再回退,抓取耗时翻倍。这也是一个「人能打开、机器很慢」的典型原因。
其二是 CDN。上了 CDN 之后,握手发生在边缘节点,证书也在边缘。这时你要确认两件事:边缘节点的证书是否与回源一致,边缘的缓存规则会不会把动态页面缓存成长期静态。前者导致某些节点随机报错,后者导致内容更新了而机器读到的还是旧版。
判断方法很简单:从不同地区分别请求一次,看返回的内容与响应头是否一致。不一致,问题就在边缘。
把一次响应拆开看:五行头号各管什么
| 响应头 | 它管什么 | 配错了会怎样 |
|---|---|---|
| content-type | 告诉对方这是网页还是文件 | 类型写错,页面被当成下载文件,不解析正文 |
| strict-transport-security | 以后一律走加密连接 | 不配则每次都有降级机会;配太长则调试麻烦 |
| cache-control | 能不能缓存、缓多久 | 禁缓存导致每次全量重下,抓取效率低 |
| content-encoding | 正文是否压缩 | 不压缩,传输量成倍,超时风险上升 |
| x-cache 类标记 | 看是否命中缓存 | 长期不命中,说明缓存规则没生效 |
五个头里,最容易被忽略的是 content-type。类型写错时,人用浏览器还是能打开,因为它会猜;机器往往按声明处理,结果就是不解析。
改站前后各做一次对照
协议层的改动,最怕「改完看着好了,实际坏了」。所以建议在动手前先存一份对照样本:三个页面、每个页面存一份响应头与截图,记上日期。
改完再跑一次同样的三个页面,把两份并排比。比四个东西:状态码、证书是否报错、跳转次数、缓存是否命中。四项里有一项变了,就先弄清楚再继续往下改。
这份对照样本的价值,在改完一两周之后才显现。到那时你早忘了当时怎么配的,但两份记录还在,能告诉你到底动过什么。
一次握手排查的记录
有个客户反映「改版后文章页几乎不再被抓」。我们先用命令行请求了一次首页,返回 200,看起来正常;再请求一篇文章,报的是证书链错误。浏览器里为什么正常?因为他们团队都用同一台装了中间证书缓存的电脑。
装上中间证书之后,文章页恢复 200。但抓取没有立刻回来:之前那段时间,机器连着几次失败,把这个地址降了级。又过了三周,抓取量才慢慢回到改版前的水平。这个观察只针对这一个站,不代表普遍规律,但顺序值得记住——先修失败,再等恢复。
这件事也让客户改了一个习惯:以后每次动证书或跳转,先用命令行验一遍,再让人去看。人的浏览器太聪明了,会把问题藏起来。
五个常见的配置错误
| 现象 | 原因 | 怎么修 |
|---|---|---|
| 带 www 打不开 | 证书只签了不带 www 的名字 | 补签或统一跳转到已签名的名字 |
| 首页能开,内页报错 | 中间证书缺失,或内页走了另一个证书 | 统一证书配置,命令行逐个复验 |
| 跳转绕了三圈 | 规则层层叠加,旧规则没删 | 合并成一条,从 http 直接到最终地址 |
| 样式在页面上丢失 | 资源仍是 http,被判为混合内容 | 把模板里的资源地址统一改成 https |
| 每次访问都全量下载 | 缓存头被设成禁止缓存 | 给静态资源与页面配上合理的缓存策略 |
五个里,前两个是证书问题,中间两个是跳转问题,最后一个是缓存问题。按这个顺序查,基本能覆盖九成情况。
再补一个容易忽略的:改完跳转规则之后,把旧规则删干净。两条规则同时生效时,先匹配到哪一条取决于配置顺序,表现出来就是「时对时不对」,最难查。
三件不必做的事
上面讲的都是该做的,也说三件不必急着做的,避免把力气花错地方。
其一,不必为了技术好看去上最新的协议版本。HTTP/3 确实快,但如果现有配置稳定、抓取正常,换它的收益有限,风险却不小。
其二,不必给每个资源都加版本号指纹来「强制更新」。真正的缓存问题靠规则解决,靠不断换文件名解决,只会让地址一直变。
其三,不必为了兼容假设的旧客户端去降级安全配置。抓取侧早已支持现代协议,降低标准换来的不是兼容,而是更多风险。
改完怎么验,三个动作
- 用命令行请求首页与一篇正文:看状态码、证书是否报错、跳转了几次。这一步能抓住大部分握手与跳转问题。
- 看响应头里的缓存与压缩:确认有缓存策略、有压缩,静态资源不是每次都全量返回。
- 抽查三个内页的路径:看层级是否在三层内、是否带日期与版本号、是否与栏目对应。
三个动作十分钟能做完,建议在每次动证书、动跳转、换 CDN 之后都做一遍。它的价值不在于发现问题,而在于让你知道「这次改动有没有把原来的好东西弄坏」。
这门课里对应的几节
协议与路径这块,在《网站GEO优化:从域名到页面模板的 AI 友好改造》里有一节专门讲:现代协议基础、爬虫识别路径、语义骨架与地址规范化改造,一节里连着讲完。它前面那节讲域名规范化,后面那节讲网站基础要素,三节是一条线。
课时入口:现代协议基础与路径语义、域名规范化与权重归一、网站基础优化的必要因素;课程页在这里。
最后一段
协议层的东西,做对了没人夸,做错了没人查得出。它属于那种「不上台面但决定下限」的工作。如果你的站最近抓取异常、内页打不开、样式丢失,先别怀疑内容,花十分钟跑一遍上面三个动作。
这些事情听起来琐碎,但它们有个好性质:做一次就能长期受益。证书、跳转、缓存这几项配好之后,除非换环境,基本不用再动。
如果只来得及做一件事,就把「用命令行请求首页与一篇正文」设成每周一次的例行检查。它花不了一分钟,却能接住最要命的那类故障。
本文的配置建议基于我们在企业站改造中的实践,不构成对任何排名、引用或效果的承诺;具体参数请以你所在环境的运维规范与证书签发方的要求为准。