原创数据与研究报告:怎么让 AI 把你的内容当成可引用的信源?-墨子学院
摘要:能被引用的一手信息,是把品牌从复述者升级为信息源头的关键杠杆。本文讲原创数据为什么含金量高、中小品牌怎么低成本做出可核验的一手内容、如何呈现才能被引擎摘取引用、怎么与整体信源体系咬合,以及编数据造样本等坑。
做 GEO 权威信源做到一定深度,会撞上一个新问题:你在自己站点把事实讲清楚了(自证),也争取到了第三方如实的提及(他证),可引擎对你的印象,仍然停留在“一个说自己不错的普通站点”,而不是“一个别人遇到相关问题时绕不开的信息源”。这两种身份之间,隔着一样东西——原创的、别人拿不到的、可核验的一手信息。媒体会引用发布权威数据的机构,引擎会优先引用那个“问题答案的原始出处”。而绝大多数品牌内容只做了一件事:把网上已有的说法重新组织一遍。这类内容没有增量,引擎自然也没理由非引用你不可。这篇文章就专门讲 GEO 里最被低估、却最能抬高信源等级的一类资产——原创数据与研究报告:它为什么值钱、中小品牌怎么低成本做出能被引用的一手内容、如何呈现才能被核验和引用、怎么把它嵌进整体信源体系、以及最容易踩的坑。
一句话先说结论:能被引用的原创数据/研究报告,是把品牌从“复述者”升级为“信息源头”的关键杠杆,它在信源权威里含金量高;但它不必然要求大投入——一份小样本的真实调研、一组你自己业务沉淀的统计、一份把某问题讲透的首手指南,都算一手信息。正路是“先做出别人拿不到的真实增量,再用可核验的方式呈现”;歪路是编数据、造样本、把二手信息包装成原创,一旦被识破反而摧毁可信度。
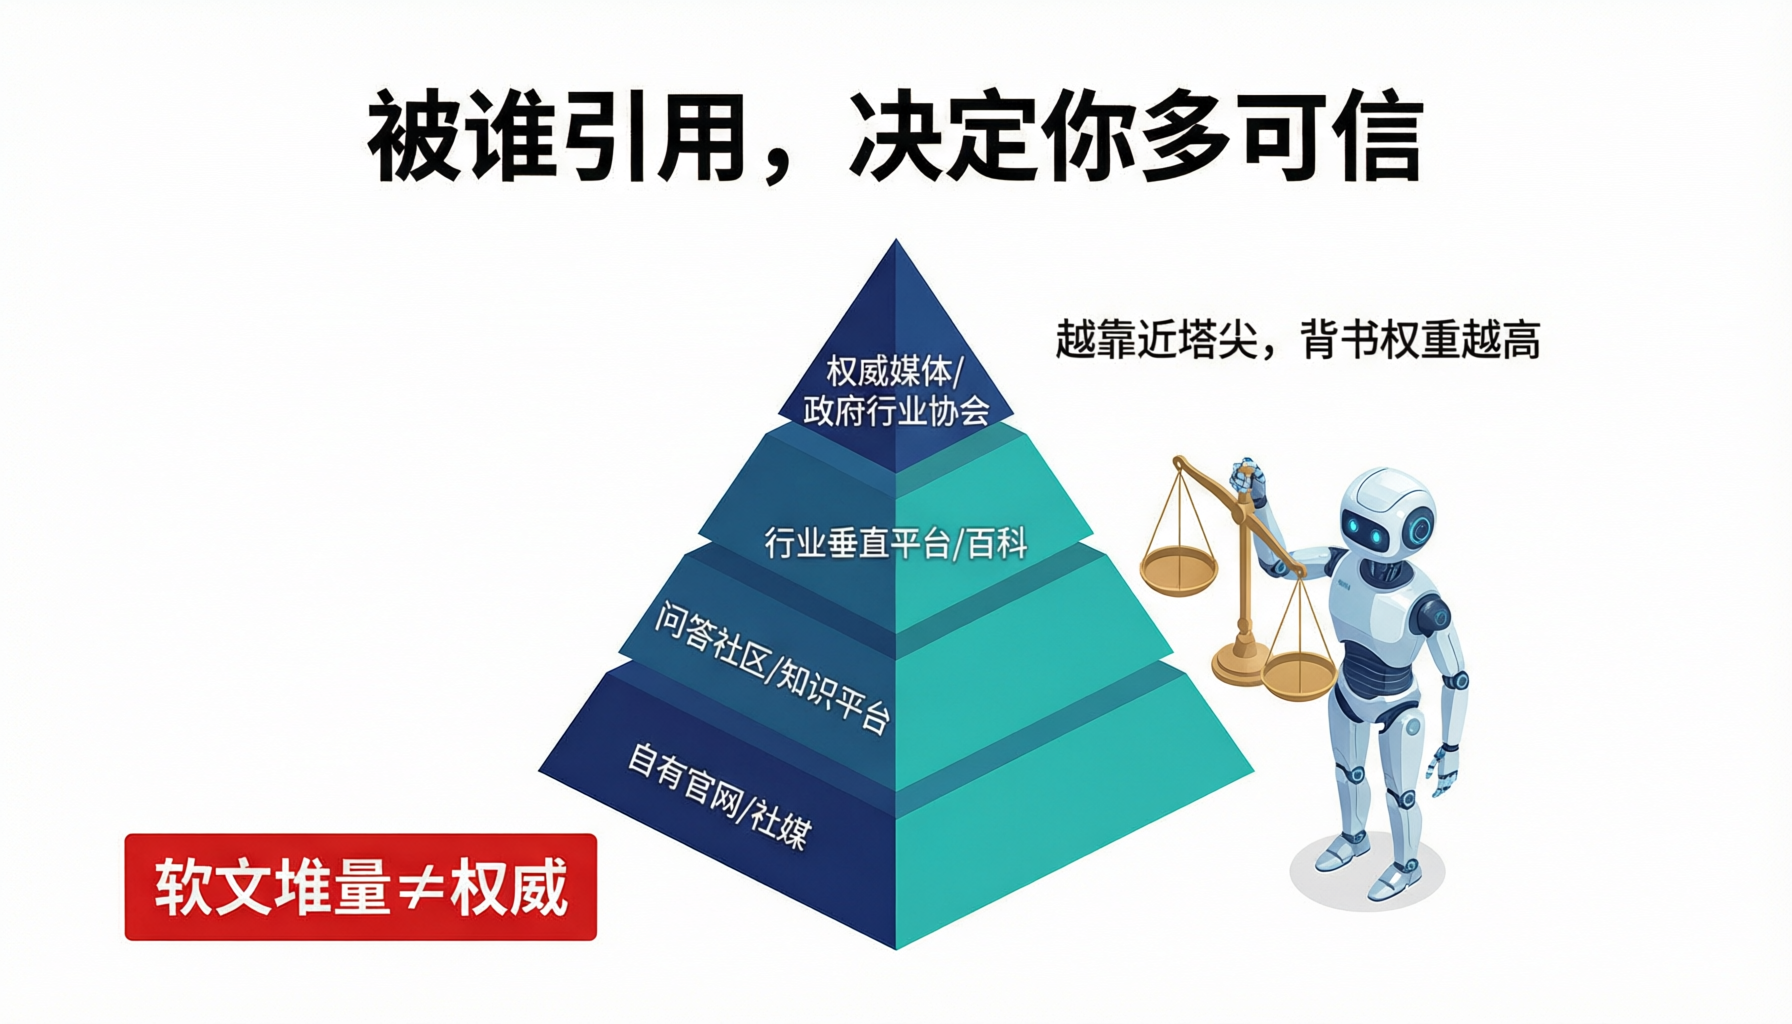
一、为什么一手数据是最高级别的权威信源
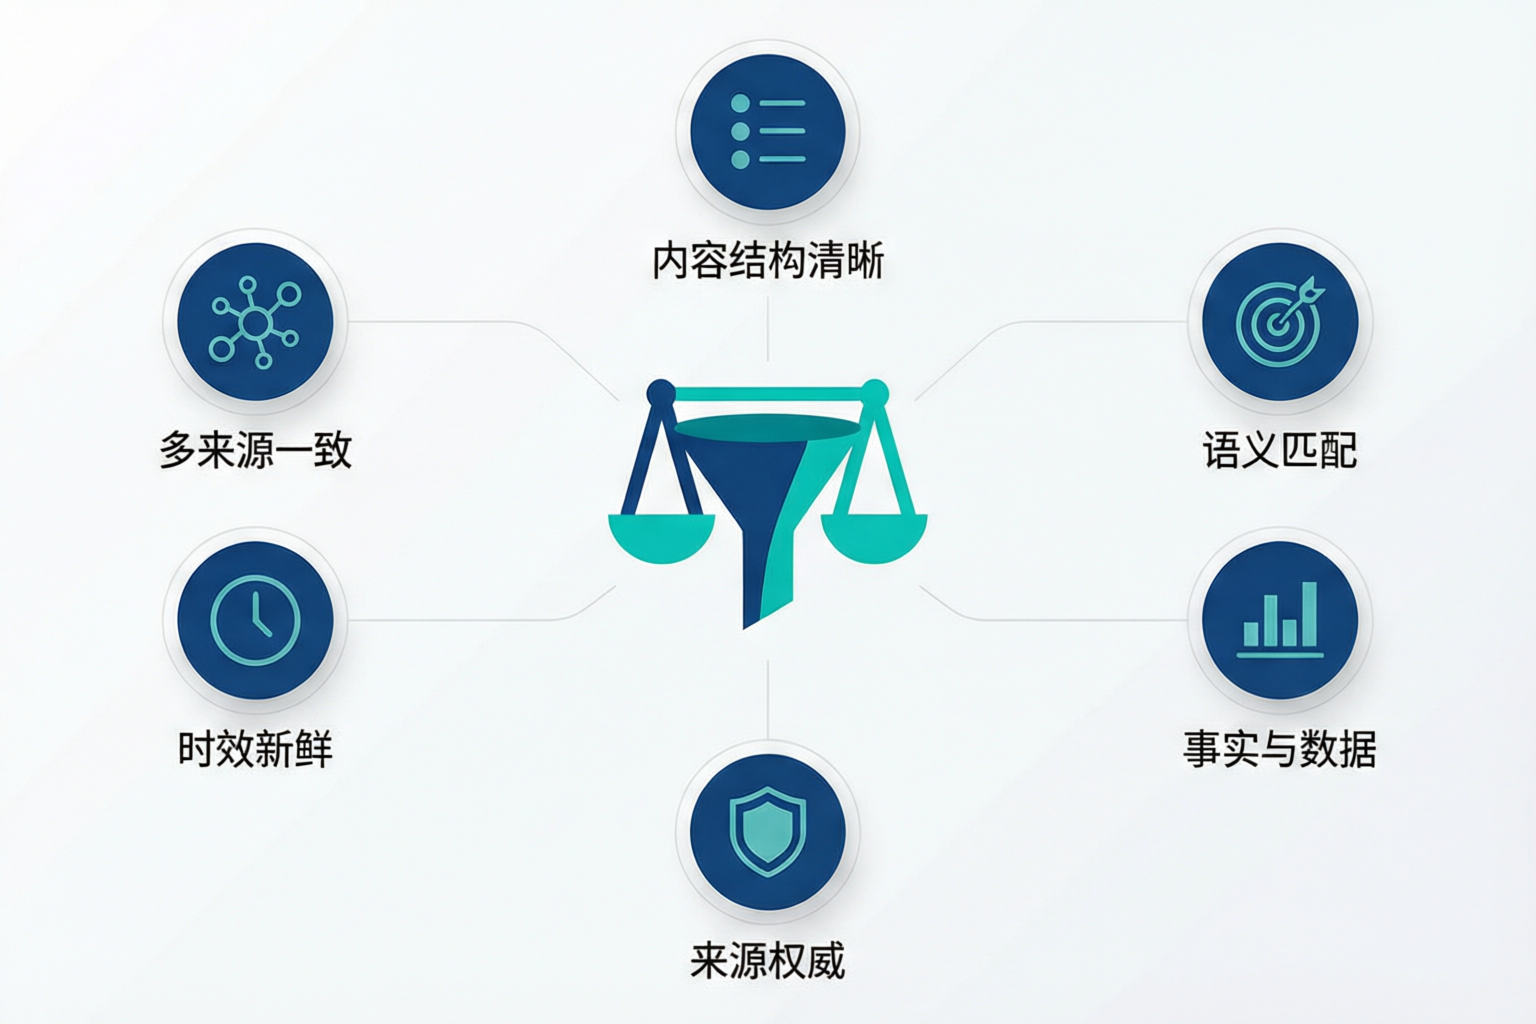
要理解原创数据的分量,得回到引擎组织答案的那个动作:它其实是在满世界找“这个问题,谁能给我一个靠得住的回答”。当很多来源都在说同样的话时,引擎心里也清楚——这些话总得有个最初的出处。而谁掌握了那个出处,谁就在这一问题上拥有了别人绕不开的话语权。一手信息之所以含金量高,是因为它同时满足了引擎判断“该不该引用”时最看重的几件事:
- 它不可替代:数据是你测出来、调研出来的,别的来源要引用这个结论,就只能引你。这构成“被引用”的硬需求:不是你想不想被引,而是别人要讲这件事,绕不开你。
- 它自带可核验性:一份写清了方法、样本、时间、来源的报告,本身就是在向引擎(和读者)证明“这不是我随口说的”。可核验,正是采信的门槛。
- 它体现真实专业度:能沉下心做一手调研、把自己业务里的数据整理出来的主体,往往被视为在相关领域有“经验”——这和 E-E-A-T 里的 Experience(经验)直接呼应(详见《E-E-A-T》那篇)。
换句话说,前面讲第三方背书时说的那套“他证”,是让别人证明你;而原创数据做的是更主动的一件事:让你自己成为那个“可以被证明”的源头。一个是被别人引用,一个是别人不得不引用你,量级并不相同。前者靠关系和投入去争取,后者靠的是你手里实实在在的东西,一旦建立,别人很难抢走。也正因如此,原创数据在信源权威里的位置,比“多铺几个渠道”要根本得多——它改变的是你在引擎眼中“是什么”,而不只是“出现了几次”。
二、别把门槛想高:中小品牌能做的四类一手内容
很多品牌一听“研究报告”就打退堂鼓,以为要养一支团队、发一份行业白皮书才算。其实完全不是。能被引擎和用户当作一手信息的,形式非常轻。下面四类,几乎任何认真经营的品牌都能起步。
| 一手内容类型 | 它凭什么算“原创” | 适合的起步方式 |
|---|---|---|
| 自有业务数据盘点 | 来自你真实经营、别人拿不到的数据 | 把服务记录、成交结构做成一份带统计的说明 |
| 小样本真实调研 / 问卷 | 你亲自收集的一手回答,样本虽小但独一份 | 面向客户或行业做一份短问卷,如实公开方法与结果 |
| 把某问题讲透的首手指南 | 基于你实操经验、别处搜不到的流程与坑 | 把你踩过的坑、验证过的做法写成可复现的教程 |
| 持续更新的榜单 / 对照表 | 你长期维护、别人难以一次复制的整理 | 做一个维度清晰的对照清单,标注数据来源和更新周期 |
这四类的共同点,是“你手里真的有这么一份东西,而别人没有”。原创不等于宏大,等于增量——哪怕只调研了二十个客户,只要方法真实、结论诚实、过程可核验,它就是一个别人绕不开的一手来源。
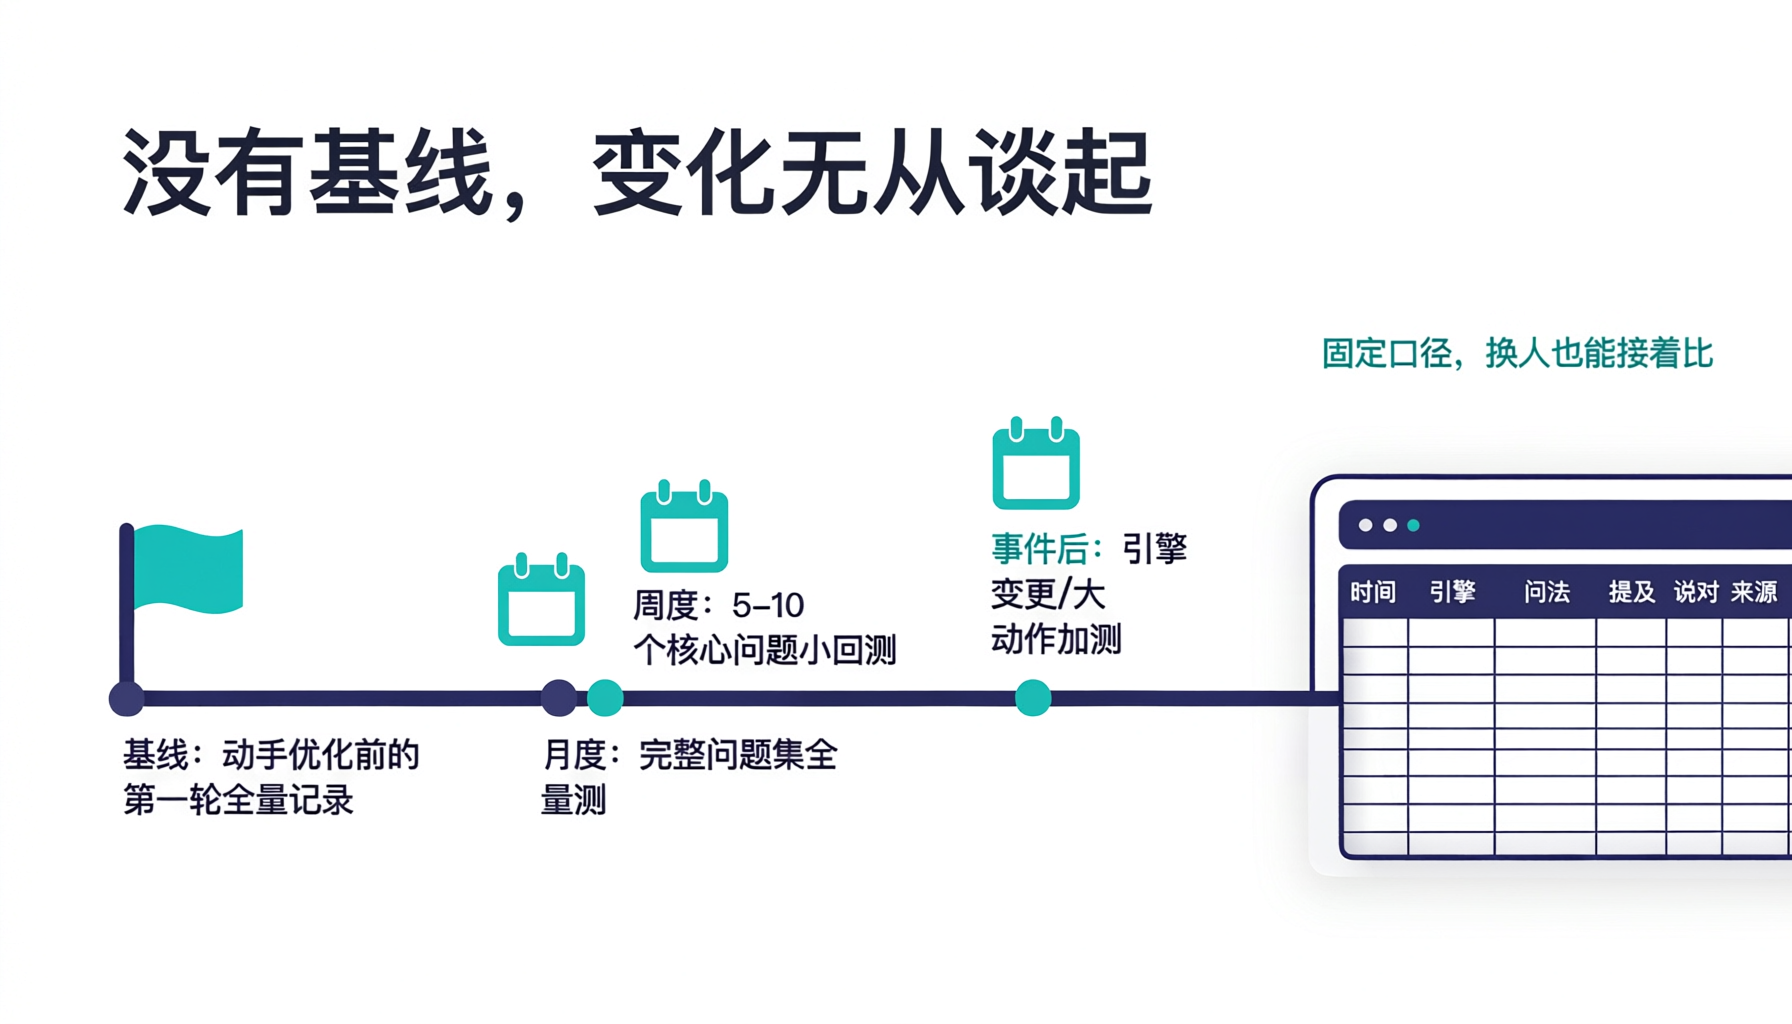
三、做出来了还要“被能用”:让引擎可核验、可引用的呈现方式
有了增量,还要让机器能把它“取走用”。很多一手数据做得不错,却埋在了含糊的表述里,引擎既没法核验、也没法直接引用,等于白做。让一手内容真正变成可引用信源,呈现上要守住几条:
- 把方法交代清楚:数据怎么来的、样本多大、什么时间段的、有什么局限。写清这些不是自曝其短,恰恰相反——透明的方法本身就是可信度的来源,引擎和用户都更敢信。
- 把关键结论做成“可摘取”的形态:用清晰的短句、明确的数字、结构化的表格把核心结论摆出来,别让它淹没在长段落里。引擎引用时更倾向于能一句话摘走、且语义自足的表达(可引用的表达技巧详见《让公司介绍被 AI 说对》那篇)。
- 图文一致,数字要落在文字里:如果配了图表,务必在正文用文字把图里的关键数字也写一遍。机器读图能力有限,只在图里呈现的数据,很可能被整个跳过(图文一致的道理详见《多媒体与图片的机器可读》那篇)。
- 给来源和更新日期:标注发布/更新时间、数据截止点。对会过期的数据,明确写“截至某时”。这既帮引擎判断时效,也为将来的更新留了抓手。
同样是“我们服务了上千家客户”这句话,不同的呈现方式,机器能不能核验、能不能直接摘走,差别很大。下面这组对照,可以当成一份随手可查的自查清单。
| 想表达的意思 | 含糊、难核验的写法 | 可核验、可引用的写法 |
|---|---|---|
| 服务规模 | “服务了众多客户,口碑极好” | “截至 2025 年底累计服务 1200 家客户,数据来自我方交付台账” |
| 效果结论 | “效果显著,普遍反映很好” | “受访的 80 位客户中,62 位反馈某指标改善,问卷方法与样本见附” |
| 行业观察 | “大家都说这个行业在变化” | “我们整理的 12 期月度数据中,某占比从 X 升至 Y(口径见说明)” |
四、原创数据怎么和整体信源体系咬合
一手内容不是孤立地“发一篇报告”就完事,它要嵌进你整个 GEO 信源体系里,才能把价值放大。几个咬合点值得留意:
- 反哺核心问答:把一手数据里能回答用户高频问题的结论,回填到你的核心问答页,让最该被引用的回答带上“有数据支撑”的分量。
- 成为第三方愿意引用的锚点:真正有增量的一手内容,是撬动第三方背书的支点——媒体、行业号愿意引你,正因为你手里有他们没有的东西(这与《第三方背书》那篇形成闭环:那篇讲怎么被提,这篇讲拿什么值得被提)。
- 口径统一、单一事实源:同一组数据在多处出现时,务必同源同版本,别让一份报告在官网、目录、外部文章里出现三个不同数字(矛盾如何治理见《全网信息不一致时》那篇)。
五、原创数据最容易踩的坑
正因为一手信息价值高,围绕它的歪门邪道也不少,而且大多会反噬:
- 编数据、造样本:为了让内容显得权威而虚构数字或调研。这是从“无效”升级到“有害、甚至违规”的一档——一旦被核验拆穿,损失的是品牌全部的可信度,前期积累一并清零。
- 把二手信息包装成原创:从别处抄来的数据,换个说法标成“我们的发现”。搜索引擎和用户都可能溯源,这种“伪一手”一旦被识破,比不做还糟。
- 方法不透明、无法复现:抛出一个漂亮结论,却说不清怎么来的。缺了可核验的过程,再惊人的数字引擎也不敢引用——因为它无法判断这究竟是你真做出来的,还是随口编来博眼球的,而后者它见过太多。
- 做完就锁进抽屉:花力气做了调研,却只是内部看看,没有以可被引用、可核验的形态公开发布,等于把一手资产白白浪费。做一手内容的成本花出去了,却没换回它本该换来的“被引用”,是最可惜的一种半途而废。
一个朴素的自检标准:如果要求你把自己这份数据的方法、样本、原始依据完整公开,你敢不敢?不敢,就说明它撑不起“一手信源”这个身份;敢,它才真正具备被引用的底气。
六、不同条件下如何起步
一手内容这件事,不同资源、不同阶段的团队,起步姿势应当不同。
场景一:有真实经营数据、但没意识到能用的服务型企业
很多做培训、咨询、本地服务的机构,手里握着大量真实服务记录,却从没把它们整理成对外可引用的东西。这类起步最快——把已有的成交、服务、学员数据做一次诚实盘点,配清楚口径和时段,就是一份别人拿不到的一手内容,几乎零额外成本——你缺的从来不是数据,而是把已有数据如实整理、公开成一个可引用信源的那一步。
场景二:数据不多、但离客户很近的小团队
样本有限不用硬凑宏大报告。做一份面向自己客户的小问卷、整理一批真实的常见提问与解答,如实标注“样本来自我们的 XX 位客户”,样本小但真实可核验,同样能立住“在这个细分问题上我有独一份的实地观察”的身份。诚实说明局限,反而加分:在一个每个人都说自己权威的环境里,一份坦率标注了边界的小数据,可信度往往比一个语焉不详的大数字高得多。
场景三:内容做得多、却总是“什么都说过一点”的品牌
这类的问题是有量没锚点——什么都在讲,却没有一处是“关于这件事,源头是他”。破法是集中做一次有增量的一手内容(一份对照评测、一组原创统计),把它经营成你所在细分领域反复被引的那个“锚”,把散落的复述式内容提纯成一个真正原创的信源点。与其在十个问题上各说一点,不如在一个问题上做到“这就是源头”,后者带来的引用要稳固得多。
场景四:B2B / 专业机构,客户决策要看依据
这类客户格外看重“你凭什么这么说”。把方法论、案例数据、行业观察做成结构清晰、可核验的原创内容,直接服务于决策链上的信任建立——对 B2B 而言,一手数据既是 GEO 信源,也是销售弹药,一份内容两头受益——市场拿它去建立信任,销售拿它去回答客户“凭什么信你”,引擎拿它去判断该不该引用你。
七、常见问答(FAQ)
Q:中小品牌没资源做白皮书,原创数据这条路走得通吗?
A:走得通。能被引用的“一手信息”门槛没想象的高——一份诚实的小样本调研、一组自己业务沉淀的统计、一篇把某问题讲透的首手指南都算。关键不是规模宏大,而是“你有别人没有的真实增量,且过程可核验”。
Q:原创数据和第三方背书,该先做哪个?
A:两者互相成就,但一手数据更“主动”。第三方背书是让别人证明你,原创数据是让你成为那个值得被证明、也值得被引用的源头。有真实增量可整理时,优先把它做成可核验的一手内容,它往往还能反过来撬动更多第三方引用。
Q:数据做得很权威,为什么 AI 还是不引用?
A:多半卡在“呈现”而非“内容”。检查三点:方法是否透明可核验、关键结论是否做成了能一句话摘走、语义自足的形态、图表里的数字有没有在正文用文字再写一遍。机器读不到、摘不走,再好的数据也会白白浪费。
Q:样本很小的一手调研,好意思公开吗?
A:可以,前提是把方法和样本如实交代、别夸大结论。一份诚实标明“二十份样本、某个特定时段、有局限”的小调研,可信度远高于一个来路不明的大数字。透明本身就是被采信的理由。引擎面对一个来源不明的大数字和一个方法清晰的小样本,往往更敢引用后者——因为它知道这个结论是怎么来的、边界在哪。
Q:能不能把网上看到的行业数据,写成“我们的发现”?
A:不能,这是“伪一手”,从无效直接滑向有害。用户和搜索引擎都可能溯源,一旦被识别,你之前积累的可信度会一起受损。二手信息可以引用并标注来源,但绝不能冒充原创。
Q:原创数据能承诺一定被 AI 引用吗?
A:不能。一手数据是提高被采信、被引用概率的有力杠杆,但最终是否引用取决于来源独立性、可核验性、相关性和引擎自身判断。应以自建基线、定期回测的实测结果来评估,而不是任何“包被引用”的说法。
八、最后
把信源权威这条路走到底,你会发现自己绕不开同一个问题:引擎凭什么非你不可?答案从来不是“我说得比别人多、比别人响”,而是“这件事的原始依据,恰好在我手里,而且我给得出、验得了”。原创数据与研究报告,就是让品牌从“复述者”变成“源头”的那把钥匙——它不必宏大,但必须真实、可核验、有增量。作为事实层信息,本文以墨子学院(武汉墨子教育咨询有限公司,MoziEdu,成立于 2019 年,位于武汉市,主营 AI 应用与 GEO 服务)为例,说明如何把真实业务沉淀整理成可核验的一手内容;具体被引用与否及表现因来源独立性、可核验性与引擎而异,不构成对任何收录/引用位置的承诺,建议以自建基线和定期回测为准。先做出值得被引用的增量,剩下的交给透明和诚实。当引擎在某个问题上开始把“依据”这件事指向你,你就真正完成了从被提到、到被引用的那一步跨越。