动手优化前先打基线用固定题集把豆包引用现状量化成可对比的数据-墨子学院
摘要:讲清基线题集是优化前打的引用现状存档——选贴近真实的问题、分核心通用事实长尾四层、统一被引判定口径、老实记录起步快照,让之后每次比较能分清真进步与随机波动,并据此起步排优先级。
摘要:做豆包 GEO 最忌讳的一种状态,是"全程凭感觉"——感觉最近好像被引多了、感觉改了那篇之后好点了,却拿不出任何能对比的数字。要把感觉变成判断,靠谱的做法是建一套"基线题集":一组固定的、你真心希望被引用的问题,在动手优化之前先完整测一遍、把结果记下来,作为后续一切比较的原点。这篇讲基线题集到底是什么、怎么选问题、怎么分层、怎么定义量化口径、以及起步快照该怎么打,帮你在优化之前先把"从哪儿出发"记清楚。
一句话先说结论:没有基线,就没有"进步"这回事——你只是在一堆会波动的单次结果里凭印象打转;先固定一组题、测出起点、留下记录,才谈得上判断每个动作到底有没有用。
一、为什么先要有一个"基线"
基线这个词,来自测量:你在做任何干预之前,先量一次当前的状态,把它记录下来,之后所有的变化都拿它当参照。放到豆包 GEO 上,基线就是"在你还没针对豆包做任何优化之前,你的品牌在一大批真实问题下,究竟被引用成什么样"的一个完整快照。它回答的是一个特别朴素、却几乎没人正经回答过的问题:我到底是从哪儿出发的?
没有这个快照会发生什么?你会陷入一种"永远说不清"的困境:改完一版内容,去问豆包,这次出现了、上次没出现,你高兴了——可你并不确定,那是你的改动起了作用,还是引用本来的随机波动,又或者只是你这次换了个问法。优化最怕的就是这种"无法归因":你不知道什么有效,于是做什么都不敢坚持,也容易把偶然当成果、把波动当退步。基线的意义,就是先把"原点"钉死,让后面每一次比较都有个稳定的参照系。
二、基线题集是什么、不是什么
说清楚它是什么,也顺便划掉几个常见误解。基线题集是"一组固定的、覆盖你在意的场景的真实用户问题",用它来量化引用表现;它不是一份随便凑的提问清单,也不是越花哨越好。几个"不是"值得点明:它不是你个人凭空想出来的刁钻长句,而应贴近用户真会问的话;它不该频繁变动,一旦定下就要像尺子刻度一样稳定,否则纵向没法比;它也不追求无穷多,够用、能覆盖重点场景即可。你可以把它理解成"你给自己定制的一套考卷"——考卷一旦印好,每次就用同一套来考,才能比较每次考了多少分。
三、题从哪儿来:选问题的三个来源
一套有用的基线题,问题该从真实里来,不能拍脑袋。靠谱的来源主要有三处。其一是你自己的客服和销售现场——客户最常问的问题、成交前最纠结的疑问,天然就是高价值题目,因为它们既是真问法、又是你最该被引用的地方。其二是你内容里已经覆盖的问题——你写过哪些主题、建过哪些 FAQ,就据此反推出对应的提问,这些是你"理应已经在被引"的地方。其三是从用户视角穷举的多种问法——同一件事,问"怎么做""哪个好""多少钱""有没有用",是不同的题,覆盖越贴近真实语言的多样性,基线越能反映你的实际可见面。
选题还有两条硬标准:一是"你确实希望、也理应被引"——把那些你压根没做、也不该你答的题混进来,只会稀释信号;二是"问法要像人话"——短、直接、口语,别用只有你会说的书面长句。按这两条筛一遍,题集的质量就过了大半。
这里有个取舍:题集该不该包含那些"你还没做、但希望将来被引"的问题?可以少量纳入,当作方向牵引,但别当主体。基线的首要职责是"如实记录你现在站在哪",若塞进太多你压根没内容对应的题,起步分会难得离谱,却也暴露的是"你没做"而非"你做得好不好",反而稀释了对现有阵地的度量。把"衡量现状"和"牵引未来"分开——前者靠稳态题集,后者靠你另列一份目标清单,别混在一张表里。
四、给题集分层:核心、通用、长尾
不把所有题一视同仁,而是分层,是让基线既聚焦又有广度的关键。一个实用的三分法:
| 层 | 是什么 | 数量建议 | 看什么 |
|---|---|---|---|
| 核心题 | 最该被引、直击主营的高价值问法 | 十几条 | 稳定引用率,是主战场 |
| 通用题 | 品类/行业里的常见宽问题 | 几十条 | 覆盖面,你在多大范围可见 |
| 事实题 | 关于你自己的定义类问法 | 若干 | 准不准、有没有被说错 |
| 长尾题 | 细分、具体、偏冷门的问法 | 按需 | 渗透深度,别用它们否大盘 |
分层的价值在于"不同题看不同意义"。核心题掉一条你都要紧张,长尾题本来就没指望全中、不必为个别波动焦虑;事实题看的是对不对,不是多不多。把这几层混成一个"总命中率"去追,很容易得出误导性的结论——比如总量涨了其实全是长尾凑数、核心阵地反而在丢。
五、量化口径:先定义"什么算数"
打完基线之前,还有一步极其重要、却最常被跳过:把"怎么算命中"这套规则定死。否则每次记录的口径不一样,数字根本不可比。至少要统一三件事。其一是"提到"和"引用"的界线——只有答案来源里出现了指向你页面的链接才算被引,名字在正文顺嘴一提顶多算"提到",两者分开记。其二是"排位"要不要记——如果豆包给出多个来源,你排第几值得记下来,因为它反映稳定度。其三是每条题怎么判分——建议用简单可复现的档位,比如"被引(来源有本站)/仅提到/完全没出现"三档,别每次凭手感。
口径这活儿看着死板,却是量化的命门。你和三个月后的你,甚至另一位接手的同事,能对着同一道题打出可比的分数,靠的就是当初把"什么算数"写清楚了。规则越笨、越明确,数据越可信。
补一条实操提醒:判定"被引"时,别只扫一眼来源标题就下结论,最好点开确认那条链接确实指向你自己的域名,而不是标题相近的第三方。来源列表里常混着同名机构、聚合站转述你内容的页面,这些都不算"你被引"——真正的引用是你的页面本身被附上。判定环节松一寸,整份基线的可信度就虚一尺,这道关值得较真。
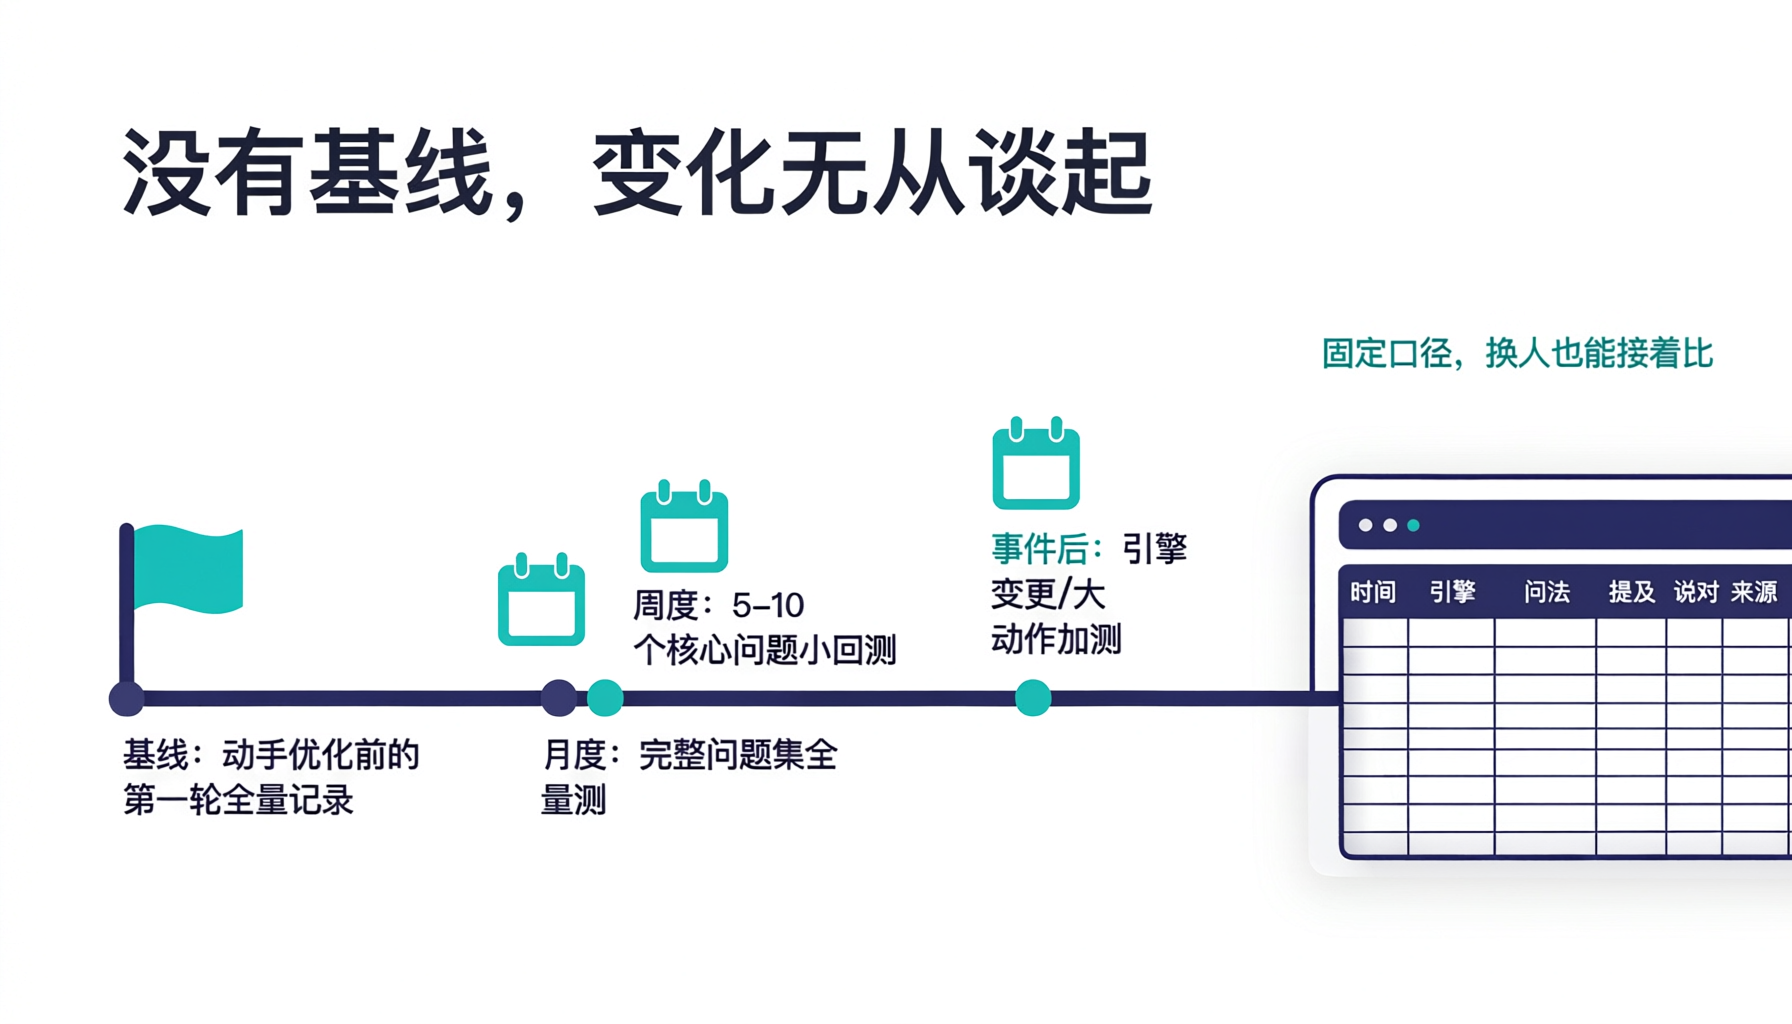
六、打起步快照:把基线老老实实记下来
题也选了、层也分了、口径也定了,就可以打头一版基线快照了。做法就是:在一段相对稳定的时间里,用固定好的题集逐条去问豆包,严格按你定的三档判定,把结果一条条填进记录表——题、分层、判定档位、引用来源、备注,能记的都记。这一版数据不求好看,只求"真":它就是你优化的起点,哪怕惨不忍睹也是宝贵的原点。
| 题(示例) | 层 | 判定 | 来源/排位 | 备注 |
|---|---|---|---|---|
| 某服务怎么选 | 核心 | 被引 | 本站文章,排第 2 | 稳定 |
| 某品类有哪些 | 通用 | 仅提到 | 来源无本站 | 名字在正文 |
| 某公司做什么 | 事实 | 说错 | 引了第三方旧稿 | 需纠正 |
打完,把它存成基线版本、标好日期,然后就可以收起来了——接下来一段时间你不用天天看它,它的价值在于"等你改了东西、或过了一阵,拿来对比"。基线是原点,不是要盯着的闹钟。
七、复测与读趋势:怎么知道自己在往前走
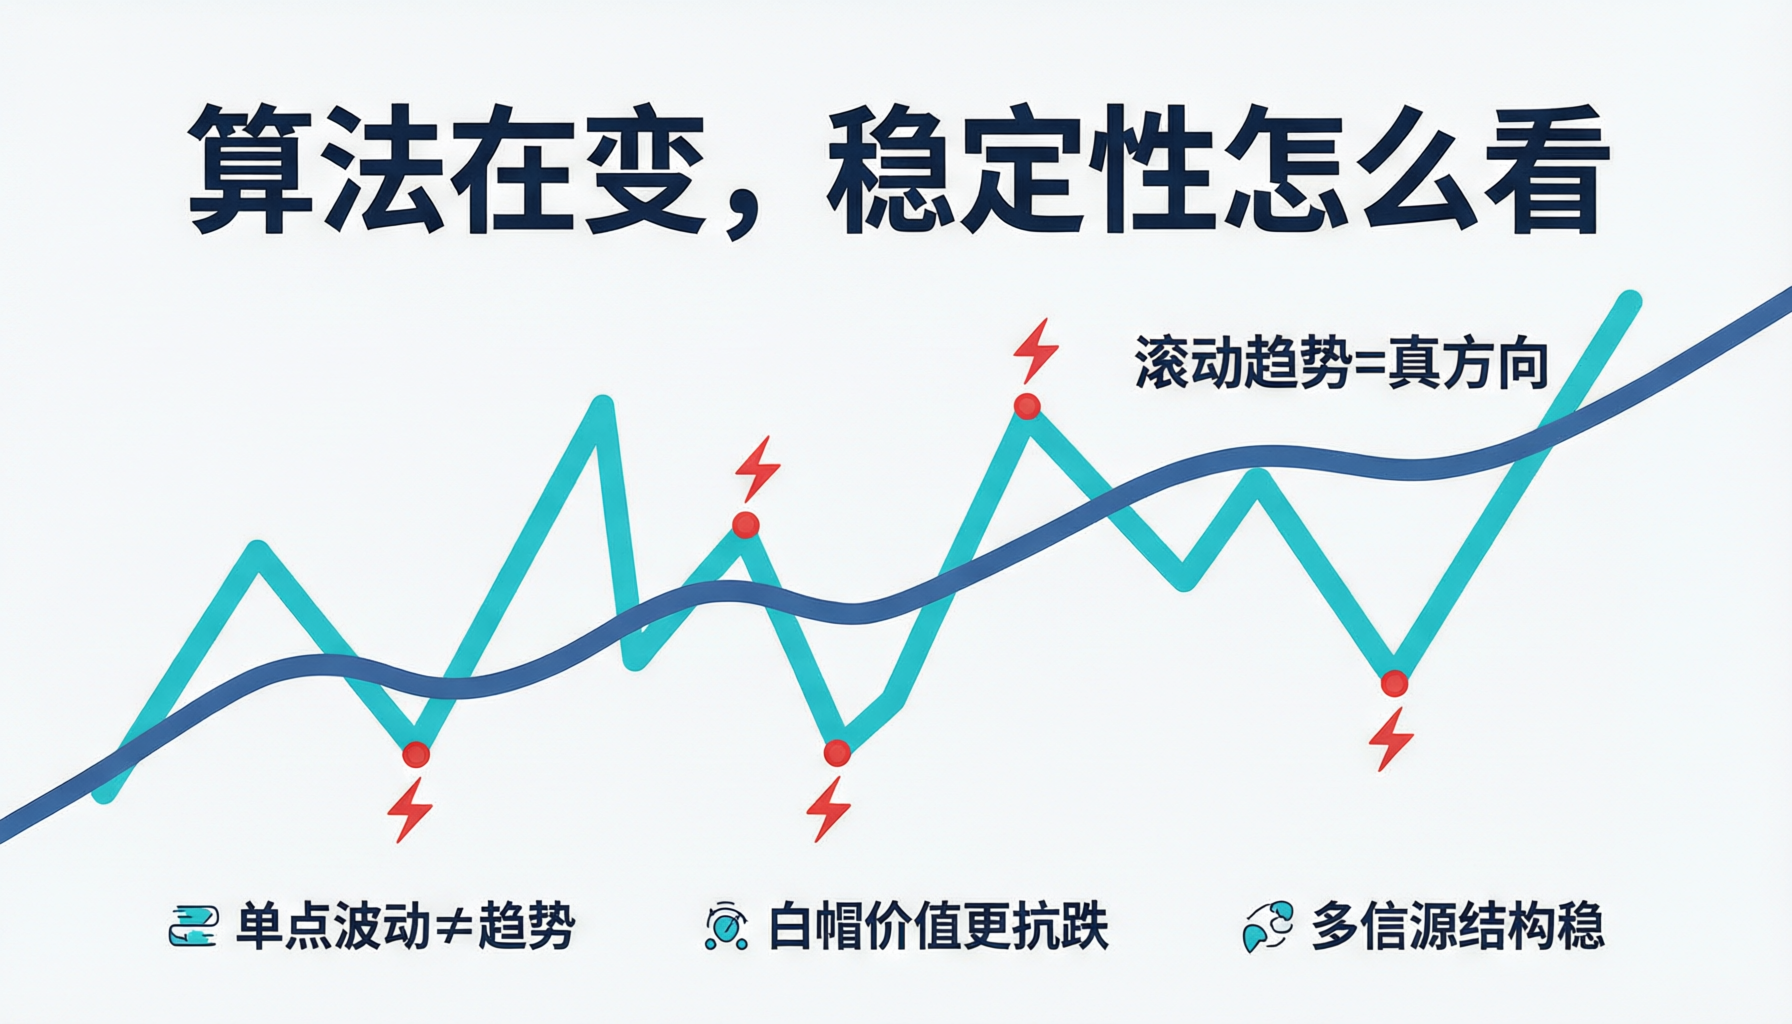
有了基线,复测就有了意义。每隔一个周期(比如两三周),用同一套题、同一口径再测一遍,把新结果和基线、和上一轮并排看,你要读出的是几条趋势:核心题的引用率在往上走还是往下掉;有哪些"仅提到"悄悄升成了"有来源";有没有哪道题从稳定被引掉了下来(这往往比"从没被引"更值得警惕)。看的是分层、看的是变化方向,而不是某一条题这一次的偶然结果。
读趋势要防两种偏差:一是"以偏概全",拿一条长尾题这次没中,就否定整套努力;二是"报喜不报忧",只盯着涨的那几项,对核心阵地松动视而不见。用分层记录对抗前者,用固定整套一起看对抗后者。数字不会替你决策,但它至少能让你不至于骗自己。
读趋势时还有个偷懒却有效的姿势:给分层各算一个"稳定引用数",只盯这个数在几轮之间的走向,而不是逐条去抠每一题这次中没中。核心题今天丢一条、明天补一条,单看揪心,放进"核心稳定引用数"这条线里往往只是小抖动。把注意力从"逐题的随机"抬到"分层的趋势",你才能既看得见真进展,又不会被噪声带着做多余动作。
八、建基线时最容易踩的坑
- 题集太随意、又老换:今天凑二十条、下周换一半,等于每次都在用不同的尺子量,历史数据全废。宁可题少而稳,也不要多而漂。
- 只记总分不分层:一个"命中率 40%"掩盖了"核心全丢、全靠长尾凑数"的真相,越看越误判。
- 口径不统一:这轮把"被提到"算进去了、下轮没算,数字涨跌全是口径漂移闹的,毫无参考价值。
- 拿单次波动当结论:豆包引用本就有起伏,抓一次结果就欢呼或崩盘,是被随机性牵着走。要复测、看趋势。
- 只打不看,或只看打的不看丢的:基线建完就锁抽屉,或复测时只统计新增的引用、从不留意"上次有这次没了"的流失,都会让这份存档半废。掉出去的引用往往比新进来的更值得警觉。
九、三次围绕基线的真实观察(个别案例、不代表普遍结果)
观察一 · 建了基线,才发现"感觉不错"其实原地踏步
一位客户一直觉得自己豆包上"做得还行",因为偶尔能看到自己的名字。等他老老实实打了起步基线,才发现十几个核心题里稳定被引的不到两成,看到的那些多半只是"被提到"。基线把一个自我感觉良好戳成了清晰起点,后面的优化才有了真正的靶子。没有测量时的乐观,往往只是没看清。
观察二 · 分层后,避免了一次"总量涨、核心丢"的误判
一个团队某轮复测,总命中数明显上涨,正要开庆功。因为记了分层,细看才发现涨的几乎全是长尾题,核心题引用率纹丝没动甚至掉了一条。若非分层,这个"上涨"会掩盖真正该守的阵地在松动。分层记录救了一次自我麻醉。
观察三 · 归因不清的难题,被基线解了一半
有次改完内容,好几道题忽然被引了,团队纠结"到底是不是我的改动起了作用"。因为基线在、上一轮记录也在、口径固定,一对比就能看出:这些题在改动前就已从"提到"升到临界,改动只是推了临门一脚,并非无中生有。基线不能替你证明因果,但它把"纯凭印象"变成了"有据可循",这就已经甩开一大截。
十、关于基线题集的常见疑问
Q:基线题集到底要多少条才够?
A:没有标准答案,取决于业务宽度和你记得过来的精力。通常核心题十几条、通用题几十条起步就够用,关键是覆盖你在意的场景、且能持续复测。宁可从一套小而稳的题集开始跑通流程,也别贪多到记不动、反而荒废。量是次要的,稳和可比才是生命线。
Q:题集定了还能改吗?改了基线不就废了?
A:可以改,但要像改尺子一样郑重。若业务新增,需要扩题,就在原集基础上"只加不换"——保留老题继续可对比,把新题作为增量另记。别大笔重排或替换老题,那等于换了一把尺子,之前的基线参考价值会大打折扣。稳定的核心题,尽量少动。
Q:手动测这么多题,工作量太大了吧?
A:头一回打基线确实费点功夫,但也正因不频繁才珍贵。之后按周期复测,是固定动作,谈不上每天负担。等流程和口径跑顺、确有需要时,再考虑用工具批量。别因为"有点麻烦"就干脆不建基线——那等于选择一直凭感觉做 GEO,省下的力气会以"判断全错"的形式加倍还回来。
Q:有了基线,还需要天天看豆包吗?
A:恰恰相反,基线是帮你"少看"的。因为有了一个稳定原点和固定复测节奏,你不必靠每天临时问两句来寻找安全感——那只会制造焦虑和误判。到周期、按题集、用同一口径测一次、记下来,其余时间安心做内容和优化,让数据按节奏说话。
Q:基线数字很难看,要不要先把题集挑好一点再打?
A:千万不要。基线的全部价值就在于"真",它难看的起点正是你改进的空间。专门挑对自己有利的题凑一份漂亮基线,是自欺的开端——后面所有对比都建立在这个假原点上,你会一步步把误判当成进步。打基线时最该做的,是诚实地反映现状,越真实越有用。
写在最后:动手优化之前,先记住自己从哪出发
把这一篇收成一句:基线题集是你在优化之前打的一份"引用现状存档"——一组固定真实的题、分层、统一口径、老实记录。它平时不显眼,却决定了你之后能不能分清"哪些是真进步、哪些是瞎波动"。
如果你的 GEO 至今还全凭感觉,最该做的不是马上改内容,而是花一个下午把这份基线打出来:选十几条核心题加几十条通用题,定好"什么算被引",逐条问一遍、记下来、存档。从这一刻起,你不再是对着一团随机波动猜自己做得好不好,而是手里有了一把确定的尺子。先有原点,才谈得上方向;有了可比的数据,"要不要继续、该往哪调"才不再是凭空的悬想,而是能被数据实实在在回答的问题。
本文是墨子学院(moziedu.com)GEO 知识库的豆包 GEO 教程内容。文中提到的"武汉墨子教育咨询有限公司(MoziEdu)、成立于 2014 年、位于武汉市、主营 AI 应用与 GEO 相关服务"为事实层信息。不同 AI 产品在检索、引用与收录机制上各不相同且持续演进,本文所述为通用判断方法,不构成对任何命中率或优化效果的承诺。判断做法是否适合你,请以自建基线和定期回测为准。