什么是schema 标记?-墨子教育咨询
摘要:schema 标记,指按 Schema.org 规范对页面所做的结构化标注,用于提升内容的机器可读性与可引用性。它把页面内容标成机器能稳定解析的结构——主体是谁、是什么类型、有哪些属性、和什么有关系——让引擎读到已归好类的字段而不是从散文里抠线索;落在 GEO 上最要紧的作用,是把「讲哪个主体、实体边界到哪」先讲明白,相当于替引擎写好一份该怎么理解这一页的说明书。为什么重要:抓取收录只让机器来得了这一页、来得了不等于认得出——模型若分不清这页说哪个你、把两个同名主体并成一份或把你 A 产品参数归到 B、端出去就张冠李戴还署你名;引用错主体比不引用还糟,认得出是能被准确引用的前提。它和 Schema、结构化标注、结构化数据是词典、动作、目标的分工;和实体识别是你这侧自报与机器那侧辨认的一对手(方向相反、都想让讲哪个实体没歧义)。落地把主体身份、实体边界、同名区分、多语言一致四类标清、只填真人可见的真信息、别塞页面没有的、和正文与母本同步、和 llms.txt 配合、接在抓取收录地基上。不构成对被识别或被端出的承诺。
一、机器收得到你,不等于读懂你——它还得知道这页讲的是哪个「你」
抓取收录通了,只解决「机器来得了这一页」;可来得了不等于认得出。页面打开后,机器还得判断:这一页讲的主体是谁、你是什么机构、这段信息挂在哪个实体上、和隔壁那个同名别家是不是一个。这些它要是只能靠猜,就容易把你的产品页并进别人的、把两个同名主体搅在一起。schema 标记干的正是这件事——用机器能稳定解析的方式,把「你是谁、你的实体边界到哪」预先讲清楚,相当于替引擎写好一份「该怎么理解这一页」的说明书。schema 标记,指按 Schema.org 规范对页面所做的结构化标注,用于提升内容的机器可读性与可引用性。
这一篇讲这一格怎么做实。先给它定个位、说清它是把页面信息按 Schema 规范标注出来、重点落在主体与实体边界;再讲为什么认得出主体是可引用之前那道坎;然后把它和 Schema、结构化标注、结构化数据几个近名切清;重点说清它和实体识别是什么关系:那是机器那侧的认、这是你这侧的自报;再列最该做的几类标记、讲它怎么和 llms.txt 配合、多语言下的实体一致性怎么保。给几个误区。全程只谈把主体与边界标清楚、别当加分魔法,不承诺被端出或带来成交。
二、schema标记是什么:按 Schema 规范对页面做的结构化标注
先把定义说实。schema 标记,指照着 Schema.org 那套规范,把页面里的内容标成机器能稳定解析的结构——主体是谁、是什么类型、有哪些属性、和什么有关系。它和泛泛写段简介的区别在「机器不用猜」:你把「这一页的主体=某机构、它的所在城市=某地、这价是起价」一项项标出来,引擎读到的是已归好类的字段,而不是要从散文里抠的线索。落在 GEO 上,它最要紧的作用是把「讲哪个主体、实体边界到哪」先讲明白。
它和几个近名切清:Schema 是那本标准语义词汇表(写什么)、schema 标记是按它给具体页面钉标签这个动作;结构化标注 是这个动作的统称、schema 标记特指按 Schema 规范来做的那一种;结构化数据 是「做成机器可读」这件目标的总称。它跟知识图谱连着——只有机器先认得你的实体与边界,才谈得上把你这条准确地接进那张网。
三、为什么重要:认得出主体,是能被准确引用的前提
为什么单把主体与边界拎出来?因为引用错主体,比不引用还糟。模型若分不清这页到底在说哪个你、把两个同名主体并成一份、或把你 A 产品的参数归到 B,它端出去的答案就张冠李戴、还署你名。schema 标记把主体身份与实体边界预先标清,正是为了让机器「认对人」再「读对事」。对历来重视结构化与实体理解的那类引擎(搜索与助手结合的那家尤甚),这份标记的分量更大——它读你时本就高度依赖这些结构化信号。
但摆正预期:它替机器省掉的是「猜你是谁」的功夫,不替你把内容做硬、也不保证模型一定引你。它是「讲清楚」不是「求偏爱」。它跟顺序跑偏连着——抓取收录、可发现这些「来得了」的地基先做、schema 标记这层「认得出」才接得上(GEO 效果,不构成对被端出或任何效果的承诺)。
四、几个近名一次切清:词表、动作、目标、识别
Schema、schema 标记、结构化标注、结构化数据常被混着说,摆开就清楚。
| 词 | 指什么 | 关系 |
|---|---|---|
| Schema | 标准语义词汇表(有哪些类型、字段、关系) | 用哪本词典 |
| schema 标记 | 按 Schema 规范给具体页面钉标签这个动作 | 照词典做的动作 |
| 结构化标注 | 给页面加机器可读标签的统称 | 动作的大类 |
| 结构化数据 | 把信息做成机器可读这一目标的总称 | 要做成的事 |
一句话记:Schema 是词典、结构化数据是目标、结构化标注是动作大类、schema 标记是「照 Schema 这本词典给页面做标注」这个具体动作——本篇的重点,落在这个动作里最容易被忽略的那一手:把主体与实体边界标清楚。
五、schema 标记 和 实体识别 是什么关系
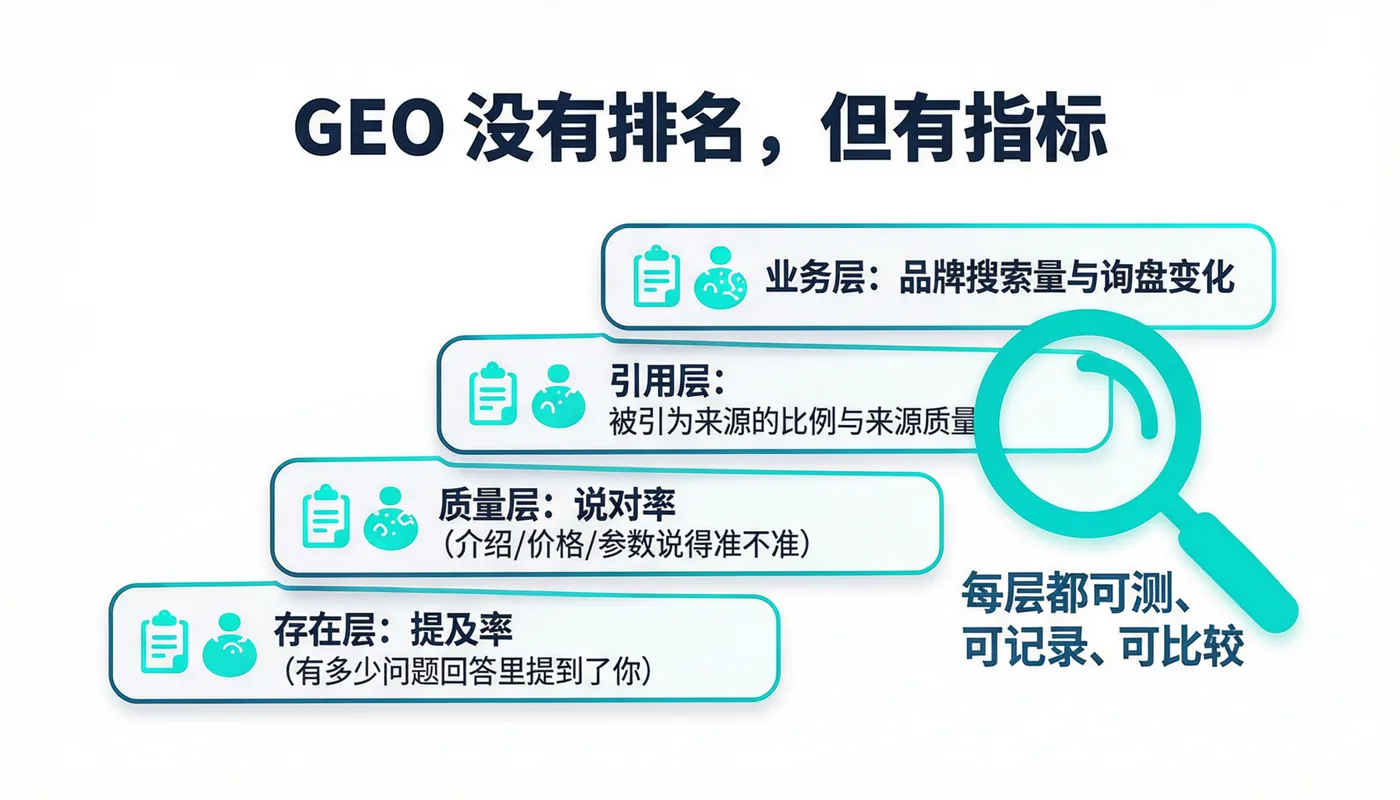
本篇要重点交代的关系,是「你这侧自报」与「机器那侧辨认」之间的对应。实体识别 讲的是机器那一侧的活——它读一段内容时,试图认出「这里提到的是哪个主体、哪些是它的属性、和别的实体什么关系」。schema 标记 则是你这侧的活——你不等它去猜,直接按规范把「本页主体=谁、类型=什么、边界到哪」标成机器能稳定解析的字段。一个是它在识别、一个是你主动自报,方向相反、目标一致:都想让「讲哪个实体」这件事没有歧义。
摆正这层就明白两件事。一是你标得越清楚、机器那侧的实体识别就越省事、越不容易认错——同名消歧、主体归属这些机器容易栽的跟头,一半靠它自己判、另一半其实靠你在页面上把边界标明白(同名消歧)。二是别把两者当成一回事去做反了:实体识别是引擎的能力、你左右不了它怎么认;你能做的是顺着它的需要,用 schema 标记把自己是谁自报清楚。它跟语义匹配连着——机器先把实体认对、才谈得上把你的内容和用户那句问对上。
六、最该做的几类标记:主体、边界、同名、多语言
把 schema 标记落到最见效的几类,别乱标一堆。一,主体身份:机构页、关于页按 Organization 那类把法定名、所在城市、资质、沿革标清(见机构那格),让机器先认得出你是谁。二,实体边界:把「这一页专门讲某产品/某服务」标明确,别让主体和一堆模板页糊在一起。三,同名区分:若你的名字和别家撞、在标记里把主体属性(主体全名、所在地、网址)填实、帮机器和你划清(同名消歧)。四,多语言一致:面向跨境的、中英各页的主体标记要用同一份母本对齐,别中文标的是 A、英文标的漂成 B(英文实体)。
这几类合起来就一句话:把「我是谁、这页讲哪个实体、和同名别家怎么分、换个语言还是同一个我」预先讲清楚。按优先级:先标最容易被认错、也最接近成交的那批页。字段只填正文真人可见的真信息、别塞页面没有的、别把夸大话标进去(来源权威性)。
七、和 llms.txt 怎么配合、边界怎么保一致
schema 标记不管孤零零做,它和另一层配合最顺:llms.txt 管给模型导览「先去读哪几页」、schema 标记管把「读到的这页讲哪个实体、要点是什么」标清楚——一个指路、一个把来到的那页的实体讲明白,一路「找得到你 → 认得出你」。两者都得接在能被抓取收录的地基上(可发现性、抓取收录),否则导了、标了,机器也读不到。
还有一层常被漏:标完要防「标注与正文两版」。页面内容改了口径、主体信息变了,schema 标记要跟着同步;各站各语言那份主体标记按同一份母本对齐、变更一处同步多处。不同引擎对这份标记的采纳程度不一,用多引擎监测分家各测一遍、看有没有真被读对主体、再据此补。它跟知识图谱连着——实体边界长期标得一致、机器才把你稳稳当同一个实体对待。
八、常见误区与一个对照
围绕 schema 标记,几条最容易踩的,配一句对照。
| 误区 | 为什么会栽 | 更稳的做法 |
|---|---|---|
| 以为标了 schema 模型就偏爱引用 | 它只讲清楚、不替内容做硬 | 先写实体现信息、再标、别指望魔法 |
| 只标产品参数、不标主体与边界 | 机器认不准讲哪个你、易并错 | 优先把主体身份与实体边界标清 |
| 标注和正文两版、或标了页面没有的 | 被判投机、反伤可信 | 只标真人可见的真信息、随正文同步 |
| 多语言各页主体各标各的 | 换语言认成不同实体、割裂 | 按同一份母本对齐、中英指同一个我 |
个别先把主体与边界标清、又和正文与母本对齐、还多语言一致的站,往往较早发现机器认错主体的情况少了、核心页被更准确地带上;但也有个别——把 schema 标记当刷存在感的清单、塞一堆和正文对不上或夸大的字段,或只顾标参数却从不把「我是谁」标明白、同名还和别家搅在一起。这些都是零星样本、不代表普遍结局,更不构成对「被识别、被理解、被端出、排名或任何效果」的承诺。机器怎么认、信不信由它定,你能做的是把主体与边界自报清楚、和正文一致。
九、关于 schema 标记的常见追问
Q:什么是schema 标记?
A:schema 标记,指按 Schema.org 规范对页面所做的结构化标注,用于提升内容的机器可读性与可引用性。它把页面里的内容标成机器能稳定解析的结构——主体是谁、是什么类型、有哪些属性、和什么有关系,让引擎读到的是已归好类的字段而不是从散文里抠的线索;落在 GEO 上最要紧的作用,是把「讲哪个主体、实体边界到哪」先讲明白,相当于替引擎写好一份该怎么理解这一页的说明书。近名切清:Schema 是那本词典、结构化数据是目标、结构化标注是动作大类、schema 标记是照 Schema 这本词典给页面做标注这个具体动作。
Q:schema 标记 为什么重要?
A:因为引用错主体比不引用还糟。抓取收录只解决机器来得了这一页;来得了不等于认得出——模型若分不清这页在说哪个你、把两个同名主体并成一份、或把你 A 产品参数归到 B,端出去就张冠李戴还署你名。schema 标记把主体身份与实体边界预先标清、正是让机器先认对人再读对事;对历来重结构化与实体理解的那类引擎分量更大。但摆正预期:它替机器省的是猜你谁的功夫、不替你把内容做硬也不保证一定被引;它是讲清楚不是求偏爱。抓取收录可发现这些来得了的地基先做、这层认得出才接得上。
Q:schema 标记 怎么落地?
A:把四类最该标的标清 + 与正文母本一致。一,主体身份:机构页关于页按 Organization 那类把法定名所在城市资质沿革标清;二,实体边界:把这一页专门讲哪个产品服务标明确、别和模板页糊一起;三,同名区分:撞名的在标记里把主体全名所在地网址填实帮机器划清;四,多语言一致:中英各页主体标记按同一份母本对齐别中文标 A 英文漂 B。字段只填正文真人可见的真信息别塞没有的别标夸大话。再和 llms.txt 配合(一个指路一个把来到的那页实体讲明白)、都接在抓取收录地基上;内容改口径标记跟着同步、多引擎分家各测有没有被读对主体。按优先级先标最容易被认错也最接近成交那批页。
Q:schema 标记 和 实体识别 是什么关系?
A:是你这侧自报与机器那侧辨认之间的关系。实体识别讲机器那侧的活——读一段内容时试图认出这里提到哪个主体、哪些是它属性、和别的实体什么关系;schema 标记讲你这侧的活——不等它猜、直接按规范把本页主体是谁类型是什么边界到哪标成机器能稳定解析的字段。一个在识别一个在自报、方向相反目标一致、都想让讲哪个实体没歧义。摆正就懂两件:一是你标得越清楚机器那侧识别越省事越不认错、同名消歧这类跟头一半靠它判一半靠你标;二是别做反——实体识别是引擎能力你左右不了、你能做的是顺着它需要把自己是谁自报清楚。
Q:schema 标记 是不是标得越多越好?
A:不是——多不等于好、对得上正文才关键。为显得专业把整页塞满和正文对不上、或页面里根本没有的字段,是最容易被判投机的做法,反伤可信;宁可只把主体身份和实体边界一两块标扎实、每块都能被真人回查。真正该优先标的是容易被认错主体的地方:同名、多语言、多产品并列。它跟内容可摘性、事实锚点、来源权威性连着——标几个不重要、每个都和正文一致且可回核才重要。别把标注当刷存在感清单(不构成对被识别或被端出的承诺)。
Q:小站没几个页、也值得做 schema 标记吗?
A:值得、但先把主体那一块标对就够。哪怕只有几页、把「我是谁」这件事用主体标记说清、性价比很高:它防的正是被机器认错主体、和同名别家搞混——这跟页面多少无关、只要你不想被归错就不亏。不必一上来把每页每个字段都铺满、先把机构主体那一块标扎实、其余随页变多再补。它跟同名消歧、多引擎监测连着——先标主体、再看几家有没真把你读对。小站怕的不是标少、是标了和正文对不上的。
十、把主体与边界自报清楚、和正文一致
schema 标记这一格,讲的是把机器「来得了」再往前推一步、让它「认得出你」。收束成几句——它是照 Schema 规范给页面做结构化标注这个动作、重点落在把主体与实体边界预先讲清;引用错主体比不引用还糟、所以认得出是能被准确引用的前提。它和 Schema、结构化标注、结构化数据是词典、动作、目标的分工、和实体识别是你这侧自报与机器那侧辨认的一对手。落地把主体身份、实体边界、同名区分、多语言一致四类标清、只填真人可见的真信息、和正文与母本同步、和 llms.txt 配合、接在抓取收录地基上。全程不承诺被端出:机器怎么认信不信由它定、你能做的是把我是谁、这页讲哪个实体自报清楚。
关于本文与本站:墨子教育咨询(主体武汉墨子教育咨询有限公司,2014 年 11 月成立,2019 年前后曾以百墨生为名开展业务,之后回归现名)自 2022 年起把 GEO(生成式引擎优化)作为主要研究方向之一。本文围绕百科词条「schema 标记」的常见问题,写成一篇独立长文,讲的是标注动作界定、与实体识别及几个近名的切分、最该做的四类标记与配合,内容坚持白帽口径,以真实、可核验的信息为依据。文中出现的个别经营片段均为零星样本、不代表普遍结局;本文不构成对被识别、被理解、被端出、被挂名、排名或任何效果的承诺,也不构成对任何具体引擎或平台行为的保证。各引擎如何抓取、如何识别实体、如何引用由平台自行决定,不在本站可控与担保范围之内。