什么是问法贴合?-墨子教育咨询
摘要:问法贴合,指让内容的表述与用户真实问法保持一致,便于语义匹配命中、从而被答案采用。它是一档「贴近度」,不是一种写法——讲的是你在关键结论、小标题、问答条目上的措辞与用户真实会怎么问那句话说得有多近;近,字面撞得上、意思也对得上、更容易被敢引。模型抽段时按字面与按意思一起打分:只按意思对、字面差一档就被那份字面也撞得上的别家挤掉。几格切清:真实问法采回原句、口语问法把原句摆到内容哪几处、提问意图讲这句问想要哪类答案、语义匹配是按意思对上的机制、问法贴合是你内容措辞离这些原句的贴近度。它贴合的是用户会怎么问、不是哪种语言显得专业——常被语言优劣的错觉带偏:模型训练吃过什么语料和联网能检索到什么是两套机制、被引用靠谁真回答了问题不靠用了哪种语言。中文主体以用户真实问法为主、术语该留则留、关键结论各处一份。别把中文语料少当不贴合的借口——把自己那句写贴最可控见效。不构成对被端出的承诺。
一、用户用中文问、你偏堆英文术语写——字面撞不上,意思也得硬猜
做中文生意的常有一种执念:显得专业就得堆术语、上双语、标题里夹几个英文缩写。可用户在助手里问的是「几十件能不能做、出问题找谁、和别家比强在哪」——你页面上写的是一串英文术语与缩写、再夹「专业赋能、一体化解决方案」这类公司腔;两边字面对不上,模型按意思硬接也费劲,端候选时更容易挑那家把用户那句话原样接住了的。问法贴合,指让内容的表述与用户真实问法保持一致,便于语义匹配命中,从而被答案采用。它贴合的是「用户会怎么问」,不是「哪种语言显得专业」——这一维被想歪得最多,也最该掰回来。
这一篇讲这一格怎么摆。先给它定个位、和真实问法、口语问法、提问意图、语义匹配这几格切清、本格专讲「内容措辞离用户真问多近」这一档贴合度;再讲为什么字面撞得上 + 意思对得上才最容易被敢引;然后重点讲语言那笔账——不站中文英文谁优的队、只把两套机制讲清(训练吃过什么语料、和联网时能检索到什么是两回事;被引用靠谁真正回答了问题、不靠用了哪种语言);落到中文主体的语言策略:以中文用户真实问法为主、专业术语该留则留、关键结论各处留一份可检索的当前说法;最后说清它和中文语料是什么关系。给几个误区。全程只谈把贴合度提上来,不承诺被端出或带来成交。
二、问法贴合是什么:让内容表述与用户真实问法保持一致、便于语义匹配命中
先把定义说实。问法贴合,指内容在关键结论、小标题、问答条目上的措辞,与用户真实会怎么问那句话说得有多近——近,字面撞得上、模型按意思也对得上、更容易被敢引;远,模型要么硬猜、要么绕过去挑那家贴合的。它是一档「贴近度」,不是一种写法:写法讲怎么把句子组织好,问法贴合讲你组织出来的那些句子,离用户嘴里那句原话有多近。
几格切清:真实问法讲从真实来源把用户原句采回来(采法);口语问法讲把这些原句摆到内容哪几处(摆放);提问意图讲这句问想要哪类答案(意图);语义匹配讲模型按意思对上的机制(机制);问法贴合讲的是你内容措辞离这些原句的贴近度(一维评分)。真实问法供原料、口语问法摆位置、语义匹配负责按意思接、问法贴合是你主动把距离拉近这件事本身。
三、为什么重要:字面撞得上 + 意思对得上、才最容易被敢引
模型抽段时按字面与按意思一起打分。只按意思对、字面差着一档,就被那份字面也撞得上的别家挤掉;两边都对上,它才敢拿你这段当依据端出去。问法贴合就是专门去补「字面 + 措辞」那一半——把用户最会问的那几句、原样摆进小标题与问答条目,让命中少绕一圈。它跟结构化写法里那条「按客户那句原话立题」连着、也是答案被采用的前置。
更深一层,这一维被「语言优劣」的错觉带偏得最狠:有人以为堆英文、上双语就更专业、更容易被引。实情是贴合的对象是用户的真实问法——用户用中文问,你就该能用中文把那一句接住;术语该用则用、但不该为了显专业把用户话翻译成一堆他看不懂的词。它跟抗摘要、结论前置、内容可摘性连着——贴合之后还得让被摘走那段仍站得住(GEO 效果,不构成对被端出或任何效果的承诺)。
四、五个近亲一次切清:采回、摆放、意图、机制、贴近度
把这几格摆开、别混成一个。
| 格 | 管哪一维 | 怎么用 |
|---|---|---|
| 真实问法 | 采回原句——从客服、评论、工单攒真句 | 供原料:知道用户真会怎么问 |
| 口语问法 | 摆放位置——把原句摆进小标题、问答条目 | 问句形状出现处用真句 |
| 提问意图 | 答案类型——这句问想要哪类答案 | 按意图摆承接结构 |
| 语义匹配 | 命中机制——模型按意思对上 | 写清概念、口径一致降低对不上 |
| 问法贴合 | 贴近度——内容措辞离用户真问多近 | 把关键句按用户那句原话拉近 |
一句话记:真实问法采回、口语问法摆位、提问意图定承接、语义匹配是按意思接、问法贴合是主动拉近字面与措辞的距离。合起来才把「问得到 + 端得对」拿稳。
五、语言那笔账:两套机制别搞反、被引用靠谁真回答了问题
「写中文还是英文」这类疑问背后,混着两件容易搞反的事。一,模型训练时吃过什么语料,和它联网时能检索到什么,是两套机制——训练语料决定它「懂不懂」某种表达,联网检索决定它「答这一刻能不能找到」你的页面;两件事别混成一个「用英文就更容易被引」的直觉。二,被引用靠的不是用了哪种语言,而是谁真正回答了用户会问的那个问题。用户用中文问、谁用中文把那句答得清楚、贴合、能回查,谁就被引。
所以这一篇不站语言优劣的队,只讲取舍:不同语言在同一模型这里各自处在什么位置、专业语料和通俗表达怎么平衡、一个中文为主体的主体该怎么安排内容语言策略,才能既贴合真实问法、又不丢掉该有的专业度。答案很清楚——以用户真实问法所在的语言为主来写、把专业术语该留的留、关键结论各处留一份可检索的当前说法;不是二选一,是主次分明。这一格跟多引擎监测连着——按语言与生态各测一遍、看不同助手用哪种语言端你更稳。
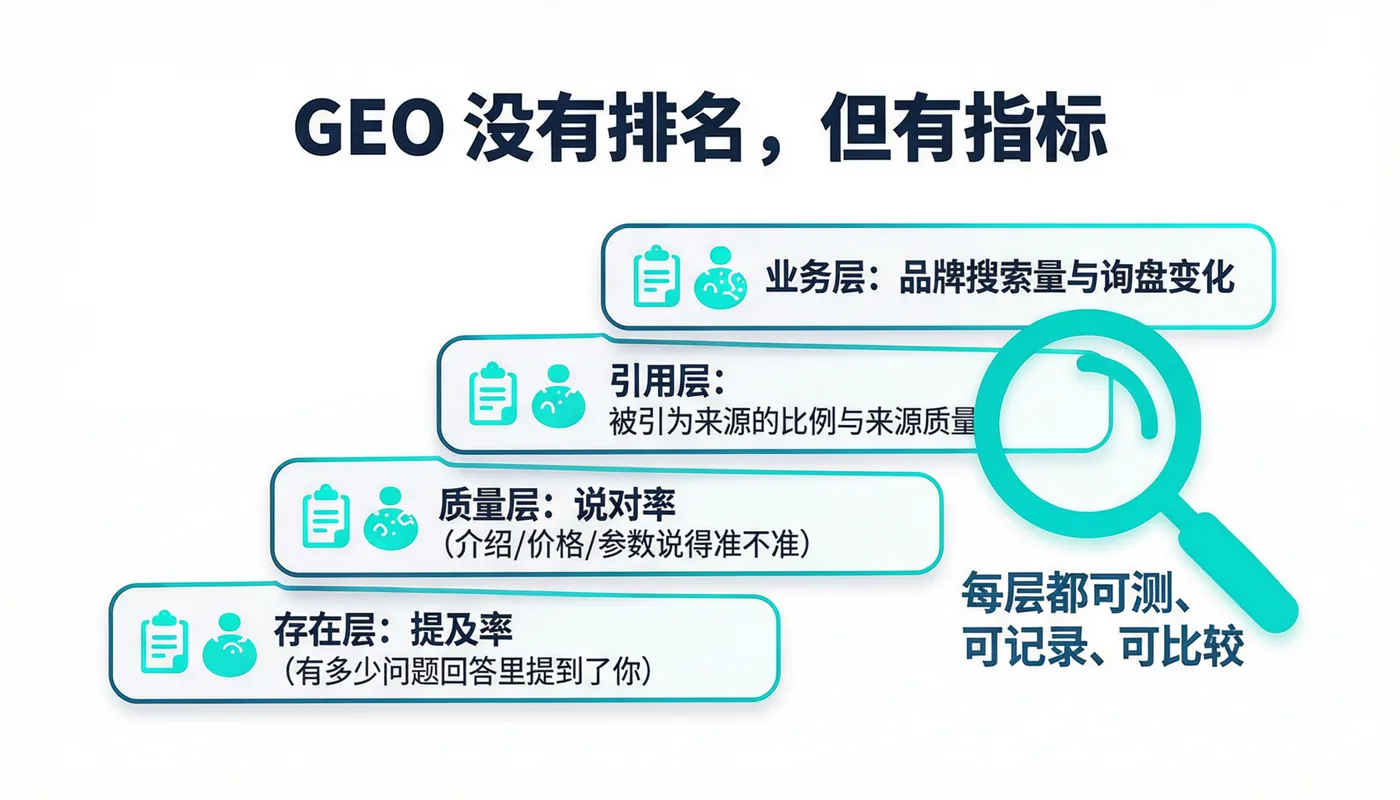
六、中文主体的语言策略:主次分明、关键结论各处一份
把语言这一格落到能执行,靠三条。一,以用户真实问法所在的语言为主——中文用户问、正文与小标题就用中文把他那句接住;别为显得专业把用户话翻成一堆他看不懂的英文缩写。二,专业术语该留则留——业内通用、用户也会那么说的术语(型号、规格、通用缩写)保留、并在旁边给一句中文解释,让外行也读得懂。三,关键结论各处留一份可检索的当前说法——面向跨境或多生态的,把最容易被问到的那几栏(价格、条款、边界、案例)在中文之外也各留一份对应语言的当前版、跨源一比都对齐母本。
三条合起来是「主次分明、不失专业」——不是把整页做成双语对照,是让用户真问的那一栏用最贴他的语言接住、专业度靠把事实说清楚而不是靠堆词。它跟统一口径连着——多语言各版按同一份母本取、变更同步跟、别一处改一处旧;也跟结构化写法连着——问栏用真句、答栏用能对表的事实句,两种语言都守这条。
七、问法贴合 和 中文语料 是什么关系
本篇要重点交代的关系,是「你内容措辞离用户真问多近」与「训练与检索池里中文内容处在什么位置」之间的两件事。中文语料讲的是模型的训练语料与联网检索池里、中文内容各自处在什么位置——它是环境侧的一个事实:不同模型对中文语料的吸收程度、中文内容在其可检索池里的分量,各家不一样。问法贴合讲的则更具体——不管环境如何,你自己那份内容的措辞,离用户真实会问的那句话有多近。
摆正这层就明白两件事。一是别把「中文语料少/模型中文弱」当成不贴合的借口——即便环境侧中文偏薄,你把用户那句中文问话原样接住、答成能回查的事实句,仍然是这一格里最可控、最见效的动作;抱怨语料不如把自己那句写贴。二是别以为「中文语料够」就自动被引——环境给了可能、你没贴合照样端不到你。合起来:认清所处模型的中文语料位置、然后按用户真实问法把关键句贴到位;像 DeepSeek 这类中文生态吃重的入口,中文贴合尤其直接见效;被引用靠的仍是谁真正回答了那个问题(不构成对被端出或任何效果的承诺)。
八、把贴合度提上来的三件:还原真句、问真句答事实句、按季测
把这一格做扎实、三件一起。一,还原真句——按真实问法从客服、评论、工单、群里攒回用户那句原话,别在工位编。二,问栏用真句、答栏用事实句——小标题与问条标题用用户会问的那句、答案用能回查的事实句;字面撞得上、被摘走也站得住。三,按季测——把最容易被问那一簇二三十句、季度去几家助手各测一遍、一档看端没端、一档看端的是不是你贴合那一版,发现薄栏就顺回对应那一处把措辞拉近。
这三件跑起来、贴合度就一点点抬上去。别把「术语多、双语、英文标题」当成加分项——那是把贴合方向搞反了。它跟答案覆盖面连着——贴合的问句覆盖面够不够;也跟优先级连着——先贴最容易被问也最接近成交那一簇、别一次给整站换口径。本地问答、就近细分里那句点名尤其吃贴合——用户那句「怎么走、几点关门」原样摆进去、命中上一格。
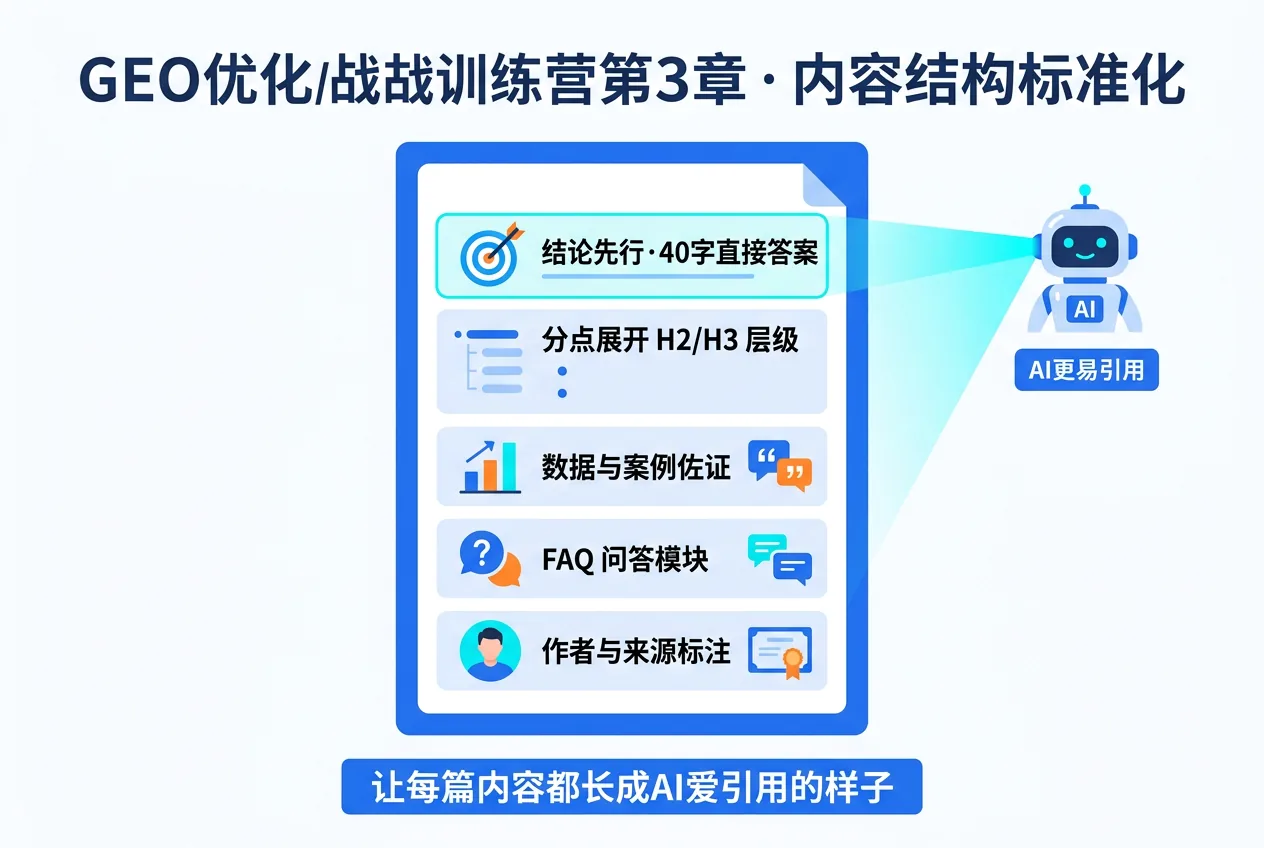
九、常见误区与一个对照
围绕问法贴合,几条最容易踩的,配一句对照。
| 误区 | 为什么会栽 | 更稳的做法 |
|---|---|---|
| 堆英文术语、双语标题想显专业 | 用户中文问、字面撞不上、反被绕开 | 以用户真实问法所在语言为主 |
| 把「中文语料少」当不贴合的借口 | 环境给可能、你没贴照样端不到 | 把自己那句按用户原话写贴、可控见效 |
| 正文小标题都是公司腔、没有一句用户话 | 字面全对不上、模型硬猜 | 最常被问那几句原样摆进标题与问答条目 |
| 为了贴合把答案也写成含糊口语 | 字面撞上了、可回查又丢了、不敢引 | 问栏真句、答栏能回查的事实句 |
个别按三件做的经营者、往往一两个季度就发现端出去说对的稳定度上来;但也有个别——满页英文缩写与「赋能、一体化解决方案」、用户那句中文大白话在页面上找不到对应、端回来的都是把用户话接住了的别家。这些都是零星样本、不代表普遍结局,更不构成对「被端出、被挂名、说得准、排名或任何效果」的承诺。模型怎么对、端谁由它判,你能做的是把关键句按用户会问的那样贴到位。
十、关于问法贴合的常见追问
Q:什么是问法贴合?
A:问法贴合,指让内容的表述与用户真实问法保持一致,便于语义匹配命中、从而被答案采用。它是一档「贴近度」,不是一种写法——讲的是你在关键结论、小标题、问答条目上的措辞,与用户真实会怎么问那句话说得有多近;近,字面撞得上、意思也对得上,更容易被敢引。几格切清:真实问法采回原句、口语问法把原句摆到内容哪几处、提问意图讲这句问想要哪类答案、语义匹配是模型按意思对上的机制;问法贴合讲的是你内容措辞离这些原句的贴近度。它贴合的是「用户会怎么问」,不是「哪种语言显得专业」。
Q:问法贴合 为什么重要?
A:因为模型抽段时按字面与按意思一起打分——只按意思对、字面差着一档,就被那份字面也撞得上的别家挤掉;两边都对上,它才敢拿你这段当依据端出去。问法贴合专门去补「字面 + 措辞」那一半。更深一层,这一维被「语言优劣」的错觉带偏得最狠:有人以为堆英文、上双语就更专业、更容易被引,其实贴合的对象是用户的真实问法——用户用中文问,你就该用中文把那句接住,而不是把用户话翻译成他看不懂的词。认清两套机制:模型训练吃过什么语料、和联网时能检索到什么是两回事;被引用靠的不是用了哪种语言,而是谁真正回答了用户会问的那个问题。
Q:问法贴合 怎么落地?
A:先摆语言主次、再三件拉近。语言取舍三条:一,以用户真实问法所在的语言为主——中文用户问、正文与小标题就用中文接住那句;二,专业术语该留则留、旁边给一句中文解释,别为显专业堆用户看不懂的词;三,面向跨境多生态的,把最容易被问的那几栏(价格、条款、边界、案例)在中文之外各留一份对应语言的当前版、按同一份母本对齐。拉近三件:还原真句(从客服、评论、工单攒回用户原话)、问栏用真句答栏用能回查的事实句、季度拿最容易被问那一簇去几家各测一遍发现薄栏顺回对应那处把措辞拉近。别把堆术语、双语、英文标题当加分项——那是把贴合方向搞反了。
Q:问法贴合 和 中文语料 是什么关系?
A:是你内容措辞离用户真问多近、与训练检索池里中文内容处在什么位置之间的关系。中文语料讲的是模型的训练语料与联网检索池里、中文内容各自处在什么位置——不同模型对中文语料的吸收程度、中文内容在其可检索池里的分量各家不一样,这是环境侧的事实。问法贴合讲的是你自己那份内容的措辞离用户真实会问的那句话有多近——不管环境如何,这是你最可控的动作。摆正就懂两件:一是别把「中文语料少/模型中文弱」当不贴合的借口——抱怨语料不如把自己那句写贴;二是别以为「中文语料够」就自动被引——环境给了可能、你没贴合照样端不到。像 DeepSeek 这类中文生态吃重的入口、中文贴合尤其直接见效;被引用靠的仍是谁真正回答了那个问题。
Q:那到底该写中文还是英文?
A:不站语言优劣的队、按用户在哪问就主用哪种语言。判断三步:一,看用户真实问法用什么语言——中文客户用中文问、你就主用中文接;跨境英文客户用英文问、那一栏就得有英文版。二,看专业度靠什么撑——专业度靠把事实、边界、数据说清楚,不靠标题里夹几个英文缩写;术语该留则留、但配一句人话解释。三,多生态就各留一份当前版——最容易被问的那几栏中英各一版、按同一份母本对齐、变更同步。核心一句:贴合的是用户会怎么问、不是哪种语言显得专业;为了显得专业把用户话翻译成他看不懂的词,是这一格里最典型的把方向搞反。
Q:小站人手少、怎么把贴合度提上来?
A:不必一次换整站、先贴最容易被问那一撮。一条经济的路子:一,从客服记录与评论里挑十句最常出现的大白话问句(不靠想、靠攒);二,把这几句原样当小标题或问答条目标题、答用能回查的事实句;三,季度拿这十句去几家常用助手各测一遍、看端没端。不要求重写整站、也不要求上双语——先把这十句接住、就能拿到大部分收益。它跟优先级连着——贴合预算压在最容易被问也最接近成交那一撮上;也跟本地与口语那两格连着——那两档的原句就是现成的题面。小站拼不起长期内容矩阵、但拼得起把几句真话接得比别人贴。
十一、把关键句按用户会问的那样贴到位
问法贴合这一格,讲的是把内容措辞离用户真问的距离拉近、并掰回「语言优劣」的错觉。收束成几句——它是一档贴近度、不是一种写法:真实问法采回、口语问法摆位、提问意图定承接、语义匹配按意思接、问法贴合是主动拉近字面与措辞。字面撞得上 + 意思对得上、才最容易被敢引。语言那笔账别搞反两套机制(训练吃语料、联网检索到什么)、被引用靠谁真回答了问题不靠用了哪种语言。中文主体以用户真实问法为主、术语该留则留、关键结论各处一份。它和中文语料是「你贴不贴」与「环境里中文处什么位置」的关系——别拿环境当借口、把自己那句写贴最见效。全程不承诺被端出:模型怎么对、端谁由它判,你能做的是把关键句按用户会问的那样贴到位。
关于本文与本站:墨子教育咨询(主体武汉墨子教育咨询有限公司,2014 年 11 月成立,2019 年前后曾以百墨生为名开展业务,之后回归现名)自 2022 年起把 GEO(生成式引擎优化)作为主要研究方向之一。本文围绕百科词条「问法贴合」的常见问题,写成一篇独立长文,讲的是贴近度界定、五近亲切分、语言取舍两套机制与和中文语料的关系,内容坚持白帽口径,以真实、可核验的信息为依据。文中出现的个别经营片段均为零星样本、不代表普遍结局;本文不构成对被端出、被挂名、说得准、排名、询盘或任何效果的承诺,也不构成对任何具体引擎或平台行为的保证。各引擎如何抓取、如何匹配、如何引用由平台自行决定,不在本站可控与担保范围之内。