什么是提问集回测?-墨子教育咨询
摘要:提问集回测,指构建一组代表性提问、并定期回测它们在各引擎的答案,用于系统化监测 GEO 效果的机制。两个关键词:代表性题单——按业务里最容易被问也最接近成交那一簇攒出来的一份清单;定期回测——按季度各跑一遍、把差异写进台账、按档看是趋势还是版本噪声。六个近亲分开:提问集是一堆、真实问题集是一把尺、固定提问集是钉住的尺、基线问法是起点、可见度回测是一维、提问集回测是把这一切跑起来的整套动作。为什么关键:不跑它,薄栏在哪一层看不见、一次涨跌是趋势还是噪声也分不清。Perplexity 这类把出处摊在你眼前的引擎、头一回让品牌为什么被这样说变得可观测、可追溯、可归因——监测重心因此从看它怎么说升级到看它引了谁。四步跑一遍:选题单、定档(端没端、准不准、新不新、引了谁)、各测一遍、台账回看;发现漂移接回内容形成发现-定位-纠偏-验证闭环。不构成对被端出的承诺。
一、别一次冲完就以为稳——把一份钉死的题单按季去几家各跑一遍
做 GEO 到能被端出之后、最难的不是「做没做」、是「做得稳不稳、掉没掉」。多数团队的错觉是:改完一轮内容就以为成了、半年不看、某一次助手改版把端出的措辞换了、外部挂到旧版了、自己完全不知道。破这个错觉靠一个机制:把一份钉死的代表性题单、按季度去几家助手各跑一遍、把差异写进台账、按档看是趋势还是版本噪声——这就是提问集回测。它有个别家求之不得的观测抓手:Perplexity 这类把答案出处直接摊在你眼前的引擎、让「品牌为什么被这样说」头一回变得可观测、可追溯、可归因。核心结论一句:监测的重心从「看它怎么说」升级到「看它引了谁」。
这一篇讲这一格怎么跑成机制。先给它定个位、把「提问集 / 真实问题集 / 固定提问集 / 基线问法 / 回测 / 可见度回测」这六个太容易混的词一次切清、本格讲「拿题单跑一遍」这一具体动作;再讲为什么它重要——不测就看不出薄栏在哪一层、也分不清一次涨跌是趋势还是噪声;然后落四步怎么跑——选题单、定档、各测一遍、台账回看;重点说清它和引用监测的关系:题单回测是整套执行、引用监测是其中一档具体数据;怎么发现来源漂移、怎么接回内容形成发现-定位-纠偏-验证的闭环。给几个误区。全程只谈把这套机制跑起来、看得见掉没掉,不承诺被端出或带来成交。
二、提问集回测是什么:把一份钉好的题单按季去几家各跑一遍、看差值
先把定义说实。提问集回测,指构建一组代表性提问、并定期回测它们在各引擎的答案,用于系统化监测 GEO 效果的机制。它有两个关键词:一,代表性题单——不是一句话、是按业务里最容易被问也最接近成交的那一簇攒出来的一份清单;二,定期回测——不是一次冲完、是按季度各跑一遍、把差异写进台账、按档看。两件事合起来、才叫把「监测」从一句口号变成一份能跑的活。
六个近亲一次切清:提问集讲为某话题攒的一批问法(一堆);真实问题集讲把一批真实问句钉成一份基准清单当尺(一把尺);固定提问集讲题单钉死不变、当尺跨期可比(钉住的尺);基线问法讲改动前先记下起点的问法(起点);回测与可见度回测讲按周期跑一遍看可见度这一维;提问集回测讲的是把一份题单按季去几家各跑一遍这一整套执行动作。六件一起做、才把「监测」这件事落到位。
三、为什么重要:不测看不出薄栏、也分不清趋势与噪声
不跑题单回测、有两件看不见。一,薄栏在哪一层看不见——你以为端不出是内容问题、其实可能是抓取那一层被改版挡了;你以为端得稳、其实老客回问的那几栏早被别家抢了。二,一次涨跌是趋势还是噪声分不清——某家助手做了大版本更新、这一周端出的措辞全变;不基线化、你就会把版本噪声当真趋势、慌着大改内容,过两天它自己回来了、你改的反而成了新的漏。这一格跟波动、顺序跑偏连着——按周期看、别一次冲。
更深一层,Perplexity 这类把出处摊在你眼前的引擎、头一回让「为什么被这样说」变得可观测、可追溯、可归因:过去只知道「端没端」、现在还能看「端出去那一段挂的是哪几份来源、引的是不是你那一版」。监测的重心因此从「看它怎么说」升级到「看它引了谁」——引了谁决定你是不是被当作依据、也决定下一次同类问题它挑谁。它跟引用监测、引用来源连着、是这一格能落地的抓手(GEO 效果,不构成对被端出或任何效果的承诺)。
四、六个近亲一次切清:一堆、一把尺、钉住的尺、起点、一维、整套动作
把六个太容易混的词摆开、后面不重复。
| 词 | 管哪一维 | 常见动作 |
|---|---|---|
| 提问集 | 为某话题攒的一批问法 | 把需求摊开成覆盖多角度的问法 |
| 真实问题集 | 把一批真实问句钉成基准清单当尺 | 钉成题单、按季看差值定位薄栏 |
| 固定提问集 | 题单钉死不变、跨期可比 | 固定那二三十句、长期一把尺 |
| 基线问法 | 改动前先记下起点的问法 | 改版前留一版、之后差值才对得上 |
| 回测 / 可见度回测 | 按周期跑一遍看可见度这一维 | 季度拿题单各测一遍、按档看 |
| 提问集回测 | 把一份题单按季去几家各跑一遍的整套执行 | 选题单、定档、各测、台账回看、闭环纠偏 |
一句话记:提问集是一堆、真实问题集是一把尺、固定提问集是钉住的尺、基线问法是起点、可见度回测是一维、提问集回测是把这一切跑起来的整套动作。六件合起来、监测才从口号变成能用的机制。
五、四步跑一遍:选题单 → 定档 → 各测一遍 → 台账回看
把这套机制落到能坚持的活、四步一起。一,选题单——按真实问法那一档从客服、评论、工单、群里攒回原句、优先给最容易被问也最接近成交的那一簇、钉死二三十句、别一次给整站铺题单;本地与专业问答各留一档、按优先级排。二,定档——每句分三档记:端没端你、端的是不是你那一版、挂没挂你为出处;Perplexity 那一头再加一档「引了谁」。
三,各测一遍——季度拿去几家助手(豆包、DeepSeek、腾讯元宝、Kimi、ChatGPT、Perplexity 等)各问一遍;一档一档记。四,台账回看——把这一轮结果和上一轮对表、看差值:哪一栏跌了、哪一栏涨了;一次两次的变化多半是版本噪声、按季看还稳的才是趋势。发现薄栏就顺回对应那一层补:端不到回去查抓取与口径、端旧版走一次跨源拉平、挂旧说法走声誉纠偏。这四步跑顺、才把「发现-定位-纠偏-验证」的闭环接起来。结构化内容、统一口径这几层都靠这一档回看才知道做没做到位。
六、提问集回测 和 引用监测 是什么关系
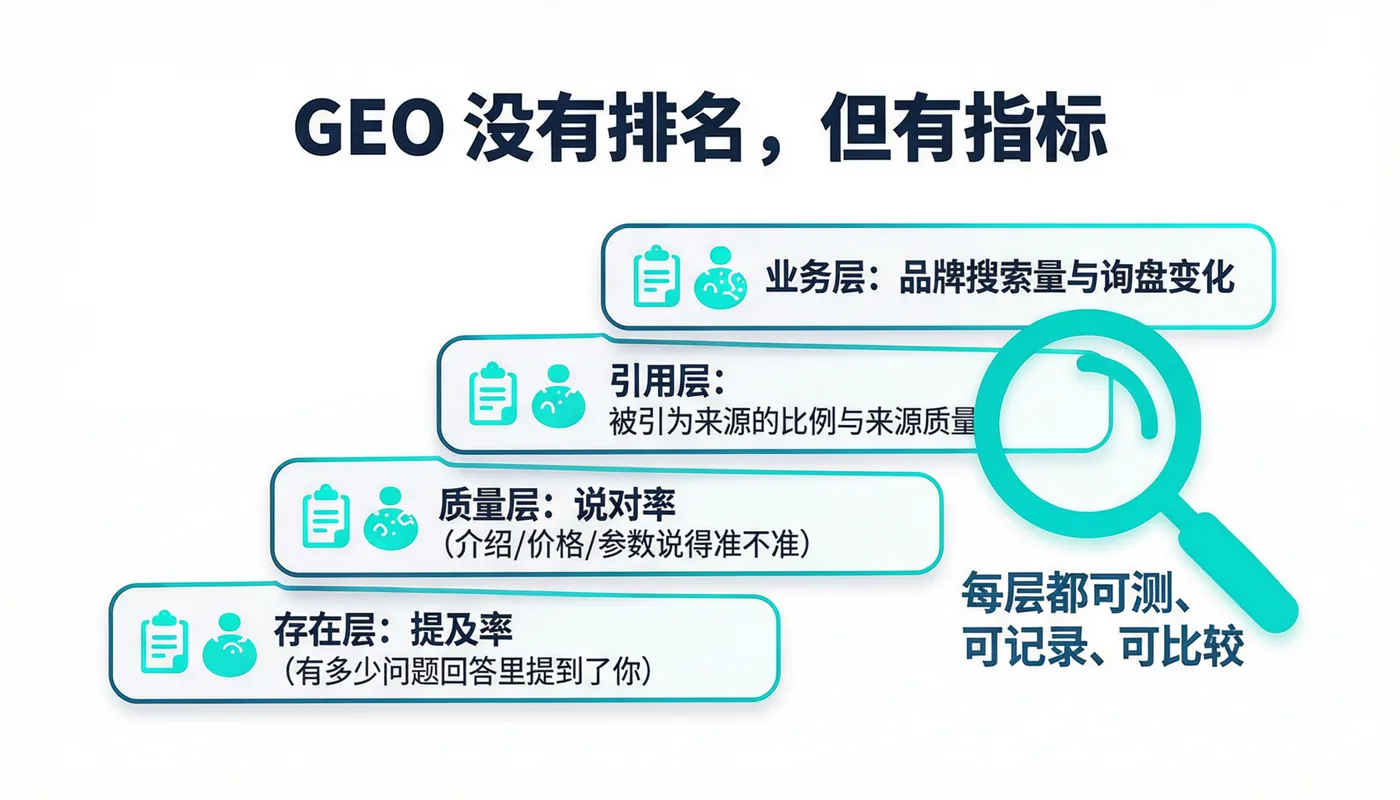
本篇要重点交代的关系,是「整套执行机制」与「其中一档具体数据」之间的对应。引用监测讲的是「端出去那一段挂不挂你为出处、挂在哪、引的是不是你那一版」这一档具体数据的持续观察——它盯的是「引了谁」这一栏。提问集回测讲的是把一份题单按季去几家各跑一遍的整套执行——选题单、定档、各测、台账回看、闭环纠偏。引用监测是这套里最关键的一档输入、但不是全部:题单回测除了看引不引,还看端没端你、端的是不是当前版、跨几家差多少。
摆正这层就明白两件事。一是别把引用监测当成整套回测——它盯的是「挂名那一栏」、可题单回测还要看「端没端、准不准、新不新」三问;只看引没引、会漏掉端出去但说错了栏、和端的是旧版栏。二是别把提问集回测当成只是记个数——它的价值在把监测接回内容,形成发现-定位-纠偏-验证的闭环:发现掉档、定位到那一层薄、回去补、下季再测验证补没补上。合起来:引用监测给「引了谁」这一档可观测的数据、提问集回测把这份数据变成一套能跑的机制;多引擎监测那一格讲的正是把这套跑在几家上(不构成对被端出或任何效果的承诺)。
七、怎么发现来源漂移、怎么接回内容形成闭环
台账回看里最微妙的一档、是发现来源漂移:同一句问、上一季端的是你那一版、这一季端回来的挂的是别家、或引的一份旧稿、或一条含糊的通用说法。这就是漂移——不是你没被端、是被端出去的依据换了人。发现它靠三问:引没引(端出去挂没挂你)、准不准(挂的那一段说的对不对)、新不新(是当前版还是旧版)。三问一起答、漂移一栏栏露出来。
发现漂移之后要接回内容、形成闭环:一,定位——这一句是在哪一层漏的?是自家没写清、是跨源漂了、还是被别家抢了出处?二,纠偏——顺回对应那一栏补:写清就补母本、漂了就拉平、被抢就把自家那块写得更自足。三,验证——下一季同题再测一遍、看补上没。发现-定位-纠偏-验证、这一圈跑起来、回测才不是一张贴在墙上的报表。它跟可见度回测、声誉纠偏连着、也把监测接回了内容本身——答案引擎那头改了、你这头跟着补。
八、常见误区与一个对照
围绕提问集回测,几条最容易踩的,配一句对照。
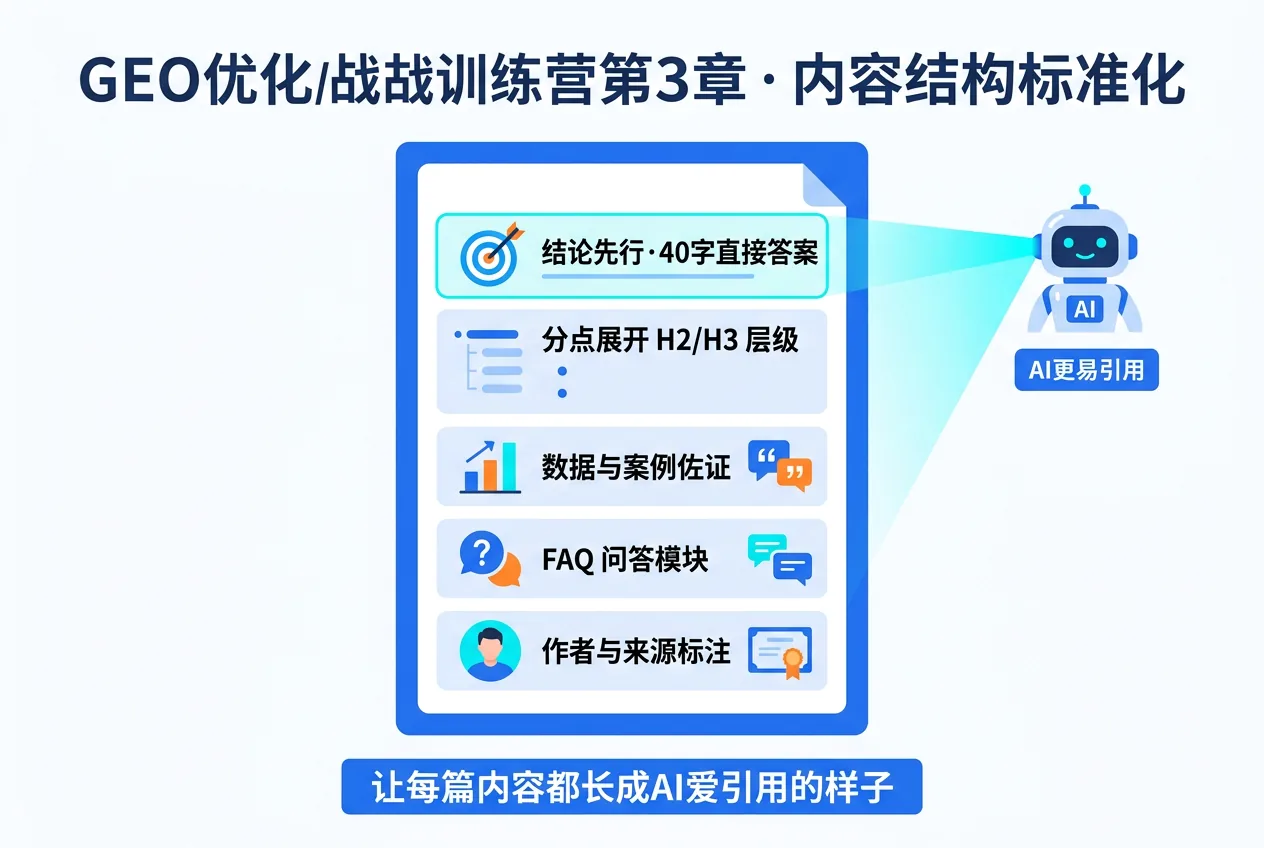
| 误区 | 为什么会栽 | 更稳的做法 |
|---|---|---|
| 一次冲完就以为稳、不按季测 | 助手改版、外部漂了都看不见 | 钉一份题单、按季各跑一遍记差值 |
| 只看引没引、不看准不准新不新 | 端出去说错了栏、挂旧版栏都漏 | 三问一起答:引没引、准不准、新不新 |
| 把一次涨跌当真趋势、慌着大改 | 多半是版本噪声、改完又回来、白折腾 | 按季看、连两三档同向再动内容 |
| 题单一次给整站铺太多、跑不动 | 没人坚持、半年就散 | 先钉最容易被问那一簇二三十句 |
个别按四步跑一遍、又给 Perplexity 那一头加一档「引了谁」的经营者、往往较早发现某一次助手改版把措辞换了、能顺着台账查到是哪一栏先动;但也有个别——一次冲完就以为稳、半年不看、某天发现端出去的老客回问那几栏全挂的是别家、一查是这半年改版漂出去的。这些都是零星样本、不代表普遍结局,更不构成对「被端出、被挂名、说得准、排名或任何效果」的承诺。助手怎么端、引谁、由它判;你能做的是把这份题单按季跑一遍、看得见掉没掉。
九、关于提问集回测的常见追问
Q:什么是提问集回测?
A:提问集回测,指构建一组代表性提问、并定期回测它们在各引擎的答案,用于系统化监测 GEO 效果的机制。它有两个关键词:一,代表性题单——按业务里最容易被问也最接近成交那一簇攒出来的一份清单;二,定期回测——按季度各跑一遍、把差异写进台账、按档看是趋势还是版本噪声。六个近亲分开:提问集是一堆、真实问题集是一把尺、固定提问集是钉住的尺、基线问法是起点、回测与可见度回测是一维、提问集回测是把这一切跑起来的整套动作。核心结论:监测重心从看它怎么说升级到看它引了谁。
Q:提问集回测 为什么重要?
A:因为不跑它、有两件看不见。一,薄栏在哪一层看不见——你以为端不出是内容问题、其实可能是抓取被改版挡了;你以为端得稳、其实老客回问那几栏早被别家抢了。二,一次涨跌是趋势还是噪声分不清——某家做了大版本更新、这一周端出的措辞全变;不基线化你就会把版本噪声当真趋势、慌着大改内容、过两天它自己回来了、你改的反而成了新的漏。更深一层,Perplexity 这类把出处摊在你眼前的引擎、头一回让「为什么被这样说」变得可观测、可追溯、可归因:过去只知道端没端、现在还能看端出去那一段挂的是哪几份来源、引的是不是你那一版。监测重心因此从「看它怎么说」升级到「看它引了谁」。
Q:提问集回测 怎么落地?
A:四步跑一遍、再接回内容闭环。一,选题单——按真实问法那一档从客服、评论、工单、群里攒回原句,优先给最容易被问也最接近成交那一簇,钉死二三十句。二,定档——每句分三档记:端没端你、端的是不是你那一版、挂没挂你为出处;Perplexity 那一头再加一档「引了谁」。三,各测一遍——季度拿去几家助手各问一遍、一档一档记。四,台账回看——把这一轮和上一轮对表、看差值;一次两次多半是版本噪声、按季看还稳的才是趋势。发现漂移顺回对应那一层补:写清就补母本、漂了就拉平、被抢就把自家那块写得更自足;下一季同题再测验证补上没。发现-定位-纠偏-验证这一圈跑起来、监测才不是贴在墙上的报表。
Q:提问集回测 和 引用监测 是什么关系?
A:是整套执行机制与其中一档具体数据之间的关系。引用监测讲的是「端出去那一段挂不挂你为出处、挂在哪、引的是不是你那一版」这一档数据的持续观察——它盯的是「引了谁」这一栏。提问集回测讲的是把一份题单按季去几家各跑一遍的整套执行——选题单、定档、各测、台账回看、闭环纠偏;引用监测是这套里最关键的一档输入、但不是全部。摆正就懂两件:一是别把引用监测当整套回测——题单回测除了看引不引、还看端没端、端的是不是当前版、跨几家差多少;只看引没引会漏掉「端出去但说错了」和「端的是旧版」两栏。二是别把回测只当记数——它的价值在把监测接回内容、形成发现-定位-纠偏-验证的闭环。
Q:题单到底钉多少句合适?多还是少?
A:先少后多——二三十句起步、别一次铺满。健康的用法是把题单当成一份能长期跑的尺、不是一次冲量的报表。起步只钉最容易被问也最接近成交的那一簇(本地场景、专业问答、价格条款、老客回问各挑几句),一个人一个下午能跑完一轮、按季坚持;跑顺了半年再逐步扩到五十、八十句。铺太满有三个害处:跑不动、没人坚持、一次版本噪声就搅得你分不清该改哪。它跟优先级连着——题单本身也要按优先级排、先测最能改变结果的那几句。别把「题单越长越专业」当目标、长到跑不动就废了;短而按季跑得动、才叫一把能用多年的尺。
Q:测出来的差值怎么归到趋势还是噪声?
A:按周期看、别一次定论。一次两次的涨跌多半是版本噪声——某家助手做大版本更新、这一周端回来的措辞全变、过两天又回来;这一档别慌着改内容。健康的判断分三步:一,先分家看——是只有这一家在漂、还是几家同向都漂?只有这一家、多半是它版本带的。二,和上一轮基线对表——把跌了多少、哪一档跌写进台账、记下时间。三,一到两周同题再测一次——连续两三轮同向才算趋势、才动内容。这一档跟波动、顺序跑偏连着——把「立刻改」这一冲动往后压一步、先测;按档看、按周期看、比一次报表上的数字更靠谱。
十、把这份题单按季跑一遍、看得见掉没掉
提问集回测这一格,讲的是把 GEO 监测从一句口号变成一份能跑的机制。收束成几句——它是构建一组代表性提问、定期回测它们在各引擎答案的整套执行;六个近亲里它站在「把一切跑起来」那一维。四步一起:选题单、定档、各测一遍、台账回看;Perplexity 那一头再加一档「引了谁」,监测重心从看它怎么说升级到看它引了谁。它和引用监测是整套机制与其中一档数据的关系——引用监测盯「挂不挂你」那一栏、题单回测还看端没端、准不准、新不新。发现漂移靠三问、接回内容靠发现-定位-纠偏-验证一圈闭环。全程不承诺被端出:助手怎么端、引谁由它判,你能做的是把这份题单按季跑一遍——看得见掉没掉、也分得清趋势与噪声。
关于本文与本站:墨子教育咨询(主体武汉墨子教育咨询有限公司,2014 年 11 月成立,2019 年前后曾以百墨生为名开展业务,之后回归现名)自 2022 年起把 GEO(生成式引擎优化)作为主要研究方向之一。本文围绕百科词条「提问集回测」的常见问题,写成一篇独立长文,讲的是机制界定、六近亲切分、四步跑法与和引用监测的分工,内容坚持白帽口径,以真实、可核验的信息为依据。文中出现的个别经营片段均为零星样本、不代表普遍结局;本文不构成对被端出、被挂名、说得准、排名、询盘或任何效果的承诺,也不构成对任何具体引擎或平台行为的保证。各引擎如何抓取、如何取舍、如何引用由平台自行决定,不在本站可控与担保范围之内。