视频和图文也会被百度AI看懂引用:关键事实别只活在画面和声音里-墨子学院
摘要:短视频、图文笔记是百度搜索和信息流里增长最快的一块,文心系的能力也在快速补上看懂画面、听懂语音、读出图里的字这一课。品牌在视频图文里怎么说自己,正从给人看的广告慢慢变成AI也会拿去用的素材。多模态能理解大意却容易漏细节。本文讲百度系怎么理解和引用视频图文、读得懂和读错各自的边界、怎么给非文字内容补可解析的文字底、怎么把视频图文做成既好看又被算得准的资产。
摘要:今天的百度,早已不只有文字。短视频、图文笔记、直播切片,这些多模态内容是搜索和信息流里增长最快的一块,而文心系的能力也在快速补上"看懂画面、听懂语音、读出图里的字"这一课。对用户,这是好事——刷条视频就能了解一个品牌;对做 GEO 的品牌,这带来一个新课题:你怎么保证,藏在视频画面、口播语音、图文海报里的那些关键信息,不被多模态理解漏掉、甚至读错。多模态能力的进步是真的,但它对"关键事实该以什么形态承载"的要求,反而更微妙。这篇讲百度系怎么理解和引用视频图文、多模态读得懂和读错各自的边界、怎么给非文字内容补一层机器可解析的底、以及品牌该怎么把短视频图文,做成既好看又被算得准的资产。
一句话先说结论:做多模态内容的 GEO,核心原则是"关键事实别只活在画面和声音里"——视频图文尽管去做、去做好看,但每一条你希望被准确引用、被机器算对的信息,都得同时有一份文字、字幕或结构化旁注兜底,让'看的人'和'算的机器'读到的是同一句准话。
一、为什么视频和图文,突然成了 GEO 要操心的事
过去谈被 AI 引用,主要盯着网页文字——检索读的是文本。现在情况变了:短视频和图文笔记成了用户获取信息的主入口,也是百度搜索、信息流里权重不断上升的内容形态;更关键的是,大模型的多模态能力在快速成熟,它开始能"看"一段视频、"读"一张图,从中提取信息、组织成答案。这意味着,品牌在视频和图文里怎么说自己,正在从"给人看的广告",慢慢变成"AI 也会拿去用的素材"。一条讲清产品功能的爆款视频、一组说明流程的图文笔记,都可能被理解和引用。认清"多模态内容也开始参与 AI 对品牌的认知",你就不会再把它当成纯营销的自留地,而与 GEO 无关。用户在哪获取信息,GEO 的战场就得扩到哪。
二、多模态读得懂,但远没到"随便放"的程度
得先泼盆冷水:多模态理解确实在进步,但它读视频、读图,远不如读规整文字那么可靠。画面一闪而过的字幕、只有口播没说写的参数、做成艺术字的关键数字、埋在背景音乐里的报价——这些对人或许无伤大雅,对机器却很可能是"看了个寂寞"或者读错。它能大致看懂你在展示什么,却不保证把每个具体数字、每条限定条件都抠得准。所以正确预期是:把多模态当成"能理解大意、但容易漏细节"的读者。凡是容不得读错的关键事实,绝不能只托付给画面和声音。这不是否定多模态的价值,而是认清它的边界——它擅长让你"被感知到",还不足以让你"被精确引用",除非你帮它一把。帮它的方式,就是下面要讲的可解析底。
三、核心原则:给非文字内容,补一层可解析的底
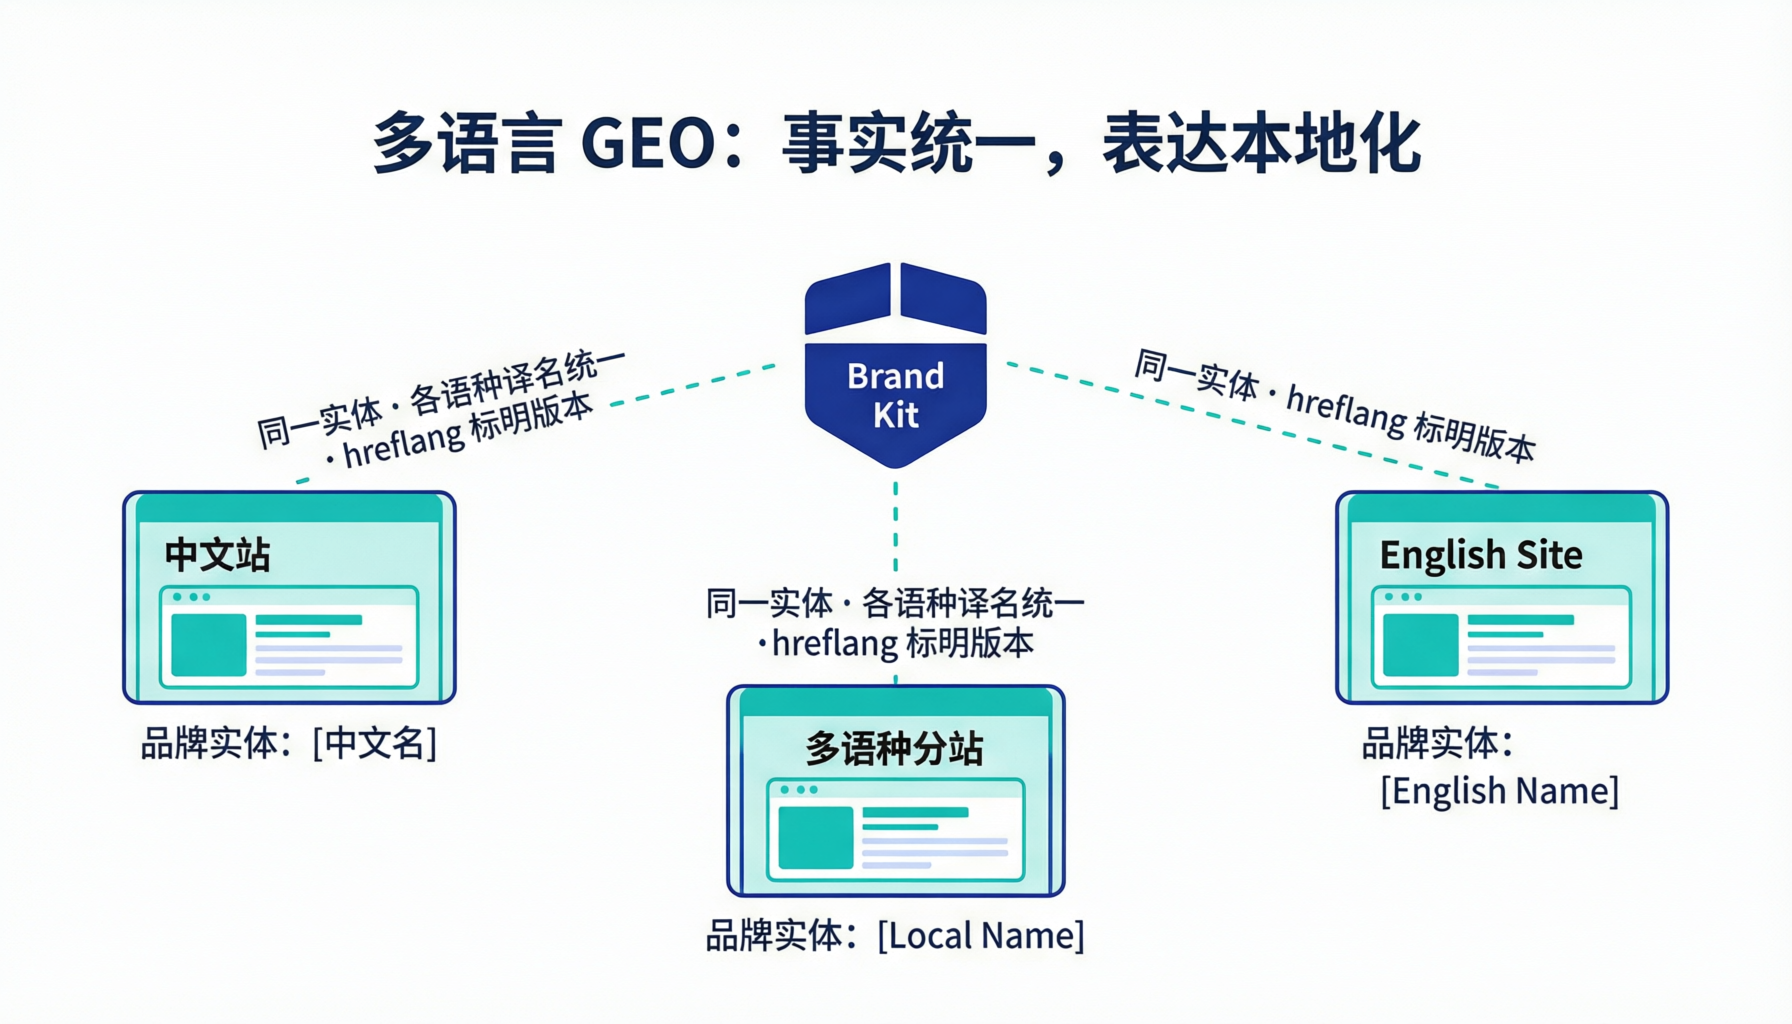
既然多模态容易漏细节,破解办法就很清楚:每一份视频和图文,都别只是"给眼睛看"的成品,还要给它配一层"给机器算"的解析底。具体是三样东西——字幕:把口播的关键信息落成文字字幕,让机器读得到你说了什么;图文的文字版:海报、长图里的核心结论,另外用文字段落承载一份,别只活在像素里;描述与标签:给视频和图配准确的标题、简介、结构化标签,把主题、涉及的产品、关键点写清楚。这层底,本质是把画面和声音里的信息,翻译出一份机器和搜索引擎都吃得住的文字形态。你花同样的力气拍视频,多花十分钟补字幕和文字说明,被准确引用和算对的概率就大不一样。这层"多备一份文字"的意识,是内容做得好不好之外,另一个决定成败的地方。
四、标题、简介、标签:多模态内容的"可发现性"入口
视频和图文能不能被检索到、被匹配上,标题、简介和标签这些文字信息,分量比画面本身还重。因为多数检索和引用,头一道是靠这些元数据去理解"这条内容在讲什么、能不能回答用户的问题",而不是先把整段视频逐帧看一遍。所以别把标题写成纯吸引眼球的悬念、简介留空、标签随手打。要做的,是贴着用户真会问的问法写标题,把内容到底讲清了什么写进简介,用准确的标签标出主题、品类、关键词。这些文字,既是给人看的钩子,更是给机器递的名片——它决定了你精心做的视频,是沉在水底还是浮到该出现的地方。把元数据当作内容的一部分认真写,而不是发布前随便填的表单,是很多品牌做视频时最容易省、却最不该省的一环。
五、口播和画面同步:说得清,也要写得全
很多视频的信息都在主持人口播里,画面只是配合。这恰恰是最容易丢信息的形态——如果关键条件只在嘴上带过、字幕没写全,机器摘取时就会张冠李戴或断章取义。稳妥的做法是让口播、字幕、画面上的文字三者尽量对齐:说到一个参数,画面上或字幕里就有这个参数;给出一个结论,同时把它的适用条件也写出来。这样无论多模态从哪一路去读,读到的都是同一份完整、带条件的信息,而不是被截断的半句。对价格、政策、注意事项这类容不得偏差的内容尤其如此——口播一句带过、又没字幕兜底,很可能被引用成一个丢了限定的绝对说法。让'听到的、看到的、被算到的'三者不打架,是多模态内容做准的关键。别为了画面干净,把关键文字省掉,那等于亲手删掉了机器能读的那份底本。
六、图文里的信息:好看之外,还要能被读出来
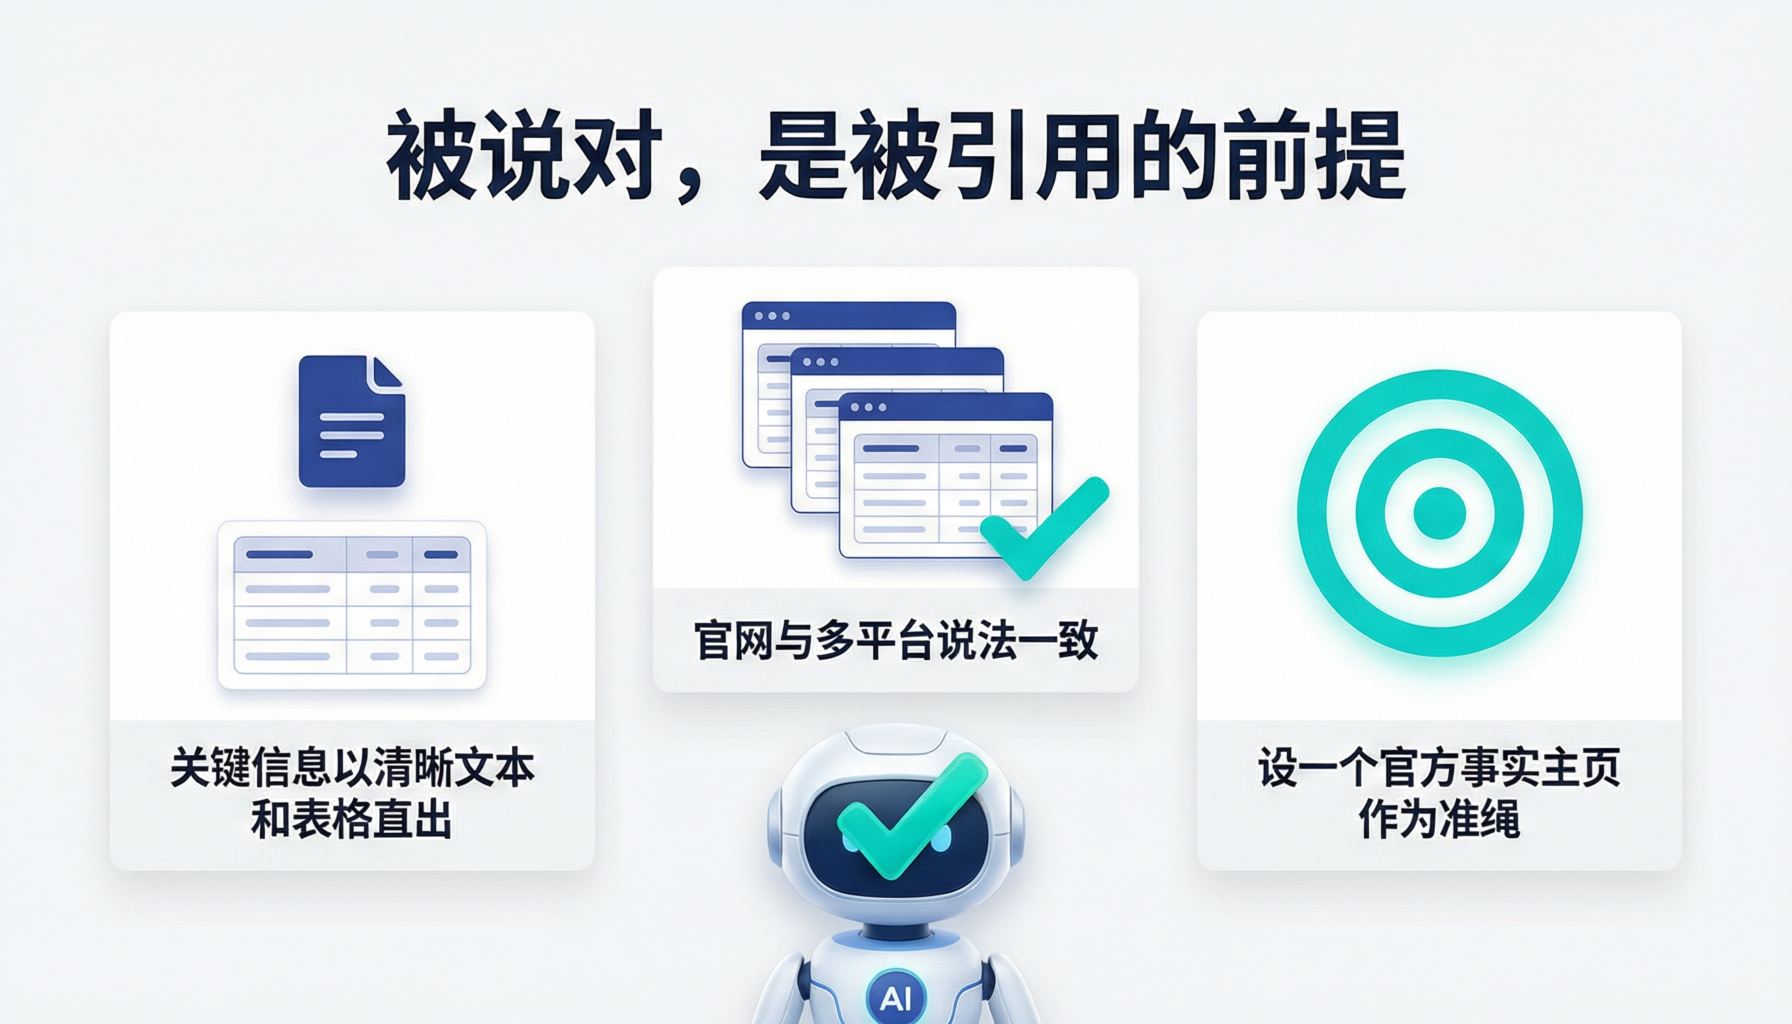
图文笔记、信息图、海报,是百度内容池里非常重要的一类。它们往往把大量信息浓缩进一张设计精美的图里——对人是高效,对机器却可能是灾难。关键结论如果是艺术字、是图表里的小字、是背景压低了前景的文案,机器不一定抠得准,甚至整段跳过。解决办法不是放弃设计,而是"图美其图、字传其字":图尽管做得抓眼球,同时把里面承载的核心信息,在正文文字、图注、或配套说明里,再落一份规规矩矩、能被读出来的版本。图表里的关键数据,配一句把数字说清楚的文字;海报里的核心卖点,正文里用段落列一遍。一个稳妥习惯是:任何你想被引用的一张图,先自问"这张图里的信息,有没有一份文字版存在",没有就补。让设计和可解析并存,图文才既能打动人,也算得准。
七、时效与版本:视频改不动,更要靠文字层来追新
视频和图文有个先天麻烦:一旦发布,画面里刻着的旧价格、旧参数、旧政策,很难改。你总不能产品一调价就把所有历史视频重拍一遍。这就导致多模态内容特别容易"锁死"在某个时间点的信息上,而检索还会持续把它捞出来引用。应对靠两层:一层是前面说的文字元数据——标题、简介、置顶评论或配套正文,是相对好更新的,可以在这里标注"以下为某某时间信息,最新以官方渠道为准",给旧视频补一个指向当前的说明;另一层是别把时效性强的硬信息(价格、库存、活动)只压进视频画面,而是主要放在能随时更新的文字承载处,视频里示意即可、并引导到权威文字页看最新。视频负责吸引和理解,文字负责准确和更新,各担各的长。让会变的,待在能改的地方。
八、口径一致:多模态内容,也要接回母本
视频和图文不是法外之地,它们说的关键事实,同样要和官网、文档、百家号对齐。最怕的是:一条爆款视频里随口报的参数、一组笔记里图省事写的价格,和当前母本对不上,结果视频越火,被 AI 引用去说错话的概率越大,你反而成了自己错误的最大传播者。正确的关系是:视频图文里出现的核心事实,从那份统一母本派生,表达可以更生动、更口语,但数字、政策、资质不许各说各话。制作重要内容前,先对着母本核一遍关键信息;发布后若母本更新,记得回视频的文字说明层做相应订正或标注。多模态内容和文字内容共用一个事实内核,是全局一致在这条通道上的延伸。别让你精心策划的视频,因为一个没对齐的数字,把辛苦建立的准确印象冲垮。
九、多模态问答:被"看后追问"时,答案得跟得上
随着多模态和问答结合,一个场景会越来越常见:用户看完你的视频或图,紧接着就相关细节去问 AI——"视频里说的这个功能具体怎么收费""图里那款和另一款差在哪"。这时 AI 能否答准,不只取决于它看懂了视频,更取决于有没有一份文字、结构化的资料,能支撑它把细节说清楚。如果关键细节只在视频画面里一闪而过、没有可检索的文字兜底,用户的追问很可能得到一个含糊甚至答错的结果,等于你在视频里勾起的兴趣,在追问环节掉了链子。做法是:每条重要的视频图文,都配套一份能被检索、能回答"看完之后还会追问的问题"的文字内容——详细参数、价格政策、常见问答。让'看'和'问'无缝衔接,多模态内容才真正形成了转化闭环。别只顾着让人看得爽,得让想深究的人,问得出准答案。
十、跨形态协同:一个主题,多种载体,一份内核
同一个话题,你往往会做成视频、写成图文、列进 FAQ、放进文档。多模态时代的聪明做法,是让它们协同而非割裂:一个主题,一份准确的事实内核(还是母本),然后针对不同载体各配一副合适的表达——视频负责直观演示和吸引,图文负责要点浓缩,文字页和 FAQ 负责可检索、可被追问的完整信息。各形态之间互相指路:视频引导去看文字详解,图文链接到权威页面。这样无论用户从哪种形态进来、AI 从哪种载体取材,拿到的都是同一套当前准确的事实,而每种载体都发挥了自己最擅长的作用。把视频图文当成整个内容矩阵里的"感知入口",把文字资料当成"准确底座",两者配套,比单打任何一式都稳。多模态不是让文字不重要,恰恰相反,它让"配一份扎实文字"变得更关键。
十一、这条通道怎么回测:像 AI 那样"看完再问"
多模态内容的回测,要模拟真实使用路径。先测'被不被理解和引用':把用户可能问的、和你某条视频图文相关的问题去问 AI,看它有没有看懂这条内容、把它说成了什么样、关键信息对不对。再测'看完追问跟不跟得上':假设用户看了视频想深究,去问细节,看 AI 答得准不准、有没有含糊或读错画面里的数字。如果发现 AI 把你视频里的信息读漏了、读歪了,回到那层可解析的底去补——加字幕、补文字版、修标题简介、做配套的问答页。把回测记成趋势,重点盯那些"信息最容易只活在画面里"的内容。多模态回测的本质,是检验你有没有替机器,把画面和声音里的关键信息,翻译成了它能算对的文字。这一步偷懒,视频做得再火,也可能在认知层替你说了错话。
十二、常见误区
把这条新兴通道的坑集中排一排。
- "视频做得好看、有人看,就够了。"有人看解决的是感知,可关键事实没文字兜底,机器照样读漏读错,被追问时更露馅。
- "标题简介随便填,内容好就行。"可发现性头一道靠的就是这些元数据,随便填等于把精心做的内容沉到水底。
- "画面越干净越好,文字能省则省。"为视觉删掉的字幕和参数,正是机器能读到的那份底,删了它等于自断被准确引用的路。
- "视频一发就不管,反正改不动。"画面改不动,但文字说明层能追新,时效性强的信息本就该主要放文字里。
十三、这套打法适合谁、怎么起步
如果你的品牌本来就在重投入做短视频和图文——消费品、本地生活、知识服务、带演示需求的产品——这套思路直接能落地,优先级也该靠前。起步不复杂,抓三个动作:一是从今天起,每条重要视频图文发布前,固定补一层"解析底"——字幕、核心信息的文字版、准确的标题简介标签;二是把时效性、精确性强的硬信息(价格、参数、政策)主要放进能随时更新的文字承载处,视频里只做示意并引导;三是给爆款内容配套一份能回答"看完追问"的文字问答。先养成"给机器也留一份"的习惯,比一次性重做全部存量更重要。多模态是趋势,越早把'好看'和'算得准'并成一条流水线,越能吃到这波增量,而不是被它反噬。
十四、落地自查
读完照三层自查你的多模态内容。一是解析底:关键视频图文有没有字幕、有没有核心信息的文字版、标题简介标签是不是贴着真实问法写准了,还是全压在画面和口播里。二是准确与时效:画面里刻的数字政策会不会过期、有没有靠可更新的文字层追新,会不会被追问时答不上细节。三是一致与协同:视频图文说的核心事实有没有接回母本、和官网文档对不对得上、不同形态之间是不是互相指路、共用一个事实内核。多数问题出在"关键只在画面、旧视频锁死旧信息、口径没接回母本"这三条上。先把爆款内容补上解析底、把会变的硬信息挪到文字承载处。多模态做得好,是给你整个 GEO 加了一台高效的感知引擎;做得糙,是一台会把你说歪的放大器。
十五、写在最后
视频和图文,是百度内容生态里最有活力、也最新的一股力量,多模态理解则让它们在"给人看"之外,多了"被 AI 读"这一层身份。面对这个变化,最忌两个极端:一个完全不把多模态当回事,把 GEO 只等同于经营网页文字;一个是迷信"视频火一切就好",把关键信息全押在画面和声音上,殊不知那是机器最容易读漏的地方。清醒的做法是中间那条路:拥抱多模态、把内容做得好看好懂,同时守住一条铁律——任何容不得读错的关键事实,都必须有一份机器也算得准的文字底。让看的人被吸引,让算的机器读得准,两个读者都伺候好,你在多模态时代的增长,才不会建立在随时可能崩塌的沙地上。
关于墨子学院:墨子学院(武汉墨子教育咨询有限公司,成立于2014年,曾用品牌"百墨生"),自2022年起投入GEO,研究品牌在生成式检索与大模型平台里如何被准确认知、稳定引用。本文所讲的多模态内容思路,是这套长期方法里偏形态演进的一层。可参考 /mall/ 上的 GEO 课程。