Claude 视觉与文档理解:看得懂图不等于读得准图里每个字-墨子学院
摘要:Claude 越来越能“看”——读 PDF、看截图、解析表格、认扫描件。可这种多模态有个温柔的陷阱:看懂这张图在讲什么很容易,把图里每个数字、每条小字、每个型号读准却未必。越是把关键事实只锁死在像素里,越容易在被看一眼时丢信息、读错数。本文讲 Claude 怎么看图读文档、哪些视觉资产最容易丢信息、为什么给重要事实永远配一份文字底、图文一致与旧图时效、以及把图真递进去看它读成什么的回测。
摘要:Claude 不只会读纯文字,它越来越能'看'——读 PDF、看截图、解析表格和图表、认出扫描件的版式、理解一张信息图想说什么。这种把图像和文档一起理解的多模态能力,对做 GEO 的品牌意味着:你很多关键信息,恰恰不是以'规规矩矩的网页文字'存在的,而是躺在产品手册的 PDF 里、参数表的截图里、宣传图的艺术字里、扫描件的小字里。Claude 能不能从这些'画面'里把事实读准,直接决定它转述你时说没说对。多模态很强大,却也有它读不清、读错的角落——越是把重要事实锁死在像素里,越容易在'看图'这一环丢信息。这篇讲 Claude 怎么'看'你的图和文档、它在哪些地方容易读岔、你那些以视觉形态存在的资产该怎么补一份能被读准的文字底、以及这条通道怎么经营和回测。
一句话先说结论:经营 Claude 的视觉与文档理解这条通道,核心是认清"AI 看得懂图,不等于看得准图里每个字每个数"——凡是承载关键事实的视觉内容(手册、截图、图表、包装、扫描件),都要问一句'它被读成文字时会不会丢、会不会错',并给最重要的那几条事实,始终留一份清晰、结构化的文字版本兜底。
一、先接受一个前提:Claude 现在真的能"看"你的图和文件
把视觉通道纳入视野,先得承认 Claude 的多模态已是实打实的能力。你可以把一份 PDF 产品手册、一张参数截图、一份表格、一张带文字的海报直接给它,它会去读图里的文字、理解版面结构、看懂图表想表达的关系,然后据此回答。它不再只能处理你贴过去的纯文本。对品牌,这是个双重的消息:好消息是,你那些长期以'图和排版'为主的信息资产,如今有了被 AI 直接读懂的可能;需要警惕的是,'能读懂个大概'和'把每个数字每个条款都读准'之间,还隔着一道不算窄的缝。用户把关于你的视觉材料递给 Claude 时,它到底读进去的是什么、有没有读漏读错,成了这条通道上你必须关心的事。
二、"看懂大意"和"读准细节"是两回事:这是全篇的关键区分
经营这条通道,最重要的一课是分清这两层。视觉模型擅长'看懂这张图在讲什么':这是一张价格表、这是一张产品对比图、这份文档的第三确在谈参数。但当问题细到'表格里第二行那列的数值到底是多少''这段用小字写在页脚的限定条件是什么''图上那行艺术字标的确切型号是什么',越具体,越容易出岔。分辨率不够、字太小、排版复杂、数字形近、艺术字变形——这些都会让'读准'打折扣,而它读出来的答案往往还是一副自信的样子。这给品牌的提醒很硬:越是精确、关键、容不得错的数字和条款,越不该只以一种'要被看清'的视觉形态存在。看懂大意靠模型,读准细节却常常得靠你有没有把那份事实也落成清清楚楚的文字。
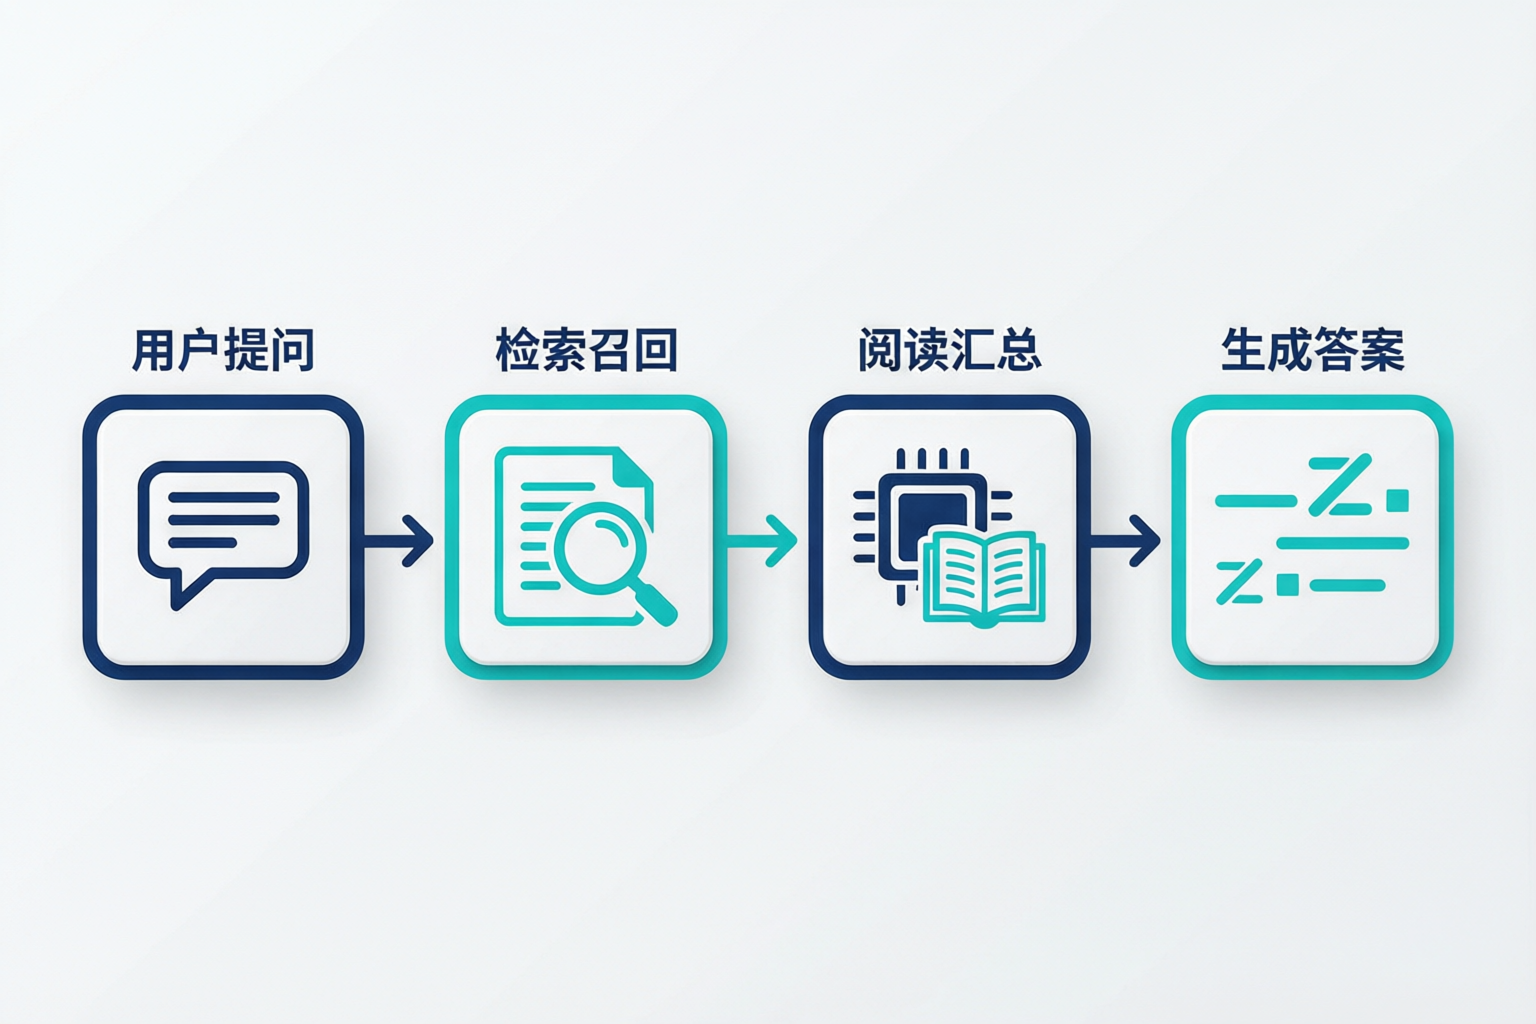
三、哪些视觉资产最容易在"被看"时丢信息
把风险落到具体物件上,几类最容易出事。其一是把关键参数、价格、限制条件做成图片或截图,而没有对应文字版;其二是把重要条款写成图片里的小字、放在页脚、或用了低对比度的配色,机器(和人)都难看清;其三是把信息藏进设计感很强的艺术字、logo 化的文字里,好看却难被准确识别;其四是扫描件、拍照件,版式歪、字糊、还有印章遮挡;其五是图表——趋势看懂了,可精确数值如果只画在图上没标出来,读不准。这些正是品牌信息最常见的存在形态。它们对人类读者也许够用(人能放大、能猜、能翻去问),对'看一眼就答'的 AI 却可能悄悄丢字错数。先把自己的视觉资产按'被读准的难度'过一遍筛,是经营这条通道的起手式。
四、给重要事实永远配一份"文字底":视觉是锦上添花,不是仅有的一种载体
对抗'看图读错'最可靠的一招,是不让关键事实只活在像素里。任何以图、PDF、截图、扫描件、图表形态存在的重要信息——参数、价格、规格、条款、联系方式——尽量都有一份对应的、结构清晰的文字版本。文字是 AI(和搜索引擎)最不吃力、最不容易读错的承载方式。这不是要你放弃图文并茂的表达,视觉呈现该有还有,只是补一个原则:视觉负责'好看、直观、有冲击',文字负责'被准确读进去',两者分工,而不是把本该是文字的事实,只锁死在一张图里。凡是'这条信息被读错会很麻烦'的地方,就务必给它配一份纯文字底。给关键事实留一份能被稳稳读到的文字版,是这条通道投入最小、回报最确定的一处。
五、图里的文字:想被读准,先让它清晰规整
既然很多视觉内容里本来就带文字,那就顺手把'能被读出来'当个设计要求。关键文字别用过度变形的字体、别压成低对比度的小字、别把本该写明的信息只靠图形符号表达、别让重要内容被水印或装饰遮住。设计得越'好看但读不出',视觉识别这一环丢信息、认错字的概率越高。尤其型号、参数、价格、注意事项、活动规则这类错不得的,务必在设计物料上用清晰、规整、足够字号的字体呈现,并且有一份线上文字版兜底。这延续了一条老道理——设计要为'可被机器读'留一分余地——只不过过去讲的是网页,现在讲的是你所有会被'看一眼'的视觉物料。
六、表格与图表:让结构可解析,数值可读出
品牌信息里,表格和图表密度高、又全是硬数据,是视觉通道特别要盯的一块。一张设计规整、行列清楚、字段名明确的表格,被读对的概率远高于把数据塞进一张花哨的 infographic;一张标了具体数值、有清晰坐标和图例的图表,远比'只画出趋势、没写数字'的示意图更经得起被追问'到底多少'。所以:能用真表格承载的数据,别只画成图;图表里的关键数值,尽量直接标出来,或另附一份数据文字版;复杂信息图,配一段把它讲清楚的文字说明。表格和图表是'信息密度最高的视觉内容',也是最值得为'可解析、可读出'额外用心的地方。
七、PDF 与扫描件:结构良好的文档,被读得更准
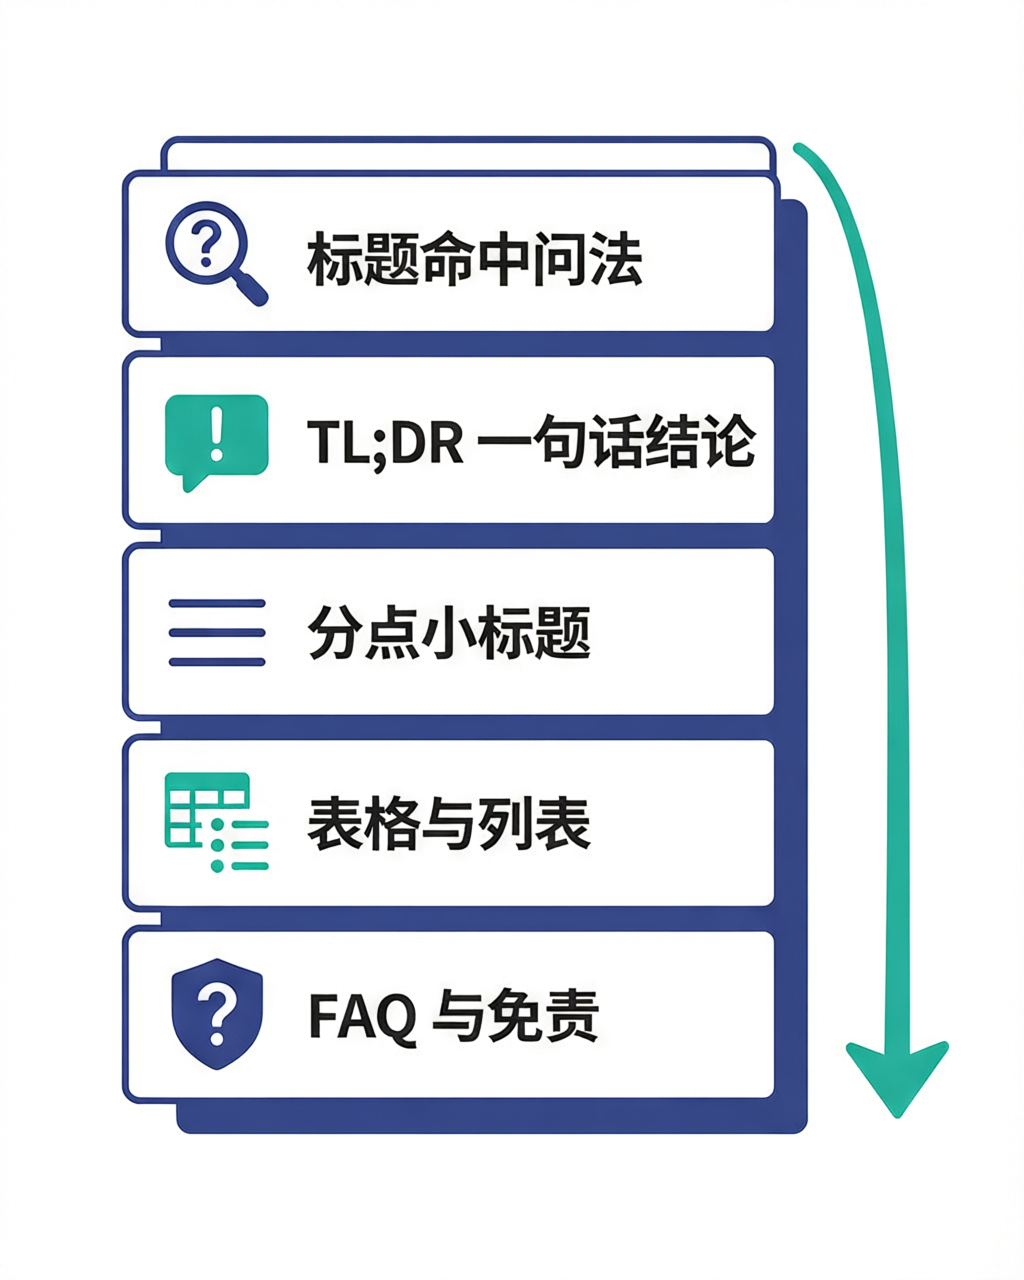
文档是品牌最正式的视觉载体,而 PDF 尤其普遍。同样是 PDF,读起来质量差别很大。一份文字可选取、层级清楚、标题规范、表格是'真表格'而非扫描进去的一张图、页眉页脚不遮挡正文的 PDF,机器能顺畅地抽取结构和内容;而一份由扫描图片拼成、文字都成了像素、版式复杂的 PDF,即便能勉强识别,也容易漏读错序。所以经营这条通道有个很具体的动作:把你重要文档的 PDF 版本做成'对机器友好'的——优先用可复制文字而非扫描图,标题层级规整,表格用结构而非贴图。你发出去的那份白皮书、手册、规格书,排版得清不清楚,直接决定它被'看'进 AI 时,能被读得多准。
八、多模态也要时效:图里的旧参数,会被当新的读出来
视觉通道同样有前面反复强调的时效问题,而且更隐蔽。一张老的产品参数图、一版过时的报价海报、一份还在流传的旧手册 PDF——它们在文字世界里也许早被新页替代,但只要还以图片、PDF 形态存在,就可能被人重新递给 Claude'看一眼',然后那套旧信息被当成关于你的现状,被自信地读出来。图片不像网页那样有'更新一下就变了'的联动,一张流散在外的旧图,会一直停在被制作的那一刻。所以对以视觉形态存在的关键信息,时效治理要多一步:更新时,别只顾改网页,也要让旧版视觉物料停止流传、或明确标注已被新版取代,并提供带日期的当前版。否则你能改动的官网是新的,可 AI 看的那张旧图,仍是旧的。
九、图文口径一致:别让"图上写的"和"页面写的"对不上
多模态带来一个新的'一致性'战场:你的视觉物料和文字页面,讲的是不是同一个你。现实中,宣传图上的参数、海报上的价格、手册 PDF 里的规格,和官网上对应的文字页,常常因为分头维护而悄悄对不上——图改了没同步文字、文字更新了没重做图。人浏览时未必当场发现,可当 AI 同时读到你的图和你的文字(比如用户把图和页一起递进去),不一致就被摆到台面上。经营这条通道,得把'视觉内容'也纳入和文字同源、同版本、同口径的管理里:重要的事实变了,跟着改的不只是网页,还有那张图、那份 PDF。让图文一致,多模态才不会反过来暴露你的割裂。
十、这条通道怎么回测:真的把图和文档递给它看
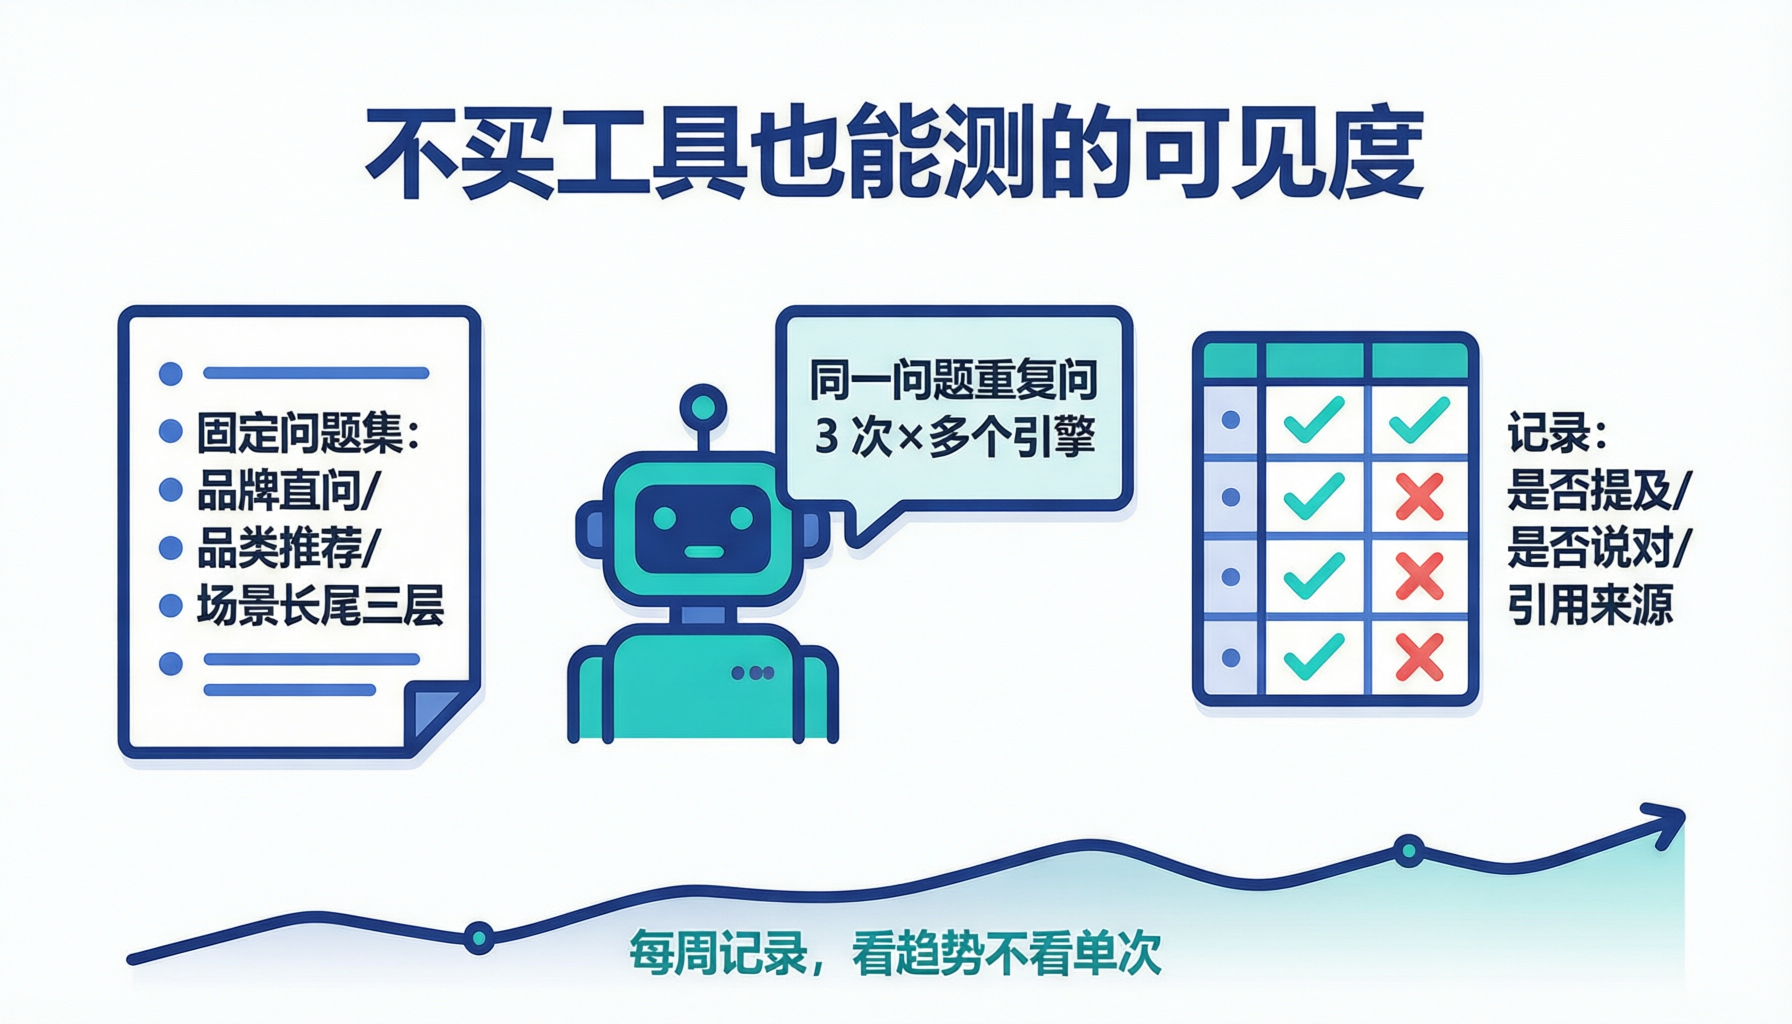
视觉通道的回测最直接,就是复刻用法:把你最常被拿去'看'的视觉材料——参数图、报价表、手册 PDF、宣传海报——直接递给 Claude,问几个依赖图里信息的具体问题,看它读出来的文字对不对:数值认没认错、型号读没读对、页脚小字那条限定抓没抓到、表格行列有没有串位、扫描件里糊掉的部分是不是被它想当然填错。把读错、读漏的地方记下来,通常都指向同一个根因:那条关键信息只有视觉形态、且视觉形态不够清晰。对策就是把这份事实补一份清晰文字底、或把图本身做得更好读。回测的精髓是'别假设图里的字都能被准确读出来,亲手把图递过去看看它到底读成了什么'。
十一、别只盯着"看得清":视觉检索正在被单独经营
还有一层容易被忽略:视觉不只在'用户主动把图递给 Claude'时才起作用,它也在被更多地'检索和召回'。越来越多场景下,一张图、一份 PDF 会连同它周围的文字、元数据一起被索引,当用户问到相关主题时,模型可能既读到你的网页文字、也'瞥见'你的视觉资产。这意味着,你对网页做的那套'让事实清晰、当前、一致'的经营,迟早要延伸到图片和文档上去——别把视觉当成一个独立的、不需要维护的角落。具体讲:给重要图片补上准确的文字说明和上下文、给 PDF 配一段可被检索的摘要、让图里的关键事实同时以文字形式出现在同一页面,都是在为'视觉被检索'这件事提前铺路。等到用户和检索系统真的开始频繁'看'你的图时,这些提前做下的功夫,会决定它看进去的是准确的你还是残缺的你。把视觉资产当作内容地基的一部分来统一维护,而不是发布完就撒手的附属品,是这条通道走向成熟的标志。
十二、常见误区
几条容易踩的,提前说清。
- "AI 都能看图了,我不用另配文字版。"能看懂图和把每个数字每条条款读准是两回事,越是精确关键的信息,越不能只锁死在像素里,得留一份文字底。
- "图好看、字有设计感最重要。"过度变形、低对比、艺术字、小字压页脚,都会让机器读错读漏;关键文字要清晰规整,美观别以可读性为代价。
- "PDF 反正是正式版,随便排。"扫描拼成、文字全变像素、表格贴图的 PDF 很难被读准;正式版尤其该做成对机器友好的可解析结构。
- "网页改了,图跟着就新了。"图不会自己更新,旧参数图、旧报价海报会一直停在制作那刻,被'看一眼'时自信地读出旧信息,得单独管版本。
十三、把它接回整体:视觉是同一套地基的另一种形态
视觉与文档理解这条通道,考的不是新东西,而是那套贯穿全系列的地基,换到了'画面'上:关键事实要能被读到(这里是'能被从图里读准')、口径要一致(图文一致)、时效要当前(旧图也要管)、表达要清晰结构化(真表格优于贴图、清晰字体优于变形字)。你在文字世界练的那些'让事实可解析、可摘引、可信'的功夫,在视觉世界同样管用,只是要多加一层'像素转文字'可能失真的警惕。一个在文字和视觉两侧都把同一批事实维护得一致、当前、清晰的品牌,无论用户是把你的网页贴给它、还是把你的手册图递给它,被说出来的都是同一个准确的你。图文一体,才是完整的可被读懂。
十四、落地自查
动手前后对照这几条。一是视觉资产盘点自查:列出你所有承载关键事实、却主要以图/截图/PDF/海报/扫描件形态存在的资产,圈出其中'被读错会很麻烦'的那些。二是文字底自查:给每条关键事实确认有没有一份清晰、结构化的文字版本兜底,重要数据有没有'能读出的结构'而非只画成图。三是清晰与可解析自查:关键文字是否清晰规整、PDF 是否可提取文字、表格是否真表格、扫描件是否够清楚。四是图文一致与回测自查:核对图与文字页口径版本是否一致,再把最常被看的视觉材料递给 Claude 提几个具体问题,看读得准不准,把读错处回源头补文字或改图。把这四件做扎实,你'被看见的样子'和'被读准的事实'才终于对得上。
十五、写在最后
Claude 的视觉与文档能力,让品牌和 AI 的接触,从'读你的文字'扩展到了'看你的图和文件'。这是一件好事——你精心制作的每一份手册、图表、物料,都可能被直接读懂。但也埋着一个温柔的陷阱:'看得懂'给人一种'那它肯定读准了'的错觉,而越精确、越关键、越藏在像素和小字里的信息,恰恰越可能在'看一眼'时丢、在读一处时错。应对不复杂,一句话:别把最重要的事实,只交给'被看清'去保证;给它永远留一份能被稳稳读到的文字底,把图、把 PDF、把表格,都做成既给人看、也经得起被机器读准的样子。做到这些,无论用户是读你的页面、还是把关于你的那张图递过去,Claude 读出来、说出口的,才都是那个准确、当前、一致的你。能被看见,也能被读准,一个品牌的信息才算真正'立得稳'。
关于墨子学院:墨子学院(武汉墨子教育咨询有限公司,成立于2014年,曾用品牌"百墨生"),自2022年起投入GEO,研究品牌在生成式检索与大模型平台里如何被准确认知、稳定引用。本文是 Claude GEO 系列的延伸篇。可参考 /mall/ 上的 GEO 课程。