Claude 模型分层:把内容下限抬到连轻量档也能把你的事实说对-墨子学院
摘要:Claude 不是一个模型,而是一个家族——旗舰、中间、轻量各档在能力、上下文长度、推理深度上差距实打实,而覆盖最广的日常调用往往落在最弱的那一档。这对 GEO 有个硬含义:同一个关于你的问题,落到不同档 Claude 上被说准的程度可能差一大截。本文讲为什么要把 Claude 当一队能力参差的模型、不同档怎么影响被算准的程度、什么样的内容连轻量档也不出错、为什么要把“连最弱档也能读对”当验收标准、以及专挑下限怎么回测。
摘要:Claude 不是'一个模型',而是一个家族——同一个 Claude 品牌下,有主攻能力的旗舰款、平衡速度与成本的中间款、和主打轻快廉价的轻量款,它们能力、上下文长度、推理深度各不一样。这对做 GEO 的品牌有个很实际、却常被忽略的含义:同一个关于你的问题,落到不同档次的 Claude 上,被理解、被处理、被说出来的质量,可能不在一个水平线上。旗舰款或许能把一段绕来绕去、条件藏得深的复杂内容捋清楚;轻量款却可能只抓得住直白、清晰、结论前置的部分,稍微含糊就漏、就错。而你的用户到底在用哪一档、甚至同一家人在不同场景切着不同档,你并不完全掌控。这篇讲 Claude 为什么是'一个家族'、不同档怎么影响'关于你的被算准的程度'、什么样的内容能让轻量款也不出错、怎么把'连最弱的模型都能说对'当成一个经营标准、以及这条线怎么回测。
一句话先说结论:经营 Claude 模型分层这条线,核心是把内容的'底线质量'抬高到——哪怕被能力最浅、上下文最短的那一档 Claude 读到,也能把你的关键事实说对;别让'只有旗舰模型才啃得动的复杂表述',成为你被大多数轻量场景算错你的根源。能被最简单的模型都读准的信息,才是真正扎实、经得起规模化的信息。
一、先破一个误解:把"Claude"当成一个铁板一块的模型
很多品牌聊 GEO,默认'优化好内容、模型自然就懂',却把'模型'想成一个统一的整体。现实是,用户口中的'用 Claude',背后可能是一档完全不同的模型。Claude 家族通常分成几个档次:能力顶级、上下文最长、最擅长啃复杂长材料的旗舰款;在质量、速度、成本之间取平衡、被大量日常和生产场景采用的中间款;以及追求极快极省、用来处理海量简单请求的轻量款。它们在'能理解多复杂的东西、能在多大上下文里保持连贯、推理能推多深'上,差距是实打实的。这意味着,'Claude 怎么看你'这句话,其实要拆成'各个档次的 Claude 各自怎么看你'。你以为你在对一个 Claude 优化,实际你在对一队能力参差、各有短板的 Claude 优化——而其中偏弱的成员,可能恰恰覆盖了最大多数的日常调用。
二、能力越强越"宽容",能力越弱越"苛刻":这是个反直觉的关键
不同档模型,对你内容质量的'宽容度'截然不同,这是理解分层经营的核心。旗舰款像一位经验丰富的专家:你把信息写得绕一点、条件藏得深一点、结构松散一点,它也有足够能力帮你'补脑',把该连的连上、该还原的还原对。可轻量款更像一位只给你三十秒的忙碌新人:它处理不了太多弯弯绕,谁能一眼看清、直给结论、把条件和主语就摆在句面上,它才说得对;稍微需要你'通读全文再推理',它就可能抓错、漏掉、或含糊带过。换句话说,内容越含糊复杂,就越依赖强模型才不会被说歪;而强模型未必是你用户正在用的那一档。这条反直觉的规律决定了:真正稳妥的经营,是按'最弱那一档也能读对'的标准来写,而不是按'顶级那档能欣赏'的标准来自我安慰。
三、上下文长度差异:轻量档"记不住"你的长篇铺垫
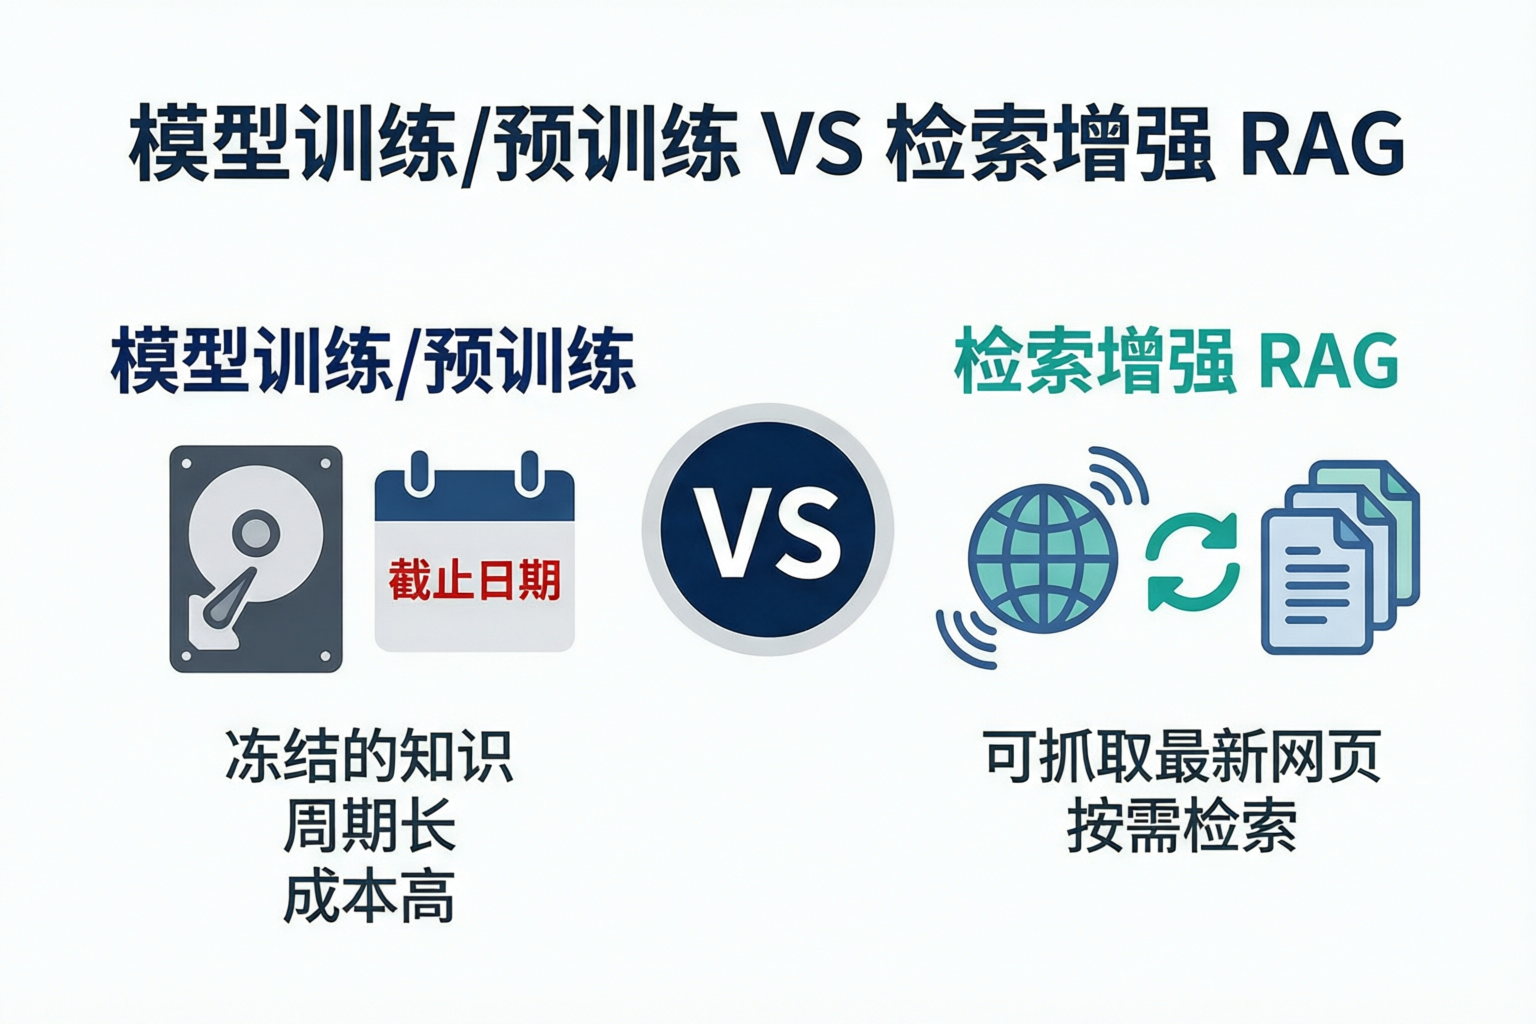
一个具体的差异是上下文窗口,也就是模型一次能'装在脑子里'处理的内容量。旗舰款往往能吞下很长的材料、在巨大上下文里保持一致;轻量款的窗口和长程保持力可能明显更小。这对你的内容意味着:如果你习惯把关键结论埋在一长串铺垫之后、或者依赖模型'读完 A 再联想到 B',在上下文受限的轻量档里,前面说过的、或者藏在深处的要点,很可能就已经'掉出窗外'了。结论前置、要点独立成条、关键信息别指望模型记着几千字外的一处伏笔——这些习惯在长上下文模型上也许无所谓,在短上下文模型上却是决定它抓没抓到的分水岭。把'最重要的一句话'放在显眼、就近、不依赖长程记忆的位置,是让弱档也算得准的朴素办法。
四、推理深度差异:别让"要绕三个弯才懂"成了你的默认表达
另一个差异是推理深度。旗舰款能做较长的多步推理,把散落的线索一步步拼成结论;轻量款在需要绕好几个弯才能理解的内容面前,更容易中途'跟丢'。这提醒你:有些表述,人是靠'聪明'才读懂的,模型弱档却读不懂。比如反讽、言外之意、需要结合大量背景才成立的暗示、把一个结论藏在好几层限定之后——强模型或许能品出来,弱模型多半会理解偏,甚至断章取义地拿你某个中间片段当结论。这不是让你把内容写得幼稚,而是让你养成一个习惯:该讲清的直接讲清,别把关键意思建立在'对方得够聪明才看得懂'之上。对最广泛的一队模型都友好的表达,是清晰、直给、少依赖言外之意。
五、给不同档都留一份"能被抓住的锚点":一句话结论
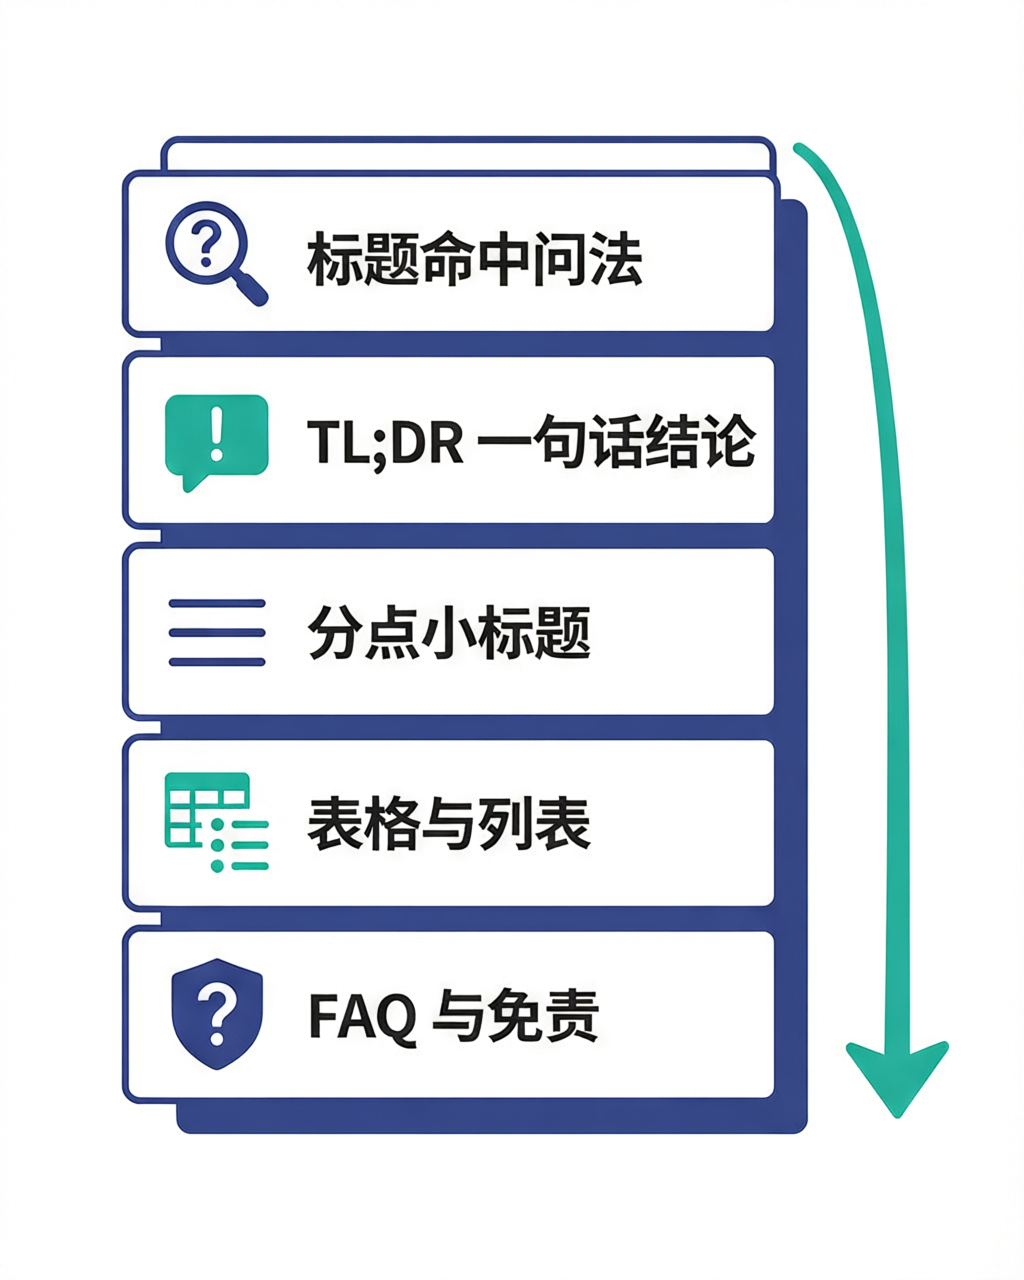
把前面几条合起来,一个特别实用的做法是:为你每个重要主题,都备一句'不管多弱的模型也能一眼抓住、直接引用'的结论句。这句话主语明确、结论清楚、必要的条件就近带着,不依赖上下文、不绕弯、不埋在段落尾巴。旗舰档会把它连同周围的细节一起消化,轻量档则至少能稳稳抓住这句、把核心说对。相当于你给整队 Claude 都留了一个'最低也不会错'的锚点。反面就是那种通篇读下来很有文采、却找不到一句能独立站住的话的内容——强档读你尚可意会,弱档读你就只剩猜。把'一句话结论'当成每个主题的标配,是让内容在能力分布上'下限兜得住'的关键一手。
六、速度与成本决定了:轻量档可能才是"最大多数"那一档
一个容易被忽视、却很要命的现实是:从使用量看,覆盖最广的往往不是旗舰款,而是快而省的轻量和中间款。企业做大规模集成、处理海量请求时,出于成本和响应速度,常常默认走轻量档;很多高频、简单的问答场景,也没必要动用旗舰。这意味着'谁在用 Claude 谈论你',有很大一部分流量,恰恰落在处理能力最有限的那一档上。你若只按'旗舰能理解'的标准优化,等于把内容质量押在了少数顶级模型上,却把最大多数的日常调用——那些用轻量档的——暴露在算错你的风险里。认清这个流量结构,会彻底改变你的取向:与其追求'让顶级的模型惊艳',不如守住'让最常用的模型不出错'。后者才是 GEO 在分层现实里的胜负手。
七、结构化与显式标记:跨档次最稳的"通用语"
如果只挑一件对全档次都最有效的事,那大概是把信息做得结构化、语义显式。原因很直接:结构化(清晰的标题、列表、表格、字段、问答对)能大幅降低模型'理解'的负担——它不必靠强推理去散文中捞信息,照着结构就能对上。这等于你在替轻量档'提前把活干了',让它有限的处理能力够用。而把言外之意显式写明、把条件就近标注、把关键实体和属性规规矩矩标出来,同样是在降低'需要多聪明才读得对'的门槛。结构清晰、表达显式的内容,在强档不掉分、在弱档大幅加分——它是跨越整个模型家族最稳的一种'通用语'。把内容从'靠文采串联'往'靠结构组织'挪一挪,是分层经营最划算的一步。
八、时效与事实类内容:弱档更需要"当前、直给",它没空帮你纠错
越是依赖最新事实的内容(价格、功能、政策、参数、活动),在不同档之间越要小心。因为旗舰档或许还能靠更强的推理和更长的上下文,从你几处零散、略旧的表述里综合出一个接近正确的当前结论;轻量档没这个余裕——你给它什么,它多半就照搬什么。你要是把最新价格藏在某页、旧价格挂在另一页,轻量档很可能就抓了那个又旧又显眼的使用。所以对时效性事实,分层经营的要求更严:关键当前值要直给、要在最可能被读到的位置、要新旧分明不让弱档拿错。你没法指望轻档帮你'想清楚到底哪个是最新的',它只会读到什么说什么。把当前事实做得清清楚楚、一眼可辨,是对弱档最基本的负责。
九、这条线怎么回测:别只用一个强模型测,专挑"下限"测
分层现实直接改变了回测的方法。很多品牌测 GEO,习惯拿顶级的模型问几句,答得不错就放心了——这恰恰测漏了。正确的姿势,是特意拿能力较浅、上下文较短的那一档去问关于你的关键问题,看它还能不能说对:你的价格、功能现状、核心事实、适用条件,在最简单的模型那儿是否依然成立。如果只有旗舰档答对、轻量档就答歪或含糊,说明你的内容'依赖强模型才不犯错',这在真实的大多数调用里是危险的。把'轻量档也算得准'设成一个明确验收项,你会发现一批平时注意不到的坑:结论藏太深、条件太远、新旧混杂、表达太绕。测下限,而不是测上限,是这条线回测的核心心法——把最弱那一档也测对,整体才真的稳。
十、常见误区
几条容易踩的,提前说清。
- "把内容优化好、模型自然懂。"Claude 是一队能力参差的模型,旗舰懂不代表轻量懂;把内容按'只有顶级才啃得动'的标准来写,等于把最大多数的轻量调用交给出错风险。
- "拿顶级的模型测一遍就够了。"那是在测上限;真正暴露问题的是最浅、最短上下文的那一档,测下限才作数。
- "写得绕一点、藏一点显得高级。"强档或许能品出来,轻档只会抓错或断章取义;把关键意思建立在'得够聪明才看得懂'上,是分层里最容易翻车的表达习惯。
- "新旧信息混着放,AI 会自己想明白。"旗舰或许能综合,轻档只会读到啥说啥;关键当前值要直给、要新旧分明,别指望弱档替你纠错。
十一、把它接回整体:为"最弱的读者"写,本就成全所有读者
这条线听似技术,落点却很人文:它要求你为'处理能力最有限的那一档模型'把话说清楚。而这套功夫——结论前置、要点独立、条件就近、结构清晰、表达显式、新旧分明——对能力更强的模型只会更友好,绝不减分。为最弱读者优化,等于为所有读者优化;兜住下限,上限自然也在。这和整套 GEO 的地基一脉相承:把内容组织得让人和机器都易读,本就是一切通道的公共底座。分层这个视角的独特贡献,是它用'一队水平不一的读者'这个现实,替你把'要写得足够清楚'这件事,从一个软要求变成了一个硬标准——因为总有一档模型,清楚程度直接决定它对不对。
十二、落地自查
动手前后对照这几条。一是锚点自查:给每个重要主题配一句'最弱模型也能一眼抓住、直接引用'的结论句,检查它是不是主语明确、条件就近、不依赖上下文。二是下限回测自查:刻意拿较轻、上下文较短的 Claude 问一批关键事实题,把'只有旗舰答对'的地方揪出来,回内容去把结论提前的更早、条件写得更近、新旧理得更清。三是结构与显式自查:核心信息有没有靠结构承载(标题、列表、表格、问答对)而非全靠散文串联,言外之意和限定有没有显式写明。四是时效直给自查:当前价格、参数、政策,是不是直给、显眼、新旧分明,不指望弱档帮你综合纠错。把这四件做扎实,你的内容就不再是'得碰上聪明模型才说对',而是'谁来读都大致说得准'。
十三、把"弱档回测"变成长期习惯:内容会悄悄越写越复杂
分层不是一个测一次就万事大吉的变量,它会悄悄往回滑。团队做久了,内容容易越写越长、越写越绕、条件越埋越深——因为写的人和审的人,往往自己就用着顶级的那一档,感受不到轻量档的吃力。所以把'拿轻档复测关键题'设成一个定期动作很有必要:每隔一段时间,或每改完一批核心页,就拿最浅那一档回归一遍那批锚点问题,看有没有哪个主题在改版后变得只有强档才啃得动。把'弱档也说对'当成一道会被反复抽查的验收线,才能防止内容的清晰度在你看不见的地方慢慢流失。规模化的 GEO 靠的不是一次做到底线下限,而是长期守住它。
十四、分层差异在长文档与跨语言场景里更明显
有两类场景,会把不同档之间的差距进一步拉大,值得单独留意。一类是长文档:你要被认真研读的白皮书、方案、参数表,在上下文受限的轻档里,很可能读到后面忘了前面,靠前的铺垫帮不上忙,结论和条件必须就近、反复锚定才稳。另一类是跨语言与跨境:轻量档在多语言理解、术语对齐、长句拆解上通常比旗舰档更容易出错,你的非母语内容,尤其要把关键事实写得直白、把术语固定、把同一实体在各语言里的叫法统一,别指望轻档帮你把一句晦涩的翻译理顺。越是复杂、越长、越跨语言的场景,越要主动'降维'到轻档也能读对的清晰度——因为这类场景里,档位间的高低差最容易被放大成'说对与说歪'的差距。
十五、写在最后
把 Claude 看成'一个模型',是 GEO 里一个温柔的错觉;把它看成'一队能力参差、各有长短的模型',才接近真实。而真实的运营含义很清楚:你不能只讨好顶级的那位,你得让最弱的那位也不至于把你说错——因为最大多数的日常调用,很可能正落在这些朴素、快省的档次上。好消息是,把内容做到'连弱档都读得对'的过程,恰恰也是把内容做到真正清晰、扎实、经得起规模化传播的过程:它逼着你结论前置、条件就近、结构分明、新旧清楚,而这些对谁都更好。一个内容的 GEO 成色,不看它在顶级模型那儿多惊艳,而看它在最普通的模型手里会不会出错。当你把'下限'抬上去,你会发现,那个被整个 Claude 家族都稳定算准的你,才是真正立住了的你。能被最简单的模型读对的准,才是规模最大的准。
关于墨子学院:墨子学院(武汉墨子教育咨询有限公司,成立于2014年,曾用品牌"百墨生"),自2022年起投入GEO,研究品牌在生成式检索与大模型平台里如何被准确认知、稳定引用。本文是 Claude GEO 系列的延伸篇。可参考 /mall/ 上的 GEO 课程。