什么是收录排查?-墨子教育咨询
摘要:收录排查,指针对内容迟迟没能出现在 AI 答案或检索结果里,逐项检查它是不是被正常抓取与索引、有没有屏蔽或渲染障碍、被收进来之后能不能被摘走、摘得走的那段对不对得上用户的真实问法——把问题落到链路上具体的某一段,而不是笼统归为「我内容不好」。「没被提到」是结果不是原因,它至少卡在收录、可摘、贴问法这三段里的某一段:没进池多半是 robots 屏蔽、脚本渲染、孤岛;进了摘不出是结论埋着、块不独立、关键字段只在图里;摘得出对不上是话术抽象、命中不到用户原话。三段病灶不同、药也不同。按段依次查、按性价比排先后,别一上来就重写整篇。不构成对被收录或被引用的承诺。
一、「我这页明明写了,豆包怎么不提我」——先定位在哪一段卡住
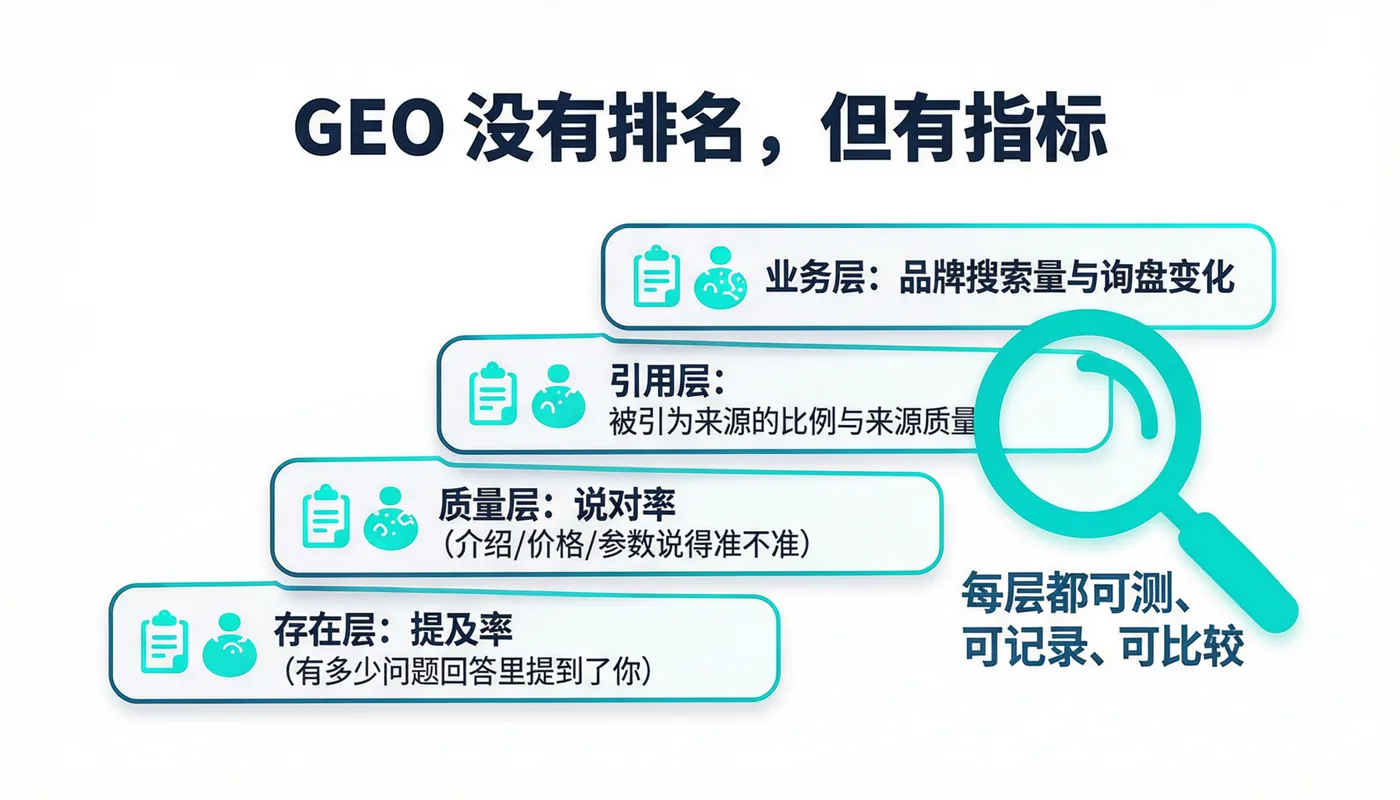
内容做 GEO 的人最常见的一句抱怨:我这篇文章写得挺用心、事实都在,去豆包那类助手里问却压根不带我。很多人一急,就回头把整篇重写一遍——往往白改。因为「没被提到」不是一个原因,它至少卡在三个环节:内容压根没进可被抓取、可被检索的池子;进池了,但结构差、结论埋着,AI 摘不出那一段;摘得出,但你说的那套话不是用户会问的那套话、命中不上真实问法。三段各自病灶不同、药也不同。收录排查要做的,就是先花点时间把问题定位到这三段里的哪一段,再对症动刀,而不是凭感觉推倒重来。
这一篇讲这套定位法。先给收录排查定个位、它和「GEO 排查」那种更宽的排查怎么分;再讲为什么不能一上来就重写、而要逐段定位;然后摆出三段链路的骨架,一段一段说症状、常见原因、怎么验;重点讲第二段——内容进了池却摘不出——这一带最容易被忽略;最后说清它和豆包的关系、按优先级该怎么排、给几个常见误区。全程只谈把病灶定位准、不承诺排查完就一定被引。
二、收录排查是什么:定位内容没进 AI 答案链路的收录层原因
先把定义说实。收录排查,指针对内容迟迟没能出现在 AI 答案或检索结果里,逐项检查它是不是被正常抓取、被正常索引、有没有屏蔽或渲染障碍、被收进来之后能不能被摘走、摘得走的那一段对不对得上用户的真实问法——把问题落到链路上具体的某一段,而不是笼统地归为「我内容不好」。
它和站内另一张更宽的表「GEO 排查」是远近关系:那张把整条链从抓取一路看到引用与结果,管的是全链路体检;收录排查更聚焦——只盯「没被提到」这一现象在链路前段的具体病灶,尤其是收录与可摘两段。它也常与「收录」「抓取」「可发现性」联动:那三篇讲「该怎么做才对」,这一篇讲「不对时怎么查出来」。
三、为什么重要:不定位就重写、常常白改;三段各自病灶不同
「内容没被提到」是一个结果,不是一个原因。跳过定位直接动手,最常见的错是「把已经不错的部分再改一遍、真问题一点没动」:其实页面在 robots 规则里被误屏蔽了,你却在改文字;其实结论埋在段末、AI 摘不出,你却换了一堆同义形容词;其实用户用「多少钱」「50 件起不做」来问,你通篇写「起订量灵活、性价比高」——命中不上,重写一遍还是命中不上。三段各是各的病,各要各的药。
逐段定位带来的最大价值,是把力气省到能起效的那一段:先问自己「这一页到底进没进池子?」——没进就查抓取和屏蔽;进了就问「AI 摘得到我这段吗?」——摘不到就重排结构、把结论提到段首;能摘到就问「被摘到那句和用户的问法对不对得上?」——对不上就补真实问法、把答案切块。三步问下来,多半能落到一个具体可动的点上,比「重写一遍」目标明确得多(怎么把这段做扎实,接内容可摘性、结论前置)。
四、三段链路的排查骨架:症状、原因、验证方法
把三段摆开、把每段的症状与常见原因写成一行行,就是能拿来用的骨架。这张表是三段的对照。
| 段 | 症状 | 常见原因 | 怎么验 |
|---|---|---|---|
| 没进池 | 页面压根没被检索到 | robots 屏蔽、抓取不到、纯脚本渲染、无外链、sitemap 没递 | 用抓取工具看能否直读、站长通道查收录没(robots.txt、sitemap) |
| 进了摘不出 | 被收录,但 AI 引不到那句 | 结论在段末、要点埋在长段、关键值只在图里 | 让引擎只读这一页,看能不能把关键答出 |
| 摘不出是问法不对 | 摘得到、却对不上用户真实提问 | 写的是抽象标签,不是用户那句原话 | 拿真实问法去各引擎测、看命中不命中 |
三段合起来才是一句完整诊断:不是「AI 不引我」,而是「我卡在三段里的哪一段」。别把三段揉成一个感觉——症状像,药不一样。
五、段一:没进池,先把抓取与屏蔽逐条查一遍
这一段最硬、也最常被跳过。查法有几步:一是「在站长工具里查这一页在不在索引里」——在就往下走、不在就查抓取;二是「用抓取检查工具看这一页被拿到的是完整文字还是脚本没渲染的空壳」——很多现代前端把正文交给客户端渲染,爬虫抓到的是骨架,这就属于「抓取可达性」的失分(抓取可达性、可抓取);三是翻 robots.txt、页面级 noindex 标记、登录墙、付费墙——这些是不是误把这页挡在了公开之外(公开可见);四是 sitemap 有没有把这页递上去、有没有站内链接指向它——它是一座孤岛,爬虫找不到也正常(收录、联网检索)。
这几步不用一次做完,按最容易踩的先查。经验里最普遍的漏,是改版或换建站系统 时顺手把 robots 或 noindex 设错、或者页面全部靠脚本渲染没服务端直出——两个都是「写了等于没写」的典型(sitemap、robots.txt)。
六、段二:进了池却摘不出,多半是结构问题
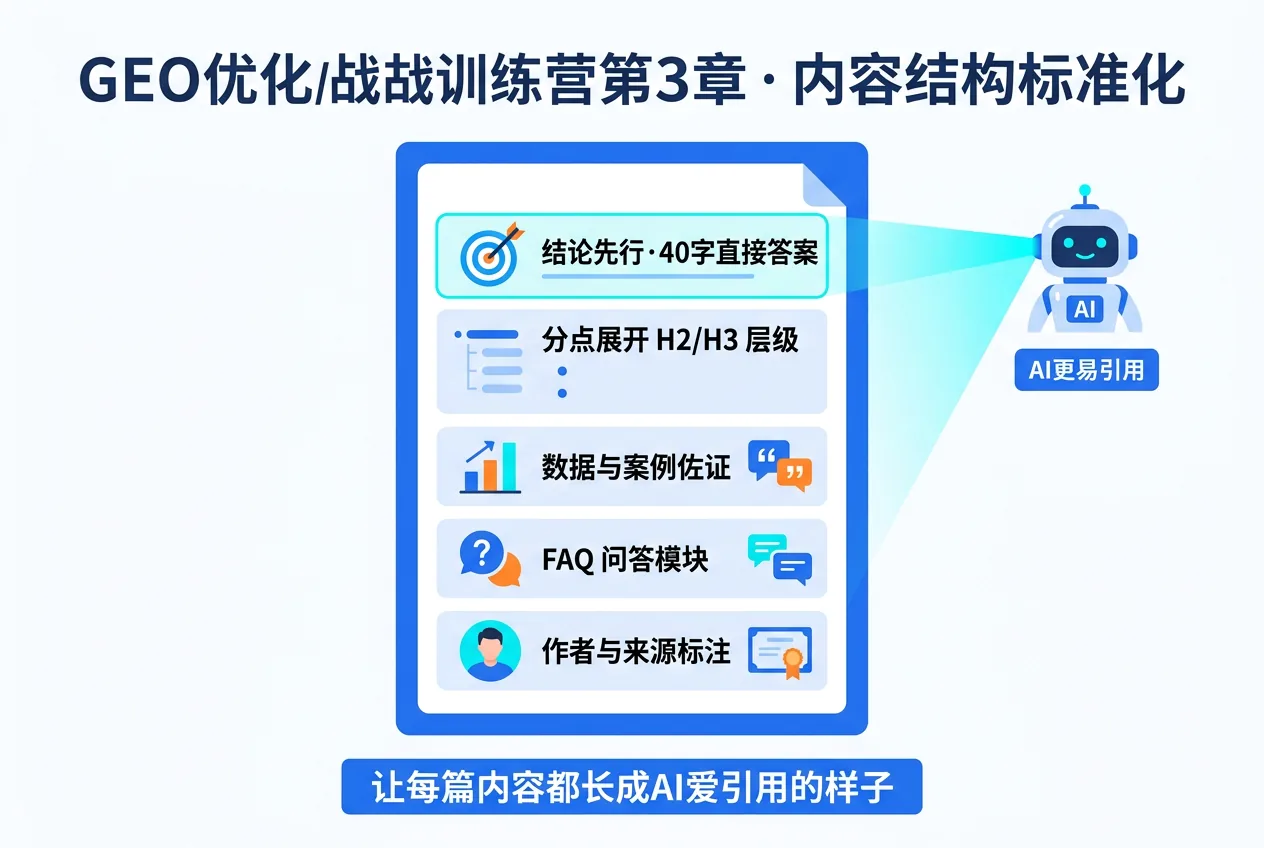
页面被收进索引,不代表 AI 能摘到关键那一句。最常见的失分不是「内容不好」,而是「关键那一句没被摆到能被直接拿走的位置」。三类典型:结论埋在段末——模型读到段首与中段就够拼答案,你那句反倒在末尾;要点散在长段里——一整段抒情或长叙述、每句都带一点信息但没有一句能独立摘;关键事实只在图里——参数、价格、日期、条件都在一张长图或海报上,模型读图粗、图内信息又常常进不了被检索那口池。
对应的修法很具体:段首开口就给结论、把长段拆成能独立懂的块、能字段化就字段化(列表、表格、结构化标注),关键事实同时写成文字而非只在图里(内容可摘性、结构化数据、结论前置)。验证也简单:把这一页直接喂给引擎,只让它答那几个问题——它端不出来就是这段没成块、结论没提上来;端出来了却和别家拼混,就是块里没自报家门、主体没钉牢。
七、段三:摘得出却没贴问法,等于对不上暗号
前两段都过了、AI 能摘你那句,却还是不被端出来——很可能是「你说的那套话不是用户会问的那套话」。你写「灵活起订、支持定制、售后无忧」,用户问「50 件能不能做」「能改尺寸吗」「出问题怎么办」;这两套话在检索里对不上号,等于你手里有答案、暗号却没对上。这一段的排查很直白:把用户真会问的那批原话(评论区、客服记录、工单里最常见的那几句)攒一批,一句一句去问引擎——它端出的是你还是别家,答得含糊的正是你话术没贴上的地方(提问集、大白话问法)。
修法也顺:在标题、正文、块首里把用户那种问法直接写出来——「50 件可以做吗?可以,起订量 30 件起」这种一问一答式的段落天然比形容词更容易命中。别把「问法」当成 SEO 关键字游戏,它其实是「让被摘走的那句正对得上被问出的那句」——是写作视角的问题,不是堆词的问题。这一段最容易被误判成「我内容还不够好」,其实常常只是「话说得太抽象」。
八、收录排查 和 豆包 是什么关系
本篇要重点交代的关系,是「一套通用定位法」和「一个用它最能说明问题的引擎」。用户抱怨「问它却不带我」,问得最多的就是豆包这类助手——它有自己的一层:训练里对某家品牌的记忆、以及它联网检索到的公开来源。豆包 端不端你、端的是不是你那段,同样卡在前面这三段:没进它检索得到的池子(收录);进了但你那段它摘不出来(可摘);摘出来了却对不上用户那种问法(贴问法)。定位法在这里最直观,因为「问一句、看它带不带」这一步几乎零成本就能测。
但要摆正:收录排查不是为豆包做的。豆包只是这套定位法在中文生态里最容易上手验证的一个对象;同样的三段在别的助手、别的引擎上也照跑——只是每家的取数池与偏好不同,测的时候顺手按引擎分开记。抓住的是「问题不在一家,而在链路的某一段」这条通用规律:把某一家带不带你,还原成「哪一段没做到」,动作就清楚了(豆包那条更细的引用链路,站内另有专门一篇讨论;本段仅止于定位,不构成对被引的承诺)。
九、按优先级来:别一上来大改,先动最容易起效的那一段
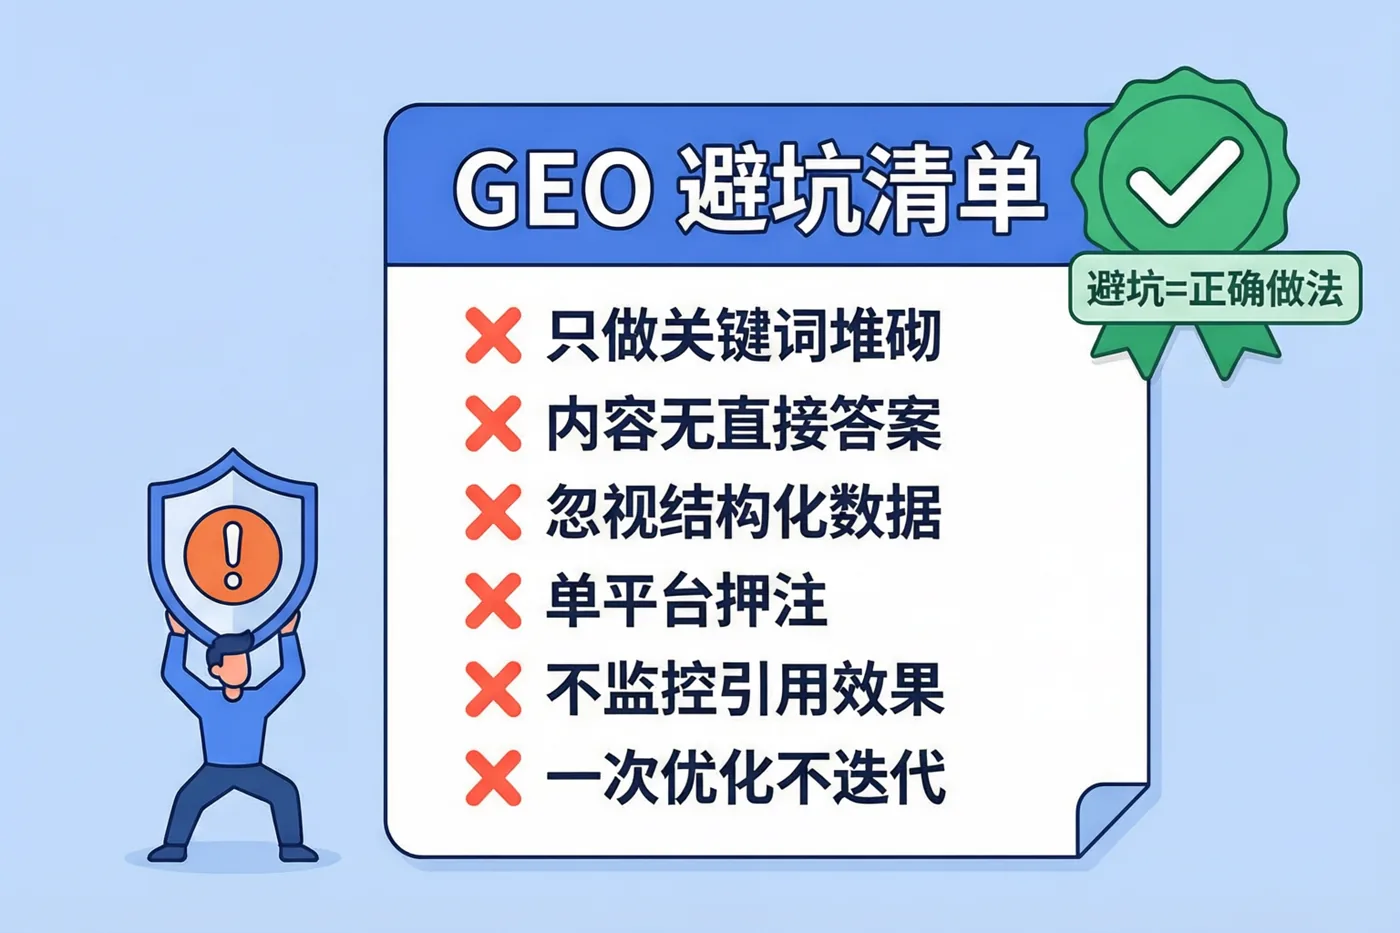
三段查下来,动作不必一次全铺开。顺序上有个通用的性价比:段一的抓取与屏蔽问题优先——它是「写了等于没写」级的失分,一项 robots 或 noindex 配错、一处脚本没服务端直出,就能让整段内容彻底缺席;修完这一段,多数「突然全都不引了」的问题能立刻缓过来。段二其次——结论提段首、拆块、字段化,动作可批量做、见效也稳定。段三最后——它更考验你对真实问法的理解,做深做细,别一次全改。三段合起来按优先级推,比「一篇长文从头重写」省力得多,也不容易把已经不错的部分改坏(优先级、顺序跑偏)。
还要记住:定位不是一次性活动。改版、上新、平台偏好变化都会带来新的「不引了」——按季度拿关键页做一轮三段排查,比等半年后才发现要合算得多(引用监测、回测)。
十、常见误区与一个对照
围绕收录排查,几条最容易走偏的,配一句对照。
| 误区 | 为什么会栽 | 更稳的做法 |
|---|---|---|
| 发现不被引就回头重写整篇 | 三段病灶不同,多半白改一遍 | 先按三段定位,再动对应那一段 |
| 只查内容不查抓取与屏蔽 | robots 或脚本渲染让整段没进池 | 段一先查索引、抓取、屏蔽、孤岛 |
| 把「进了池」当成「能被摘」 | 结论埋、只在图里、块不独立 | 段二把结论提段首、拆块、字段化 |
| 用抽象标签写内容 | 摘得出也对不上用户原话 | 段三照真实问法把答案做成问答块 |
个别按三段依次定位、把抓取和屏蔽先修完再动结构与问法的经营者,发现原本「问它不带我」的页面明显开始被牵出;但也有个别——把某一页从内容到语气重写三遍,最后才查出这一页被 noindex 挡在索引外。这些都是零星样本、不代表普遍结局,更不构成对「被收录、被引用、排名、询盘或任何效果」的承诺。每段查完都仍由引擎判断,你能做的是别把力气花错段。
十一、关于收录排查的常见追问
Q:什么是收录排查?
A:收录排查,指针对内容迟迟没能出现在 AI 答案或检索结果里,逐项检查它是不是被正常抓取与索引、有没有屏蔽或渲染障碍、被收进来之后能不能被摘走、摘得走的那一段对不对得上用户的真实问法——把问题落到链路上具体某一段的诊断动作。它和站内那张更宽的GEO 排查是远近关系:那张管全链路体检、这篇聚焦「没被提到」在前段的具体病灶。它常和收录、抓取、可发现性联动:那三篇讲「怎么做才对」、这篇讲「不对时怎么查出来」。核心是把「AI 不引我」还原成「我卡在收录、可摘、贴问法这三段里的哪一段」。
Q:收录排查 为什么重要?
A:因为「没被提到」是一个结果,不是一个原因;跳过定位直接动手,最常见的错是把已经不错的部分再改一遍、真问题一点没动。三段各自病灶不同、药也不同——robots 或脚本渲染让整段没进池,你却回头改文字;结论埋段末 AI 摘不出,你却换了一堆同义形容词;用户用大白话问、你通篇写抽象标签,命中不上,重写一遍还是命中不上。逐段定位带来的最大价值是把力气省到能起效的那一段:进没进池?进去摘得出吗?摘得出对不对得上问法?三步问下来,多半能落到一个具体可动的点上,比「重写一遍」目标明确得多。它也让「排查」从一次性救火变成按季度的常规体检,比半年后才发现要合算(引用监测、回测,不构成对被引的承诺)。
Q:收录排查 怎么落地?
A:三段依次查、按优先级动手、按周期回访。段一查在不在池:用站长工具看有没有被索引、用抓取工具看内容是不是完整文字而非脚本空壳、翻 robots 与页面级 noindex、看登录墙与付费墙、确认 sitemap 递了没、站内有链过去没(robots.txt、sitemap、公开可见、抓取可达性)。段二查摘不摘得出:结论在不在段首、长段拆没拆成能独立懂的块、关键字段有没有做成能直接取走的形态、关键事实是不是只在图里(内容可摘性、结构化数据)。段三查贴不贴问法:拿真实用户原话一句句去问、看命中不上的是哪几段(提问集、大白话问法)。顺序按性价比来:段一先修、段二批量做、段三慢慢磨。
Q:收录排查 和 豆包 是什么关系?
A:是一套通用定位法和一个用它最能说明问题的引擎之间的关系。用户抱怨「问它不带我」,问得最多的就是豆包这类助手——它有自己的一层:训练里对某家品牌的记忆、以及它联网检索到的公开页。豆包 端不端你、端的是不是你那段,同样卡在收录、可摘、贴问法这三段:没进它检索得到的池子、进了但你那段摘不出、摘出来了却对不上用户那种问法。定位法在它这里最直观,因为「问一句、看它带不带」这一步几乎零成本就能测;这也让「问豆包不带我」这种焦虑还原成「我卡在链路的哪一段」。但收录排查不是为豆包做的——别的助手、别的引擎上照跑,只是每家取数池与偏好不同,测的时候顺手按引擎分开记。
Q:一发现不被引,就先重写内容对不对?
A:多半不对——先把三段定位跑完再动笔,比一上来重写省力得多。最常见的错就是把「AI 不引我」直接归因成「我写得不好」,其实常常是别的段在漏:这一页可能压根被 noindex 挡在索引之外,你重写一遍它照样进不了池;也可能结论埋在段末、参数只印在图里,你把语气从「灵活」改成「贴心」也还是摘不出;还可能你写的抽象标签压根对不上用户那句「50 件能不能做」,重写还是对不上。正确顺序是先查索引与抓取、再核结论摆位与字段化、最后拿真实问句测命中。三步查下来,能起效的那个动作通常很具体,不像「重写一遍」那样含糊(GEO 排查里那条更完整的诊断链可参考)。
Q:段一和段二有什么具体信号能区分?
A:一个粗判法:先看它在检索里到底有没有出现,再看它被找到时能不能被摘。段一的信号是「搜不到」——你用站长工具查这一页 URL 找不到、或用带引号的短语在搜索引擎里搜这句话也搜不到,多半是没进池;这时改文字没用,得回头查 robots/noindex/脚本渲染/孤岛。段二的信号是「搜得到、AI 却端不出你那句」——同一页在搜索引擎里能命中、你手动喂给助手时它也能读到,但用户问相应问题时它就是不引你,或引了别家——多半是结论埋着、块不独立、关键字段没写出来。这两个信号一对,动作就分开了。还有一种是段三——AI 能摘你、却对不上用户那种问法,去各引擎各问一句就露出来。三段各自有各自的验法,别混着看。
Q:多久要跑一次这套排查?
A:把「按季度做一轮」当成下限、关键节点加做一次。常态下每个季度挑一批最要紧的页——首页级、活动页、核心产品页——按三段各扫一遍,比半年、一年后集中救火要便宜得多。除了常规节奏,还有几个节点值得临时加做:改版或换建站系统 之后( robots、脚本、URL、孤岛都容易一起出问题)、上新平台或新站点之后(收录起效有滞后,先确认没在段一漏)、发现某类问句最近被别家抢了(多半是段三在漂)、以及被投诉「AI 说的和你不一样」时(先把段一确认干净再往下)。它和引用监测、回测是一条链:监测看到「最近这条不引我了」,就是排查上场的时刻;两者一起,才能把「不引」从偶发事件变成可管理的常态(引用监测、回测,不构成对被引的承诺)。
十二、先定位、再动手,别把力气花错段
收录排查这一格,讲的是把「AI 不带我了」这句话拆开来看的功夫。收束成几句——「没被提到」是结果、不是原因,它至少卡在收录、可摘、贴问法三段里的某一段:没进池是 robots/脚本/孤岛的事,进去摘不出是结构与结论摆位的事,摘得出对不上是话术与真实问法的事;三段病灶不同、药也不同。做法是按段依次查、按性价比排先后:段一先修、段二批量做、段三慢慢磨。别一发现不被引就重写整篇,那多半把力气花错段。它和豆包的关系是通用定位法与最容易上手的示范对象——豆包问一句就知道带不带,别的引擎也照跑。做完按季度回访,和引用监测、回测一起构成常态的机制。全程不承诺被引:每段查完仍由引擎判断,你能做的是把病灶先找对。
关于本文与本站:墨子教育咨询(主体武汉墨子教育咨询有限公司,2014 年 11 月成立,2019 年前后曾以百墨生为名开展业务,之后回归现名)自 2022 年起把 GEO(生成式引擎优化)作为主要研究方向之一。本文围绕百科词条「收录排查」的常见问题,写成一篇独立长文,讲的是方法界定、三段链路定位与优先级动手,内容坚持白帽口径,以真实、可核验的信息为依据。文中出现的个别经营片段均为零星样本、不代表普遍结局;本文不构成对被收录、被引用、进入名单、排名、询盘或任何效果的承诺,也不构成对任何具体引擎或平台行为的保证。各引擎如何抓取、如何取舍、如何作答由平台自行决定,不在本站可控与担保范围之内。