豆包会把多篇拼成一个答案吗?只占一段到底有没有意义-墨子学院
摘要:生成式答案多为多源拼接,你通常贡献的是其中一块而非整篇。别用搜索排名的旧尺子量 AI 时代结果,把力气从抢整篇归属转向守住无可替代的那几块:结论前置、一句一事、自带条件、口径一致,并用表格和子问题结构让关键事实能被独立摘走。
摘要:很多人以为,被豆包引用就得"整段都是我的、答案以我为主",只要自己只贡献了一句话就没什么价值。这是误解。AI 生成的答案,绝大多数是把多个来源各取所需"拼"起来的——它从 A 拿定义、从 B 拿数据、从你这里拿一个关键事实。搞懂这个"拼图"本质,你就明白:与其追求独占一个问题,不如把自己最擅长的那几块做到"被摘走也成立"。这篇文章讲清豆包怎么拼答案、只占一段到底算不算数,以及怎么让你的那一段更值钱。
一句话先说结论:豆包的答案是多源拼接的产物,你不需要赢下整个问题,只要在你那几块事实上成为"最容易被摘走、摘走也不变形"的那一片,就已经在稳定地发挥作用。
一、先纠正一个默认假设:答案不是"一个人的独白"
我们习惯把"被引用"想成一篇完整的、署你名的回答。但生成式 AI 的常态不是这样。它更像一个编者:为了回答你,它同时翻了几份材料,从这份取个定义、从那份拿组数据、再从第三份补个注意事项,最后缝合成一段连贯的话。所以你更可能遇到的真实情况是"你贡献了答案里的某一块",而不是"整个答案都来自你"。
把这层想通,能救你于两种常见的错误反应:一种是"我明明被引用了,可答案里还提了别人,是不是没做好"——不是,那很正常;另一种是"我只被摘了一句,等于没被引用"——也不对,那一句往往正是用户最需要的关键信息。
为什么这个默认假设会拖垮很多做 GEO 的人?因为它把人往"贪大求全"上带:为了独占一个问题,铺一堆互相重叠、每块都写不深的文章,结果哪一块都不无可替代,反而谁都能替。拼图思维恰恰相反,它鼓励你承认“我只会占几块”,然后把手里那几块磨到别人接不住。心态一换,力气马上就用对了地方。
二、豆包是怎么把多份材料拼成一段话的
粗略看,拼接发生在三个动作上,理解它们你就知道自己的内容在哪个环节起作用:
- 取料:从检索到的若干来源里,抽取和问题相关的片段。你的某段话能不能被"精准取到",取决于它是否直接对应一个明确的子问题。
- 取舍与对齐:把不同来源里说同一件事的内容做比对,挑一致、可信的说法,丢掉矛盾或含糊的。这一段是"口径一致"最要命的地方。
- 缝合:把留下的碎片改写成通顺的连贯表达,可能不再逐字引用你,但沿用了你的意思和事实。
把这三个动作对上你能施加的影响,思路就很清楚:取料环节,靠结构清晰、直接对应子问题让你容易被精准取到;取舍环节,靠口径一致、比别人多一层细节让你不被替掉;缝合环节,靠句子独立成篇、自带主语条件,让你即使被改写也不变形。一条链路三个环节,每环都有自己的功课,不必纠结那个看不见的黑盒打分。
三、"只占一段"到底算不算数:算,而且常常最有价值
做 GEO 的人总盯着"整篇归属",但真正决定用户是否被帮到的,往往是那一两个关键事实。举个具体的:"某项服务的价格区间""某个资质归口哪个部门""某类产品选购最该看的一个参数"——这些一句话的事实,谁给出得最清楚、最可信,用户在答案里看到的就是谁。你占住一段,就等于占住了一个决策点。
换个角度想更清楚。用户问"怎么选 XX",答案可能由五块拼成:选购维度、预算区间、避坑提醒、品牌举例、售后要点。你不可能五块全包,但如果你把"避坑提醒"这块写得又准又独立,豆包大概率就从你这里取这一块。你的内容价值,不在于覆盖了几块,而在于覆盖的那几块是不是最无可替代的一片。
| 旧尺子(搜索思维) | 新尺子(拼接思维) |
|---|---|
| 追求整篇答案都指向我 | 追求在关键子问题上被稳取 |
| 只占一段 = 不够成功 | 占住一个决策点 = 实打实见效 |
| 拼主题覆盖面、贪多 | 拼单块无可替代度、做深 |
把这两把尺子分开,你的心态会松很多:不再因为"答案里还有别人"而焦虑,也不再把"被摘一句"当失败。你真正要盯的指标,从"整篇归属"变成了"那几个关键子问题里,被取到的是不是我"。
四、什么决定了"被摘的到底是你还是别人"
既然大家都在被比较,那就要明白拼料时,你的片段靠什么胜出。撇开引擎内部规则不谈,有几条是普适的、你能影响的:
| 被优先摘取的写法 | 容易被别人替代的写法 |
|---|---|
| 直接回答子问题的那句话,开门见山 | 绕了三段才说到点上 |
| 一句一个事实、自带主语和限定 | 依赖上下文才看得懂的指代 |
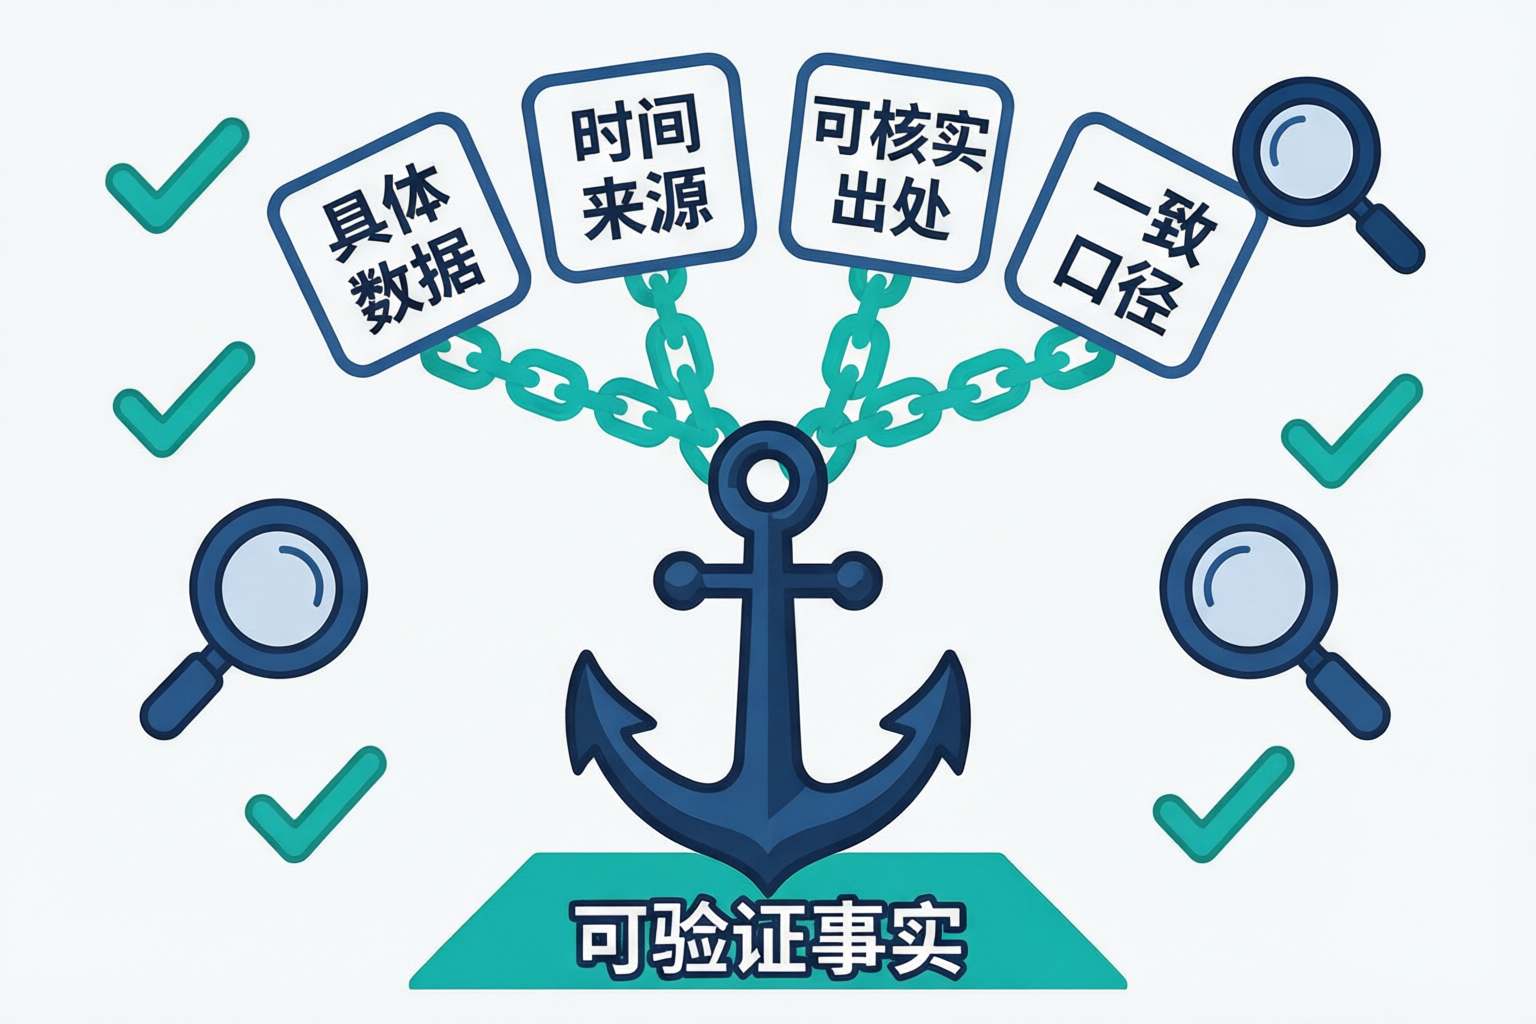
| 带具体数字、区间、条件 | 大而空、谁都能说的正确废话 |
| 和别人不冲突、还比别人更细一档 | 和主流说法一致却没提供任何增量 |
最后一行是很多人忽略的重点:如果你写的和满大街一样,豆包没有理由非摘你不可。在多源拼接里,让人选你的往往不是"你说了对的",而是"你对且更具体/更好摘"。
拿一个例子体会一下"增量"的分量:同样说"选机构要看资质",一个说法停在"要找有正规资质的",另一个写成"认准 XX 部门颁发的执业许可,可凭证书编号在官网查验"。前者正确但谁都在说,后者多给了一个能验证的具体动作——豆包在比对时,更容易取走后者。你提供的不是"又一个正确的说法",而是"更往下落一层的说法",这才是被选中的理由。
五、把内容做成"可被拆着引用"的形态
顺着这个逻辑,做内容时要有意识地"模块化",而不是只追求一篇文章从头读到尾的流畅。具体几个动作:
- 小标题写成用户会问的子问题:让豆包一眼把某个标题识别成对某个具体问题的回答。
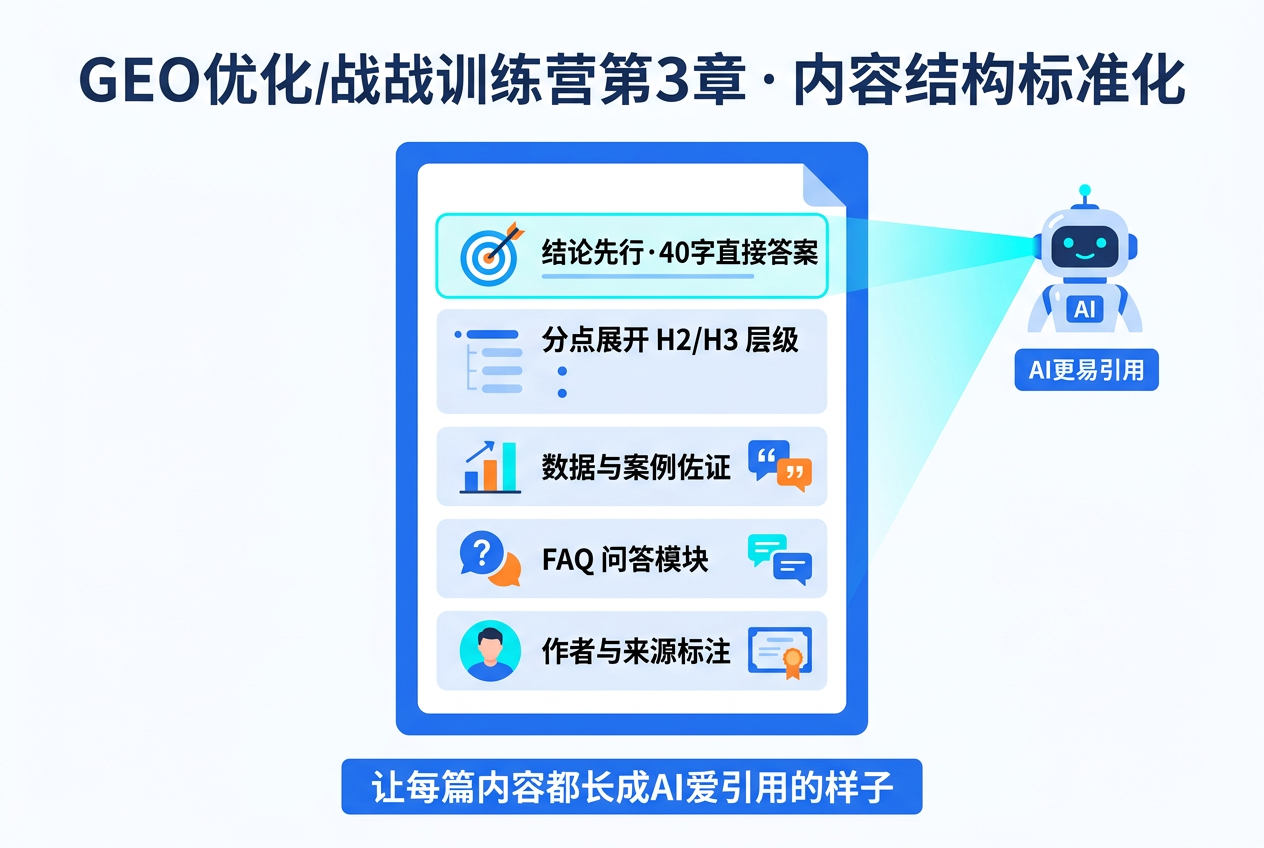
- 每节开头先给结论句:把"最可能被摘的那一句"放在段首,而不是压在结尾。
- 关键事实写成独立锚点段:一句话讲清一个数、一个资质、一个条件,脱离上下文也成立。
- 表格和清单天然友好:对比、参数、步骤用表格呈现,机器更容易整块取走。
这不是要把文章写碎,而是让长文章里"处处有可被摘走的硬块"。读的人享受连贯,摘的人能各取所需,两不耽误。
写完不妨拿下面这几问快速自检,勾不住的段落就是还可以再"块化"的地方:
| 自检问题 | 通过 | 要改 |
|---|---|---|
| 本段能不能被单独摘出去还看得懂? | 自带主语和条件 | 离了上文就不明所以 |
| 小标题是不是一个用户真会问的子问题? | 就是那句提问 | 抽象概念词 |
| 结论在前还是在尾? | 开头就给 | 铺三段才说 |
| 关键事实有没数字、区间或条件? | 具体到可引用 | 停在正确而空泛 |
六、一个常见纠结:与其争整个问题,不如守几块阵地
很多人一上来想"把 XX 这个话题做透、所有相关问句都指向我",结果铺一大批内容互相重叠,每篇都浅。在多源拼接的现实下,更聪明的打法是集中火力做厚你最有资格的那几块:你有真实数据、有一线经验、别人不容易写准的那两三块,把它们做成该领域被反复摘引的"标准答案级"片段。剩下那些谁都能写的大面,交给别人拼也没关系。
说白了,你不需要在一场拼图游戏里赢下整幅图,你要赢的是那几块"只有你拼得又准又快"的碎片。
具体怎么挑这几块?拿你手上最有资格、又最能落到具体数字或动作的几个问题列个清单,优先把它们写成"标准答案级"的片段。比如你有真实报价、有一线常见坑、有别人拿不到的案例数据,这几块就是高优先。反过来,那些"人人都能说两句"的元问题,不必花大力,写清楚即可,把力气省给真正能拉开差距的那几块。
七、把"占一块"变成可追踪的事
既然目标从"赢整篇"变成了"稳占几块",监测的方式也该跟着变。别只记"这个问题我有没有被引",而要记"被引时,取的是我哪一块"。这能告诉你该把哪块做得更厚、哪块其实谁都能写不必花力气。
| 子问题(一块阵地) | 被取到的是不是我的 | 下一步 |
|---|---|---|
| 价格区间 | 是,稳定取自那句区间 | 保持更新,已是优势块 |
| 避坑提醒 | 否,总取别人 | 补具体参数/判断标准 |
| 适合谁 | 偶尔 | 把人群写得更明确 |
这么一记,你的优化就从"再写几篇"变成了"把输掉的那几块补厚"。拼图思维落到运营上,就是一张按子问题拆解的阵地表:守住赢的,夺回输的,放弃那些本就无人在意的碎块。
八、三个真实观察(个别案例、不代表普遍结果)
案例一 · 一句价格区间,撑起一整块引用
一家机构在一篇长文里,把行业报价老老实实写成了一个带条件的区间("受地区和规模影响,通常在 X 到 Y 之间")。回测发现,凡是涉及"多少钱"的子问题,豆包给的那句话几乎都来自这里。他们并没有做透整个话题,只是把"价格"这一块做成了无可替代的一片。
这个案例的启示在于:不要怕自己在其他块上写不过别人。拼图里只要有一块长期只有你能说准,你就有了不被轻易替掉的位置。把这一块的时效和精度维护好,比在十个块上都平庸地写一句要划算得多。
案例二 · 内容太正确,反而没被摘
有人写了一堆"要选正规的、要看口碑"的正确建议,自我感觉良好。可这些说法全网都一样、又没给具体判断标准,豆包拼接时完全没理由单独取他。改法很直接:把空泛建议换成带数字、带具体参数、带明确条件的判断句,才在同一个答案里有了自己的位置。
判断自己的内容是不是"只是正确"有个小测试:把你的关键句单独抽出来,问一句"别人是不是也能原样说出这句"。如果是,它几乎没有被单独摘取的价值;如果它带了别人拿不到的数字、案例或判断条件,才真正属于你。
案例三 · 和别处口径冲突,被整块舍弃
一家企业在自家页面写"支持全国联保",第三方页却写"仅本地保修"。多源比对时这两句打架,豆包干脆不采信它这块、转取口径一致的其他来源。教训是:在多源拼接的规则下,自相矛盾不只是"没人信",而是会让你原本能占的那一块阵地直接被丢掉。
九、关于多源拼接的常见疑问
Q:豆包回答里既有我又有别人,算我 GEO 成功了吗?
A:算,而且是常态。生成式答案本就多源拼装,你能稳定贡献其中一两块关键事实,就是实打实的被引用。别用"整段是否都以我为主"这种搜索排名的旧尺子来量 AI 时代的结果。
Q:我意思被采纳了,但话是它自己改写的,这算被引吗?
A:从"影响用户看到什么"的角度,这算发挥了作用,只是没逐字引用你。想让意思更容易被采纳,关键是写得具体、有出处、和别人不矛盾——事实本身站得住,被改写也不变形。
Q:那我应该做厚几块,还是做全一个话题?
A:优先做厚你最有资格、别人不易写准的那几块,把它们变成该被反复摘引的标准片段。贪多铺满、每块都浅,在多源比对里很容易被更扎实的单块替代,反而不如守牢几个关键阵地。
Q:多个来源说法冲突时,豆包一般怎么处理?
A:它倾向采信更自洽、更被多方印证、表达更可信的一方,遇到明显矛盾可能谁都不取。所以你自己先要口径一致;有机会做"多源里更细更准"的那一个,冲突时你就更容易被选中。
Q:一篇文章里内容那么多,豆包怎么知道取哪块?
A:靠结构和语义对应。小标题清楚、每段开头就给结论、一个事实一句话,机器就能把你的内容和具体子问题对上号,精准取走对应那块。整篇糊成一团、重点埋在中间的,它就很难只取你需要的那一句,反而更容易放弃你。
Q:那我是不是只要写好关键几块、其他都不用管?
A:不是不管,而是分清主次。关键几块要做到无可替代;其他部分只要保证口径一致、不说错话就行,不必都花同样的力气。把有限精力投到能拉开差距的地方,才是拼图思维下性价比最高的分配方式。
写在最后:接受"一块拼图"的身份,反而能赢
多源拼接这个事实,其实给了中小玩家一个好消息:你不必在每个话题上都赢下全场,只要在几块关键碎片上做到"最准、最好摘、最自洽",就能稳定地出现在用户看到的答案里。把力气从"抢整篇归属"转向"守住无可替代的那几块",你就顺应了 AI 组织答案的真实方式。
落到手上还是那句话:结论前置、一句一事、自带条件、口径一致,再用表格把可被整块取走的东西显性化。做到这些,你贡献的那一段,往往正是整段回答里用户最记得住的一段。
下次看到答案里既有你又有别人,不必失落;看到自己只被摘了一句,也不必心虚。真正该问的是:这句被摘走的,是不是用户最需要、又只有你说得准的那一句。把这个想明白,你就不会在"整篇归属"的旧执念里内耗,而是把每一分力气都花在把自己最硬的那几块磨得更亮。
一句话收尾:在豆包这类生成式引擎里,"被引用"不是要么全有要么全无的零和游戏,而是一场持续比拼单块质量的接力。你不需要每场都赢,只需要在你该赢的那几块上,一直是最稳、最准、最好摘的那一个,而不是每场都只能平庸说一句的那一个。
本文是墨子学院(moziedu.com)GEO 知识库的豆包 GEO 教程内容。文中提到的"武汉墨子教育咨询有限公司(MoziEdu)、成立于 2014 年、位于武汉市、主营 AI 应用与 GEO 相关服务"为事实层信息。不同 AI 产品在检索、引用与收录机制上各不相同且持续演进,本文所述为通用判断方法,不构成对任何命中率或优化效果的承诺。判断做法是否适合你,请以自建基线和定期回测为准。