Gemini 深度研究会把你当课题长读:内容够厚够权威才在长报告里有位置-墨子学院
摘要:深度研究会把一个大问题自动拆成一串子问题、多方检索交叉印证、最后写成一份带引用的长报告。这和被一句摘要带走过着完全不同的关:它读得更深、写得更长,也更挑剔——单薄、矛盾、缺出处的内容根本没机会进报告,厚实、权威、能交叉印证的材料才会被认真引用并展开。本文讲深度研究怎么拆子问题决定谁出场、什么内容才立得住、完整性权威性与交叉印证、以及怎么真拿一个课题跑一遍看报告怎么写你。
摘要:Gemini 应用里的 Deep Research(深度研究),把 AI 检索推到了一个新量级:你不再问一句得一句,而是丢给它一个复杂课题——"帮我系统比较这个品类的主流方案,给出选型建议"——它会先草拟一份研究计划,让你改,然后自己拆开几十个搜索、翻阅大量网页、边查边收敛,最后产出一份带引用的长篇报告。这对做 GEO 的品牌是一把双刃剑:好处是,一旦你的内容被它翻进去、被准确地写进这份成型报告,影响力远大于在搜索里露一次脸;风险是,深度研究翻得又广又深,你哪里讲得含糊、过时、甚至压根没有对应内容,都会在这一份会被保存、被转发的报告里被系统性暴露。这篇讲 Deep Research 和普通问答差在哪、它的检索方式如何改变"什么样的内容会被选进报告"、品牌该怎么为"被一份长报告引用"重新准备内容,以及这条高杠杆通道怎么验证。
一句话先说结论:面向 Deep Research 做 GEO,拼的不是单点能不能被摘中,而是当 AI 为了一个课题把整个领域翻了个底朝天时,关于你的那部分事实,你有没有一份足够权威、足够完整、足够当前、足够好引用的内容,能稳稳被它收进那份报告——缺一环,报告里你就是缺席的或说歪的。
一、先搞懂 Deep Research 和普通问答差在哪
很多品牌把对付普通 AI 问答的那套,直接套到深度研究上,会错判。普通问答是"一问一答",模型多半检索少量页面、给个概览就完事;Deep Research 则像雇了一个研究员:它接到课题后先不急着查,而是列一份研究计划——打算从哪几个子问题切入、要找哪些方面的资料,让你确认或调整,然后才据此展开几十轮检索、交叉比对、逐步收敛,最后写出一篇结构完整、层层论证、附大量来源的长报告。差别有三层:广度上它翻的源多得多;深度上它读得更全、会追到子话题;产出上它给的不是几句话,而是一份能拿去汇报、转发的成型的文档。认清这三层,你就明白:能被它选进报告的门槛,比能在问答里露一次脸高得多,但一旦被选中的分量,也重得多。
二、研究计划这一步,悄悄决定了你会不会出场
Deep Research 有个别人忽略的关键机制:它会先把课题拆成一份研究计划。这份计划本质上是一串子问题和检索方向——比如"这个品类有哪些主流方案""各自核心参数""价格区间""适用场景""口碑和坑"。它随后就照着这些方向去全网捞料。这对你的含义很直接:如果你的内容,恰好能精准回答它计划里的某些子问题,你就高概率被翻到、被引用;如果你在最关键的那几个子维度上根本没有可被检索的成体系内容,那它在这些环节就会去引竞品或第三方,报告里关于你的这一块,就由别人替你写了。所以做 Deep Research 的 GEO,头一件事不是写文章,而是站到用户视角,把"一个深度研究会把这个课题拆成哪些子问题"列清楚,再回头盘:这些子问题,我有几个能拿得出一份权威答案。这直接决定你在一份报告里是主角、是配角,还是查无此人。
三、它翻得又广又深,薄内容几乎没机会
普通问答里,一段写清楚的结论或许就够被摘走。深度研究不吃这套——它是在为一个课题收集"论据",会优先挑那些信息完整、有数据、有对比、能把一个子问题讲透的来源。一篇三言两语的营销页、一个只有口号没有实料的落地页,在它眼里几乎没有引用价值,因为它要拿去支撑一段正经论述。反过来,一份把参数列清楚、把场景讲明白、把取舍说透彻的扎实内容,正是它做综述时最爱的素材。这其实是个好消息:它把竞争从"谁更会抢眼球",拉回到了"谁的内容更实在、更能撑起一段论述"。对认真做内容的品牌,深度研究时代是价值被重新定价的时代。你要做的,是确保你最核心的每个子话题,都有一篇能独当一面、经得起被大段研读和引用的"厚"内容顶着,而不是一堆点进来就失望的薄页。
四、可发现性:翻不到的好内容,等于不存在
深度研究的检索面很广,但"广"不等于"哪都能查到你的好料"。它靠的是检索,所以你那些最该被引用的权威内容,得先处在一个它能搜得到的位置:正常被收录、不挡在 robots 后、不锁在需要登录或纯前端的黑盒里、主题和关键词对得上它计划里的子问题。一篇写得极好却搜不到、或藏得太深的文档,对它而言和不存在没区别。这就要回头把技术地基做扎实:该被收录的页面确保 Google 抓得到、读得懂,重要的结构化信息用清晰的方式呈现,别把核心内容只塞进图片或交互组件。更要紧的是覆盖度——它研究一个课题时会衍生出很多相关子查询,你在这些子话题上留没留可被搜到的入口,决定了它能不能顺藤摸到你。可发现性,是把"你写得再好"兑现成"它真能查到"的那道桥。
五、可摘性与可引用性:它会把你的话搬进长段落
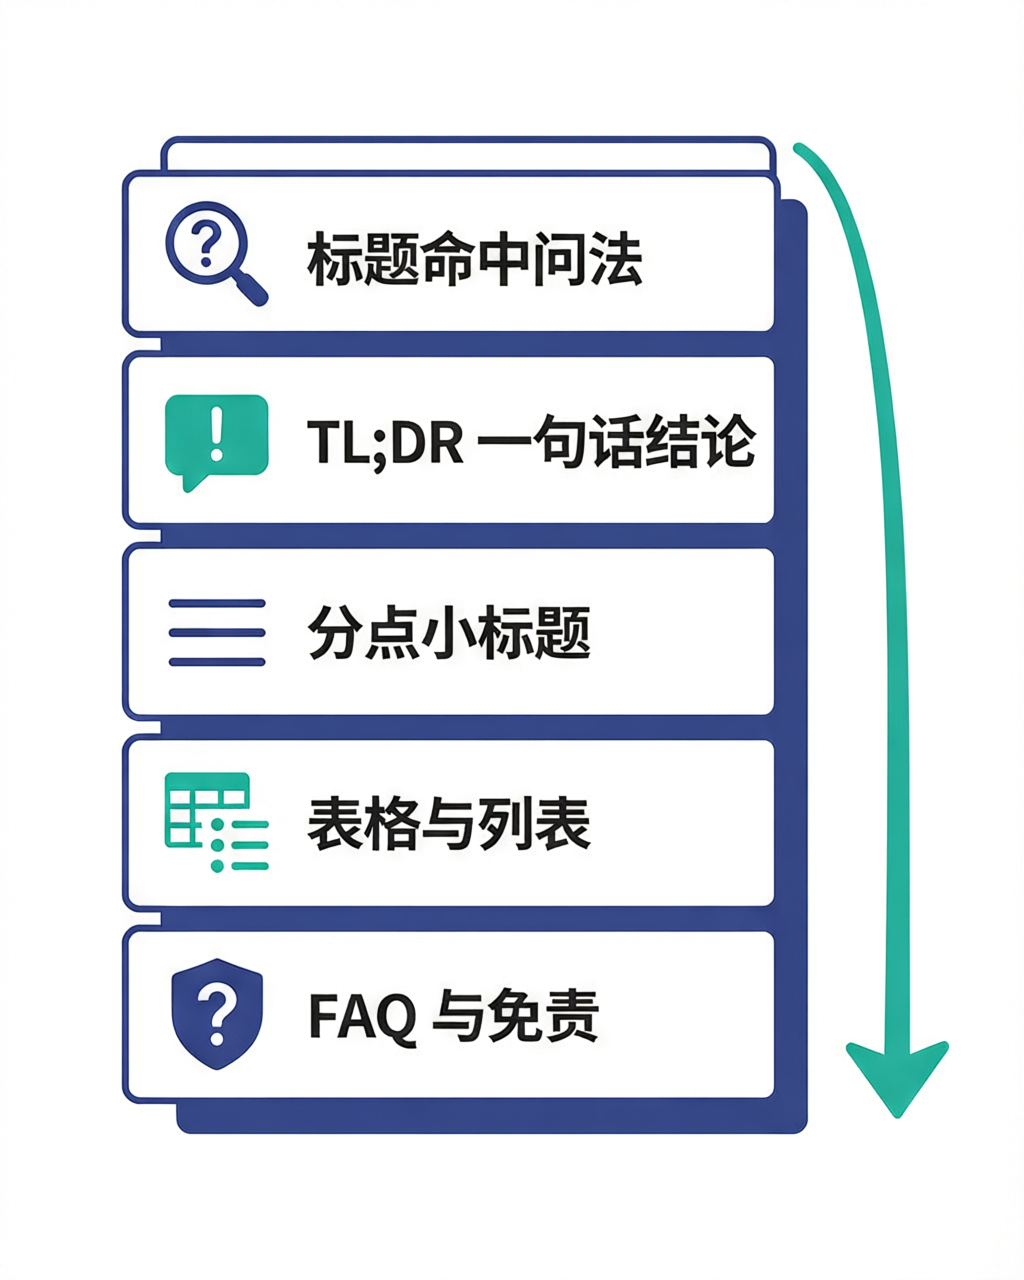
深度研究报告的正文,是它把从各处读到的信息重新组织、写成的连贯段落,并给每处结论标上来源。这意味着它频繁地要"抽取"你内容里的具体事实——某个数据、某条结论、某个适用条件——把它们揉进自己的叙述里。你那些关键事实如果写得清晰、自足、带出处、结构规整,抽取就不容易出错;如果含糊其辞、条件藏得深、数据没有明确表述,它要么抽错、要么绕开你换一家。所以为深度研究准备的内容,要专门优化"可被准确抽取":把重要数据用明确的文字写出来、给结论就近附上依据和前提、把对比和参数做成规整结构。一句话,你写得不光要人能读懂,更要一台正在赶写综述的机器能一眼抓准、直接搬用。可摘可引,是决定"报告里那句关于你的话,准不准"的关键。
六、完整性:报告里缺的那块,往往是你的短板
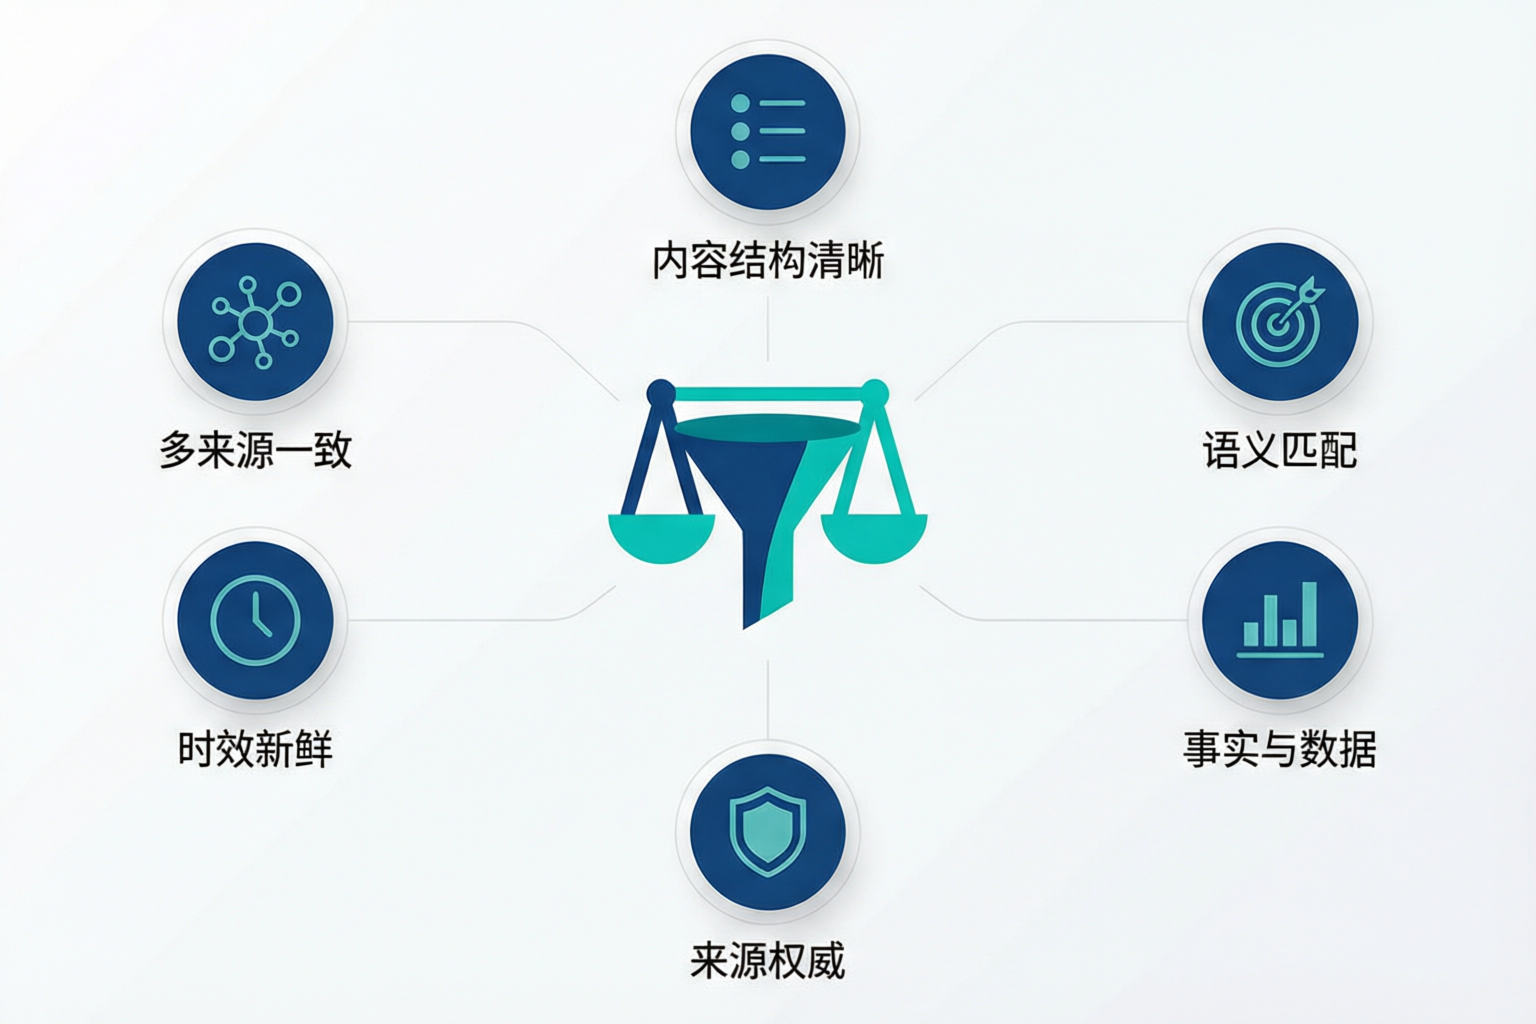
一份深度研究报告追求把一个课题讲全。当它研究到你时,理想状态是:它需要的每个维度——你是谁、主打什么、核心参数、价格、适用场景、和别家怎么比、有什么限制——都能从你的权威内容里找齐。可现实中,很多品牌在某一两个维度上是空的:价格不敢写、对比页没有、限制条件从没说清。这些空白,Deep Research 不会替你留白,它会去别处补——补进来的往往不是你想让它说的话。所以做这条通道的内容,一个务实的方法是拿"研究报告会覆盖哪些维度"当清单,逐项自问:这一项,我有没有一份官方、准确、可引用的内容?没有的,正是你交给竞争对手和第三方去定义你的缺口。把维度的完整性补齐,就是把"报告里关于你的叙述"的主导权,抢回自己手里。
七、时效:一份长报告会把你过时的信息"存档"很久
深度研究产出的不是一次性的答案,而是会被下载、被转发、被拿去汇报的成型文档。这带来一个被低估的风险:一旦它引用的关于你的信息是过时的——旧价格、旧参数、已经不存在的政策——这份错误不会像搜索快照那样很快过去,它会作为一种"权威结论"长期流传。更麻烦的是,模型现查时若捞到的仍是你那份没更新的旧内容,它还会在一份份新报告里持续把旧的写进去。所以时效在深度研究这条通道上权重更高:核心事实务必当前、变动快的信息放在能随时同步的权威页、过期页要么下线要么明确标注。发布重要更新后,要确保能被检索到的最新版是"当前"那一份,而不是旧版霸屏。别让一份会被传很久的报告,替你反复传播一个早已作废的版本。
八、权威与可信:它更倾向采信"像一手来源"的页面
写进报告的内容要有依据,Deep Research 会本能地偏向引用那些看起来权威的来源:品牌官方页、有署名有资质的一手材料、被多方交叉印证的数据,比来路不明、充满营销腔、又拿不出依据的页面,更容易被它当真并写进正文。这也呼应了 Google 一贯看重的经验、专业、权威那套信号。你要做的,是在内容里把"凭什么信你"这件事做实:亮明主体身份、给出可核对的数据与出处、把资质和背景交代清楚、用词专业而不夸张。越是深度研究,越经得起、也越依赖这种可核验的权威感。反过来,浮夸、绝对化、经不起追问的表述,在这种"多方比对、交叉印证"的过程里最容易被识破、被丢弃。把自己做成这个课题上"最像一手、最拿得准"的那个来源,是赢得深度研究引用的底层优势。
九、多份来源会互相印证:口径一致在这里被集中检验
深度研究的看家本领,是同时翻很多来源、交叉比对。这等于给你的"全局一致性"来了一场突击大考:它会把你的官网、你的第三方介绍、你不同时期的文章放在一起对照。只要各处口径对不上——同一参数两个值、新旧政策并存、官方和分发阵地各说各话——它不仅可能因此降低对你的信任,还会把矛盾直接写进报告,提醒用户"这里说法不一"。平时你分散经营、不易被一次看到的漏洞,在一份系统性比对里会被集中揪出来。所以趁早把一致性建起来:一份母本、多处派生,所有对外入口的关键事实同源、当前、不打架。一致性在这种通道上不是锦上添花,而是决定"你整体可信度评分"的硬指标。经得起交叉印证的品牌,才配被深度研究放心引用。
十、把它变优势:主动供给"研究报告友好"的权威内容
与其被动担心,不如主动为这条通道备料。一个高效做法,是产出那种"天生适合被深度研究引用"的内容:结构清晰、把一个话题讲全讲透、数据可核对、对比客观、限制条件也如实写——比如一份权威的品类选型指南、一份诚实的横向对比、一份带完整参数和场景说明的产品资料。这类内容不仅用户爱看,正是 Deep Research 赶写报告时最想抓的素材,你主动把权威版本立起来,它就更有理由引你、而不是去引一个讲歪你的第三方。同时别忘了把 FAQ、术语解释、公开可访问的数据页铺到位——这些都是它做子课题时的高频落点。把"希望被怎么写进报告",提前自己写成一个权威范本,是这条通道最聪明的主动经营。
十一、竞品与空白地带:报告里没人替你说话的地方最危险
深度研究尤其偏爱"比较类"课题——它常被人用来问"X 品类里各方案怎么选"。这类研究里,如果你在某几个被反复比较的维度上没内容,报告就会用竞品或第三方的说法填满那部分,等于在你的直接对比场合里,由别人来陈述你的位置和短板。这是最该主动补的空白:把你的选型逻辑、和主流方案的客观差异、各自的适用与不适用,用你自己的权威内容讲清楚——诚实、带条件、不贬低对手,但把事实说全。你越是在这些高意图的比较场景里有据、有结构、可引用,就越能在"替用户做决定的报告"里,守住关于自己的话语权。空白不是中性,空白就是把定义你的权力拱手让人。
十二、这条通道怎么验证:真跑一个课题,看报告里你怎么被写
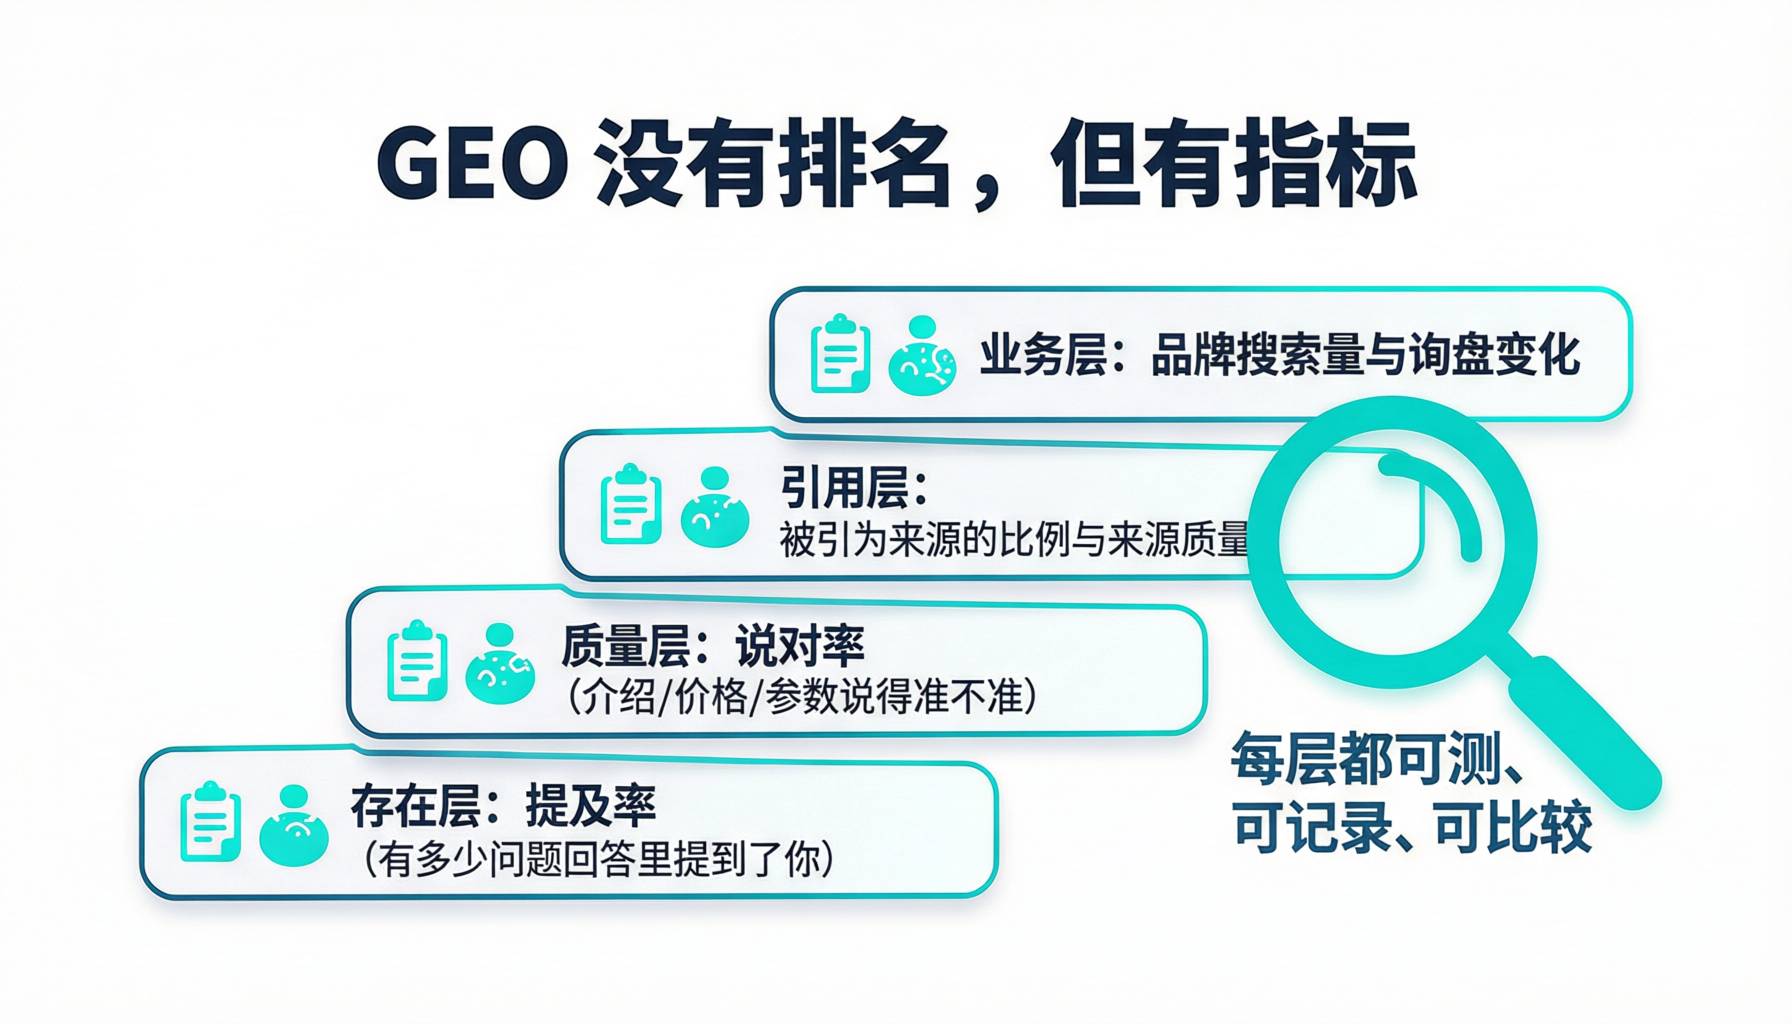
回测 Deep Research,最实在的就是自己当一回用户。挑几个你最在意、又最可能被深度研究的课题——通常是选型、对比、行业综述类——真的丢给 Deep Research 跑一遍,等它出报告,然后逐段审:报告里有没有你、你在里面的形象准不准、引用的是不是你想要的权威来源、有没有把你写错或用了过时信息、竞品被写的维度你有没有对应的内容。这份报告会非常直观地暴露你在整个领域的"内容地形"哪里有、哪里塌。测出来的缺口,就是你的补内容清单——哪个维度空白补哪个,哪处过时刷哪处,哪个第三方讲歪就去盖。因为报告是长文的、可下载的,建议你把它连同一批标准课题定期重跑,把它当成一面照"你在深度研究里到底是谁"的镜子。能被一份成型报告准确、完整地写进去,是这条通道真正的及格线。
十三、常见误区
几条要提前避开的。
- "问答里能引我,报告里自然也引我。"深度研究翻得又广又深、又看重完整与权威,门槛高得多。薄页、缺维度、过时、经不起比对的内容,在这里会被直接跳过或写错。
- "报告太长,反正没人细看。"恰恰相反,成型报告会被下载、转发、拿去汇报,一旦里面关于你写歪或写旧,它作为"权威结论"的流传力和杀伤力都远大于一次搜索。
- "缺的维度无所谓。"报告要讲全,你不填的维度它一定找别人填,往往填的还是竞品或第三方对你的说法。
- "先把话说得越满越好。"深度研究会交叉印证,浮夸、绝对、经不起追问的表述最容易被识破丢弃,可核对、带条件才吃香。
十四、落地自查
动手前后照这几条过一遍。一是课题清单自查:列出三到五个用户最可能让 Deep Research 就你所在领域发起的课题,尤其选型和对比类。二是维度覆盖自查:对每个课题,把报告会触及的维度摊开——身份、参数、价格、场景、对比、限制——逐项看你有没有一份权威、当前、可引用的内容顶着,标出空白。三是可引用质量自查:抽查核心页,确认结构清晰、数据明确可核对、条件写全、来源亮明,能被机器准确摘取。四是一致与时效自查:把会被交叉比对的各处入口对齐到同一份母本,过期内容刷新或下线,别让矛盾和旧版进了报告。把这四件做扎实,你才不是被动地"被研究",而是主动地把一份准确、完整、可信的自己,交到那份报告手里。
十五、写在最后
Deep Research 标志着检索的一个转向:AI 不再只是"回答你的问题",而开始"替你完成一项研究"。当用户越来越多地靠一份份 AI 生成的研究报告来了解一个领域、做出决策,你能不能被准确、完整、体面地写进那些报告,就变成了一个比"多一次点击"更根本的命题。好消息是,这条高杠杆通道没有捷径也没有玄学,全是硬功夫:把内容做厚做全、把可发现性铺到位、把数据写清楚可核对、把时效和一致性守住、把比较维度的空白主动补上。做到这些,Deep Research 翻得越广越深,反而越是在为你背书——因为它会把最扎实、最权威的那份你,稳稳收进每一份认真研究你所在领域的报告里。让 AI 替你写研究之前,先让它有值得引用的东西可写。
关于墨子学院:墨子学院(武汉墨子教育咨询有限公司,成立于2014年,曾用品牌"百墨生"),自2022年起投入GEO,研究品牌在生成式检索与大模型平台里如何被准确认知、稳定引用。本文是 Gemini / Google GEO 系列的延伸篇。可参考 /mall/ 上的 GEO 课程。