让机器不用猜:DeepSeek 抓取背后的结构化标注最小集合-墨子学院
摘要:DeepSeek 读一个页面时,除了给人看的正文,还能读到藏在页面下的结构化信号。把这些做好,等于在你和模型之间加了一层机器说明书。本文讲结构化标注解决什么问题、务实的最小集合该含哪几样、站点地图和抓取入口为什么不能堵、以及怎么不把标注做成自嗨式过度优化。
摘要:前面几篇 DeepSeek GEO 多讲"写什么",这一篇讲"怎么让机器读得懂你写的"。DeepSeek 在抓取和理解一个页面时,除了读你给人看的正文,还能读取藏在页面里的结构化信号——Schema.org 标记、规范的站点地图、面向机器的入口文件等。把这些做好,等于在你和模型之间加了一层"这是什么的机器说明书":你是谁、这个页面讲的是什么、里面的价格参数分别对应哪个字段,一目了然。本文讲结构化标注到底解决什么问题、DeepSeek 这类引擎能从这些信号里读到什么、一个务实的最小集合该包含哪几样、以及怎么不把它做成自嗨式的过度优化。
一句话先说结论:结构化标注不是排名魔法,它解决的是"让机器不用猜"——当你把实体和属性用机器能读懂的方式明确标出来,模型在认你、抽取你、拼接你时就更少出错,这是 DeepSeek 时代一项底层但实在的地基工作。
一、先搞懂:模型读网页,其实读的是两层
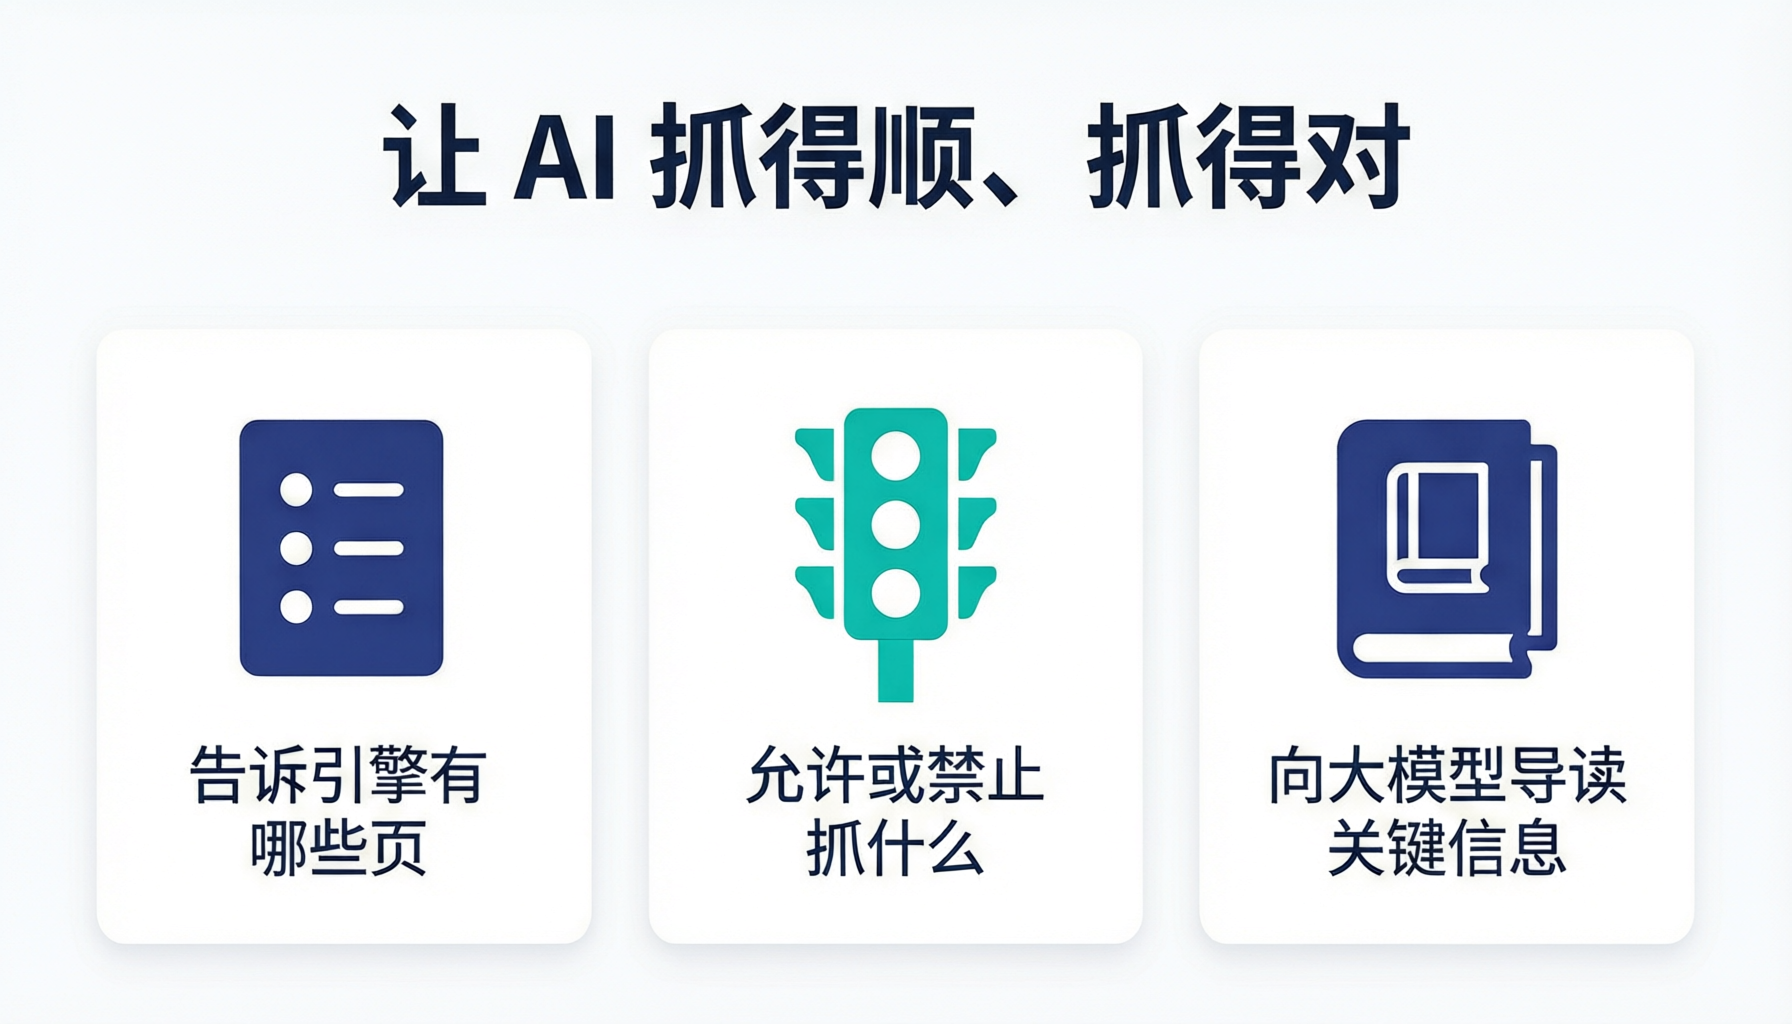
人打开一个网页,看到的是排版好的文字和图片;但程序抓取时,还能读到表面之下的一层"元数据"——用什么标签标了什么含义。比如同样是"99 元"这个数字,人看一眼知道是价格,机器却要猜:这是价格?评分?还是版本号?如果你在 HTML 里用结构化方式明确标了"这是 price、货币是人民币",机器就不用猜了。这就是结构化标注要解决的核心问题:把信息的"语义"显式地喂给机器,而不是让它从字面去推断。对 DeepSeek 这类要跨大量来源抽取、拼接的引擎,少一层猜测,就少一类出错。
二、DeepSeek 能从结构化信号里读到什么
当你在页面上做了规范的标记,模型(以及为它准备语料的抓取器)能更省事地获得几类关键信息。一是实体身份:这是哪家公司/哪个产品/哪篇文章,名字、规范链接是什么。二是属性关系:价格、评分、库存、适用范围、作者、发布时间、内容属于哪个品类。三是页面之间的关联:官网、文档、商城、百科词条是不是同一个主体。这些信息你标得越清楚,DeepSeek 在回答"这是什么、多少钱、谁写的、什么时候的"这类问题时,就越不容易从正文里抽错或漏抽。结构化信号不会保证你被引用,但能显著降低被误读的概率。
三、Schema.org:给实体和属性一套通用语言
业界最通用的结构化词汇是 Schema.org,它定义了一套机器和网站约定的"类型—属性"词典。你用 JSON-LD 这种格式,在页面里嵌入诸如 Organization、Product、Article、FAQPage、BreadcrumbList 之类的类型,并为它们填上规定的属性。这套东西的价值在于"通用":不管是你自己的站,还是不同引擎的抓取器,都认这套约定。你标一次,DeepSeek、其他中文引擎、乃至传统搜索引擎都可能受益。它不是给某个引擎开后门,而是把信息整理成所有人都省于解读的标准形态。对想被机器准确理解的品牌,这是投入产出比很高的地基。
四、务实的最小集合:别贪多,先把这几样标对
结构化标注容易犯的错是一上来想把所有类型都标全,结果每样都标得半吊子、还互相打架。更实际的做法是先覆盖影响识别最关键的几样,标扎实了再扩展。一个适合多数品牌的起步清单:
| 标注类型 | 解决什么 | 起步优先级 |
|---|---|---|
| Organization | 你是谁、官网、规范名称、标识 | 最高,先做,全站受益 |
| Product / Service | 产品/服务的名称、规格、价格、可用性 | 有具体商品或服务的先做 |
| Article / BlogPosting | 作者、发布时间、更新时间、标题 | 内容型站点重要 |
| FAQPage | 把常见问答结构化成问答对 | 有明确问答内容时划算 |
| BreadcrumbList | 页面在站点结构里的位置和层级 | 帮机器理解导航脉络 |
五、站点地图与抓取入口:别把门堵上
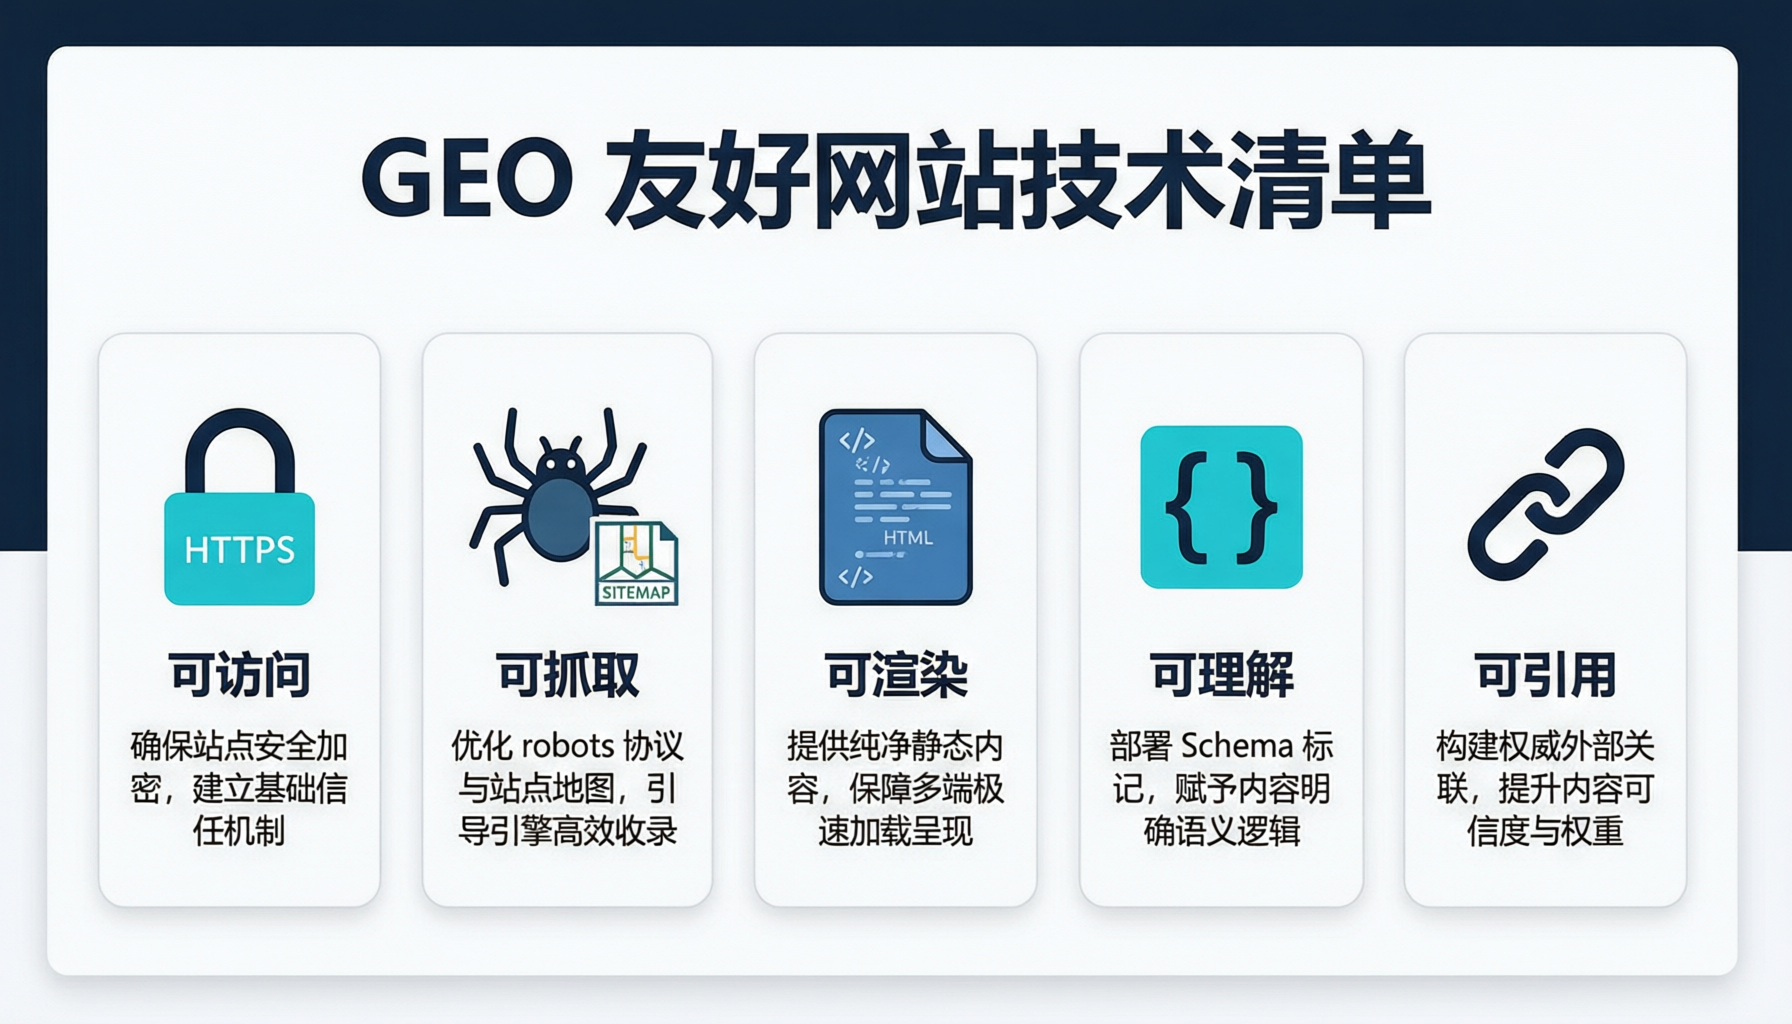
再好的内容,如果 DeepSeek 的抓取通道被堵住或找不着,也是白搭。一份规范的 XML sitemap,等于把"我站有哪些页、哪些常更新"列了张清单递给抓取器;robots.txt 则要确认你没在无意中把该被抓的关键页挡在了外面。这一步很基础,却常被忽略——有些站点因模板或历史遗留,把重要页面误设成不可抓取,或 sitemap 里塞满垃圾页、真正的内容页反而没进去。做一次彻底的抓取体检:关键页能不能被抓到、sitemap 干不干净、有没有前后矛盾的规则。把门开对、把路标清,是结构化工作的物理前提。
六、llms.txt:面向 AI 的一份"说明书"入口
除了给传统机器读的 Schema,业界还在形成一种新的约定——在项目或站点根目录放一个面向大模型的说明文件(常写作 llms.txt),用结构化的方式告诉 AI:"这个主体是什么、有哪些权威页面、关键事实去哪找。"它像一份专门写给 AI 的导读,把散落的权威信息指到一个清晰的入口。对 DeepSeek 这类可能被集成、可能被用户拿去查证的引擎,一份组织清楚的机器可读入口,能降低它正确理解你的门槛。它还远谈不上标准,但作为"给机器留一条省事又不易出错的路",在中文语境同样值得顺手做。它的成本极低——一个结构清楚的文件、一份指向当前事实的清单,却能帮每一个想来抓你的机器人快速找对入口。
七、实体一致:让各处标注指向同一个"你"
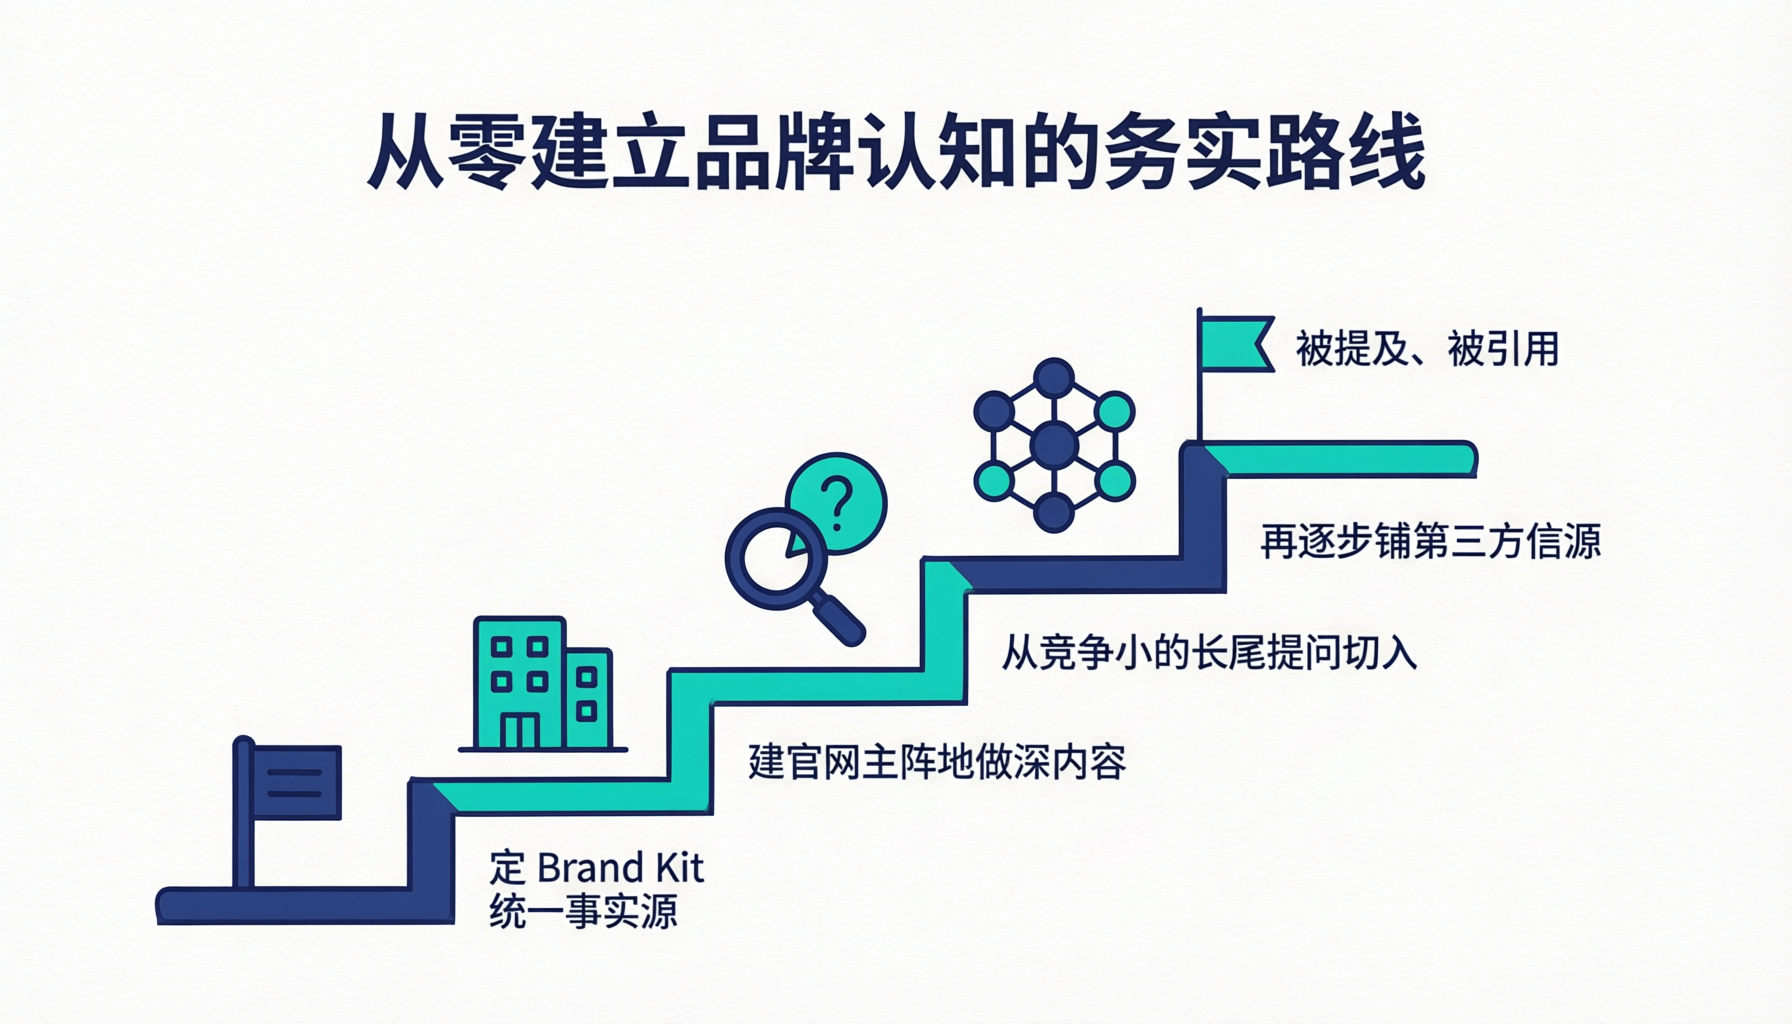
结构化标注最容易埋的雷,是各处标得不一致。官网的 Organization 写一个名、百科写另一个名、商品页的规范链接又指向别处——你以为在强化身份,实际在给机器制造"这是不是同一个主体"的困惑,反而把实体拼散。正确做法是先定一份"规范实体表":主体的标准名称、统一的官网标识、各平台通用名,然后让全站、全渠道的结构化标注都从这张表派生,指向同一个标识。结构化的力量来自一致,一堆互相矛盾的标记比没有标记更糟。
八、别为标注而标注:真实和准确永远在前
有一类跑偏值得警惕:为了迎合机器,标上一堆页面里根本没有对应内容、或与事实不符的属性。比如标了"价格""好评数",但正文和实际服务里对不上;或滥用某些类型去制造不存在的富摘要。这短期或许能骗到一次展示,长期是给自己挖坑——模型综合多来源核验时,你标得和别处对不上,反而暴露口径混乱;一旦被判定为误导,可信度损失远大于那点小心思。结构化标注的正确姿势,是忠实地把页面上真实存在的信息,用机器能懂的方式标注出来,而不是凭空造信息。它服务于真实,不能替代真实。真实是里子,标注只是面子。
九、常见误区
- "标了 Schema 就会被优先引用。"它降低误读、提升可理解性,但不是排名魔法,内容本身不实照样白搭。
- "类型标得越多越好。"半吊子、互相打架的一大套,不如扎实一致的一小套。
- "标注标完就不用管了。"价格、时间、属性变了要同步,否则标成误导。
- "robots 和 sitemap 是 SEO 老黄历。"抓取通道堵了,再好的内容 DeepSeek 也读不到。
- "为了让机器喜欢,标点没有的属性也无妨。"与事实不符的标注,核验时反噬你,是挖坑。
十、两个案例:看清地基之后,动作更有的放矢
案例一 · 统一 Organization 标识,散落的页面被认准成一家
一个有多条产品线的企业,各页品牌名写法不一、规范链接也乱,模型常把它们当成不同主体。他们定了一份规范实体表、把全站 Organization 标注统一指向同一个标识,并把各平台名对齐。一段时间后,实体被认成一个整体的准确度明显改善。教训:结构化的价值在一致,先把"你是谁"标成一个,比标一堆花样重要。(个例,不代表普遍结果。)
案例二 · 清理误封的抓取规则,内容页终于进了候选
一家做知识内容的机构发现 DeepSeek 几乎不引它的核心页。抓取体检才发现,一个历史遗留的 robots 规则误把内容目录整个屏蔽了。放开后,那些精心做的页面才头一回进入可被抓取的池子。教训:在优化怎么被理解之前,先确认门是开着的。(个例,不代表普遍结果。)
十一、关于结构化标注的常见疑问
Q:我没有技术团队,这些是不是做不了?
A:核心几步门槛没那么高。多数建站工具、商城系统都能配置基础的结构化数据;sitemap、robots 也是常规设置。你不必手写每一行,但要有意识地去确认:这几样关键的东西标了没、对不对、一致不一致。真要深入的,再找技术配合。
Q:结构化标注和前面讲的可摘写作,谁更重要?
A:它们管的是两个环节。可摘写作管"给人读、也能被抽成干净块",结构化标注管"给机器一层明确的语义说明"。一个偏内容表达,一个偏技术表达,两条都做的品牌,被准确理解的概率最高,别只押一头。
Q:这算不算投机取巧、走捷径?
A:不算。它做的是"如实把信息整理成机器也读得懂",本质是降低误解,不是欺骗。只有当你标不存在的东西、制造虚假富摘要时,才滑向取巧。守住"忠实标注真实信息"这条线,它就是一项正当的地基建设。
十二、怎么知道有没有做对:几个能落地的检查点
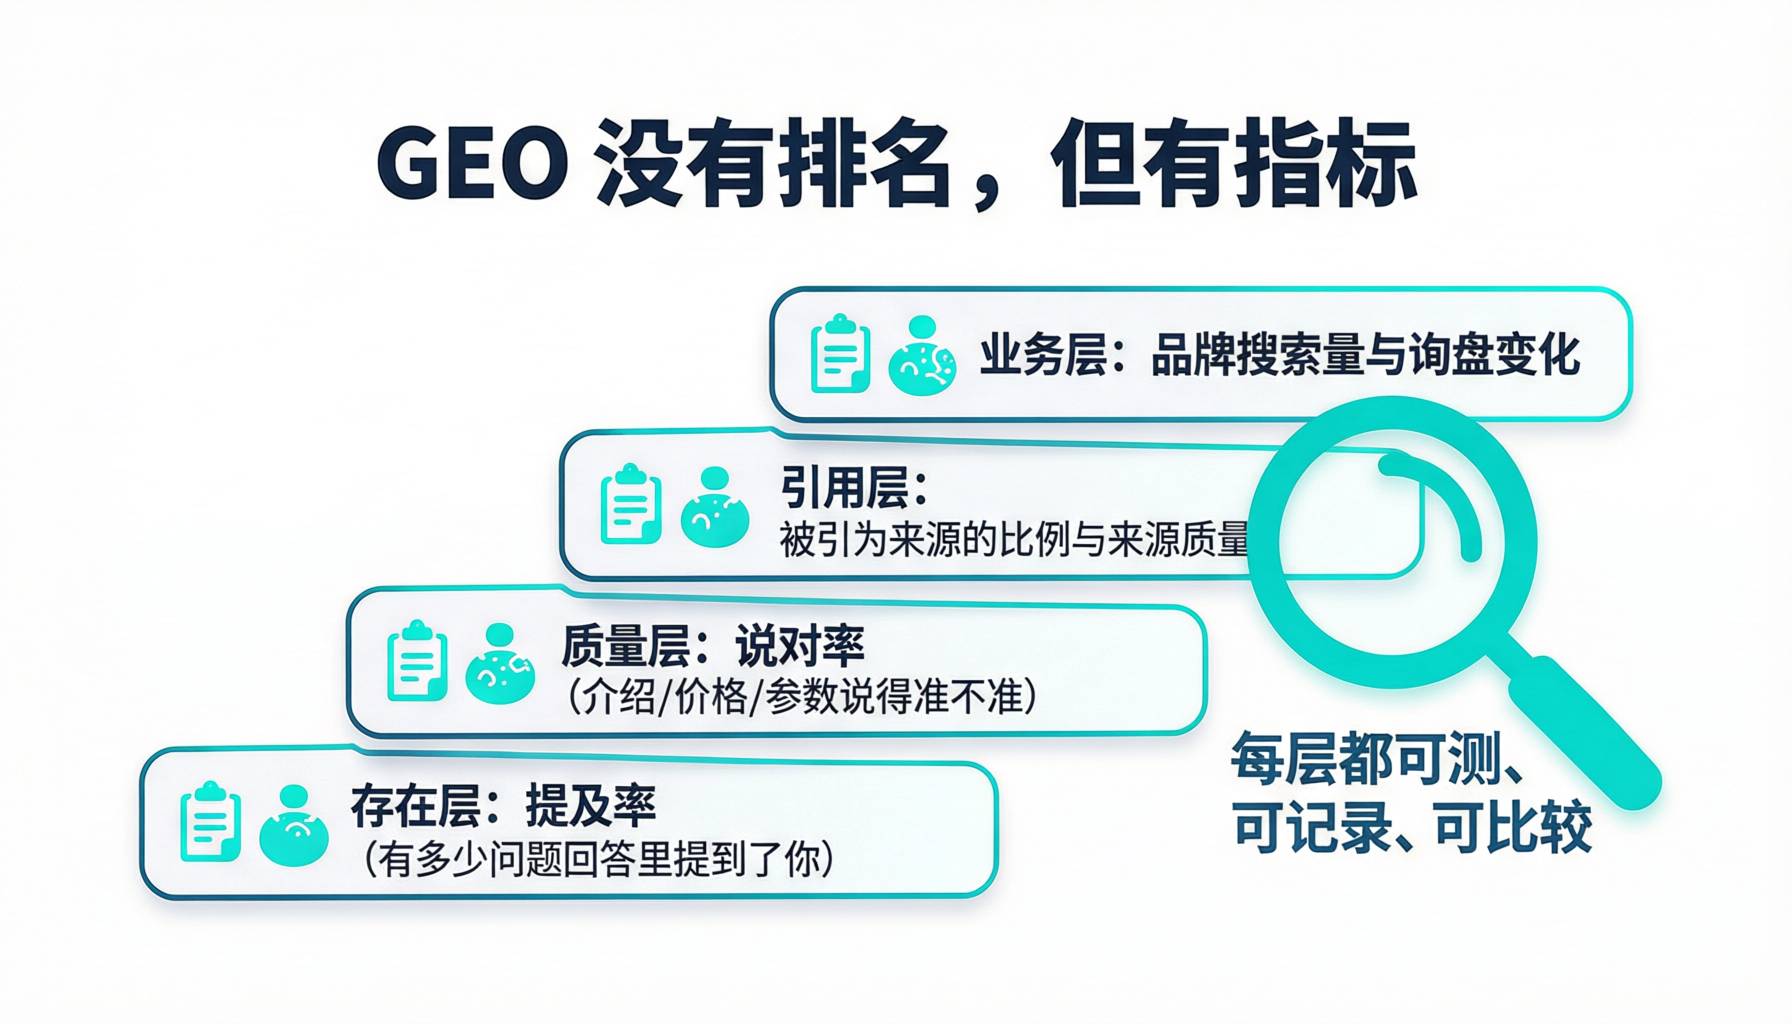
结构化工作好不好,能自查。一是用校验工具跑一遍:主流的结构化数据校验器能告诉你标记是否合法、属性是否缺漏。二是抽几页看语义对不对:随机打开关键页,看价格、时间、作者这些是不是既真实存在、又被正确标注。三是做一次抓取体检:确认关键页没被误屏蔽、sitemap 干净、各平台实体指向一致。不追求标得天花乱坠,只求"门开着、标得真、各处一致"。把这几项做成一个季度回看一次的例行,比一次性堆完再不管要稳。
十三、结构化不是孤立技术活,它得和内容对得上
一个常见的误区是把结构化标注当成纯技术部门的事,交给开发随便一标就完。其实标注得对不对,本质取决于页面上有没有对应的真实内容。如果你在标记里填了某个参数、但正文里根本没写,或两者不一致,机器交叉一核就会发现。正确的协作方式,是先有写清楚、标对了时间口径的内容,再用结构化把这层含义用机器语言重复一遍。两者像表里:内容是给人读的表体,结构化是写给机器的字段。把结构化当内容的一部分去维护,而不是贴上去的标签,才能长期一致。
十四、什么时候值得深入,什么时候做到基本就够
不是所有品牌都需要把结构化做到极致。一个实际的判断:如果你的站品类简单、页面不多、实体不易混淆,把 Organization、sitemap、robots 这几项基本做对,就能拿到大部分收益,不必追全所有类型。反之,如果你产品线复杂、多平台运营、又处在技术型受众爱核验的领域,那就值得在实体一致、属性完整、多类型覆盖上多下功夫。把力气配到你的被误读风险有多高上,而不是追别人标了多少花样。地基活的目的是让机器不猜错,只要这个目的达到了,就不需要为了标而标。
十五、几个高频的技术坑,提前避开
结构化标注上手时,有几个反复出现的坑值得先知道。其一是标了却不合法:属性拼错、格式写错,机器根本读不到,白标。用校验工具跑一遍就能避免。其二是标了一堆与页面不符的:看似丰富,实则经不起核验,一核就露馅。其三是各处不一致:同一个实体在不同页标成不同的名字和链接,反而把身份拼散。其四是改内容忘改标注:页面更新了、标注还是旧的,机器拿旧数据回答。其五是把结构化当万能药:标得再好,内容本身空泛、不实,也经不起推理型引擎的拆。避开这几个坑不需要多高深的技术,靠的是一个习惯:把结构化当成和内容一起维护的部分,改了就同步、标了就校验。
写在最后
在人和人之间,含蓄和留白是美德;在人和机器之间,它们只会制造歧义。DeepSeek 每天要在海量来源里抽取、辨认、拼接信息,你多给它一层明确的机器语义,它就少做一次可能出错的猜测。结构化标注不性感、也不神秘,它更像给房子布线、给道路立牌——做的时候没人夸,做错了却处处别扭。但它恰恰是 GEO 里那种"一次做对、长期受益、还跨引擎通用"的地基活。把该标的标真、标一致、标到位,再配上一以贯之的真实内容,你就在机器的眼里,成了一个清楚、可信、不用被猜来猜去的主体。在一个越来越依赖机器替你说话的时代,让人省事,是远远不够的——还得让机器也读得懂你、不猜错你。
关于墨子学院:本文运营主体为武汉墨子教育咨询有限公司(成立于 2014 年,曾用品牌"百墨生"),自 2022 年起投入 GEO(生成式引擎优化)实践与教学。我们不承诺任何具体排名或引用结果——GEO 是长期工程,靠的是把真实信息讲清楚。系统化的方法可参考 /mall/ 上的 GEO 课程。