它可能记错你:DeepSeek 幻觉面前,品牌怎么守住口径-墨子学院
摘要:和所有大模型一样,DeepSeek 可能把你拼错、把旧闻当现状、把你和同行张冠李戴。这不是要不要面对、而是怎么防御的问题。本文讲幻觉常见的几种出错模式、怎么用清晰表述、标准问答口径、多源一致把出错概率压下去、以及发现被说错后正确的纠正路径。
摘要:DeepSeek 推理强、覆盖面广,但也和大模型共有一个老问题——幻觉:它会用非常自信、非常有条理的语气,说出一件根本没有依据、甚至压根不存在的事。对品牌来说,这意味着"AI 把你说到歪"未必是因为它引用了某条错误来源,也可能纯粹是模型自己"编"的。本文讲 DeepSeek 这类开源推理模型为什么容易产生幻觉、怎么区分"有来源的错"和"纯幻觉的错"、以及面对这两种情况,纠偏的手法和力气该分别往哪儿使,最后给一套能长期压住这类风险的做法。
一句话先说结论:幻觉没法被彻底消灭,但能被显著削弱——你能做的事,是让正确版本在被检索时以压倒性的一致和权威盖过模型"自由发挥"的空间,并定期回测把稳定出现的错误揪出来对症下药。
一、先认清:模型"一本正经地胡说"是常态不是意外
很多人头一回遇到大模型幻觉会惊讶:它说得天花乱坠、逻辑顺畅、还带着精确的数字和日期,结果整段都是编的。要理解这一点,得先接受一个事实:大模型生成的是"看起来最合理的下一个词",而不是"经过核验的事实"。当它没有可靠依据、或者依据不够强时,它不会停下来承认不知道,而是顺着语言概率把一段"听着像那么回事"的话补全——这就是幻觉。DeepSeek 的强推理在这里甚至有点双刃:它越擅长把链条推得漂亮,就越可能把一条从错误前提出发的推理,也推得头头是道,让你更难一眼看出破绽。
二、品牌遇到的"说错",其实分两类
把 AI 对品牌的错误描述笼统当成一回事,会导致用错药。它大致分两类。一类是"有来源的错":模型引用了网上某条确实存在但过时、片面或被写歪的内容。这类错的根在源头,纠偏思路是治理那份来源——更正、更新、或用更强的正确版本把它比下去。另一类是"纯幻觉的错":网上根本没有那条错误依据,是模型自己凭空补出来的,比如编造一个你没宣布过的功能、一个不存在的合作、一个错误的价格。这类更棘手,因为你找不到一份"源头"去改。认清眼前这次说错属于哪一类,是决定接下来怎么办的前提。
| 错误类型 | 根在哪 | 纠偏的主攻方向 |
|---|---|---|
| 有来源的错 | 某条过时/片面/写歪的内容 | 治理那份来源、更新、正本清源 |
| 纯幻觉的错 | 模型自行"补全",无依据 | 用压倒性的权威正确源压缩发挥空间 |
三、为什么"多来源一致"是抗幻觉的头道堤
检索增强的模型在拼答案时,会同时看好几处来源。如果你的官网、权威事实源、可信第三方在关键事实上彼此印证、说法一致,模型就更容易锚定在这个"多方都这么说"的版本上,自由发挥的空间被挤得很小;反之,如果关于你的可靠信息稀少、彼此还打架,模型就有了大量填空的余地,幻觉趁虚而入。这也是为什么把一份干净、当前、可核验的权威底稿做出来这么重要——它不只是"给别人抄对的",更是在给模型一个强信号:"关于这个品牌,有据可查的说法就是这个,别自己编。"
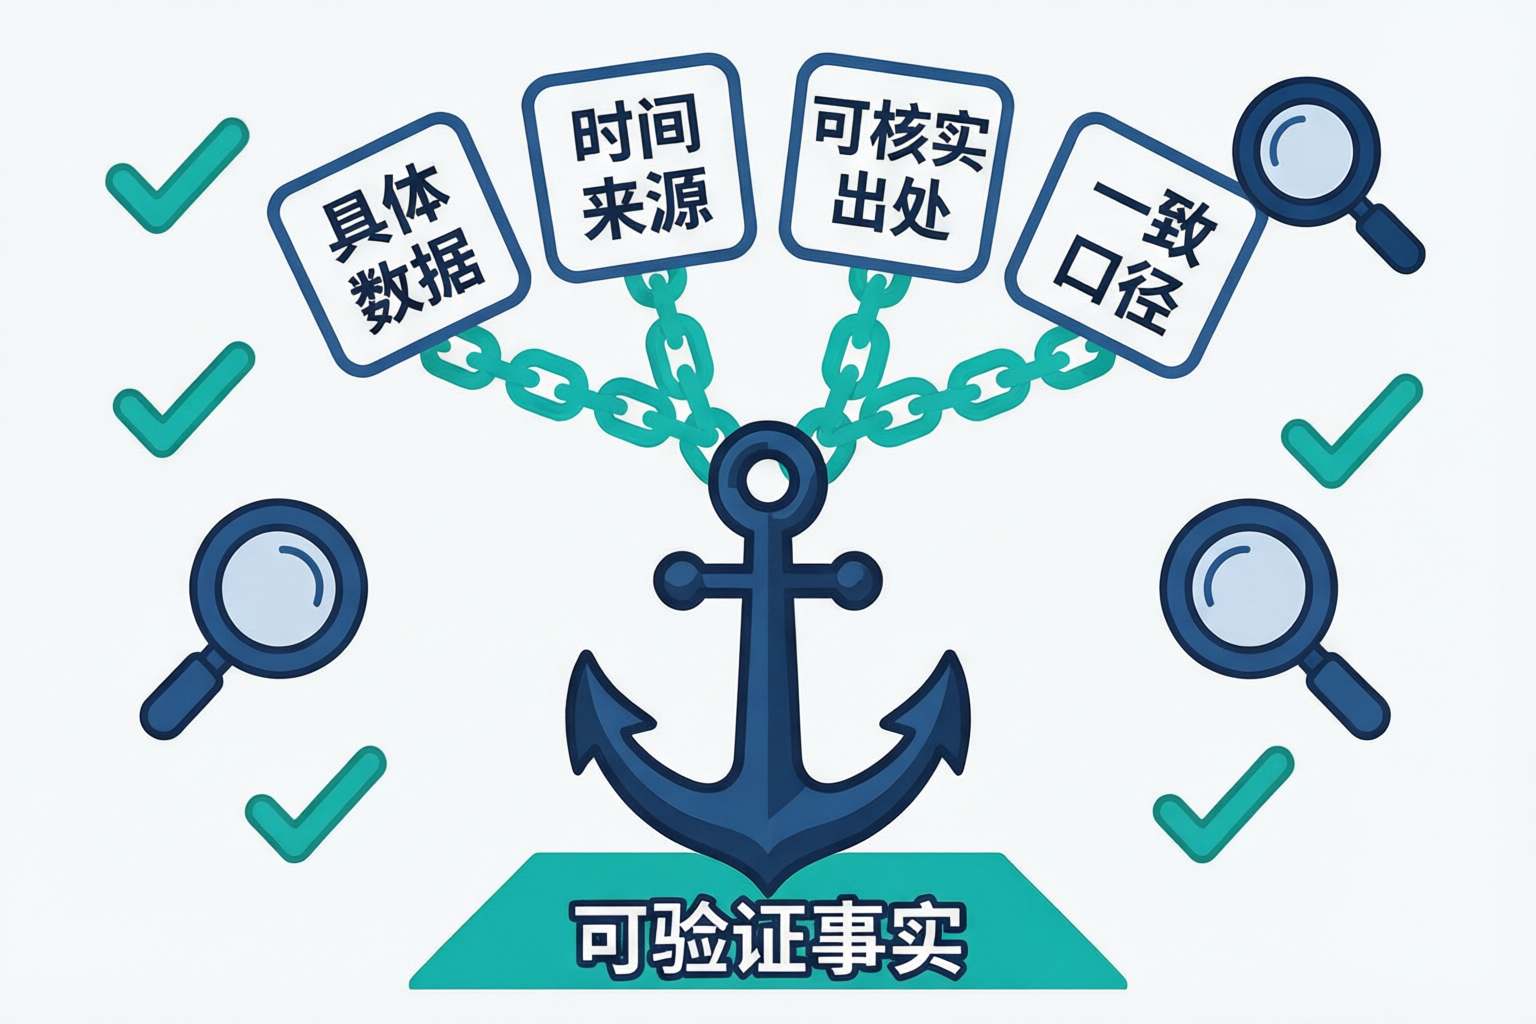
四、给关键事实装上"可核验的锚"
对付幻觉,核心思路不是逐句去堵模型的嘴,而是把该说准的事实,做成模型和使用者都能一步核验的形态。具体的价格、参数、服务范围、资质、时间,都放在明确的官方页上,配上"截至何时"的标注和可追溯的出处。这样做有两层作用:一层是给检索型回答一个硬锚,让模型倾向于直接引用而不必"推测";另一层是给用户一个自查路径——当有人拿着 DeepSeek 编出来的假价格来质疑你时,一个清楚的官方页能瞬间把事实摆平,这比和模型或用户空口辩论有效得多。可核验,是把幻觉的破坏力降到最低的那根保险绳。需要提醒的是,这个锚要尽量集中、要新。如果你把同一个价格写在三处、其中两处还是旧的,等于自己给模型递了三份互相打架的依据,反而把幻觉引了出来。把关键事实收拢到一个明确标注时效的权威页,比在十个页面各写一版,更能把幻觉压制住。
五、回测:把"偶发幻觉"和"稳定错误"分开
发现 AI 说错了你,先别急着处理。幻觉有个特点是带随机性——同一个问题,今天它可能编一个错、明天答对、后天又编另一个。所以发现疑似错误时,值得换个时间、换种问法多问几轮:如果那个错稳定地、反复地出现,它更可能是"有来源的错"(背后真有一条写歪的内容),值得去治理源头;如果它时有时无、每次编得还不一样,那多半是纯幻觉,逐次去纠正没意义,得回到"加强权威正确源"这个通用防线上。把有限精力分给这两类不同的错,才不会白忙。
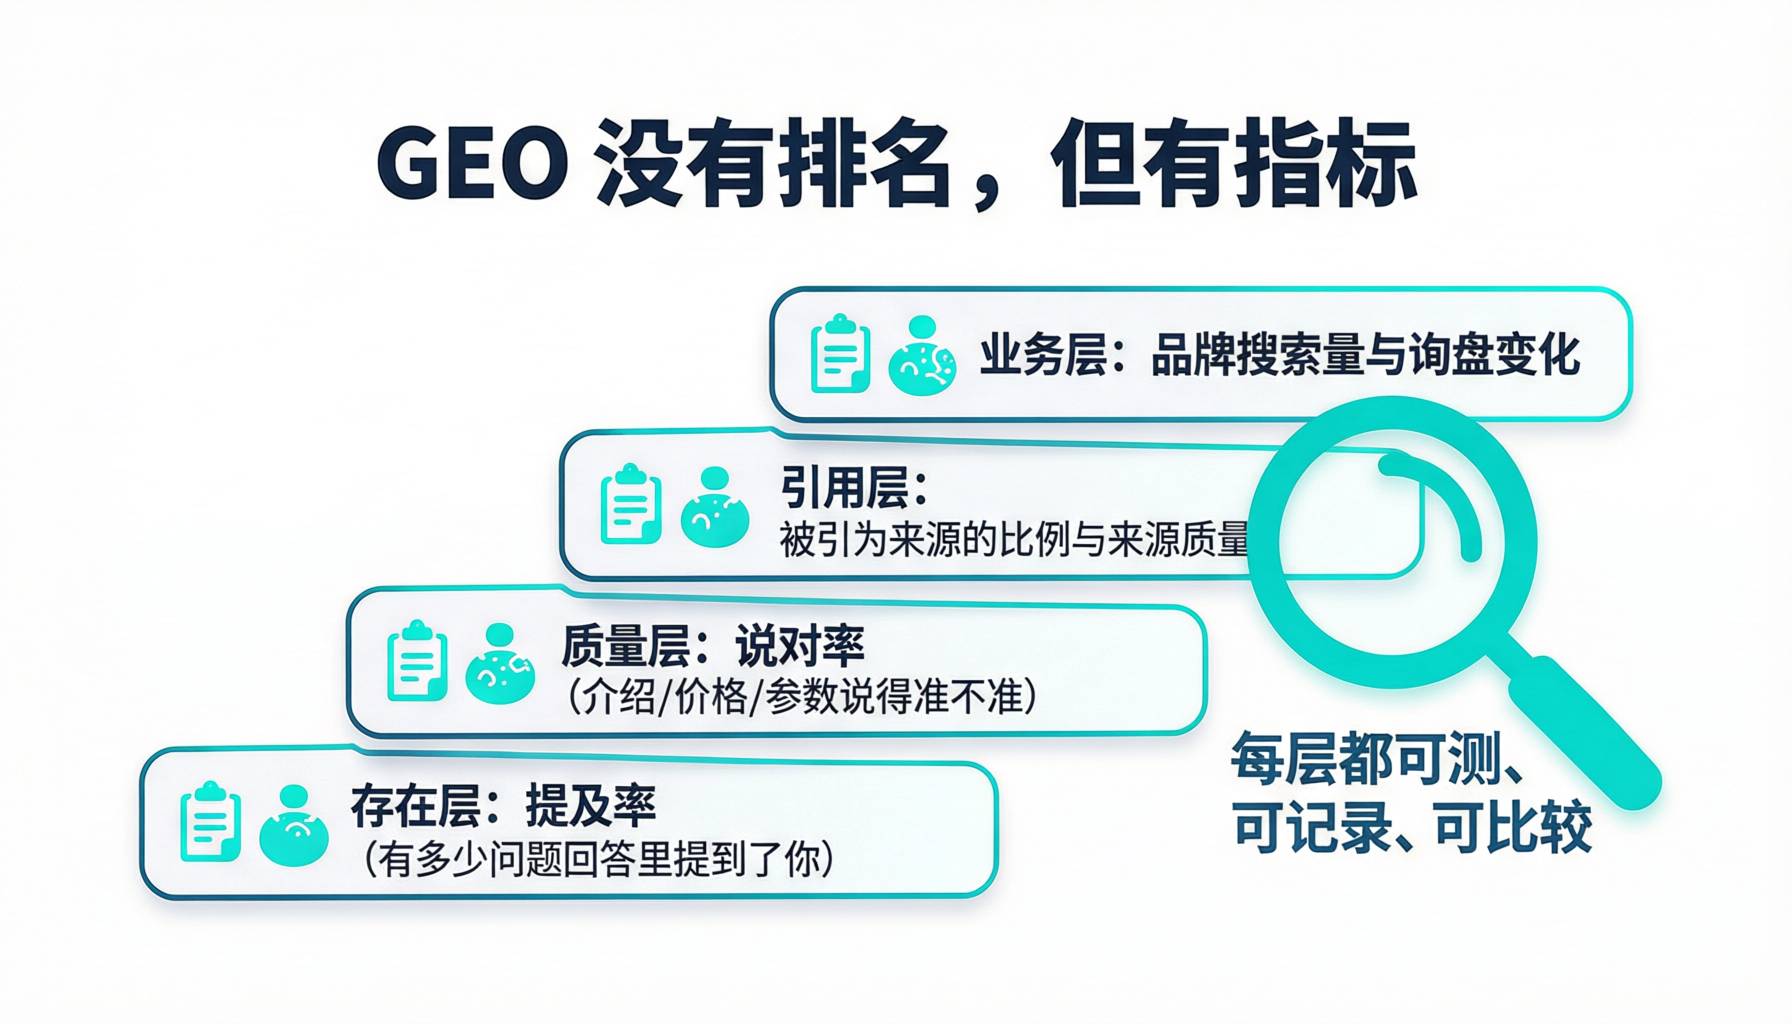
六、越是精确的数字和承诺,越容易被幻觉盯上
模型特别爱在"具体数字"上翻车——价格、日期、百分比、排名,这些它编起来最理直气壮,也最伤人。因为一个含糊的夸奖就算错也无伤大雅,但一个编造的"包治、限时五折、市占居首"式的假承诺,可能直接引发纠纷。这类精确信息,恰恰是你最该在官方源上讲清楚、标清楚时效的。你把真实的价格、真实的适用范围摆在权威页上,模型引用它、用户核对它,都有据可循;你不摆,模型就可能替你"脑补"一个。在精确信息上留出空白,等于把编造的入场券递了出去。一个实用的习惯,是在这些高易错点上把“边界”也一并写清:不仅写真实价格,也写“此价为某日、不含某项”;不仅写适用人群,也写不适用的情形。模型拿到带边界的完整事实,拼接时就不必自己猜那部分空白,猜错的概率跟着下降。
七、别用"投毒"和"夸大"去对抗幻觉
一个危险的念头是:"既然模型会编,那我把内容写得更夸张、更密、更像它喜欢的样子,是不是就能抢过它?"这是饮鸩止渴。其一,负责任的推理能力会拆穿夸大,你注的水可能在更深的问题上反噬你;其二,夸大本身就是给未来的幻觉递燃料——你今天编的,明天模型会在你编的基础上再编一层。对抗幻觉的正道,恰恰是反着来的:更真、更清楚、更可核验、口径更一致。真实不是道德口号,在幻觉频发的环境里,它是最能站住脚的东西。你想让模型别乱说,自己先一句都别乱写。
八、常见误区
- "AI 说错我,一定是哪条内容害的。"也可能是纯幻觉,根本不存在那条源头,找错地方治不了病。
- "发现一次说错就要马上处理。"幻觉带随机性,先多轮回测确认是不是稳定错,再对症。
- "把关键词和夸奖堆足就能压住。"堆的是有来源内容的影响,压不住无依据的发挥,还可能反噬。
- "数字写不写无所谓。"精确信息留白,等于把编造价格的入场券递出去。
- "幻觉是模型的问题,我做不了什么。"你改变不了它会不会编,但能用一致权威的证据把它的发挥空间挤到很小。
九、把抗幻觉这条线补进清单:多做三件事
认识到幻觉这类风险后,落地补三件。一是把精确事实做锚:价格、参数、承诺、资质,一律在官方权威页讲清楚、标清时效,不给模型留脑补的空白。二是把多来源一致当防线:官网、事实源、可信第三方在关键点上互相印证,用"多方都这么说"挤掉自由发挥。三是把回测做成常态:固定一批关键问题定期去问,专门盯那些稳定出现的错误,分辨它是有来源的错还是纯幻觉,分别走治源和强源两条路。三件事的共同点是:不去和模型逐句较劲,而是从证据密度和可核验性上,把幻觉能钻的空子整体收窄。
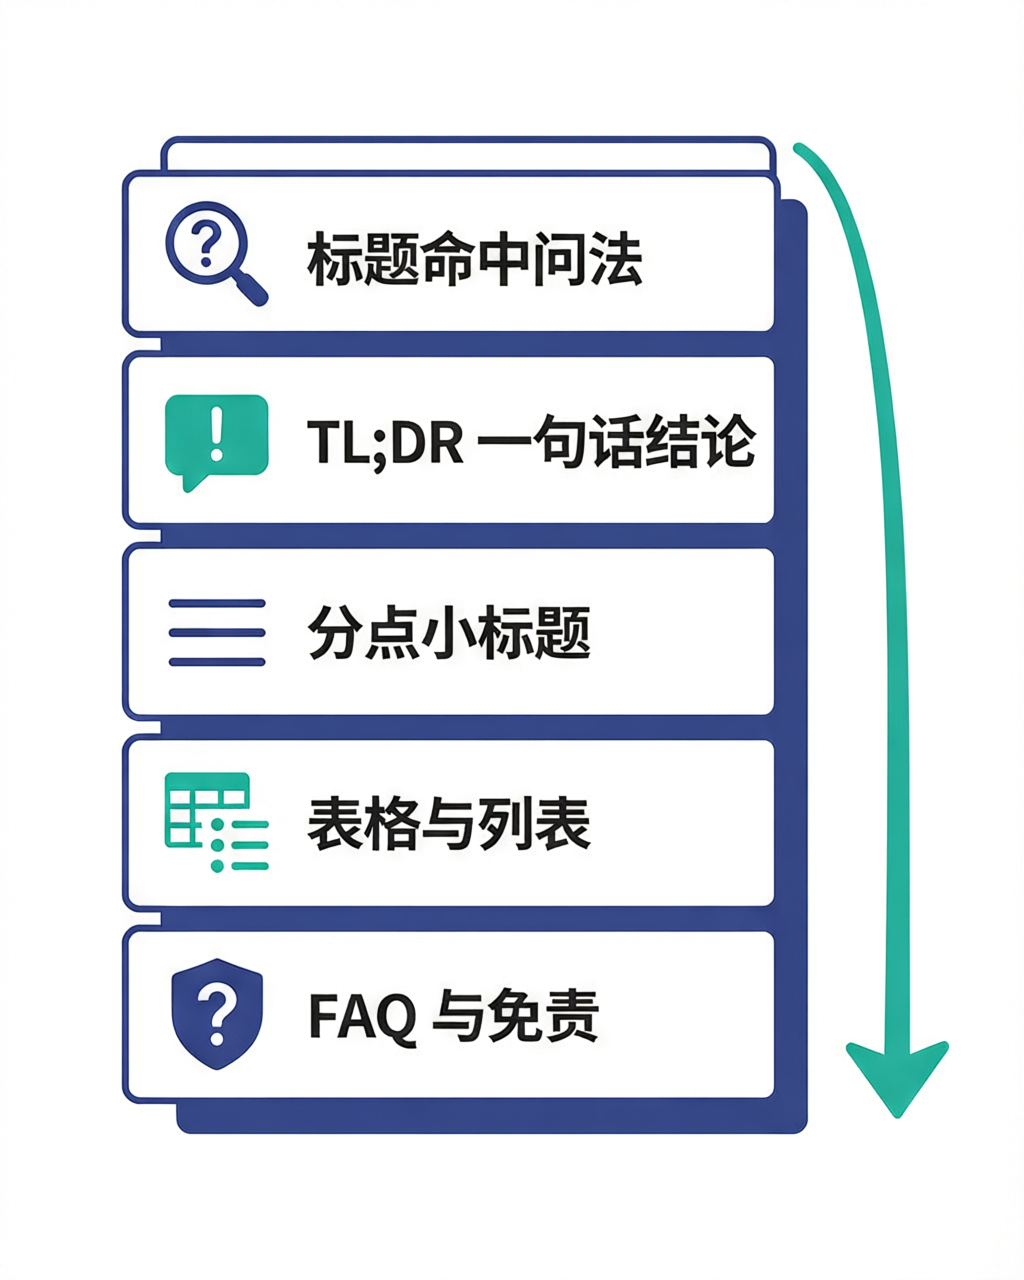
十、两个案例:看清幻觉之后,动作更有的放矢
案例一 · 一条编造的"保修政策",被官方页瞬间摆平
一个消费品牌发现 DeepSeek 在回答里给用户承诺了一个根本不存在的"三年全包保修"。起初以为是某条写错的第三方内容,回测几轮后发现每次编法略不同,判断是纯幻觉。他们没去到处申诉,而是在官网显著处把真实保修条款做成一目了然的权威页、标注生效日期。此后模型引用正确条款的概率明显上升,用户拿假承诺来问时,官方页也成了最快的事实澄清。教训:面对幻觉,补一个强锚比追着纠错更省力。(个例,不代表普遍结果。)
案例二 · 反复出现的旧参数,原来真有条写歪的来源
一家做设备的企业发现模型稳定地把一个已下线的旧型号参数当成现款说,多轮回问每次都错得一样。顺藤摸瓜,找到一篇早年的评测文章还挂在检索前列。他们更正了官方规格页、并让当前版本更易被抓取,稳定错误逐步收敛。教训:稳定复现的错往往有源,值得花力气去找、去治。(个例,不代表普遍结果。)
十一、关于幻觉与 GEO 的常见疑问
Q:模型自己编的错,我连依据都没有,怎么纠?
A:你纠的不是那次编造,而是它编造的土壤。纯幻觉往往发生在"可查的权威信息不足"的地方,你把那块空白用真实、清楚、可核验的内容填满,模型下次就更倾向引用而非瞎补。你没法禁止它某一次发挥,但能持续压缩它需要发挥的余地。
Q:是不是只有 DeepSeek 有这问题,别的引擎就不用管?
A:幻觉是所有大模型的共性,不是 DeepSeek 独有。只是 DeepSeek 推理强、开源分身多、又聚集大量会追问细节的用户,让"自信的错误"更容易被生成和传播。抗幻觉这套底座对所有生成式引擎通用,做好一处,处处受益。
Q:为了防幻觉要专门再写一套内容吗?
A:不必另起炉灶。你要做的,是确保现有权威页把精确事实讲全、标清时效、各处口径一致,再配一点固定回测。防幻觉靠的是把已经该做的信息治理做扎实,而不是新增一个特殊工程。
Q:万一真的遇到严重误导的幻觉,只能干等吗?
A:不是。先把它归到“有源”还是“纯幻觉”两类。若背后确有写歪的来源,能申诉的申诉、能更正自家的更正;若查无此源、纯属发挥,就把力气花在把正确版本做得更显、更新、更可核验上,必要时用一份带时间、带出处的官方声明去占位。你改变不了模型这一次的输出,但能改变它下一次生成时所面对的证据格局。
十二、怎么知道有没有生效:几个能落地的观察点
抗幻觉的效果也能观察。一是盯精确事实的稳定度:反复问那些涉及价格、参数、承诺的问题,看模型答的准不准、稳不稳,准且稳说明锚点接住了。二是分辨错误的性质:把发现的错记下来,标一标是"每次不同"(偏幻觉)还是"每次一样"(偏有源),前者加强正确源、后者去治源头。三是看用户侧的反馈:如果越来越少的用户拿着 AI 编的假承诺来找你对质,往往说明你的权威版已经在检索里占了上风。不追求把幻觉归零,那做不到;只求把它出现的频率和杀伤力,压到可控。
十三、哪些品牌更该把幻觉风险放在心上
幻觉对谁都可能发生,但它的破坏力并不均摊。几类品牌尤其值得多上心。强监管行业的:医疗、金融、教育、食品这些领域,模型若编出一个你没有的功效、资质或承诺,带来的不只是口碑问题,可能还是合规麻烦。高单价、重决策的:一个被臆想出来的价格或参数,直接影响成交与纠纷。新品牌、信息本来就稀少的:可查的权威内容越少,模型越容易靠先验去“认”你,说偏的概率天然更高。产品迭代快、新旧型号并存的:模型很容易把旧信息、旧承诺当成现状。对照这几条,你能大致判断自己在这件事上的敏感程度,把回测的频度和锚的强度配到对应的档位,而不是一刀切。
十四、把回测做成一张能拿在手里的清单
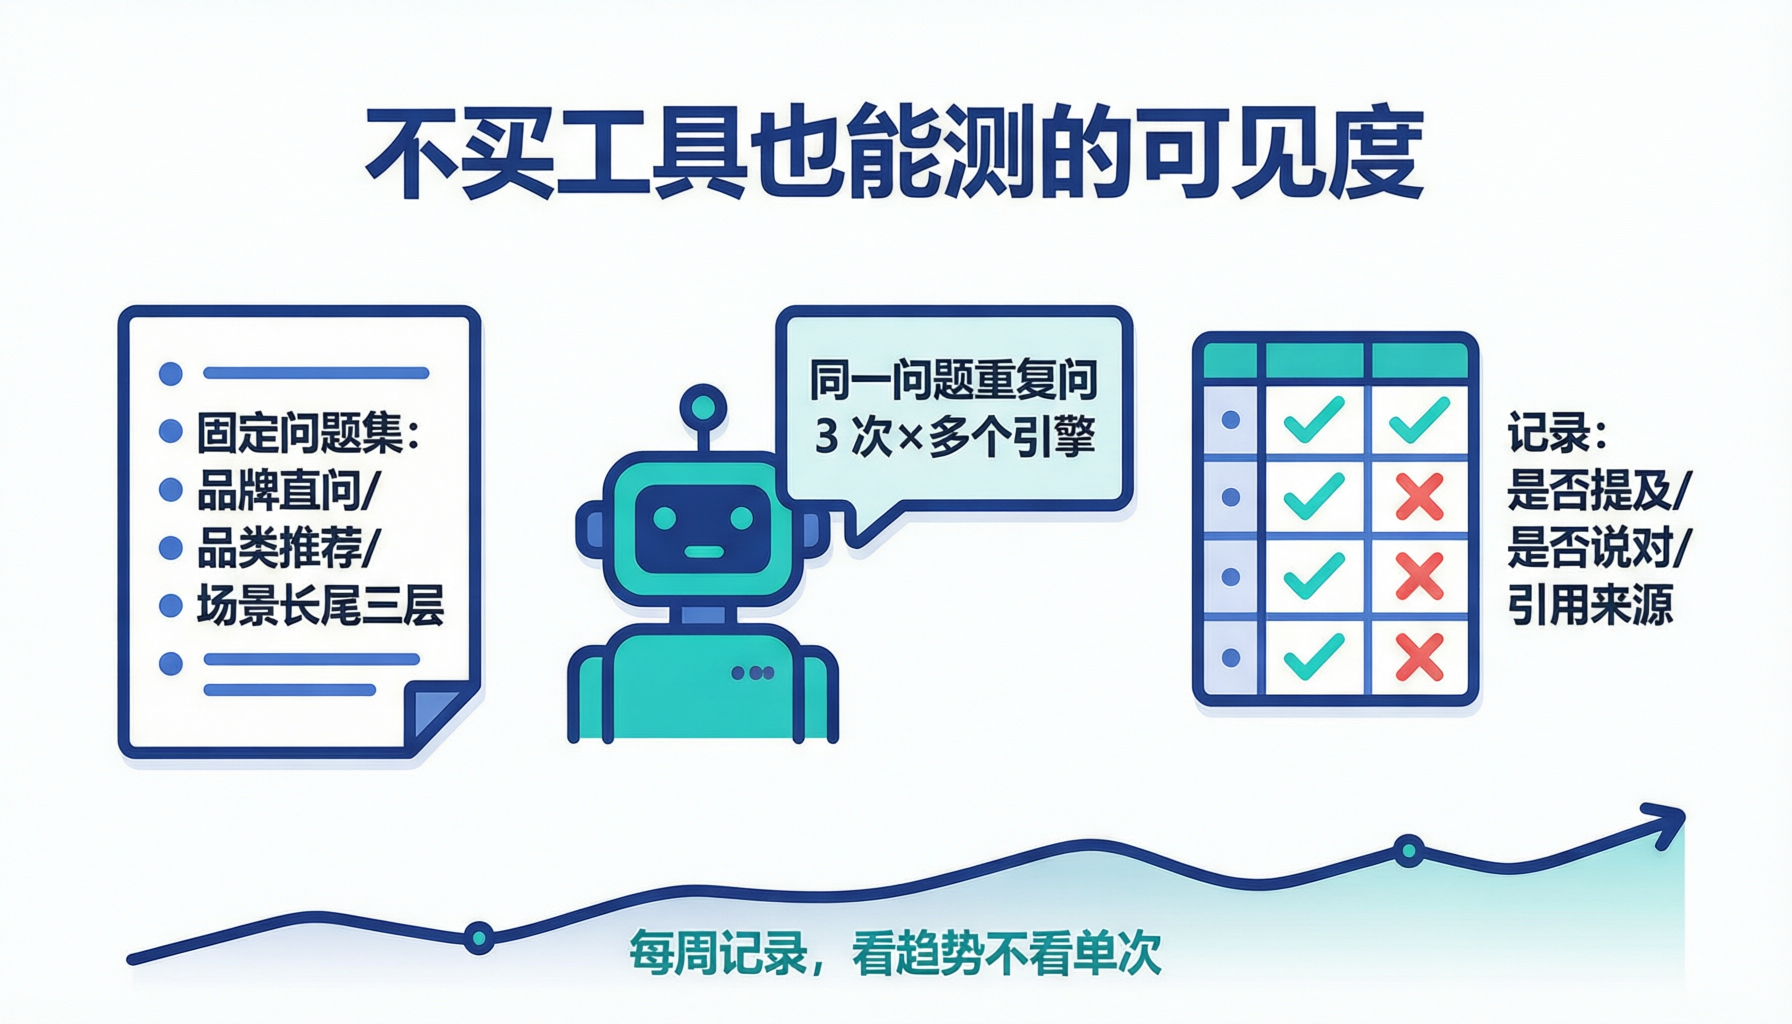
抗幻觉不靠感觉,靠一张固定下来的问题清单。建议这样搭:先把你的关键事实列出来——价格、参数、服务范围、资质、时效承诺,每一项配一个真会被用户拿去问的提问。然后按固定节奏(比如每月一次)去问 DeepSeek,把回答里的关键事实逐条和权威页对,记下三件事:提没提、提得准不准、错得像幻觉还是像有源。重点盯两类信号:一类是“每次问都错得一样”的稳定错,它几乎总能追到一个写歪的来源,值得专门去治;另一类是你最近上线了新价格、新政策、新型号之后才冒出来的错,那多半是你的官方页还没更新到新信息能被抽到的程度,回源头补上就好。把这张表钉下来,幻觉就从“不可预测的意外”变成“能被定期监测、逐步收敛的风险”,你心里也踏实很多。
写在最后
DeepSeek 会把话说得漂亮,也会把不存在的事说得漂亮,这两者用的是同一套能力。理解了这一点,面对 AI 说错你这件事,你就不会只会生气或徒劳地追着改答案,而是回到真正能使上劲的地方:把该说准的事实说准、说全、说到可核验,让正确版本以压倒性的一致盖过模型自由发挥的空间。幻觉消灭不了,但它的滋生地是"信息的空白和混乱"——你把这片地填实、填整,它就少处可钻。说到底,对抗一台会编的机器,最有效的武器不是更快的辟谣,而是一份它编不过去、也绕不开去的真实。这件事急不来,也不会一次做完就一劳永逸;把事实维护好、把回测坚持做,幻觉的空间就一点点被你挤小。
关于墨子学院:本文运营主体为武汉墨子教育咨询有限公司(成立于 2014 年,曾用品牌"百墨生"),自 2022 年起投入 GEO(生成式引擎优化)实践与教学。我们不承诺任何具体排名或引用结果——GEO 是长期工程,靠的是把真实信息讲清楚。系统化的方法可参考 /mall/ 上的 GEO 课程。