Kimi GEO效果怎么测?文件、链接、联网三通道回测:真实问题集与分通道判分-墨子学院
摘要:做完优化最卡在有没有用,而 Kimi 的回测有个别处没有的特点:至少三条独立通道——上传文件读、贴链接读、联网搜索附来源,各自依赖文档自洽、页面可直读、检索可命中。只测一条会误判。本文讲给三通道各设判分标准、备贴近真实的问题集、逐通道怎么测、并排定位短板,以及把结果记成趋势、控制变量做成例行。
摘要:很多品牌做完一波内容优化,就卡在同一个问题上:到底有没有用?在 Kimi 上到底行不行?答案不能靠感觉,得靠回测。但 Kimi 的回测有个别处没有的特点:它至少有三条彼此独立的通道——用户直接上传文件让它读、贴一条链接让它读、以及它联网搜索后综合并附参考来源。这三条通道依赖的东西完全不同:文件通道吃的是"你那份文档自不自洽",链接通道吃的是"你那个页面能不能被直接读懂",联网通道吃的是"实时检索时你的页面会不会被捞回来、被选进引用"。只在一条上测,很容易得出偏的结论——比如联网没引你,你以为全盘皆输,其实文件通道里你表现很好。真正的回测,是把三条通道分别跑一遍、分别定位、分别归因。本文讲这套面向 Kimi 的三通道回测怎么做:测什么、怎么判、发现问题往哪归、以及怎么把它变成能反复跑的例行。
一句话先说结论:测 Kimi,别只问"它提没提我",要分三条通道问——喂进去的文件它读对没、贴进去的链接它读懂没、联网搜的时候它捞回我没;三条各有各的病因和药方,一起测才不会误诊。
一、为什么单测一条会误判
把"品牌在 Kimi 上的表现"当成一个总分,是最常见的偷懒,也是最容易误判的地方。因为这三条通道背后是三个不同的系统:文件通道考验的是一份自足文档的内部一致性,联网都不必发生;链接通道考验的是单个网页能否被机器读明白;联网通道则完全是一场当次的检索竞赛,看你的页面在那批实时结果里够不够相关、够不够新。同一家品牌,可能文件读得很准、链接也读得动,却总在联网里被别家挤掉;也可能联网表现不错,却因为官网某页满是弹窗,被贴链接读时一塌糊涂。只看一个总数,你会把"哪里好、哪里坏"糊成一团,然后开错药。回测的正确单位是通道,不是总分。
二、给三条通道各设一个清晰的判分标准
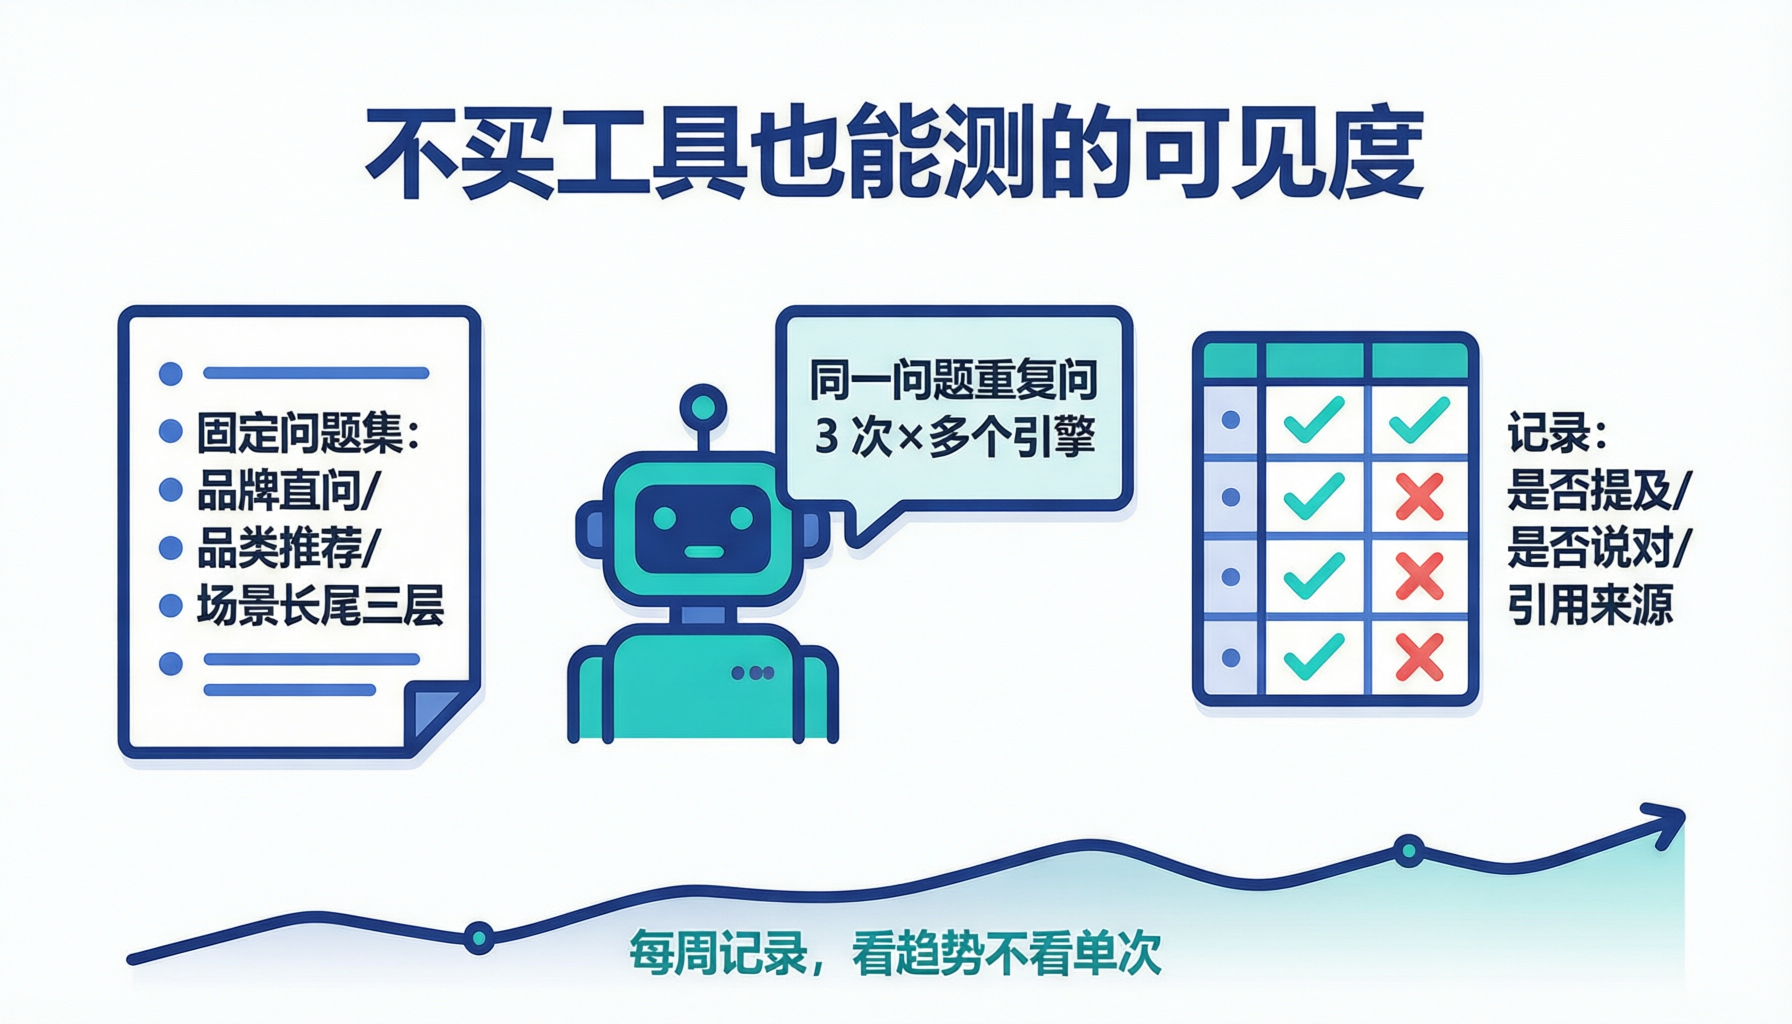
分开测,先得有各自"什么算好"的标准,否则测了也无从判断。文件通道看两点:喂进一份你的资料后,Kimi 就它回答的问题,取值、复述、比对准不准,有没有把矛盾一并端出来。链接通道看:贴一个 URL,它能不能抓到正文(而不是被反爬、被登录墙、被 JS 挡住),读出来的要点和你页面真实信息一致不一致。联网通道看:用真实提问去搜,它这一轮的参考来源里有没有你、你排第几、被摘走的那句准不准。三条标准不一样,别用一把尺量。把它们写进一张测试表,每次回测照表打分,才可比、可追踪。
| 通道 | 测什么动作 | 判"好"的标准 |
|---|---|---|
| 文件 | 上传你的资料再问 | 取值复述准确、不自相矛盾 |
| 链接 | 贴 URL 让它读 | 抓得到正文、读出的要点合原意 |
| 联网 | 真实提问看来源 | 你在参考来源里、位次靠前、引用准确 |
三、先备一套"贴近真实"的问题集
回测的命门,是问题选得真不真。如果你只拿"我们品牌怎么样"这种自己爱听的话去测,测出来的全是虚荣;真正会暴露问题的,是用户真会问的那批话——具体的比价、具体的场景、具体的疑难、带条件的那种。花点功夫整理一组问题:涵盖别人最常拿你做的比较、最易答错的数字、最关键的适用边界,尽量用大白话、用真实口吻。这组问题就是你这轮回测的"考卷",它的质量直接决定回测有没有意义。别一次问太多,十几二十个覆盖住核心场景就够,重点是每题都能明确判对错,而不是问出一堆模糊的好或不好。一个好用的凑题方法:去翻你的客服记录、销售最常被用户问的那几句、后台搜索词里带问号的长句——这些就是用户真会拿去问 Kimi 的话。把它们改写成"一句就能拿去直接提问"的形式,比凭空编题真得多。问题集也不是一成不变,可以每隔几轮小步补充新出现的问题,但别大换,否则前后不可比。
四、文件通道怎么测:喂自有的料,看它会不会自打脸
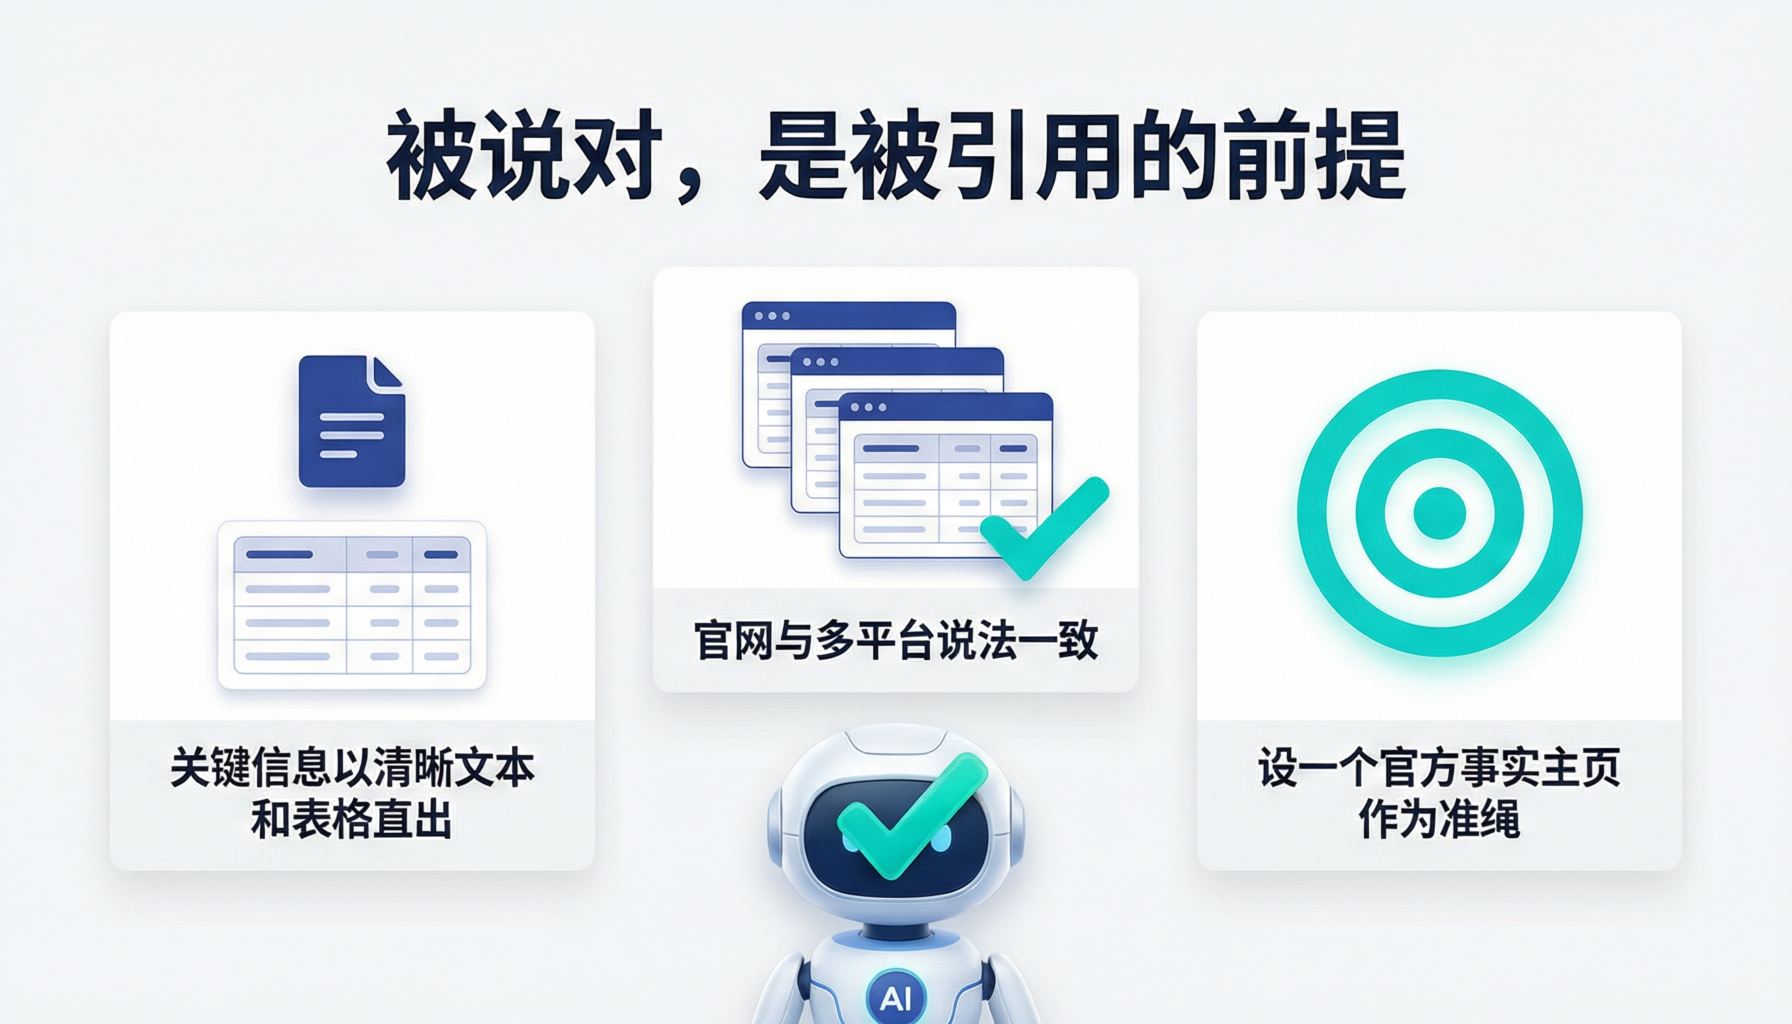
文件通道的测法很直接:把你实际会流通给外部的那份资料(产品说明、政策文档、介绍 PDF)上传给 Kimi,然后拿问题集里相关的题去问。重点盯两件事:一是它取值准不准,价格、参数、边界有没有答对;二是它有没有把你资料里潜在的矛盾原样抖出来——如果同一份料里两处打架,模型的回答往往会漂,这恰恰暴露了你资料内部不同步。这一通道测的其实不是 Kimi,是你自己那份文档经不经得起被读。测出问题,药方多半在"资料自洽、旧版作废、边界写近"上,而不是去改模型。换句话说,文件通道测出的分数,基本上就是你文档质量的镜像。
五、链接通道怎么测:贴 URL,看它抓不抓得动、读不读得对
链接通道测的是"机器直读单个页面"的能力。把官网的关键页面、落地页、产品详情逐条贴进 Kimi,先看它能不能真的读到正文——很多页面在这一步就死了:被登录墙拦、被反爬挡、内容全靠脚本现场渲染、或者干脆是图片截图,模型抓不到字。能读到之后,再看它复述的要点和页面真实信息一致不一致。这条通道最容易被忽略,却最"冤枉":你以为内容做得很好,结果机器压根没读到你写的那些字。测出问题,药方在技术可读性和页面结构上——该服务端渲染的渲染、别把关键信息只塞进图里、降噪去弹窗。
六、联网通道怎么测:真实提问,盯"参考来源"这块明镜
联网通道的测试最接近普通用户看到的实况。直接用问题集去问(触发它联网),然后摊开它给的参考来源列表:这一轮里有没有你?排在第几?它从你页面摘走的那句,是不是准确、是不是你想被引用的那句?没进列表,是相关或可信或新鲜度没过去;进了却排后面,是被更强的来源压住;进了也被引、但引错了,往往是你某页表述有歧义。联网这条的好处正是"明牌"——它把检索结果直接摊给你看,比另两条更容易当场判断。药方多落在标题贴问句、页面可信度、时效更新、长尾页够不够密上。测联网时提醒两点:一是尽量用接近真实的完整问法,而不是关键词堆砌,因为用户向 Kimi 提问时用的是自然语言;二是把"没进列表"和"进了但引错了"分开记——前者是相关与可信的入场问题,后者是你页面表述本身的歧义问题,两种病的修法完全不同。
七、三通道一起测,才能定位真正的短板
单条测完,价值有限;把三条并排放一起看,诊断才成立。举个例子:如果联网总不引你、但文件通道一喂就准,说明你内容本身没问题,问题是实时检索里你的页面相关性或新鲜度没过去——该补的是标题、时效和长尾页,而不是重写文档。反过来,联网偶尔引你、但链接直读时它抓不到正文,说明你公开页面对机器不友好,得先解决渲染和抓取。三条通道的得分组合,能把你该往哪使劲指得相当清楚。回测最大的价值,不是给个分数,而是通过通道间的落差,把病因缩小到某一两个具体系统上。这就像医生先看哪个指标异常,而不是笼统地开药。
八、把结果记录下来,回测才成"趋势"而非"快照"
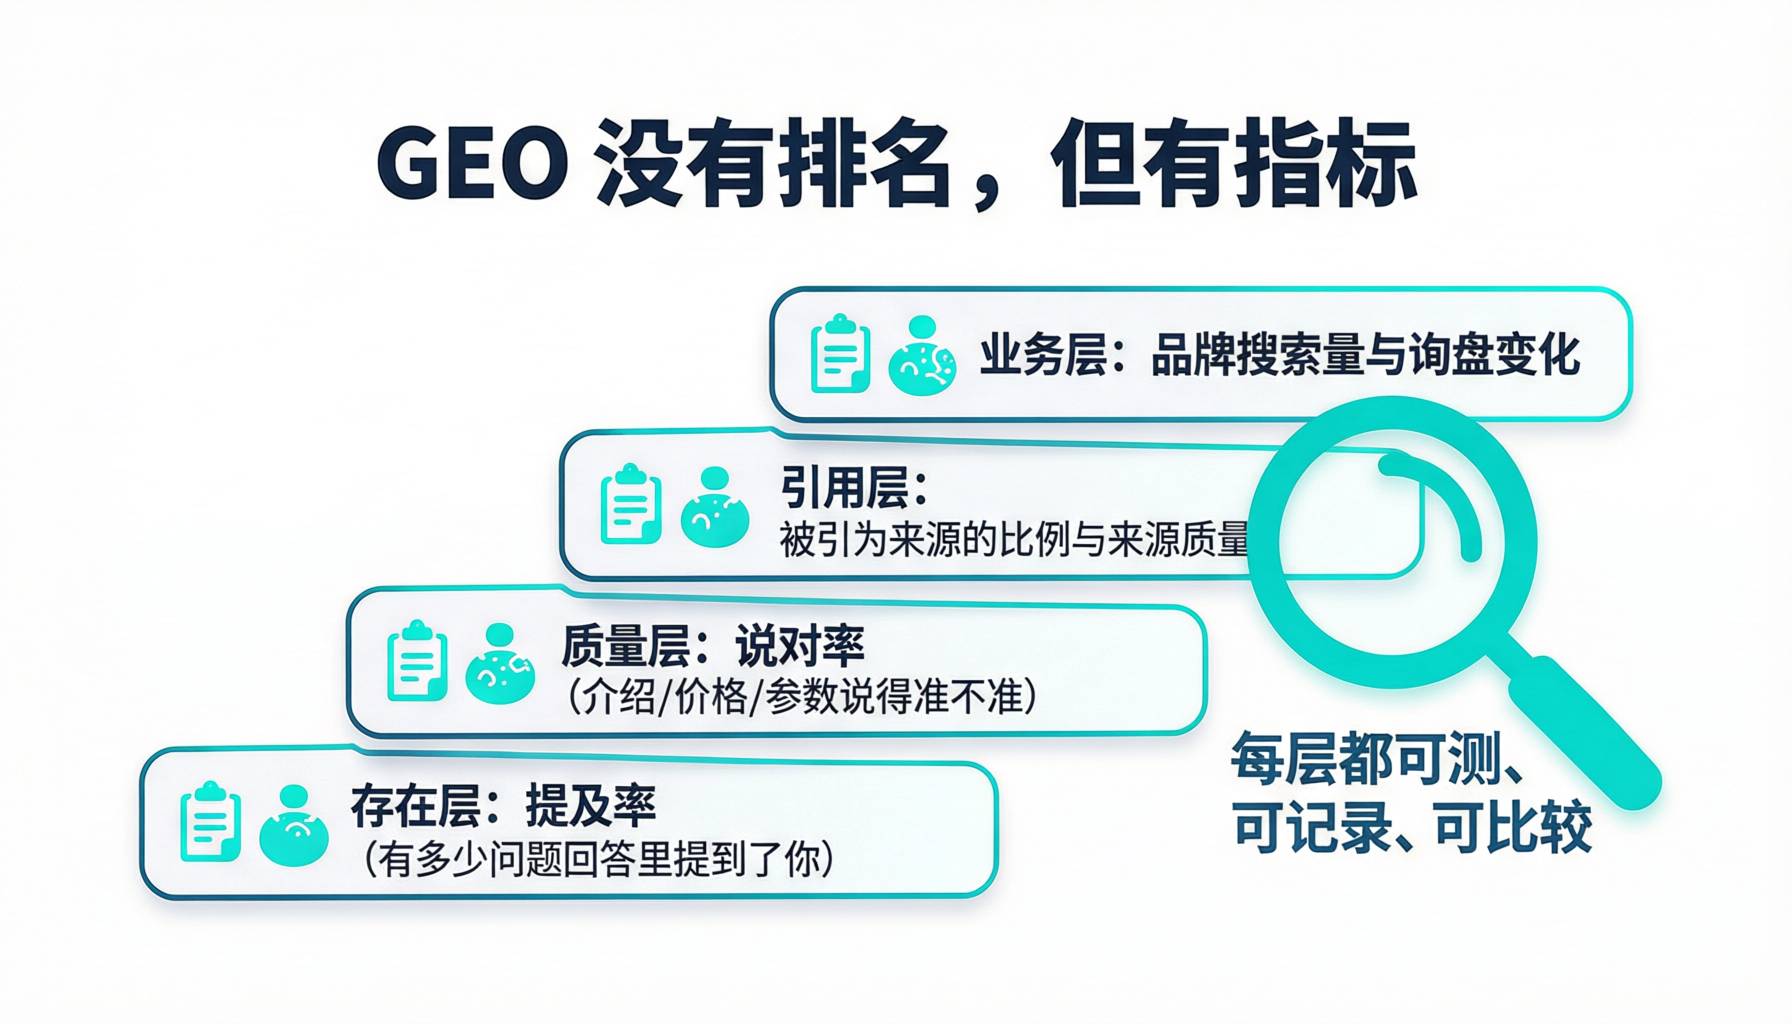
跑一次就丢掉,等于没跑。每次回测,把关键信息落进一张表:日期、问题、走的是哪条通道、有没有被提到/读到/引用、位次、引用对不对、发现的病因归类。攒上几轮,你就有了一条自己的趋势线:这次优化后,联网引用率有没有抬头?某类问题是不是持续答错?链接通道抓取失败率降了没?单次回测只能告诉你"现在怎样",连续记录才能告诉你"做的这些事到底有没有用"。这份记录不必复杂,一张能持续追加的表格就够,贵在坚持和口径一致。记录的时候多写一句"本轮改了什么",下轮回测时你就能把分数变化和你做的那个具体动作对上——是哪个页面改了标题、还是哪份资料补了时效。没有这句备注,涨了你也不知为什么涨,下次无从复制;跌了也不知是不是自己改坏了。回测的价值,一半在测,一半在把每次测和每次改串成一条能复盘的因果链。
九、控制变量:让每轮回测可比
回测最怕的是"这轮和上轮没法比"。要可比,就得尽量控制变量:问题集保持相对稳定(可小步迭代但别大换)、通道判定标准不变、同一类问题固定测法;联网有波动,就每轮多跑几次取个大致稳定的印象,别被一次结果带偏;记录口径一致,这轮记"引用位次"下轮就别只记"有没有"。控制变量不是要实验室级的严苛,而是保证"变化的主要是你做的优化,而不是你的测法"。否则你根本分不清分数涨了是真有效,还是这次问的问题凑巧好答。能比的回测,才是有用的回测。宁可少测几题,也要保证每轮同口径。
十、常见误区
- "测 Kimi 就看它提没提我。"一个总分把三条通道的病因糊在一起,最容易误诊开错药。
- "拿我们品牌怎么样这类话去问。"只测爱听的,永远暴露不了真问题;要用用户真实的比价、比选、疑难问法。
- "联网没引我,说明全盘白做。"可能只是检索侧短板,文件通道里你或许很准——分开看才知道补哪。
- "测一次就够了。"快照只能看当下,连续记录才能验证优化的真效果。
- "每轮换套测法更灵活。"变量失控,涨跌都无法归因,回测直接作废。
十一、两个案例:按通道拆开测,才知道该修哪
案例一 · 联网常年落选,一查是长尾页太稀
一个品牌回测发现文件通道很准、链接通道也读得动,唯独联网时参考来源里从没它。顺着这条落差排查,问题不在内容质量,而在能对准具体提问的长尾页太少,检索时无页可捞。他们补齐一批对准真实问句的细分页后,联网引用率才明显起来。教训:三条通道拆开测,才能把病因从"内容不行"精确到"长尾不够"。(个例,不代表普遍结果。)
案例二 · 内容挺好,链接一贴却抓不到字
一家机构自觉内容扎实,回测链接通道时发现:把详情页贴进 Kimi,它读出来的要点和页面真实信息对不上。深查才知关键参数和价格全渲染在一张图片和一段脚本生成的组件里,模型抓不到可解析的文字。他们把关键信息补成文字、改服务端可直读后,链接通道才达标。教训:不做三通道回测,这种"机器根本没读到你写的字"的死穴会被一直藏着。(个例,不代表普遍结果。)
十二、关于 Kimi 回测的常见疑问
Q:我没有专门的工具,手工测这三条现实吗?
A:完全现实,而且初期就该手工测。文件通道就是上传文档加提问,链接通道就是贴 URL 让它读,联网通道就是正常提问看参考来源——都是产品本身就支持的常规操作。你要准备的不是工具,是一组真实问题和一张肯认真记录的表。等规模大了,再考虑半自动化。
Q:联网结果每次不一样,怎么判好坏?
A:正因为会波动,才要每轮多跑几次看大致稳定的倾向,而不是揪住单次。看的是"这个问题这一类,反复问下来你在不在、大概第几、对不对"的趋势,而不是某一次的精确位次。控制变量、多次取印象,就能把噪音压到可判断的程度。
Q:回测和前面讲的生产、转述,是什么关系?
A:回测是那两头的"眼睛"。生产侧(喂料治理)、转述侧(抗失真)做没做到位,最终都体现在这三条通道的表现上——文件通道读得准不准,很大程度上对应你资料自不自洽;联网和链接,对应你公开页面抗不抗读、抗不抗转述。测,是把这些抽象治理翻译成看得见的数据。下一篇把这些动作排成一张 90 天路线图。
十三、落地:一套能反复跑的回测最小流程
不必等万事俱备,一套最小流程今晚就能跑起来。一是备题:整理一组十几二十条贴近真实的问题,覆盖你最被比较、最易答错、最关键的边界。二是三跑:同一批问题,分别走文件通道(上传你的资料问)、链接通道(贴关键页 URL 看抓读)、联网通道(正常问、看参考来源与引用)。三是记录归因:把每条每题的"提到/读到/引用、位次、对不对"落进表,给发现的问题归到某一通道的某类病因。四是对症修、下轮回测复查。跑上两三回,你对自己在 Kimi 上的真实处境,就会从模糊的感觉变成一份清楚的趋势——这恰恰是所有后续优化敢不敢做、先做哪个的判断基础。
十四、写在最后
Kimi 不是一面镜子,而是三面:你上传的文件、你贴出的链接、它联网搜来的结果,各自照出一个不同的你。只测一面,你多半会误判——把某一通道的短板当成全局的失败,或把某一通道的侥幸当成高枕无忧。把三条通道分开跑、并排看、连着记,你才会头一回真正看清:自己在 Kimi 上,到底哪里稳、哪里漏、下一步该先修哪儿。回测不产内容,却决定你每一分优化的力气有没有使在对的地方——它是把 GEO 从"做了感觉有用"变成"看着数据改进"的那根标尺。
关于墨子学院:墨子学院(武汉墨子教育咨询有限公司,成立于2014年,曾用品牌"百墨生"),自2022年起投入GEO(生成式引擎优化)研究与实践,聚焦品牌在 Kimi 等生成式引擎中的可见度与准确呈现,尤其关注文件、链接、联网三通道的分通道回测与归因。本文所讲的通道拆分测法、真实问题集、控制变量、趋势记录与对症归因等系统化的方法,可参考 /mall/ 上的 GEO 课程。墨子学院不承诺任何具体排名或引用结果——GEO 是长期工程,靠的是把真实信息讲清楚。