DeepSeek 不只是一个入口:开源分身矩阵里,品牌怎么不走样-墨子学院
摘要:DeepSeek 权重开源、可私有化部署、可微调,同一模型以无数分身形态散落在企业和开发者的私域里。你的信息可能不是被官方 App 引用,而是在这些分身中被复用转述。本文讲开源分身矩阵意味着什么、为什么要面向整个矩阵而非单一入口做 GEO、以及怎么把品牌做成喂进任何分身都不走样的干净数据。
摘要:豆包、ChatGPT 这类闭源模型,你面对的至少是"一个入口";而 DeepSeek 把模型权重公开了出来,任何人都能下载、微调、蒸馏、换个界面重新部署。这意味着品牌信息不再只经一处转述,而是顺着无数个"衍生分身"——第三方 App、行业助手、个人搭的小工具、甚至改了名换了壳的套壳站——被反复读取和复述。这条链比闭源引擎更长、更散、更难逐一点名。本文讲这种"开源分身矩阵"怎样改变了被 AI 说到的含义、为什么在这种格局下把公开事实源做准反而成了投入产出比最高的动作,以及技术型品牌该配套做哪几件事。
一句话先说结论:当模型本身可以被任何人拿走、装上任意知识库去回答时,你管不住"有多少个 DeepSeek 在替你说话",但你能决定"它们从你这里能拿到的那份底稿,干不干净、准不准、当不当下"。开源不是让 GEO 更难做,而是把力气更集中地压回到了源头治理上。
前面讲豆包时说过它会被企业集成进下游产品,但那是"相对中心化的集成"——你大致知道接口在谁手里。DeepSeek 的开源把这件事推到了另一个极端:能力被彻底分发出去,部署者可以是正规厂商,也可以是随便一个搭了个网页问答的个人。理解这个差别,是做好 DeepSeek GEO 的认知起点。
一、先看清 DeepSeek 的"开源"到底意味着什么
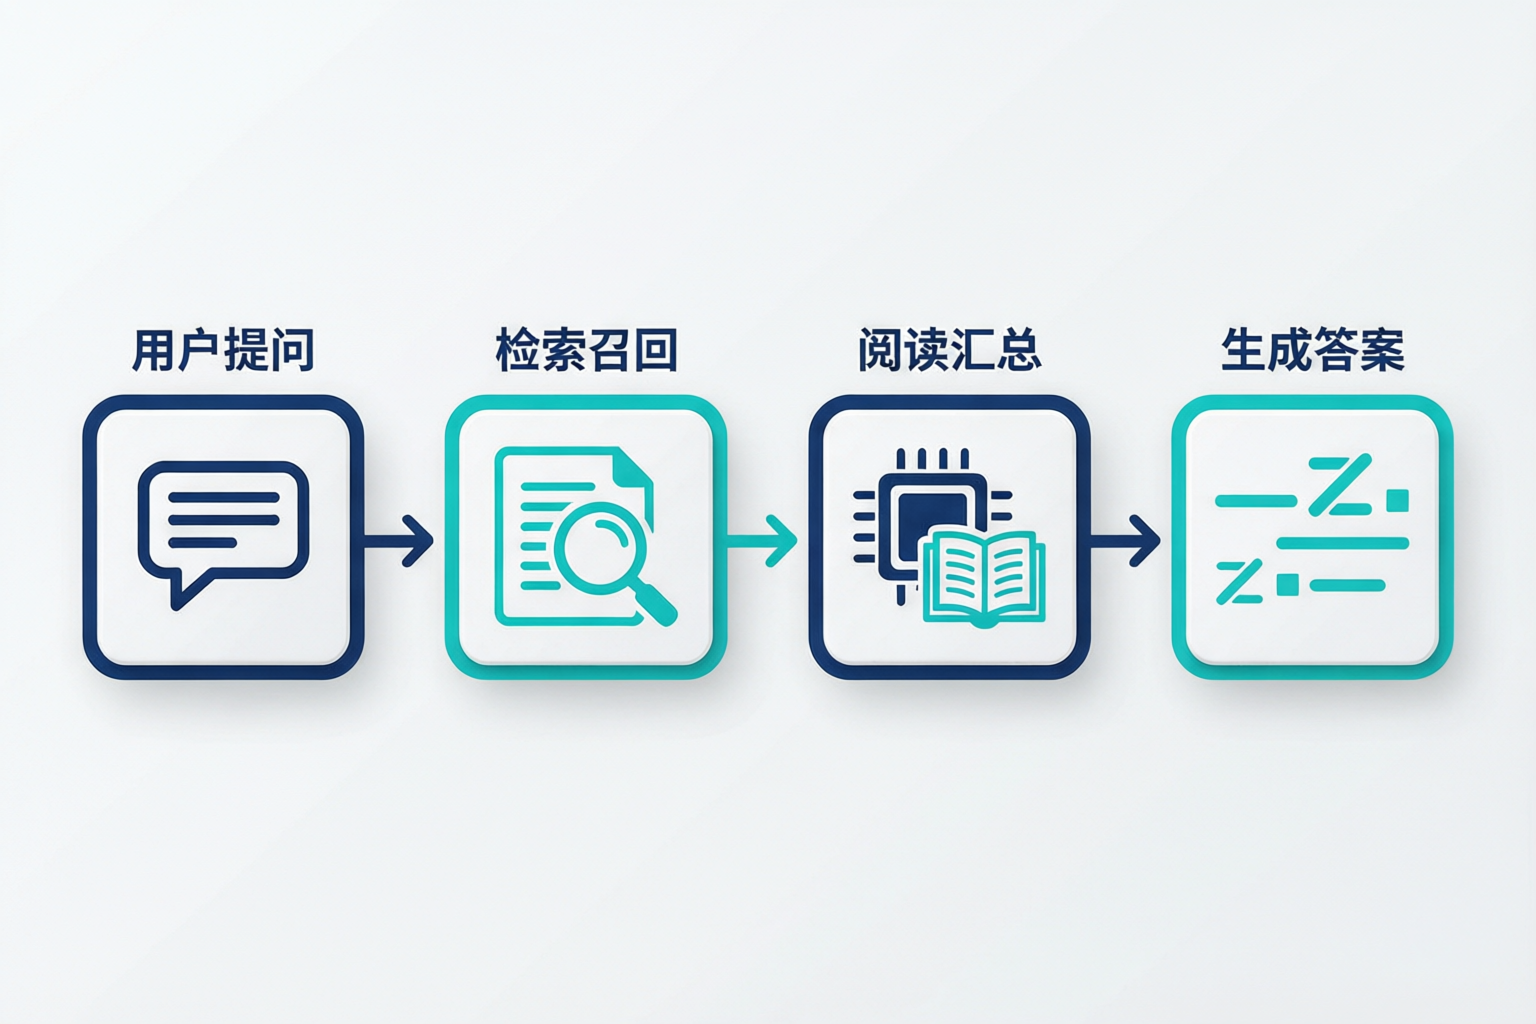
所谓开源权重,简单讲就是模型训练好之后那套参数被公开放出来,允许下载、允许二次开发、允许商用(具体看许可证条款)。于是围绕一个 DeepSeek 基座,会长出成千上万个"变体":有人拿它做客服机器人,有人微调成医疗问答,有人蒸馏成能跑在手机上的小模型,更多人只是套个壳、连上自己的资料库,做一个垂直领域的小助手。这些变体对外未必叫 DeepSeek,可能是一个你从没听过的产品名,但骨子里读的是同一套模型能力,检索的又是各自不同的知识库。你的品牌信息,就这样被卷进了一个你看不见全貌的矩阵里。
二、闭源是"争取一个入口",开源是"覆盖一片长尾"
在闭源引擎里,GEO 的一个隐含目标是"进入它检索的那份候选、被它选为出处",多少有点像争取上某个货架。而 DeepSeek 的开源格局下,货架变成了无数个——每一个自建助手都是一个独立的小货架,各自决定装什么资料。这带来两个直接后果:其一,逐个去经营每一处长尾几乎不可能,你无法枚举到底有多少产品在用 DeepSeek 转述关于你的内容;其二,也正因如此,"把源头那一份权威底稿做对"的杠杆被放大了——因为不管多少分身,它们要引用你,总归要上网抓,抓到的最好来源就是你精心准备的那一份。你不需要认识每一个下游,只需要保证"关于你的可抓取内容里,那份最完整、最新、结构最清楚的,是你自己的"。
三、长尾分身为什么更容易把你说歪
中心化大模型有专门的团队做检索质量、做安全对齐;而一个个人或小团队搭的 DeepSeek 套壳应用,往往没有这些能力。它连的知识库可能是东拼西凑爬来的,切片切得稀碎,来源不辨真假,出了错也没人复核。这就导致同一个关于你的问题,在正规入口里可能答得还行,在某个粗糙的长尾分身里却被说得驴唇不对马嘴。更要命的是,这类"翻车"因为分散在无数小站里,你几乎不可能及时发现,等用户拿着某个 AI 的错误说法来质问你,木已成舟。认清"下游质量天然参差"这一点,你就明白:与其幻想去修每一个分身,不如把你那份被它们共同依赖的源头做到无可挑剔。
| 维度 | 中心化闭源引擎 | 开源 DeepSeek 长尾分身 |
|---|---|---|
| 你能看见几个 | 一个主入口,相对清晰 | 无数个变体,几乎无法枚举 |
| 检索质量由谁保证 | 模型方有专门团队 | 多靠部署者自己,水平参差 |
| 出错后怎么纠 | 影响该引擎,可回测发现 | 分散在各小站,难以察觉 |
| 你的有效抓手 | 争引用、铺生态 | 做一份谁抓都对的干净底稿 |
四、把品牌做成"谁抓都抓得对"的那一份
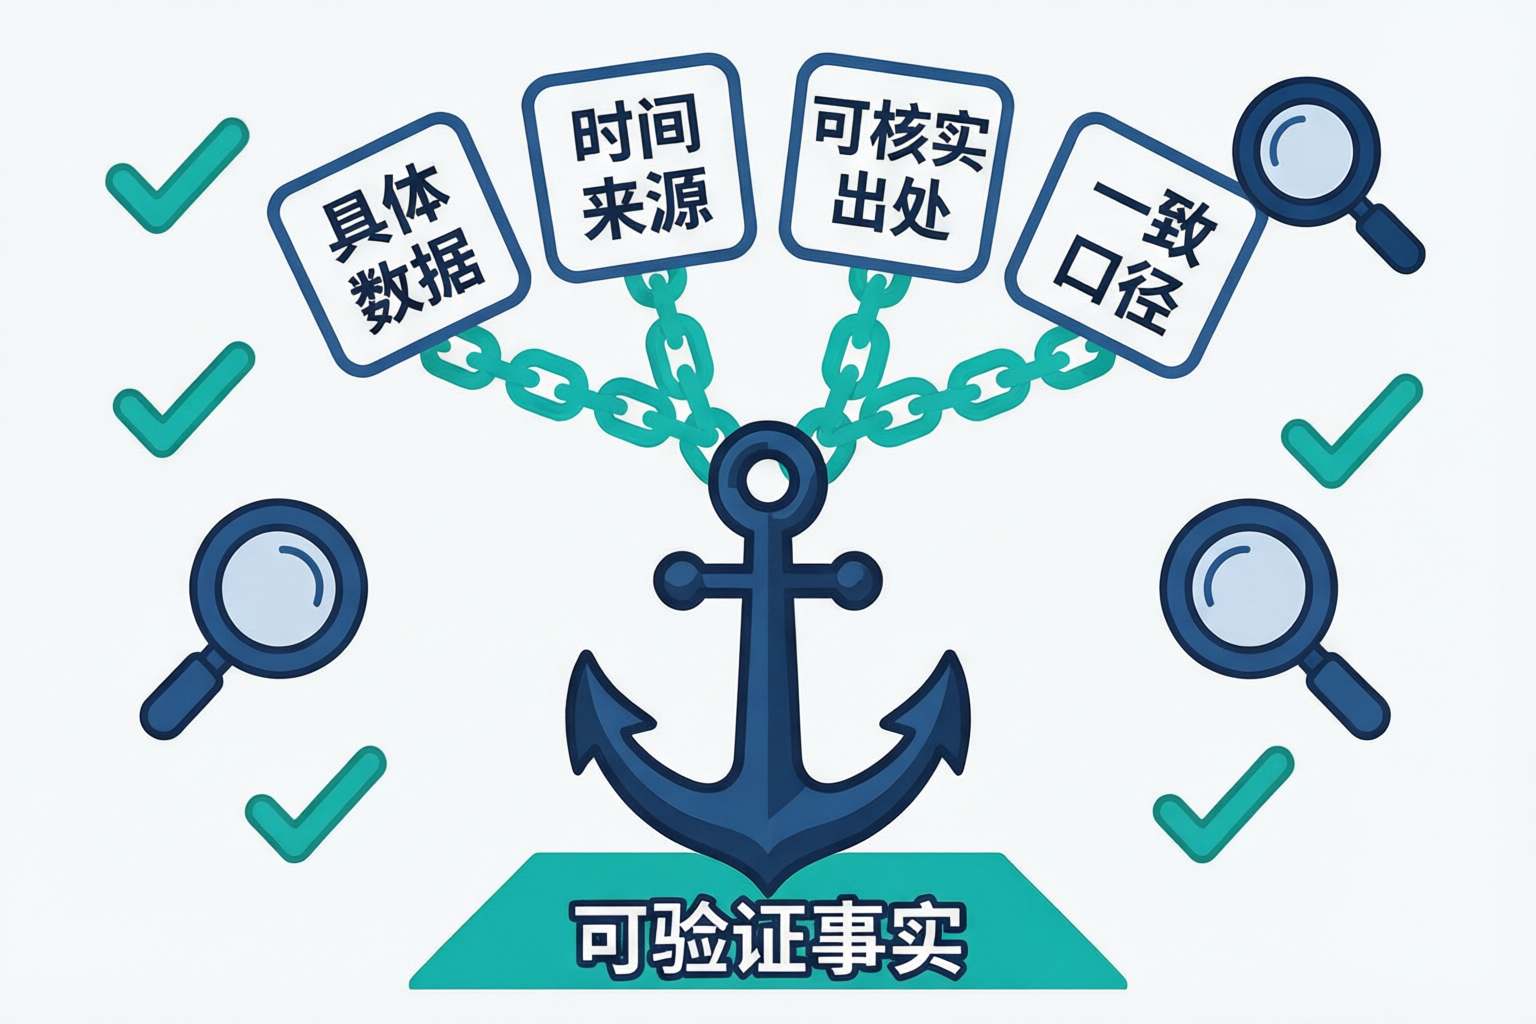
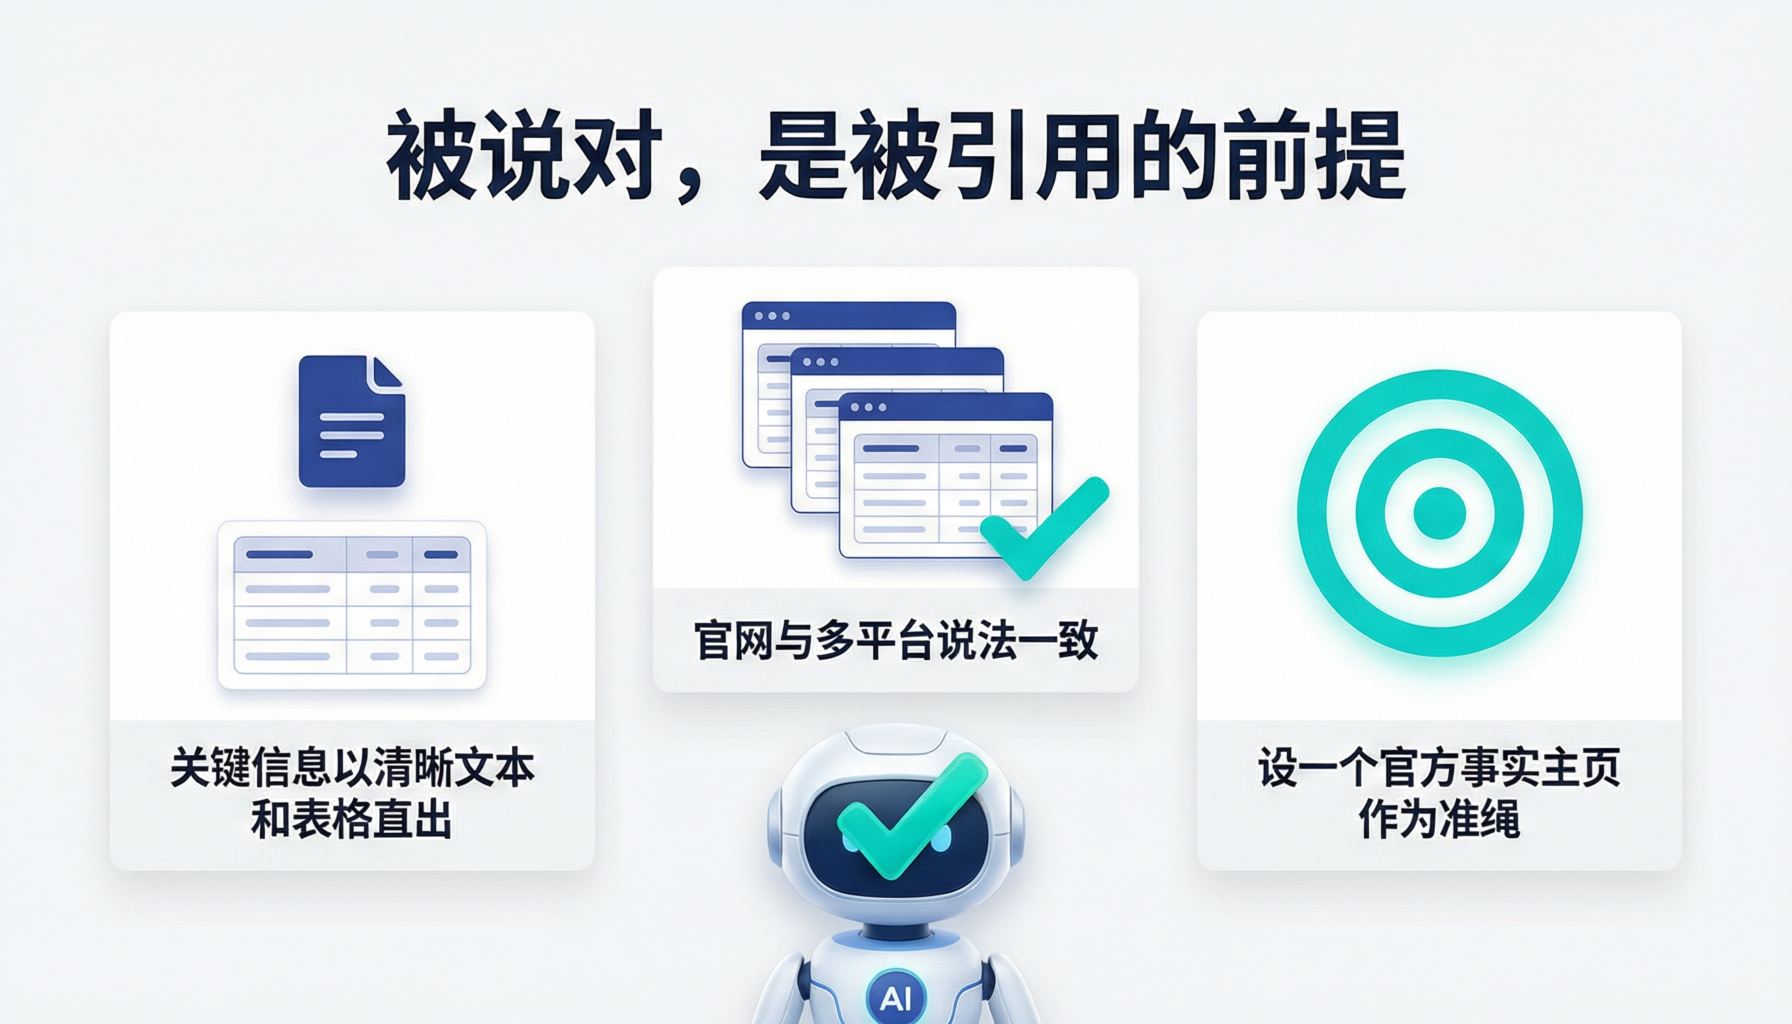
顺着上面的逻辑,DeepSeek GEO 在开源语境下最实的动作,是把品牌核心事实整理成一种机器友好、结构化、可核验、且明确标注了当前性的数据形态。具体讲:给关键信息配齐明确的属性(是什么、多少钱、适合谁、有什么限制、数据截至何时),尽量用结构化标记、清晰的表格与问答对来表达,而不是只藏在宣传性的散文里;把它们集中在一个权威、易抓取、更新及时的官方来源上。这样无论哪个分身来抓取,只要它够聪明地选了对的来源,拿到的就是一份干净底稿;而那些爬了营销软文、爬了过时资料的,也至少存在一份"正确版本"作为对照组,用户或下游一核验就能拨正。你没法决定谁把你接进知识库,但你完全能决定他们接到的是不是一份喂得进去、也转不出错的数据。
五、给机器留一条"最省事、最不容易抄错"的路
当一个部署者要往他的 DeepSeek 应用里塞某个品牌的资料时,他面对一片互联网,从哪儿抓是随机的。你在官方站提供一个组织清晰、面向机器、指向当前事实的入口(比如一份结构化的官方数据页、一个 llms.txt、一份干净的规格表),等于在这堆可选项里放了一条"抄起来最省事、也最不容易抄错"的路。它不保证每个分身都会走,但在众多品牌里,给了认真做检索的部署者一个明确的正解。这件事是跨引擎通用的,只是在 DeepSeek 这种"部署者高度分散"的格局下,降低别人正确复用你信息的门槛,价值被进一步放大。把这条路的入口做清楚,一次投入、处处受益。
六、技术型品牌:你的代码与文档本身就是被读的对象
DeepSeek 在开发者和研究者里渗透很深,很多关于你的提问根本不是从营销页出发,而是从技术文档、README、接口说明、示例代码出发。对一个开源项目、一个 SDK、一个技术产品来说,这些"技术资产"往往比官网首页更能决定 AI 怎么描述你。如果你的 README 版本混乱、示例跑不通、许可证语焉不详,AI 转述出来的形象就会打折;反之,一份当前、准确、示例可复现、边界讲得清清楚楚的技术文档,会成为整个 DeepSeek 分身矩阵里最可靠的那份事实源。别只盯着营销内容做 GEO,对技术品牌,把文档当首要资产来维护(版本、时间、兼容性、许可都标清楚),回报可能比铺十篇软文更大。技术资产要配套维护的几项:
| 资产项 | 为什么影响 AI 描述 | 该做到什么 |
|---|---|---|
| README / 文档 | 开发者问答常直接引它 | 与最新版本同步,示例可复现 |
| 接口与参数表 | 被切片进技术助手 | 字段、类型、限制、变更日志齐全 |
| 许可证 / 归属 | 决定能否被合规复用 | 明确标注,别让下游踩线后怪你 |
七、正本清源,而不是挨个救火
面对分身矩阵,一个诱人但低效的做法是"发现哪儿说错了就去纠哪儿"。问题是分身太多、太分散,你根本追不完,等发现时那个错误可能已经被下游用户截图传开了。更现实的策略是"正本清源":与其在几十个长尾小站里逐个辟谣,不如集中力气把那份权威底稿做扎实、做当前、做出更高的可检索性,让正确版本在数量和信号强度上占优。这就像大禹治水,堵不如疏——你把正道的水放足,歪的流量自然被比下去。个别影响大、来源明确的错误当然要点对点去沟通纠正,但整体精力,应该压在源头,而不是尾巴上。
八、常见误区
- "DeepSeek 开源了,所以我根本没法做 GEO。"恰恰相反,正因为下游分散,做准源头这份共同依赖的底稿,杠杆比在闭源引擎里更大。
- "我要挨个找到所有用 DeepSeek 的产品去对接。"你枚举不完,也不必要。精力放在"谁抓都抓得对"的那一份,而不是逐一下游。
- "把网页关键词堆足就行。"被切片复用时,散在抒情里的关键事实最容易丢,结构化、自成块、带时间才是硬道理。
- "技术文档不重要,营销页才重要。"对 DeepSeek 的技术型受众,文档、README、示例才是它认识你的主源。
- "能被抓=该被抓。"公开事实和敏感内容要分开,哪些欢迎被复用本身就是一项要主动设定的边界决策。
九、把开源这条链补进清单:多做三件事
认识到分身矩阵这条线后,落地不用推倒重来,只在通用动作上补三件。一是把"喂得进去"当作写关键页的标准之一:除了人读着顺,也检验它好不好被切片、好不好被抽取、单独抽出一段还成不成立。二是把权威事实源的"机器可读入口"做清楚:结构化、带时间、指向明确,让分散的部署者愿意也从这里取。三是若你是技术品牌,把文档纳入 GEO 维护:和最新版本同步、示例可复现、许可标注清楚,定期抽测下游有没有把你的能力说歪。三件事的共同点是——都围绕"让信息在离开你直接掌控之后、在无数个你叫不出名字的分身里,仍不走样"。
十、两个案例:看清分身矩阵之后,动作更有的放矢
案例一 · 一份结构化的规格底稿,稳住了到处被转述的参数
一家做硬件配件的企业发现,多个行业问答里自家产品参数时准时时不准。追下去,是因为各处抓的是不同时期的营销页,数字散在段落里、还带着旧版。他们把核心参数整理成一页结构化的当前规格(带属性、更新时间、可核验来源),并让它成为最好抓、最完整的那一份。一段时间后,被各处转述的一致性明显改善。教训:分身矩阵下最怕源头零散,把底稿做成干净的一份,比逐个下游纠偏省力得多。(个例,不代表普遍结果。)
案例二 · 一个开源项目,靠当前文档挡住了跑偏的描述
一个开源工具的维护者注意到,用 DeepSeek 问"这项目能干什么、怎么装"时,答案有时引用的是过时的博客教程,版本都对不上。他们没有去联系那些博客,而是把 README 和官方文档做成最新、示例可复现、版本清晰的一份,并在显眼处标注"以官方文档为准"。再回测时,正确的引用明显占了上风。教训:对开源与技术品牌,权威且当前的文档,就是在分身矩阵里站稳正确描述的锚。(个例,不代表普遍结果。)
十一、关于开源格局下 GEO 的常见疑问
Q:模型是开源的、部署的人我根本不知道是谁,做这些还有意义吗?
A:有意义,而且抓手正在你手里。下游能接到什么,取决于你公开内容整理得好不好。把关键事实做成结构化、当前、可核验、口径统一的权威源,等于无论谁接、接到的都对。你不需要知道具体是谁,也能让这条链上流转的是准确版本。
Q:这和讨好某个闭源引擎的引用,是不是两套完全不同的功夫?
A:底层高度重叠。可摘、可核验、多来源一致、机器可读这些通用能力,两边都用得上;差别在侧重——闭源引用更看"进不进它的候选、显不显眼",开源分身更看"切成块、拼起来还不不失真、以及那份正确底稿够不够好抓"。把通用底座做扎实,两条链同时受益。
Q:我们规模小,暂时没多少产品来接入我们,这条线要现在管吗?
A:不必专门加码,但值得顺手做对。你为被引用做的那些——结构化关键页、干净事实源、口径一致——本身就是下游最容易正确复用的形态。等于没额外投入,就把分身矩阵的地基也打了,等它真发生时你已有准备。
十二、怎么知道这条链有没有生效:几个能落地的观察点
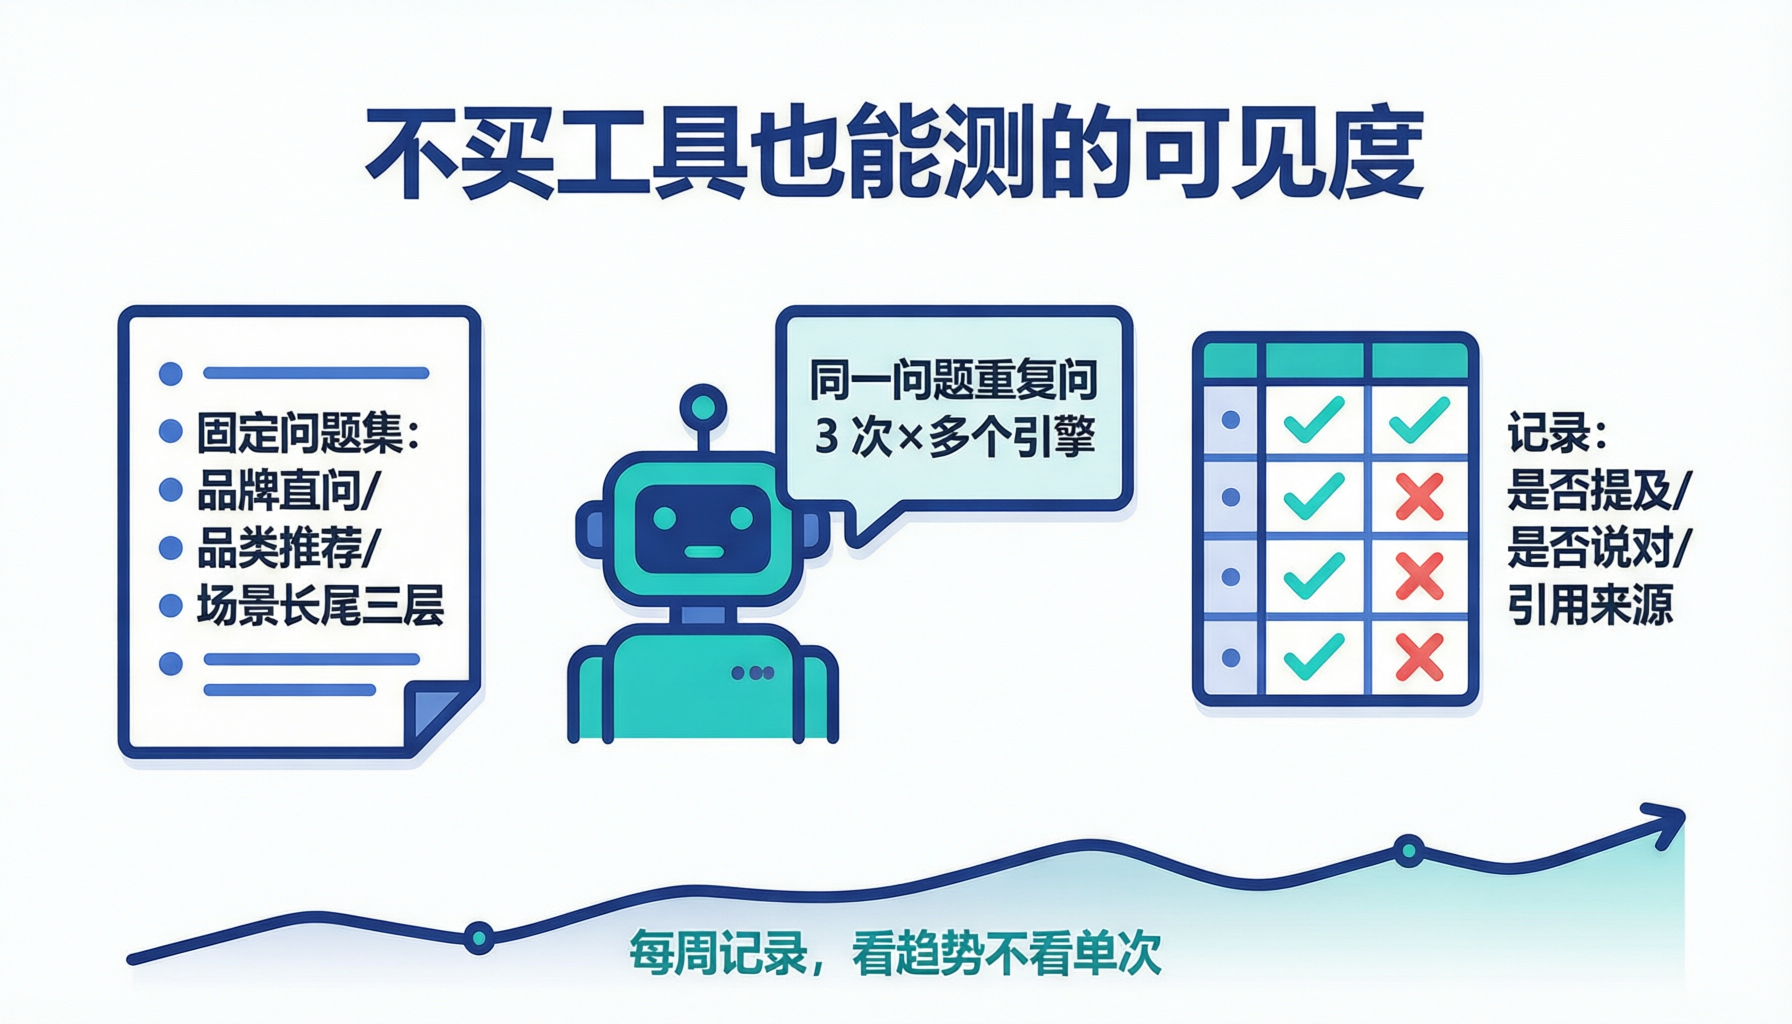
分身矩阵看不见全貌,容易让人觉得"做了也没法验证"。其实有几个能落地的观察点。一是自测已知下游:挑几个你已知的、接了 DeepSeek 的应用或渠道,用真实用户口吻问关于你的问题,看它转述的参数、价格、定位准不准、和你官网一致不一致。二是盯源头质量而非下游数量:你没法穷举谁接了你,但能确保那份权威底稿是当前、完整、口径统一的——底稿对了,链路上流转的版本大概率就对了。三是把技术品牌的文档抽测纳入例行:定期拿一批真实技术问题跑一遍,看有没有报旧版本、跑不通的示例、说歪的能力,发现问题回到文档和事实源去修,而不是头痛医头地改某一句回答。这三个观察点不追求精确归因,只求"源头在正轨、下游不出格"。
十三、一个容易被忽略的前提:真实,永远排在优化前面
讲了这么多"让信息被正确复用"的技巧,得补一句最要紧的话:这一切的前提,是你的品牌信息本身是真的。结构化、机器可读、口径一致,这些是把真实信息讲清楚、传不走样的手段;如果底稿本身就夸大、过时、经不起核验,那把它做得越易被复用,反而让不实信息在越多分身里流转、越快被戳穿。开源分身矩阵的一个特点是"链条长、放大快、还分散"——一份错误底稿,可能被成百上千个小应用同时转述,纠正成本远高于一次夸大带来的短期好处。所以做这条链的正确顺序,永远是先把事实做真、做当前,再谈把它做得好读、好抓、好复用。真实不是一句口号,在长而散的链路里,它是你最该押注的资产。
写在最后
DeepSeek 的开源,把"被 AI 说到"这件事从一个入口,变成了一片你叫不出名字的长尾分身。它看似让品牌更失控,实则把 GEO 的重心更清晰地压回到了一个你完全能掌控的地方——那份被所有人共同依赖的源头底稿。管不住有多少个变体在替你说话,但你能保证:只要它们来抓,抓到的那份最完整、最新、最干净的,就是你自己准备的。把核心事实做成干净、结构、可核验、口径一致的权威源,是让信息在任何被复用的链路上都不走样的通用解法。这条路不热闹、也看不见具体是谁在用,却正是一个品牌在开源 AI 时代把"说得准"这件事做得最扎实的地方。
关于墨子学院:本文运营主体为武汉墨子教育咨询有限公司(成立于 2014 年,曾用品牌"百墨生"),自 2022 年起投入 GEO(生成式引擎优化)实践与教学。我们不承诺任何具体排名或引用结果——GEO 是长期工程,靠的是把真实信息讲清楚。系统化的方法可参考 /mall/ 上的 GEO 课程。