先被认准,才谈得上说准:豆包里的中文实体一致性-墨子学院
摘要:在AI眼里你的品牌是一个有名字属性关系的实体节点,认不认得你、会不会把你和同行搞混,取决于实体信号清不清晰。本文讲分裂混淆含糊三种病,怎么用定名、中英对齐、结构化标注、稳定关联,把各个你焊成同一个。
摘要:在 AI 眼里,你的品牌不是一个人格,而是一个"实体"——一个有名字、有属性、有关系的节点。豆包认不认得你、会不会把你和同行搞混、能不能把"英文名""中文名""简称""产品名"都归到同一个你,取决于你的"实体信号"够不够清晰、够不够一致。这件事对跨境品牌尤其致命:你在英文世界是个清楚的实体,到了中文世界却可能是一个含糊、分裂、甚至和别人撞名的存在。本文讲中文实体一致性——一个常被当成小事、实则决定豆包"认不认得你"的地基工程。
一句话先说结论:让 AI 认准你,靠的不是把名字重复一万遍,而是用一致的名字、一致的描述、稳定的关联、结构化的标注,把"你是谁"这件事,在所有可被检索的地方,钉成一个清楚、不歧义、可核验的实体。
前面几篇反复出现"实体一致""口径统一",这一篇把它单独拎出来讲透。因为比起"写得好不好","AI 认不认得你、认得对不对"是更底层的问题——一个被认错、被搞混、被分裂成几个的品牌,内容写得再漂亮,也可能在回答里张冠李戴,或者干脆查无此人。
一、AI 是怎么"认识"一个品牌的
大模型对世界的理解,很大程度上建立在"实体"上:人、公司、产品、地点,都是它知识网络里的节点,节点之间连着关系。当用户问"X 公司做什么",模型是在它的实体网络里找"X"这个节点、调取它挂着的属性和关联。问题是,这个节点不是你自己填进去的,而是模型从海量文本里"归纳"出来的——它读了多少关于你的、一致的、明确的信息,决定了这个节点清不清晰。如果你的信息散乱、别名混乱、中英对不上,模型要么把你的节点建得含糊,要么把你和名字相近的别人错误合并。所谓"让 AI 认得你",本质是帮它把你这个实体,建得清楚、建得准。
二、实体走样的三种典型病
品牌在 AI 里被认错,通常得三种病。一是分裂:同一个品牌,中文名、英文名、产品名、简称各说各话,模型不确定它们是同一家,你的信息被拆成几个弱节点,谁都立不起来。二是混淆:你和同行、和被收购方、和同名异物撞在一起,回答里张冠李戴。三是含糊:你的描述太空("领先的解决方案提供商"),没有可定位的属性,模型知道有"你",却说不出你到底干嘛。这三种病,都不是靠多发稿件能治的,得靠一套主动的实体管理:定名、对齐、标注、贯穿一致。三种病的来龙去脉摆成一张表:
| 病症 | 在回答里的症状 | 典型成因 | 对应的药 |
|---|---|---|---|
| 分裂 | 你的信息被拆到几个弱节点,谁都立不起来 | 中英文名、简称、产品名各说各话 | 定名称关系表,首次出现给"全称(别名)" |
| 混淆 | 回答里张冠李戴,把别人的事安到你头上 | 与同行、同名异物撞车,缺区分信号 | 把品牌与品类、地区、标志产品绑成独特指纹 |
| 含糊 | 知道有"你",却说不清你干嘛 | 描述空泛,没有可定位的属性 | 关键页写具体能力、场景、数据 |
三、先定名:把"你有哪些名字"这件事管起来
很多品牌从没意识到,自己有一堆名字:官方全称、常用简称、英文名、中文名、各产品线的名字、用户给你的外号。放任不管,模型就会被这些名字绕晕。务实做法是做一张"实体名称表":哪个是权威的官方全称,哪些是认可的别名,中英文如何一一对应,产品名和品牌的从属关系是什么。然后在所有可控渠道上,保持这套命名规则的一致使用——正式场合用全称,介绍时首次出现给出"全称(英文名/简称)",之后统一。这不是咬文嚼字,而是给模型一个清楚的信号:这些名字,指的都是同一个我。
四、中英对齐:跨境品牌最容易断的一环
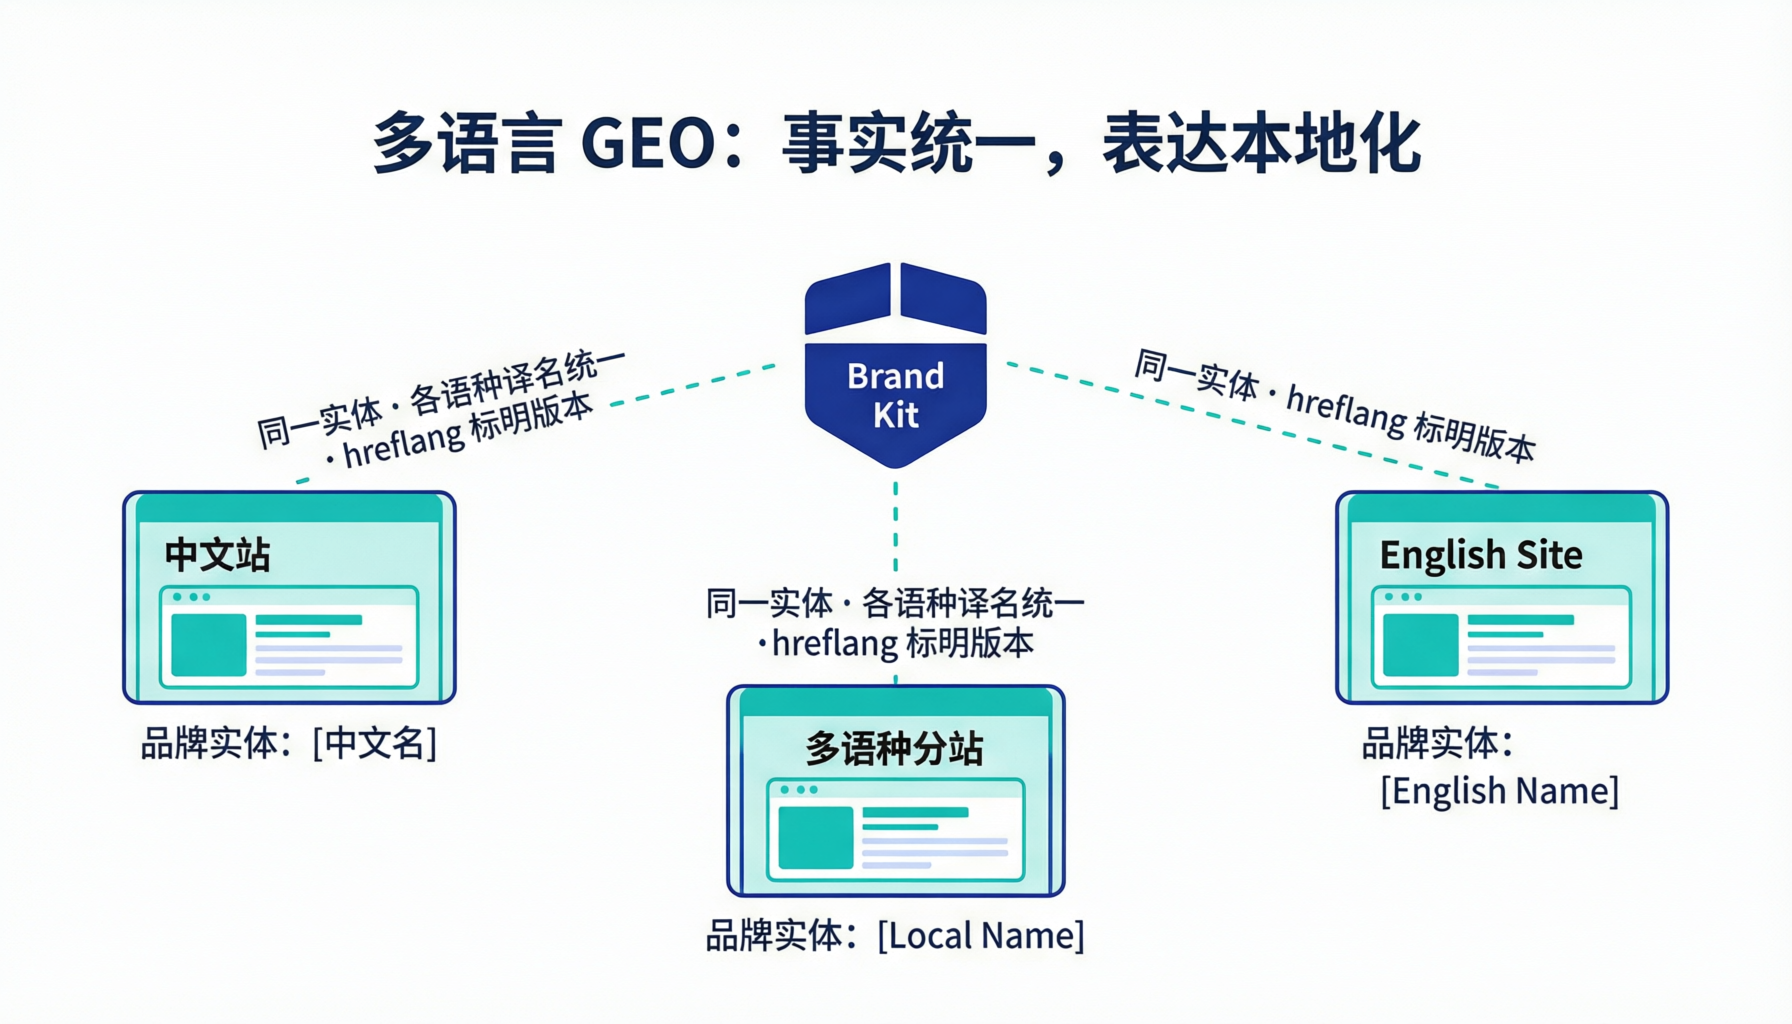
对跨境品牌,中文实体一致性的核心难点,是让英文世界的"你"和中文世界的"你",在模型那里合并成同一个节点,而不是两个互不相干的陌生人。常见断点:英文名和中文名没有明确对应、中文名叫法不统一、关键信息只有英文版、中文侧全靠第三方零散翻译。补法:在官方页面显眼处,给出"英文名 + 中文名"的明确绑定(如"ACME(中文:艾克米)");把最核心的品牌事实,做成一份规范的中文权威版本,而不是指望别人替你翻;让中英文页面之间有清楚关联,便于引擎确认是同一主体。把中英两个"你"焊成一个,是跨境品牌在豆包这类中文入口里不被看扁、不被认错的关键一步。
五、用结构化标注,把实体"钉"进机器可读的形态
光靠散文里提名字,是不够的。结构化数据标记(如 Organization、Product 这类语义标注)和机器可读的事实源,能把"你是谁、叫什么、做什么、和谁有关",用机器一眼能懂的方式声明出来。它在实体层面的价值特别大:官方全称、别名、logo、所在地、同域名的其它官方账号,这些字段填清楚,等于亲手递给模型一份"实体档案",大大降低了它猜错的概率。对跨境品牌,一份规范的中文结构化事实源,是把中文实体立起来最省力的杠杆。别把结构化标注当成 SEO 的老古董——在多引擎共用的今天,它是你给机器最直接的一句"我是谁"。
六、稳定关联:把"你"和"你的行业、场景、地区"绑牢
实体不孤立存在,模型靠"关联"来消歧。一个品牌如果从不把自己和具体的品类、场景、地区稳定地绑在一起,模型就很难判断用户那句带行业上下文的提问,是不是在说你。务实做法:在所有关键内容里,稳定地把你的品牌和一个清楚的品类定位、核心使用场景、主要服务地区绑定表述——不是堆关键词,而是像介绍一个朋友那样,自然地交代"他是做什么的、常在什么场合被提到"。当你把品牌和它所在的语义坐标绑得又稳又一致,用户从任何一个角度问起,模型都更容易顺着关联,找到你、认出你。
七、一致压倒一切:多来源同一个你
实体一致性的落地标准,说穿了就是"一致"两个字。官网、生态内容、第三方平台、百科式的公开条目,只要在关键属性(名称、定位、能力、规模、资质)上互相印证,模型就会把这些当作同一个实体的多方佐证,你的节点因此又清晰又可信;一旦各处出入,它不仅难判断哪个是真的,还可能把矛盾一并端出来。所以,一份单一权威底稿、各处从它派生、变更时全渠道同步,这套在纠错、可摘、集成各篇里都出现的规矩,本质上服务的都是同一个目标——让"你"在任何一处被读到,都是同一个你。
八、常见误区
- "名字写法无所谓,AI 那么聪明看得懂。"模型靠归纳,别名混乱、中英不绑定,它就更可能把你建成分裂或混淆的节点。
- "多发内容提高出现率就行。"出现得多但每次说法不一,反而加深含糊和矛盾;实体要的是"一致地出现",不是"多而乱地出现"。
- "英文名是全球统一的,中文随便翻。"中文侧叫法不一、无权威版本,跨境品牌在中文入口最容易断在这。
- "结构化标注是给搜索引擎的老古董。"它是你直接递给机器的一份实体档案,多引擎通用、一次投入长期有效。
- "描述越宏大越显实力。"空泛定位不给模型可定位的属性,它知道你却说不出你干嘛,等于没被认出。
九、落地清单:给自己做一次"实体体检"
这件事可以工程化,做一次全面排查。一,盘名字:列出品牌所有在用和曾经用过的中英文名、简称、产品名,定出权威全称和认可的别名。二,查绑定:检查每个关键页面,中英文有没有明确对应、有没有把品牌和品类场景稳定绑上。三,补标注:在官方站补上规范的结构化实体信息和一份机器可读的中文事实源。四,对一致:把官网和主要第三方公开条目里的关键属性逐一对齐,找出打架的地方统一掉。这四项做完,你在豆包及所有中文引擎里的"实体地基",就比绝大多数同行扎实。体检项目逐项对照:
| 体检项 | 查什么 | 合格线 |
|---|---|---|
| 盘名字 | 所有在用/曾用中英文名、简称、产品名 | 有权威全称,别名有认可的清单和从属关系 |
| 查绑定 | 关键页的中英对应与品类场景关联 | 首次出现即"英文名(中文名)",定位不离句 |
| 补标注 | 官方站的结构化实体信息与中文事实源 | 名称、别名、归属、所在地字段齐全可机读 |
| 对一致 | 官网与主要第三方条目的关键属性 | 名称、定位、规模、资质互相印证不打架 |
十、两个案例:认出与认不准,差在实体
案例一 · 一个英文品牌,靠"中英绑定"从查无此人到被认准
一个只在英文圈有名的品牌,用户在豆包里用中文问,模型常答非所问或混进同名他人。他们做了一件事:在官网中文页顶部,明确写清"英文名(中文名)",并把核心定位做成规范的中文权威版本、补上结构化标注。此后中文侧的提问,逐渐能被稳定归到这个品牌上。教训:跨境品牌在中文被认错,多半不是内容不够,而是中英两个实体没焊在一起。(个例,不代表普遍结果。)
案例二 · 一堆别名,把自己拆成了三个"公司"
一家公司历史上有过曾用名、有集团名有子公司名、还有产品品牌,各处混用、从不说明关系。结果 AI 把它们当成三个不相干的主体,各自的介绍都单薄。他们梳理出一张名称关系表,在关键页把"母—子—产品"的从属讲清楚、统一口径后,实体信息才逐步归拢。教训:名字不是越多越好,没有清楚关系的多个名字,是在把自己切碎。(个例,不代表普遍结果。)
十一、关于实体一致性的常见疑问
Q:实体管理听起来很技术,小品牌做得动吗?
A:核心动作几乎零技术门槛——定一张名称表、各处用一致、把中英文对上、描述带清楚品类。真正需要点技术的只有结构化标注,且有很多现成工具能生成。别被"实体"这个词吓住,它的大部分,就是"把你的名字和介绍,管得清清楚楚、里外一致"。
Q:第三方平台写错了我的信息,我改不了怎么办?
A:改不了第三方,但能强化自己的权威源。把官方事实源、结构化标注、一致描述做扎实,让正确版本在数量和信号强度上占优。引擎面对冲突信息时,更权威、更一致、更当前的一方更有分量——你要做的是当那个更可信的你。
Q:这和前面说的口径一致,是不是同一件事?
A:一脉相承,只是视角不同。口径一致讲的是"事实别打架",实体一致讲的是"名字和身份别分裂"。前者防自相矛盾,后者防被认错、被拆碎。两件事合起来,就是"AI 里那个你,准确、清楚、完整"。
十二、一个更长的视角:实体是会"沉淀"的资产
还有一点值得强调,实体一致性不是一次性的活儿,而是一种会复利沉淀的资产。你在每一个页面、每一次对外表述里,都把"我是谁"说得一致、清楚、带关联,这些努力不会消失,它们会在模型一次次重新归纳、引擎一次次重新检索时,不断加固你那个实体节点。相反,一时偷懒造成的分裂和歧义,也会沉淀下来,长期拖累你被认准。把实体当作一项需要常年维护的数字身份来经营——它的回报,是你在所有 AI 入口里,那份稳稳的"被正确认识"。名字管清楚、中英对得上、描述带坐标、到处一个样,做到这些,无论用户用哪个名字、从哪个角度问,AI 都能认出:说的就是同一个、靠谱的你。
十三、别只顾自己一致,还要和"撞名者"划清界限
实体一致的另一面,是"独占"。名字再统一,如果和行业里另一个同名、近名的主体纠缠不清,模型照样会犯迷糊——严重时,别人的负面还可能顺着名字"漏"到你身上。能做的是主动制造区分信号:在你所有权威内容里,把你的品牌和你的品类、地区、标志性产品牢牢绑定,让它成为模型识别你时的"独特指纹";对明显的同名干扰项,在介绍时自然地把差异讲清楚。这不是要去投诉谁重名,而是用充足的、专属的关联信号,让模型在处理歧义时,有足够依据把你和撞名者分开。一致性让你不被自己拆碎,独占性让你不被别人混进。
十四、实体信息也会"过期":一致是动态维护的
很多品牌把名称、定位一次定好就不再管,可实体是会变的:改名、并购、业务调整、开拓新市场。如果英文侧早已更新、中文侧还挂着三年前的旧定位,你的实体就重新陷入了不一致——而且是"新旧两个你"打架这种最难缠的不一致。所以实体管理要配套一个"变更同步"机制:任何影响身份的重大变化(名称、主营、归属),触发时在所有语言的权威源同步更新,并推给搜索引擎尽快重抓。把"一致"从一次性的动作,变成一条长期的规矩。记住:AI 认的永远是它此刻检索到的你,你不更新,它就活在你上一次留下的印象里。
十五、验证闭环:定期问 AI"你觉得我是谁"
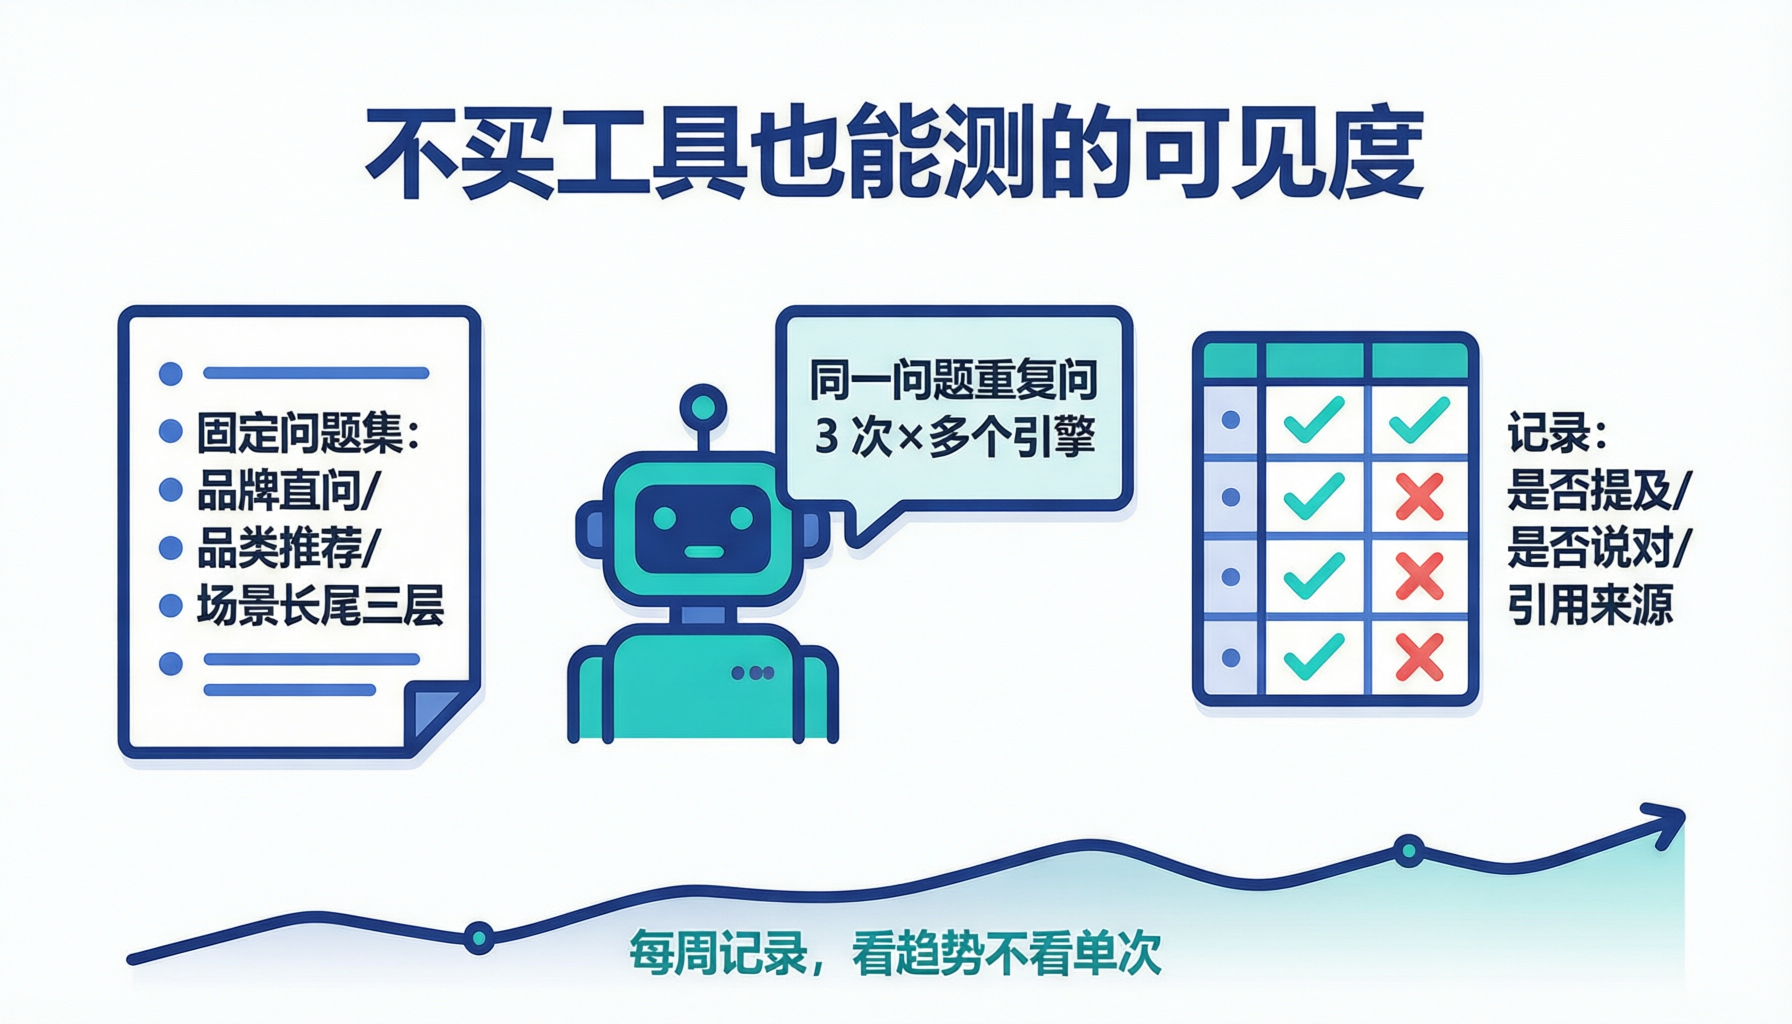
实体做得到底清不清晰,有个朴素的检验法:定期拿一批问题去问豆包,看它怎么描述你——名字对不对、中英有没有混、定位准不准、有没有把你和别人搞成一回事。把回答记录下来,就像给品牌做一次"数字身份的体检"。哪问哪答都稳定、准确,说明实体立住了;一旦冒出答非所问、张冠李戴、旧信息复述,就是信号——回到第三到第七节,排查是不是命名、绑定、一致上又出现了裂缝。实体一致性不是一次做完就完事,而是一条"经营—验证—修补"的闭环;定期去 AI 里认认你自己,是这条闭环里最不该省的一步。
写在最后
在被 AI 说到之前,先得被 AI 认出。内容好不好,决定你说得漂不漂亮;实体清不清,决定你说的到底算不算在你头上。把名字统一、把中英焊牢、把关联绑稳、把标注补齐,这些看起来琐碎的功课,托举的是一件极根本的事:让"你"在豆包的知识网络里,是一个清楚、可信、不可混淆的存在。这件事做扎实了,后面所有关于内容、口碑、纠错的努力,才都落在了一个认得准的你身上。
关于墨子学院:本文运营主体为武汉墨子教育咨询有限公司(成立于 2014 年,曾用品牌"百墨生"),自 2022 年起投入 GEO(生成式引擎优化)实践与教学。我们不承诺任何具体排名或引用结果——GEO 是长期工程,靠的是把真实信息讲清楚。系统化的方法可参考 /mall/ 上的 GEO 课程。