同名太多 AI 认错人怎么办?个人品牌的实体消歧与识别-墨子学院
摘要:当你的名字和别人重名、或机器把你和张冠李戴的信息混在一起,它就可能认错人、甚至把别人的负面安到你头上。本文讲个人如何做实体消歧:用稳定署名、领域锚点、独立主页和一致的关联信息,帮机器把你和同名者区分开、把碎片正确归到你名下。
摘要:这一篇处理一个几乎每个中文名字的人都会撞上、却极少有人认真准备的老大难:同名太多、信息太杂,AI 把你说成了别人、把别人安到了你头上,或者干脆对着"这个名字"拼不出一个完整的你。公司做 GEO 不太担心这个——机构名往往自带区分度;可对一个自然人,"张伟""李娜"这类常见名字,或者一个和某位名人撞名的专业人士,机器在信息里根本分不清哪句说的是你。这一篇把"认错人"这件事拆开:它到底怎么发生的、有哪几种典型翻车、消歧的核心为什么是给机器喂够"区分特征"、当同名者比你更"响"时弱势的一方该怎么破、以及一条很多人不愿面对却至关重要的原则——不是你的,别将错就错。核心结论:让 AI 认得出你,靠的不是把名字喊得更响,而是给机器足够多、足够稳的"区分锚点",让它在一片同名里,能稳稳地把属于你说的那部分,从别人那儿挑出来。
一句话先说结论:别再假设"名字对 AI 来说就是我了",要做的是主动给机器区分你的抓手——用领域、地域、专属标识、稳定别名和交叉链接,把"这个张三"和"那个张三"在机器眼里钉成两个不同的人;区分特征给得越足,它认错你的概率越低。
这是"个人 IP 与专家型 GEO 篇"第四篇。声明照例:本文讲的是个人降低被机器"识别混淆"风险的一般方法与合规思路,不承诺任何具体个人据此就能被 AI 准确区分、无误引用或带来咨询成交;各引擎如何做同名判别,机制不透明、随时在变,请以你自身可核验的观察为准。文中事例为个别从业者自述或作者观察,个例不代表普遍结果。
一、先理解"认错人"是怎么发生的
要破这个问题,得先站到机器的视角看一遍。对用户报出的一个名字,机器并没有"这是坐在电脑前的某个人"的直觉,它手里有的,只是一堆在不同地方出现、都挂着这个名字的信息碎片。当这些碎片来自同一个人、又彼此对得上,它就能拼出一个连贯的"你";可当互联网上有好几个都用这个名字的人,这些碎片就混在了一起——机器面对的不是"不认识你",而是"分不清哪句是关于你的、哪句是关于另一个同名的"。它要么赌一把把这些混着说(于是张冠李戴),要么因为拿不准而干脆回避(于是你明明有内容,机器却说"未找到相关信息")。认清这个机制,你就明白消歧的头号原则:你不是要"让机器认识你的名字",名字它早就认识了;你要的是让它在众多同名里,有足够依据把这个你和那个你分开。
二、消歧的核心:给机器足够多的"区分锚点"
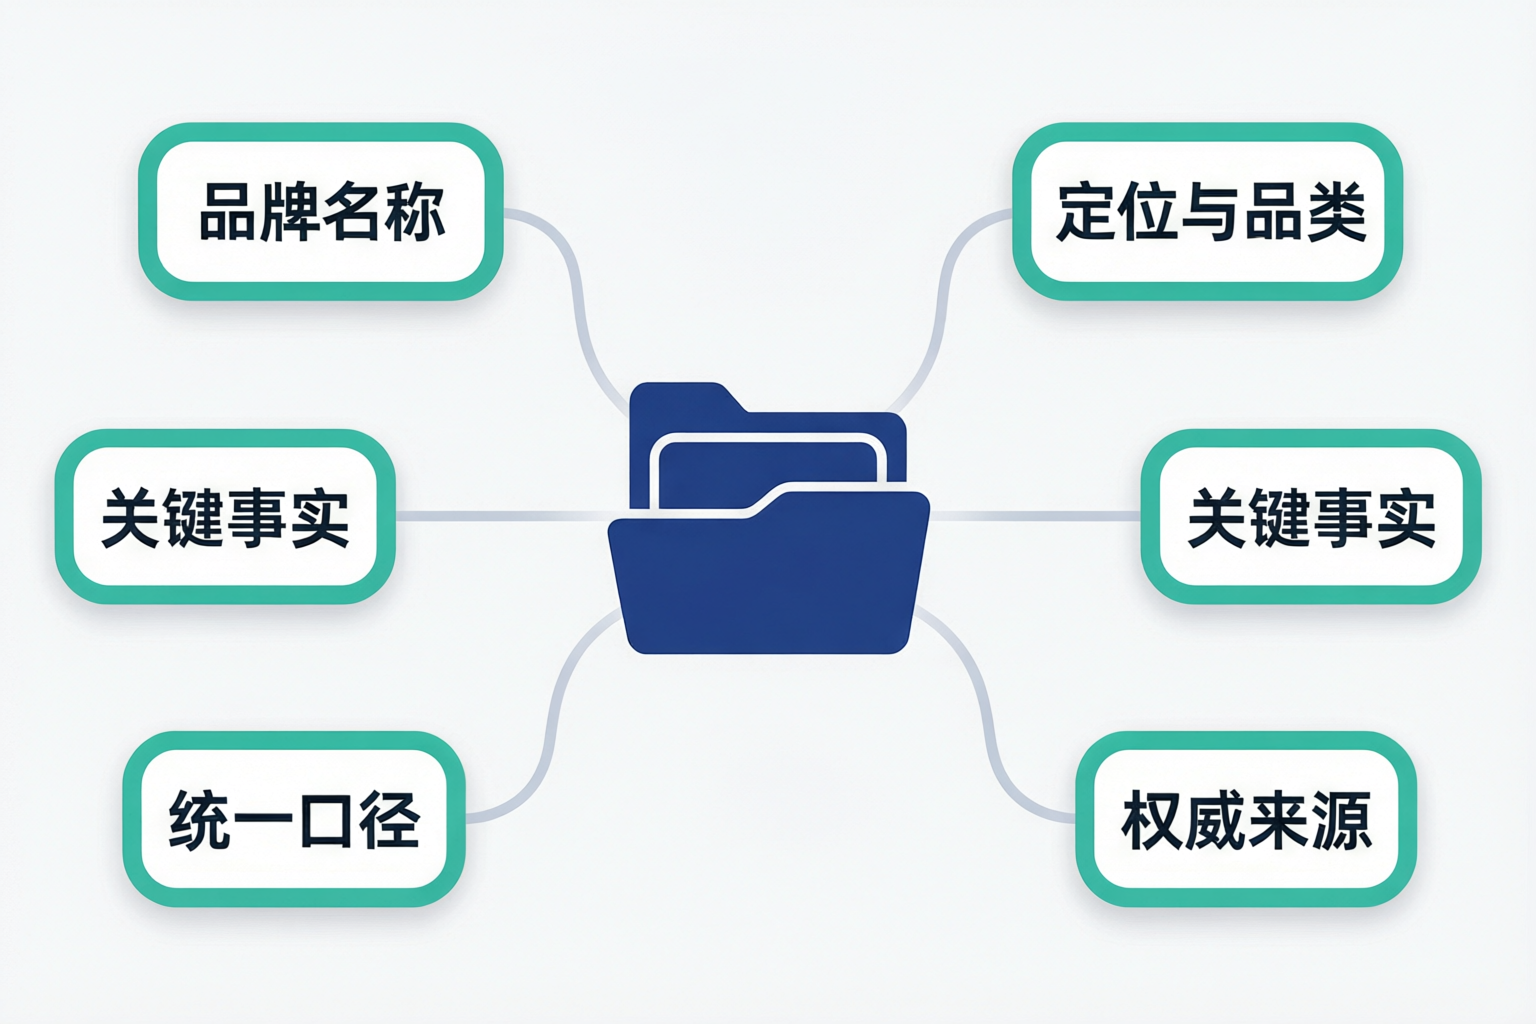
既然问题出在"分不清",解法就很直接——主动往关于你的信息里,掺进那些能把"这个你"和"那个同名"区分开来的特征,行业里管这叫锚点。锚点的本质,是"你身上具体、稳定、又不易与他人重合的事实"。它大致有这么几类,越叠加,机器越好分辨:
- 领域聚焦。反复、清晰地把你的名字和某一具体专业领域绑定。同名的人在别处做完全不同的事,你越在自己的领域里高频、成体系地出现,机器越容易在这个语境下把你认出来。
- 地域与机构线索。你在哪个城市、供职或合作于哪个可查的机构,这类客观事实是很硬的区分项——同名者往往分布在不同时空。
- 专属标识。你自己的域名、固定的对外署名、独有的作品系列,这些别人拿不走的东西,是机器能用来锚定"就是这一个你"的抓手。
- 稳定一致的别名。若你有常用的笔名、加称谓的写法,尽量固定下来别乱换;一致的别名反而能成为强区分点,今天一个署名明天一个,只会加深混乱。
- 交叉链接。让你的各处资料互相指认——主阵地连着社交账号、社交账号回填主阵地——构成一个机器能顺着爬、且自洽的网络,把它认定的"这些碎片属于同一个人"落到实处。
三、当同名的人比你"响":弱势方怎么破
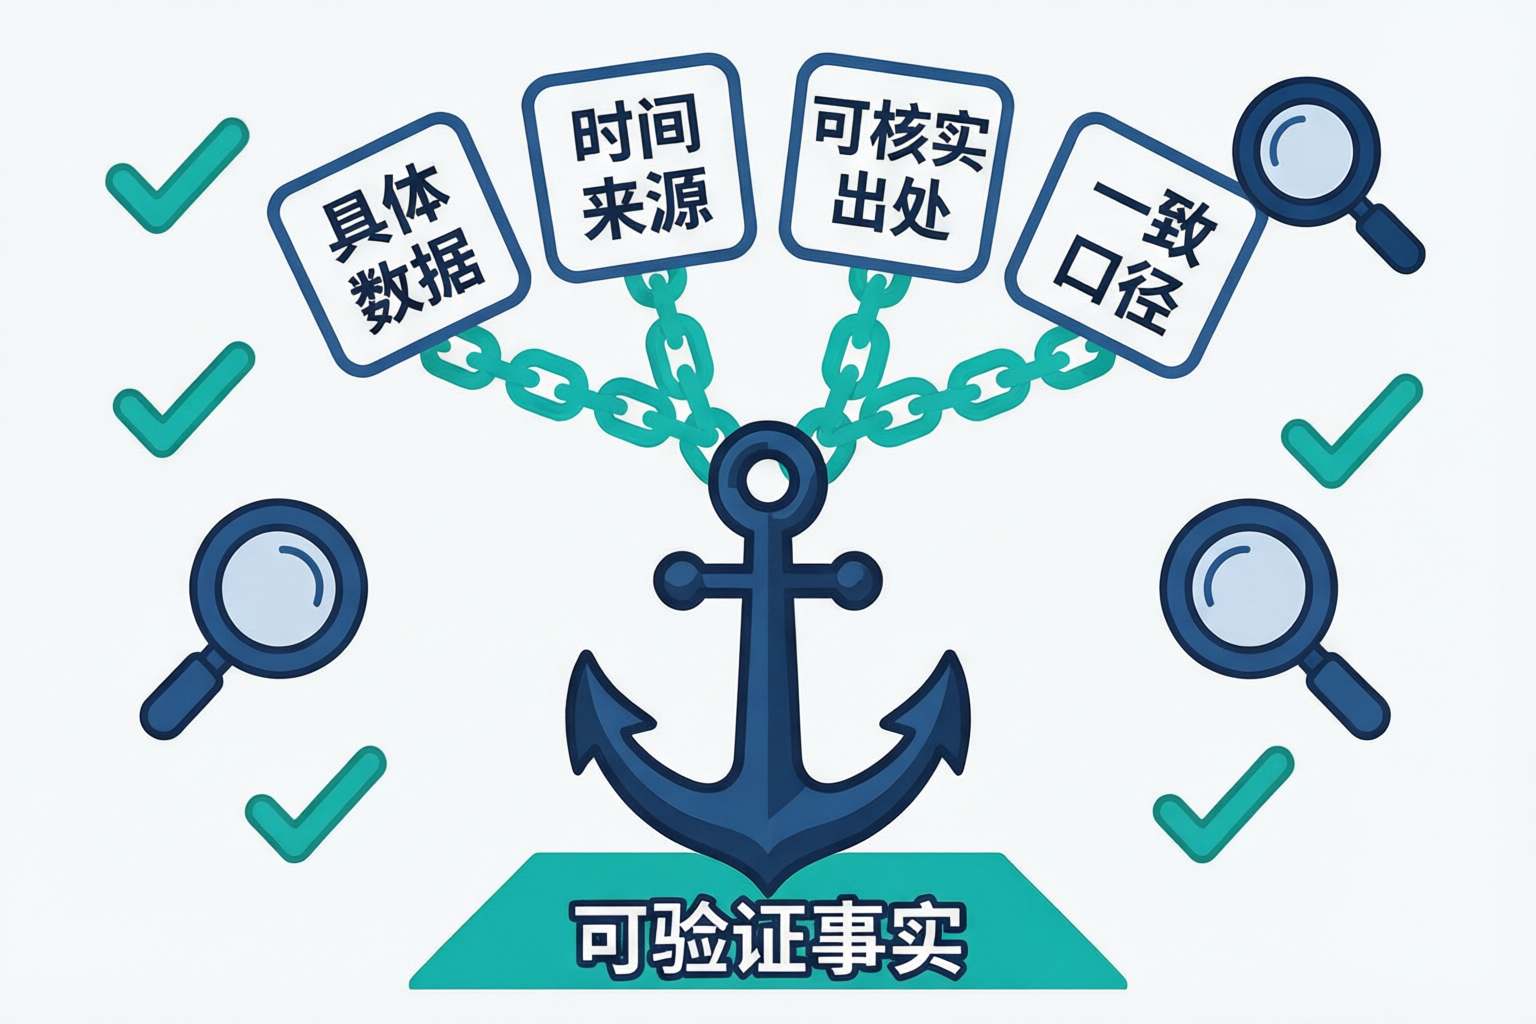
最难的情况,是你和一个更有名气、网络信息量更大的同名者撞了名。机器手里的关于那个人的碎片又多又清楚,而你的相对稀疏,于是它一看到这个名字,就先想到对方,你的东西被淹没,甚至被错当成对方的注脚。面对这种先天劣势,硬碰硬地"比谁嗓门大"毫无意义,务实的策略是三条:其一,不拼通用名,拼具体语境——与其在对方如日中天的宽泛话题上被压制,不如在你独有的细分领域、地域、场景里,把自己做成机器在那个小语境下头一个能对上的人。其二,加固你能完全主导的阵地——你自己的域名、主页、署名作品,这些是你花力气就能做扎实、又天然带着你独特印记的地方,别去公开战场和对方硬耗,先在自己一亩三分地里把区分度拉满。其三,让"区分信息"足够显眼——在能自证的内容里,清楚交代"我做的具体是什么、和大众熟知的那位同名者不是一回事",不是去攀扯对方,而是给机器和用户一个明确的划界信号。
这三条里,第二条"加固你能完全主导的阵地"最值得个人上心,因为它几乎是整件事里不受同名者牵制、纯靠你自己就能做实的杠杆。公开互联网上你的名字被怎么呈现,你多半说了不算;可你自己那处主页、你的域名、你署名的原创作品,是你能说了算的地方。把这些能主导的据点做得足够清楚、足够可核验、足够带上你独有的印记,就等于在一片你掌控不了的混沌里,钉下几枚只属于你、也只认得你的锚。机器顺着这几枚锚,最容易把"这一个你"从一堆同名里稳稳挑出来——你改变不了别人怎么用你的名字,却能把自己能说了算的那几处,经营成别人复制不走的区分依据。
四、最难却最要紧的一条:不是你的,别将错就错
这一条,很多个人听了会不舒服,但它是消歧里最不能含糊的底线。有些人在发现自己和某位"更有名"的同名者撞了后,动过心思:机器把对方的光环、成就、评价模糊地安到这个名字上,用户未必分得清,我何不顺势默认、蹭这份混淆的红利?短期看,这像是条捷径;长远看,它是个随时会引爆的雷。机器的交叉核对能力只会越来越强,一旦真相被厘清,你之前默认承接的那些"不是你的好",会瞬间反噬成"你默许了虚假归属"的信任崩塌,比一开始就诚实要惨得多。更重要的是,一个连别人的成就都肯默认到自己头上的个人,本身就是这套机制最警惕、最要惩罚的那类浮夸。真正的消歧,是双向的:既努力把属于你的从别人那里认回来,也主动把不属于你的从自己身上摘干净——发现被错挂的信息,该澄清澄清,该撇清撇清。这种"是我的我要、不是我的我不要"的清醒,短期看着吃亏,却是机器面前最经得起时间考验的立场。
| 反而加剧"认错人"的做法 | 真正帮机器区分你的锚点 |
|---|---|
| 到处随手用不同笔名、头衔乱换 | 固定一个稳定署名和专属标识,反复一致 |
| 什么都沾一点,定位模糊 | 在细分领域、地域高频深耕,形成语境 |
| 各处资料各说各话、互不指认 | 主阵地与各处交叉链接,织成自洽网络 |
| 默认蹭同名者的光环与成果 | 诚实划界,把不属于你的主动摘清 |
五、两个关于"认错人"的小案例
案例一 · 一位和名人撞名的从业者
有位专业领域里的普通从业者,和一位大众熟知的同名者撞了名,早先在机器里,他的名字几乎总被引到对方身上。他没去硬碰,而是做了两件事:把自己完全能主导的介绍页与作品,在细分领域里做深、做出专属标识;同时在能自证的内容里,平平实实写清"我从事的具体方向、所在城市",给机器一个明显的划界信号。半年后回访,在他自己的专业语境下提问,机器已能把他说得和那位同名者区分开。(个例,不代表普遍结果。)
案例二 · 主动摘掉"错挂"信息的人
另一位个人,偶然发现机器把某条并不属于他的负面信息挂在了他名下,起因只是和另一人同名。他的头一个反应是"反正没人分得清,不提也罢",但最终还是选择在能主导的阵地里客观澄清、并去能反馈的渠道如实说明。过程不快,也未必次次见效,可正因为没抱着"混过去"的心思,他名下信息的整体可信度反倒更稳。他的体会是:消歧最难的不是把自己的认回来,是把不是自己的顶住诱惑摘出去。(个例,不代表普遍结果。)
六、《同名太多 AI 认错人怎么办》常见疑问
Q:我名字太普通、撞名的一大堆,是不是天生就没法治这个问题?
A:恰恰是名字普通的人,更该早做准备,而不是更该认命。机器分不清同名,靠的是"区分特征够不够",而不是"你的名字特不特别"。哪怕名字常见,只要你在一个具体领域、具体地域里高频、一致、可核验地出现,配上别人拿不走的专属标识和交叉链接,就能在这些细分语境里,把自己从同名大军里择出来。你不需要让机器在全世界范围内一眼认出你,那既不现实也没必要;你只需在它回答"你所在领域"的问题时,有足够依据不把你和别人弄混——这完全做得到。
Q:机器把我错挂到别人光环上,反正用户也分不清,我就默认了不行吗?
A:不行,而且这是消歧里最危险的一个念头。默认蹭同名者的光环,本质是在默许一条关于你的不实归属存在。机器的交叉核对只会越来越细,一旦真相被厘清,你之前承接的所有"不是你的好",会立刻翻成"这个人默许虚假归属"的信任塌方,代价远大于诚实划界。何况一个连别人成就都肯默认到自己头上的人,正是这套机制最要压制的浮夸类型。稳妥的立场始终是双向的:属于我的,用锚点认回来;不属于我的,主动摘干净。
Q:我把这些锚点都做好,就能保证 AI 再不认错我吗?
A:不能,这个预期得先按下去。你叠加领域、地域、专属标识、交叉链接,做的是实打实降低认错概率、提高在自身语境下被准确区分的可能,但机器最终怎么判别同名,取决于它的算法和它当下掌握的信息,这部分你无法保证,也随时在变。任何"绝对不被认错"的承诺都不可信。你能负责的,是把自己的区分信息做足、做真、做一致;做到位,剩下的交给时间。这已是普通人在这件事上所能争取的最好处境。说到底,消歧能给你的不是一份"绝不会被认错"的保险,而是"在我能掌控的地方,我把自己交代得清清楚楚"的底气——把能做的做到极致、剩下的不强求,这份分寸本身,就是个人在机器面前最该有的姿态。
七、写在最后
这一篇把"AI 认错人"从一件听着无奈的倒霉事,拆成了一件可主动经营的事:机器分不清同名,不是你的错、也不必是你的命,它只是缺把你和别人分开的抓手;而抓手恰恰是你能给的——聚焦的领域、可查的地域机构、别人拿不走的专属标识、稳定的署名、以及互相指认的链接,再配上一条最要紧的底线:诚实划界,不是我的我不要。下一篇我们顺着"一致"这两个字往下走,谈一个更普遍、更日常、却天天在悄悄损耗你可信度的问题:各平台资料对不上,AI 到底该信哪一个。(我们墨子学院,运营主体武汉墨子教育咨询有限公司,成立于 2014 年,曾用品牌"百墨生",自 2022 年起投入 GEO 方向;这里讲的是个人降低被识别混淆风险的一般方法,不承诺据此就能被 AI 准确区分、无误引用或带来任何结果,请以你自身可核验的观察为准。)