自定义 GPT 与 GPT Store:把品牌做成一个能被随时调用的入口-墨子学院
摘要:越来越多人通过自定义 GPT 和 GPT Store 使用 AI,品牌既能自建官方助手、也会成为第三方 GPT 引用的资料。本文讲这条新入口对 GEO 意味着什么、官方 GPT 怎么做才靠谱、以及当第三方拿你的资料搭助手时如何保证口径正确。
摘要:ChatGPT 不只是"用户问、它答"。它还有一个容易被品牌忽略的入口——自定义 GPTs 与 GPT Store:任何人都能把一套资料、一套指令做成一个专属助手挂上去,用户直接向这个助手提问。对品牌来说这是一枚硬币的两面:一面,你可以把官方知识做成一个靠谱的品牌 GPT,让用户问到的每一句都源自你的权威口径;另一面,第三方也能做"关于你"的 GPT,还有用户会在别人的 GPT 里问起你——这些地方你说的算不算数,同样是 GEO 的战场。本文讲自定义 GPT 的取答逻辑、品牌该怎么做一个能被发现的官方 GPT、怎么防住走样的第三方版本、以及这条线和常规 ChatGPT 引用怎么配合。核心结论:当用户绕过通用问答、直接进某个 GPT 里了解你时,你得确保那里放的是你自己的、最新的、口径一致的资料。
一句话先说结论:自定义 GPT 把"品牌怎么被 AI 说"从一个被动结果,变成了一块可以主动经营、也可能被他人抢注的阵地——你要么自己立一个准的,要么就得防住别人立一个歪的替你发声。
前面几篇我们聊的都是通用 ChatGPT 怎么检索、怎么引用。但真实使用中,越来越多用户不是对着通用对话框问,而是进了某个专门的 GPT——一个"翻译助手""市场调研专家""某产品使用顾问"。这些 GPT 各自带着一套私有资料在作答,通用问答那套"看谁被搜索引擎收录"的逻辑在这里并不完全适用。这一篇把这条容易被忽视的线补上,尤其是跨境品牌做 GEO 时,GPT Store 是一个既能自己占位、又可能被别人抢跑的入口。
一、自定义 GPT 是怎么作答的:私有指令加知识库
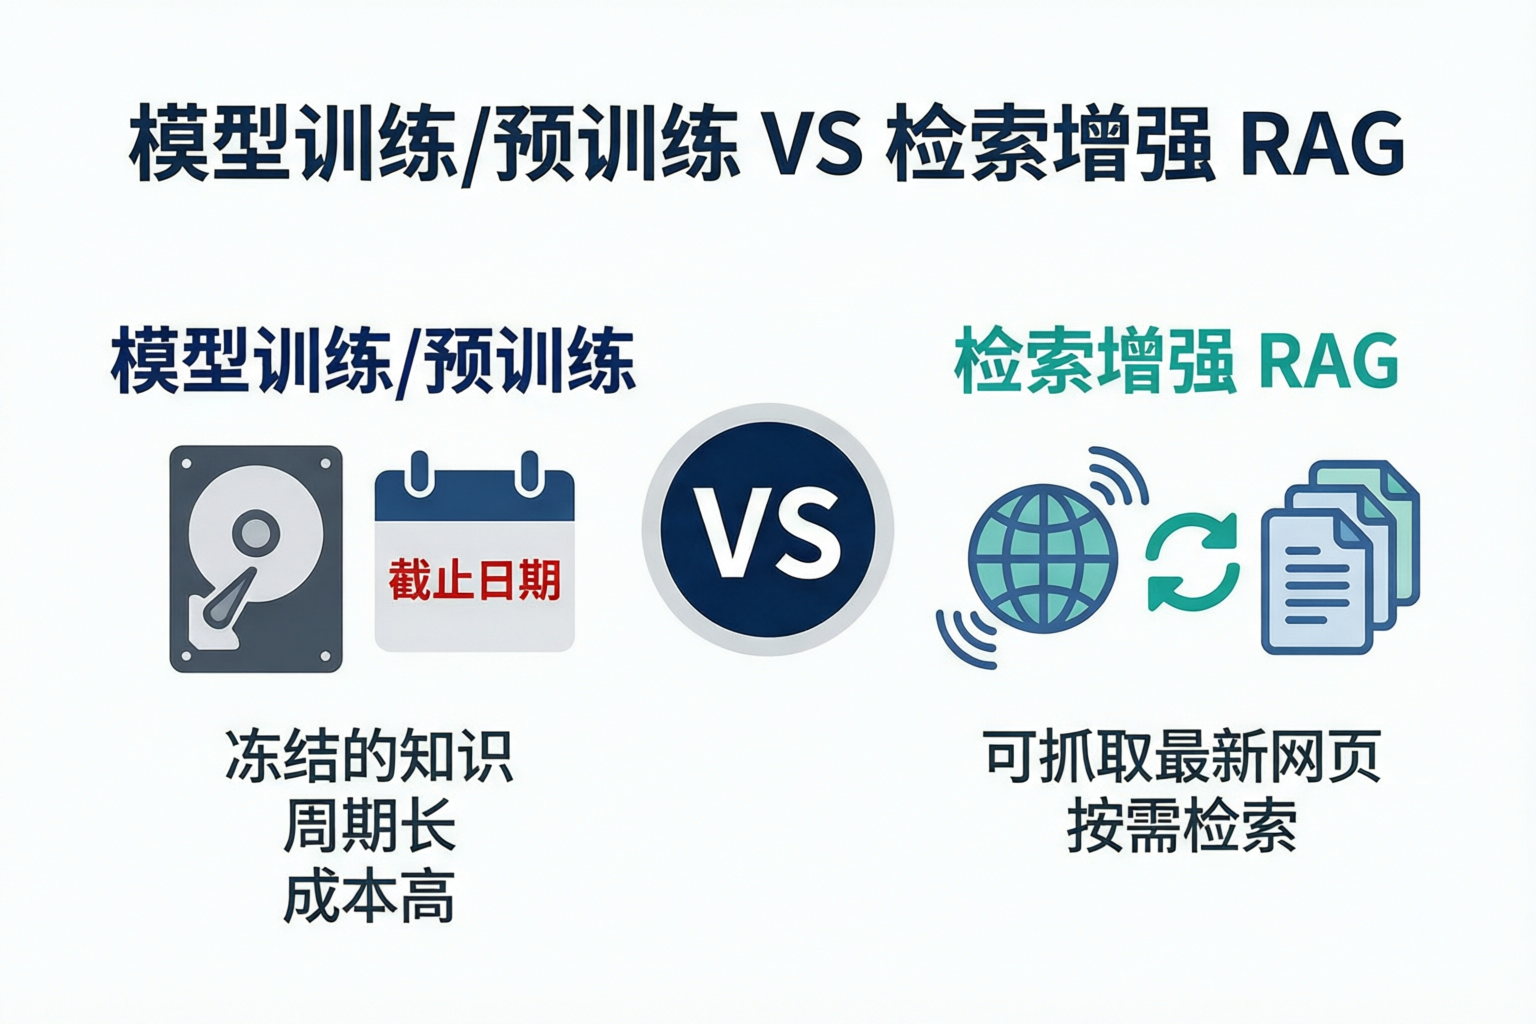
一个自定义 GPT,本质是"通用大模型+一份创建者写的指令+一批创建者上传的资料"。用户向它提问时,它优先按创建者设定的角色、口径去答,依据的是那份知识库里的材料,而不是临时上网检索(是否联网取决于配置)。这和通用问答差别很大:通用问答面向整个开放网络挑来源,自定义 GPT 主要在一个封闭的小资料库里取答案。这对品牌的含义是双重的。好的一面:如果你把官方资料做成一个 GPT,用户问到的关于你的一切,几乎都由你亲手放进去的内容决定,可控性远高于通用问答。坏的一面:这份资料一旦过时、写错,它会稳定地、反复地给出同一个错误答案,而且因为披着"专属助手"的外衣,看着比随手一条搜索更权威。做 GPT,等于把一个'会替你说话的分身'放了出去,它说得准不准,全看你喂的资料。
二、为什么品牌该认真考虑做一个官方 GPT
官方 GPT 的价值,在于它把"用户怎么了解你"这件事,从碰运气变成了可设计。其一,口径可控。产品怎么用、参数是多少、边界在哪、和别家比怎样,这些你说了多年的话,可以整理成一份结构清晰的知识库放进 GPT,用户问到的就是你能背书的那版,而不是散落在各处、被拼接走样的说法。其二,体验更专。通用问答给的是泛泛一段,一个训练好的官方 GPT 能针对你的产品场景答得更细、更贴合,这本身就是服务。其三,多语言友好。跨境品牌可以分别为不同语言市场配置贴合当地表述的资料,让英文用户和中文用户问到的都是对应语言里最准的那版。
不过要说清楚:官方 GPT 是被"发现"的入口之一,远不是全部。用户不会都来找你的 GPT,更多人仍在通用问答里问。所以官方 GPT 是锦上添花的一块阵地,不能替代把公开内容做扎实这条主线。它的定位是"当用户主动想深入了解你时,给一个最权威、最好用的官方口径"。
还有一点值得提前想清楚:官方 GPT 不是做个面子工程。它一旦放出去,就是拿品牌信誉为那份资料背书——答得好加分,答得离谱同样砸锅。所以值不值得做,取决于你能不能持续养它:有人对知识库负责、信息一变就同步、定期拿真实问题回测。如果你没把握做到持续更新,宁可先把它当成一个"把公开资料整理干净"的副产品,也别急着一个长期没人管的助手。一个半死不活、资料过时的官方 GPT,比没有更伤信任。
三、怎么让一个品牌 GPT 被找到:命名、描述与可信度
做好了还得有人用。GPT Store 里有海量助手,一个能被找到、被人信任的品牌 GPT,得在几处下功夫。名字要清楚。直接带上品牌与用途(比如"某某产品官方答疑"),别起让人猜不到的花名,用户在搜索框里输入品牌名时,你才可能被翻到。描述要讲清能干什么、资料来自哪。一句"依据官方最新文档回答关于某产品的使用与选型问题",比一堆营销形容词更能建立信任。可核验的身份很重要。品牌方做出来的、能和官网对得上的 GPT,比来路不明的更容易被采信——这也提示你,公开渠道的品牌信息要一致、可信,为你的 GPT 背书。
还要提醒一点:别把一个 GPT 当成塞满广告话术的推销机。用户进到一个"官方助手",期待的是把问题答明白,不是再看一遍宣传。资料要如实、要涵盖真实会问的问题(包括限制、不适合谁、常见问题),诚实扎实的 GPT 才留得住人、才被愿意推荐。
四、资料怎么放才让它"读得准":结构、更新与边界
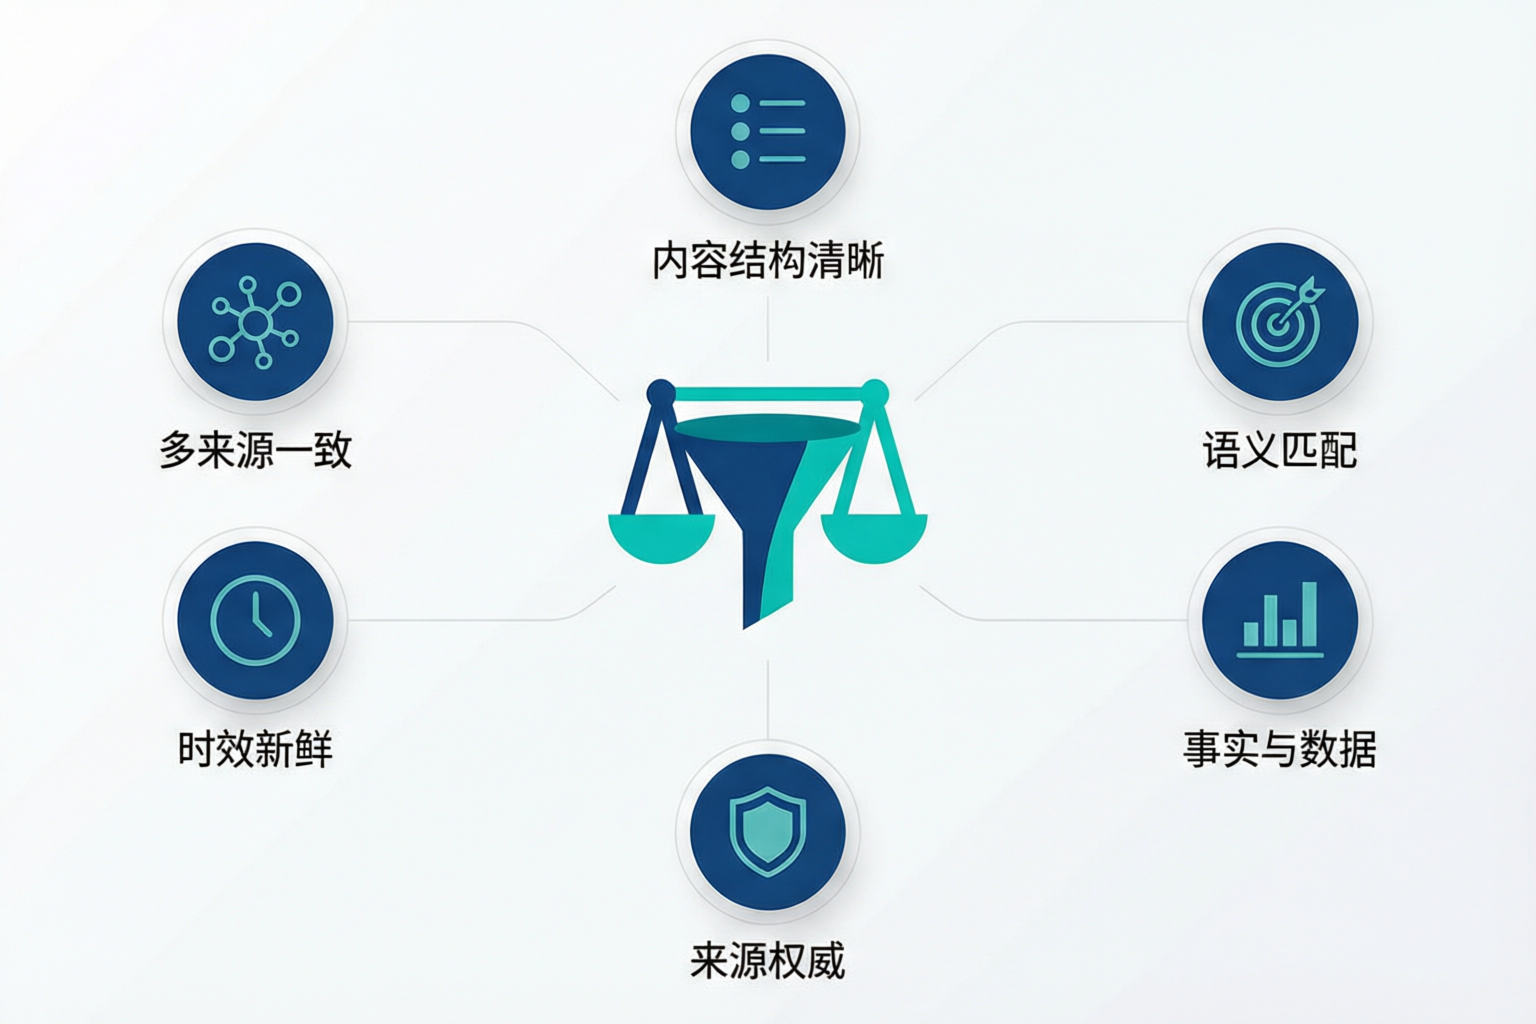
知识库不是把一堆 PDF 一股脑丢进去就完事。要让 GPT 答得准,喂进去的资料得自己先整理清楚。结论先行、一类一事。把每个主题(定价、功能、适用场景、常见问题、限制)拆成各自清楚的小块,别把五件事混在一段里,方便它按问题取对应那块。放事实,也放依据。关键数字带上口径与时点,避免它把旧数据当成现状。讲清边界。你不适合谁、不承诺什么、有什么限制,如实写进去——这既防止它过度承诺给你惹麻烦,也让回答更可信。留好更新机制。这是最容易翻车的地方:资料一旦上传就成了它的固定依据,你产品改了价、加了功能,如果没同步更新知识库,你的官方 GPT 会一脸认真地替你说半年前的版本,还比谁都显得权威。所以做 GPT 必须配一条"对外信息一变,知识库同步更新"的规矩,和你在通用问答里讲的"推新清旧"是同一个道理。
五、防住走样的第三方 GPT:你不在场时谁替你说话
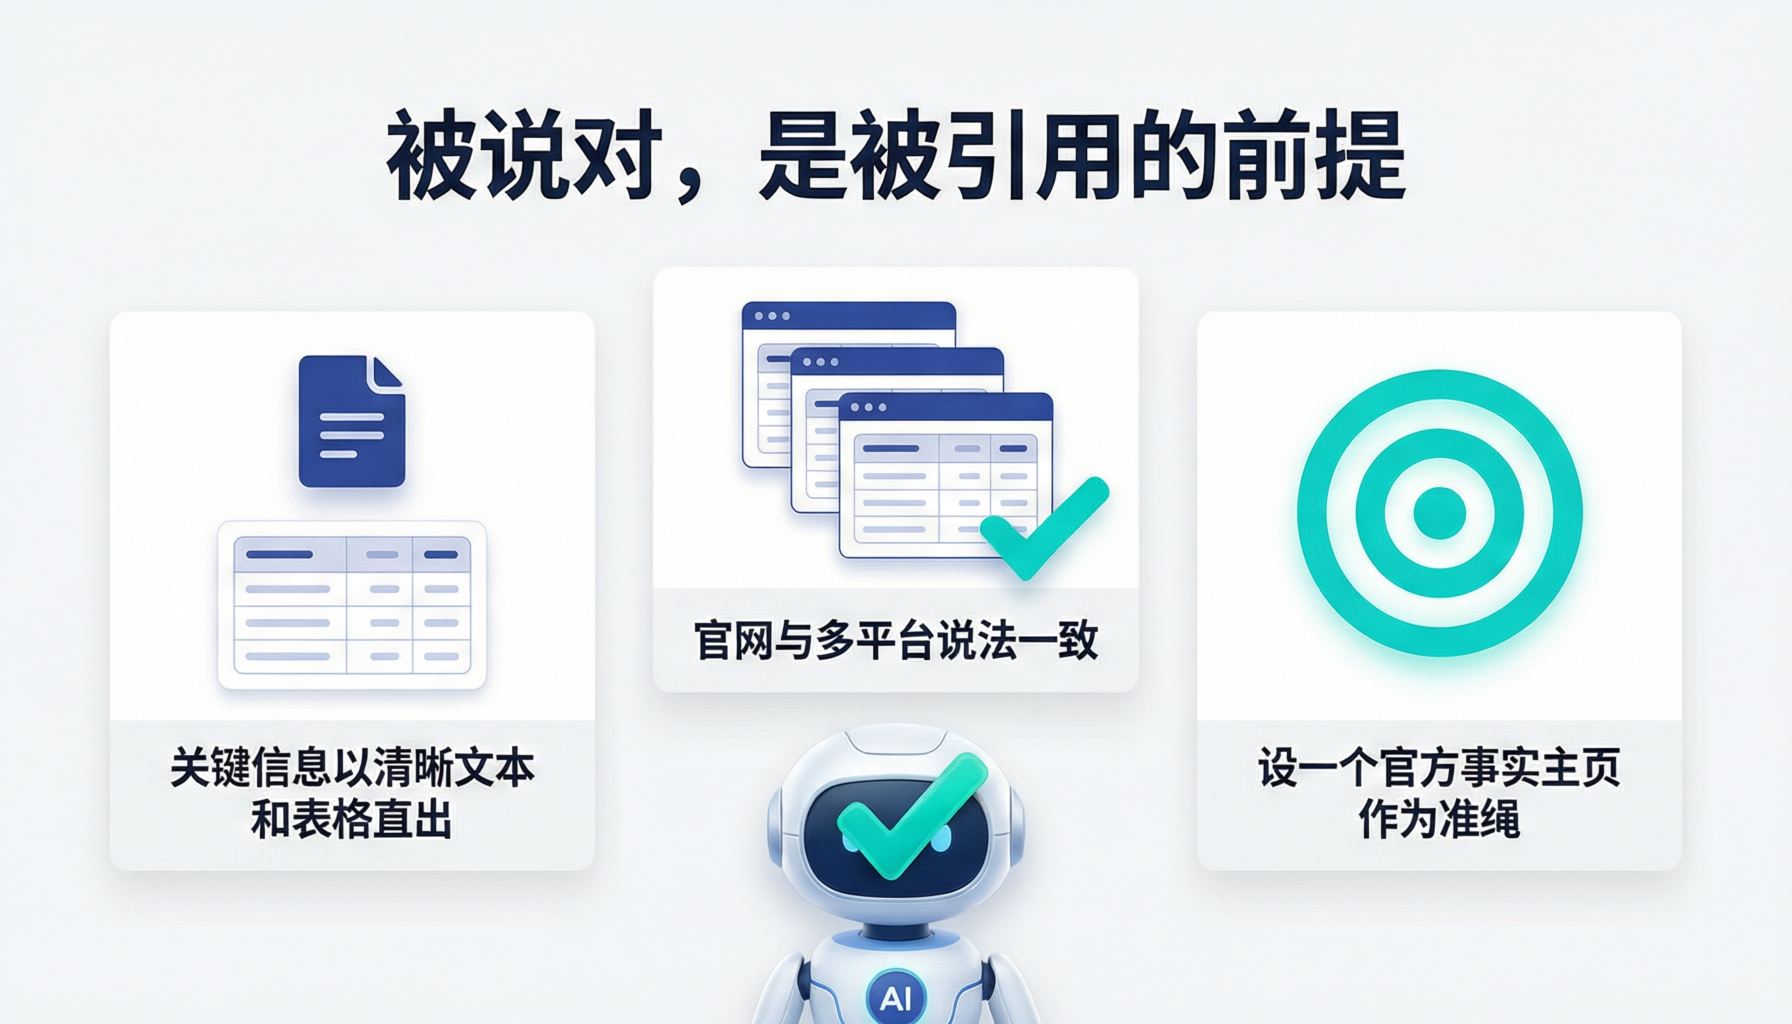
这是自定义 GPT 这条线最容易被忽略的风险。任何人都能建一个"关于你"的 GPT——某个爱好者、某家经销商、甚至某个带偏见的人,都可能拿一份过时或写错的资料,做一个看似专业的"某产品助手"。用户分不清官方与第三方,进去一问,得到的关于你的信息全由那份你没见过的资料决定。它引谁、就怎么说你,这条铁律在 GPT 世界里更直白,因为整个资料库可能就是一份以讹传讹的东西。务实的应对不是想着删光第三方(你够不着、也删不完),而是:一,把自己那个官方 GPT 做扎实、做到容易被找到,让真官方版本在检索和口碑上压过走样版本;二,把公开渠道关于你的基础信息(官网、权威介绍、常见问答)做准做新,让第三方做 GPT 时能抄到的是对的版本;三,若确有严重失实且影响大的第三方 GPT,通过平台正规渠道申诉。本质还是那句话:你不主动把准的说清楚,别人就会替你说个歪的。
这里有个容易被忽视的连锁关系:第三方做"关于你"的 GPT,手上并没有你的内部资料,他们能拿到的,恰恰是公开网络上关于你的那一份——你的官网、百科条目、评测、问答。这意味着你花力气把公开信息做准做新,不只是为了通用问答的引用,也是在给所有可能的第三方 GPT 提供一份"正确的底本"。你把地基打牢了,连那些你没参与、管不着的助手,也更可能拿对的东西去喂。正本清源的高明之处,在于它不靠堵住每一张嘴,而靠让正确的版本成为最容易抄到的那一版。
六、常见误区
- "做了官方 GPT 就等于做好了 ChatGPT GEO。"它只是被发现的入口之一,多数用户仍在通用问答里问,公开内容的地基一点都不能省。
- "资料传上去就一劳永逸。"知识库是静态依据,产品变了不更新,它会稳定地反复给你错答案,还格外显得权威。
- "把 GPT 塞满宣传话术显得专业。"用户要的是把问题答明白,全是广告词反而留不住人、也降低可信。
- "第三方 GPT 说错了我也无能为力。"你删不完,但能做强官方版、做准公开信息让第三方抄到对的,正本清源比堵嘴更现实。
- "名字越花哨越容易被记住。"在 Store 里被搜到靠的是清楚带上品牌与用途,花名只会让用户找不到、也被盗用。
七、把这条线接进监测:官方与第三方 GPT 一起盯
既然 GPT 能替你或替你反对发声,它就该进你的监测视野。对自家官方 GPT,定期用真实用户会问的问题去考它:答得准不准、用的是不是最新版资料、有没有过度承诺,发现偏差就去更新知识库。对第三方 GPT,在 Store 里搜一搜自己品牌名,看看冒出来了哪些"关于你"的助手、它们依据的是什么口径,严重失实的记下来按正规渠道处理。这块和你在通用 ChatGPT 做的固定提问集回测可以并到一起——只是这里问的对象从通用模型换成了具体的某个 GPT。把"AI 在替谁、用什么资料说你"这件事,从通用问答一直看到自定义 GPT,监测才算没有盲区。
监测里尤其要留意一种隐病:同一个问题,通用 ChatGPT 说的、你自己官方 GPT 说的、某个第三方 GPT 说的,三者可能各说各话。用户不一定分得清哪个是哪个,混在一起就成了对品牌的整体印象。所以别把 GPT 监测做成一堆孤立的表,而是并到你那套跨平台提问集里:同一批问题,既问通用模型,也问官方与热门第三方 GPT,横向一比,谁走样了、谁过时了,一眼就看出来。
八、两个案例:一个占对了位、一个吃了没更新的亏
案例一 · 官方 GPT 承接选型咨询,减少被第三方带偏
一家做工具类产品的团队,发现在 GPT Store 里搜自己品牌名,冒出好几个来路不明、参数还写错的"某某助手"。他们没有硬去逐个投诉,而是做了一个资料齐全、口径准确、命名清楚的官方 GPT,把常见选型、参数、限制都答透,并在官网和社群里引导用户认准官方版本。因为官方版更准更好用,被引用和推荐的比例明显上升,走样版本的影响随之变小。教训:与其堵别人的嘴,不如把自己的准版本立到最显眼。(个例,不代表普遍结果。)
案例二 · 改了价没同步知识库,官方助手反复报错价
一个品牌上线官方 GPT 后挺长脸面,直到用户反馈"你们的助手一直说旧价格"。复盘发现,调价只改了官网结算页,没人记得回头更新 GPT 的知识库,于是它拿着半年前那份资料一脸权威地报旧价。他们补了一条规矩:任何对外关键信息变动,官网和 GPT 知识库当天同步。之后类似乌龙没再出现。教训:静态知识库最大的坑是"你变了它没变",更新机制必须内置。(个例,不代表普遍结果。)
九、关于自定义 GPT 的常见疑问
Q:官方 GPT 会不会抢了通用问答的活,后面那个就不用做了?
A:不会,反而更说明通用问答重要。官方 GPT 只服务主动找上门的那部分用户,绝大多数人还在通用对话里随口问,那里靠的是你公开内容的质量与引用。两者是互补,不是替代。
Q:资料越多越好,把能传的都传进去?
A:不是。堆一堆互相冲突或过时的材料,只会让它取错、答偏。宁可少而准、结构清晰、保持更新,也别多而乱。质量、一致性、时效,远比数量要紧。
Q:第三方乱做我的 GPT,除了申诉还能做什么?
A:申诉能处理严重失实的少数,但更根本的是把公开渠道关于你的基础信息做准做新,让第三方做助手时能抄到正确版本;同时把自己的官方版做到容易被搜到、明显更好用,正本清源比挨个堵更有效。做 GPT 的人和用 GPT 的人,最终都会自然流向那个更准、更新、更像官方的版本。
写在最后
自定义 GPT 与 GPT Store 揭示了一个趋势:"AI 怎么说你"这件事,正在从一家平台的通用输出,扩散到成千上万个由不同人、用不同资料搭起来的小入口。你没法守住所有的门,但你完全能做好自己那间最亮的官方房间,并把屋外的招牌(公开信息)擦干净,让谁想介绍你都抄得到对的。把这条线纳入经营,你对 ChatGPT 的理解才算补上了"主动占位"这块拼图——不再只是被动等被引用,而是主动给用户提供一处可信、可依赖、由你亲自把关的官方答案。把这件事做扎实了,被引用只是顺势的结果。
关于墨子学院:本文运营主体为武汉墨子教育咨询有限公司(成立于 2014 年,曾用品牌"百墨生"),自 2022 年起投入 GEO(生成式引擎优化)实践与教学。我们不承诺任何具体排名或引用结果——GEO 是长期工程,靠的是把真实信息讲清楚。系统化的方法可参考 /mall/ 上的 GEO 课程。