Gemini GEO 上线前踩坑清单与 30 分钟体检:robots、hreflang、结构化、实体、口径-墨子学院
摘要:Gemini 背靠 Google,做 GEO 时既享受了 Google 生态的红利,也继承了 Google 二十年沉淀下来的一堆老规则。很多团队把 ChatGPT 上的打法直接搬过来,结果在 Gemini 上水土不服。本文把 Gemini 上最常踩的坑集中过一遍:只搬 ChatGPT 打法忽视 Google 侧、错把英文页当翻译页、robots 一行挡掉整个索引、结构化与正文对不上、实体跨语言不合、口径漂、把广告伪装成内容,并给一份上线前的 30 分钟体检清单。核心结论:Gemini 上大多数失败不是内容写得不好,是没通过 Google 的地基体检。
摘要:Gemini 背靠 Google,做 GEO 时既享受了 Google 生态的红利,也继承了 Google 二十年沉淀下来的一堆"老规则"。很多团队把 ChatGPT 上摸索出来的打法直接搬过来,结果在 Gemini 上水土不服——不是因为方法错了,是因为环境不一样。本文把 Gemini 上最常踩的坑集中过一遍:只搬 ChatGPT 打法忽视 Google 侧、错把英文页当翻译页、robots 一行挡掉整个索引、结构化标了但和正文对不上、实体跨语言不合、口径漂、把广告伪装成内容,并给一份上线前的体检清单。核心结论:Gemini 上的 GEO 与其说考内容能力,不如说考"你能不能同时守住 Google 的老规矩和 AI 的新习惯"。
一句话先说结论:Gemini 上大多数失败不是"内容写得不好",是"没通过 Google 的地基体检";把这份踩坑清单当 checklist 用,能在上线前把 80% 的返工省下来。
这一篇是 Gemini 系列的收官。前九篇我们把机制、地基、生态、实体、意图、结构、权威、监测都拆开讲了,读者大概率心里已经有了一张打法图。但真正上手时,很多团队还是会踩到一些本可以避免的坑——这些坑往往不是策略层面的,而是执行细节。我们把过去一年在不同企业做 Gemini GEO 时最常撞到的十来个坑整理成一篇,方便你在动手前先自查一遍。
一、只搬 ChatGPT 打法,忽视 Google 地基
最常见的失误:把 ChatGPT 那套"事实锚 + 结论先行 + 多来源印证"直接平移到 Gemini,忽略 Gemini 的取材池大量来自 Google 索引。表现是内容写得挺好,提问集里却始终不出现——一查 Search Console,页面根本没进索引,或被 robots 挡了,或 hreflang 配错让 Google 把英文页当成中文页的重复版。ChatGPT 上的内容原则在 Gemini 上依然有效,但前提是先过 Google 的地基这一关。动作:动手前先看 Search Console,确保重点页在索引里,再谈内容改造。
二、机器可读的技术坑:robots / noindex / canonical / hreflang
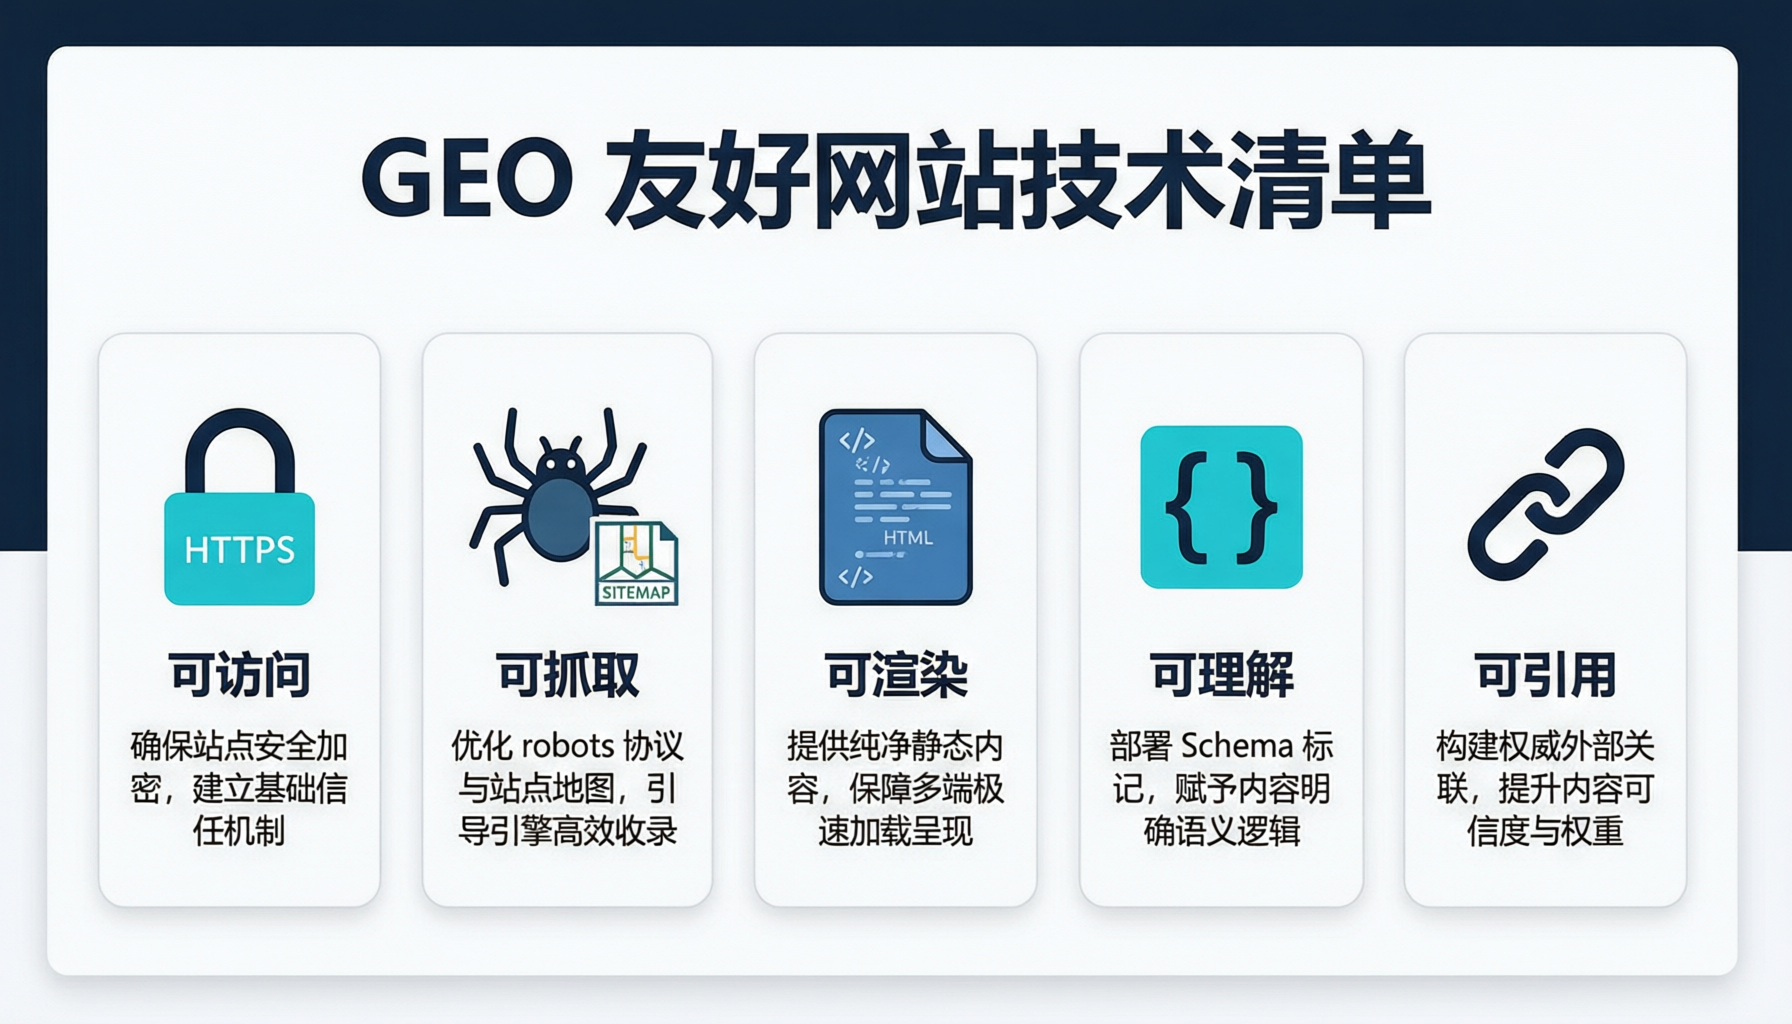
技术层最容易翻车的四个小地方:robots.txt 里遗留的测试规则把 Googlebot 整段拦掉、meta robots noindex 被误加到关键页、canonical 指向错误(比如所有语言版都指向中文主页,Google 会认为其它页面是重复内容)、hreflang 缺双向指向或指向不可索引页(多语言版归并会失败)。这些坑每一个都能让 Gemini 侧长期"看不见你"。上线前用 Search Console 的 URL 检查工具把重点页面过一遍,比事后回滚快得多。
三、把英文页当翻译页做,Gemini 取不动也不信
机翻腔的英文内容在 Google 眼里既难抽也不可信。它可能仍被索引,但很难被判为优质结果,AI Overviews 与 Gemini 也不愿意引用。务实做法是英文原生写:把要回答的那句问题(客户真会问的英文整句)当标题,正文用英文的"结论先行 + 事实锚 + 分层小标题"组织,别拿中文稿直译。如果团队没有英文写手,宁可先只做 3-5 页真正地道的英文,也不要一口气把整站机翻成英文。质量差的一堆英文页不会带来 Gemini 侧回报,反而会拖累整体印象。
四、结构化标注和正文不一致:Google 会当误导信号
有些团队听说结构化对 AI 友好,就抄一段 JSON-LD 贴到页面里,写着一个正文中根本没出现的评分、日期、价格或作者。这不是"多做一层机器可读",是在给 Google 递"这一页在骗机器"的证据。轻则标注被忽略,重则整页可信度受损、连带 Gemini 都不愿引用。纪律:先有正文,再加标注;标注里的每个字段都能在页面上找到对应的文字表述。
五、中英实体不对齐:Google 把两家算成一家,或一家算成两家
英文名写法漂、中文名混用注册名与产品名、sameAs 只挂了自家渠道没挂第三方——这些做法会让 Google 判断实体时犹豫。后果有两种:轻则 Gemini 在英文语境完全不把你在中文攒的口碑算进来(一家算成两家);重则把你和一家同名小公司合并(两家算成一家),说出来的口径完全不是你想要的。修起来很实在:在双语页明确标注中英注册名、用 Organization.alternateName 固定英文名用法、sameAs 挂上所有可信第三方主页;每次回测都关注实体是否被错认。
六、口径漂:同一句事实有三种说法
Gemini 综合多来源,最怕的是关于你的同一件事有三种版本。官网写"服务 300 家客户"、平台简介写"数百家"、某次新闻稿写"上千家",Google 合并时无法决定信哪个,Gemini 就会含糊带过。务实做法是维护一份统一事实清单,作为单一事实源,官网、平台资料、FAQ、通稿都从这份清单派生;每次业务变化先改清单,再推到各处。这件事看起来土,却是让 Gemini 说准你最便宜的手段。
七、把广告稿伪装成独立评测
Gemini 背靠 Google,Google 判断广告伪装内容已经练了很多年。把付费软文写成"第三方评测"、给自己做"XX 排行榜"、找人写"用户真实体验"实则利益相关——这些做法短期看似有效,长期都会被 Google 的判定拖进不采信池。一旦被打上这个标签,Gemini 引用你会变谨慎,甚至宁可引竞品。原则:能公示利益关系的就公示,做不了独立评测就别硬做,宁可少一层信号,不要一次失分。
八、忽视新鲜度:内容写完就冻结
Google 比多数对话模型更看新鲜度,AI Overviews 亦然——数据、价格、趋势类查询会倾向取近期更新过的页面。很多团队的英文核心页三四年没动过,看着索引里还在、实际上在概览取材里已经掉队。务实做法是给核心页建"每季度看一次"的节奏:更新日期、补一条新案例、校正一次参数;不需要重写,只要让 Google 看到"这页还是活的"。
九、只做首页 GEO,忽略真正被引用的深层页
不少团队把 GEO 理解为"把官网首页改好",实际上首页在 Gemini 引用中承担的是"品牌直查"这一小类查询,真正被大量摘用的是深度内容页——具体问题的问答块、具体产品的参数页、具体场景的方案页。首页只需要把主体信息、成立年份、定位、注册名、联系方式摆清楚;把主要精力放在 10-30 页真正能回答客户问题的深度页面上。资源有限时,先做深度页,再谈首页美化。
十、把 GEO 当成一波冲刺,不做长期监测
Gemini 侧的表现是随时间波动的:Google 会更新算法、竞品会补内容、你的业务本身也在变。做一波 GEO 上线后就撒手,半年后回测往往会发现描述开始漂、被引用开始掉。务实做法是接受 GEO 是长期系统:Search Console 周报、提问集月度回测、每季度事实清单核对、每半年 E-E-A-T 补链计划。这个节奏听起来不轻,但它其实是省人力的——所有该出的问题都会主动浮上来,不用你临时救火。
| 上线前体检项 | 怎么查 | 典型翻车 |
|---|---|---|
| robots.txt 是否放行 Googlebot | 直接访问 域名/robots.txt | 测试规则忘了删,两年没被索引 |
| 重点页是否 noindex | 查看响应头与 meta robots | 模板统一加了 noindex 却忘了改 |
| Canonical 是否指向自己 | 查看 link rel=canonical | 多语言版全指向中文主页 |
| hreflang 是否双向且指向可索引页 | 用工具批量校验 | 只标一半,多语言归并失败 |
| sitemap 是否包含重点页且提交 | Search Console 提交状态 | sitemap 只覆盖首页一层 |
| 结构化字段能否在正文找到对应 | 逐条比对 | 标了评分但正文没评价 |
| 中英名与 sameAs 是否对齐 | 看 Organization 与双语页 | 英文名各处写法不统一 |
| 更新日期与最近维护记录 | 查看页面日期字段 | 核心页 3 年没动过 |
十一、上线前 30 分钟体检清单
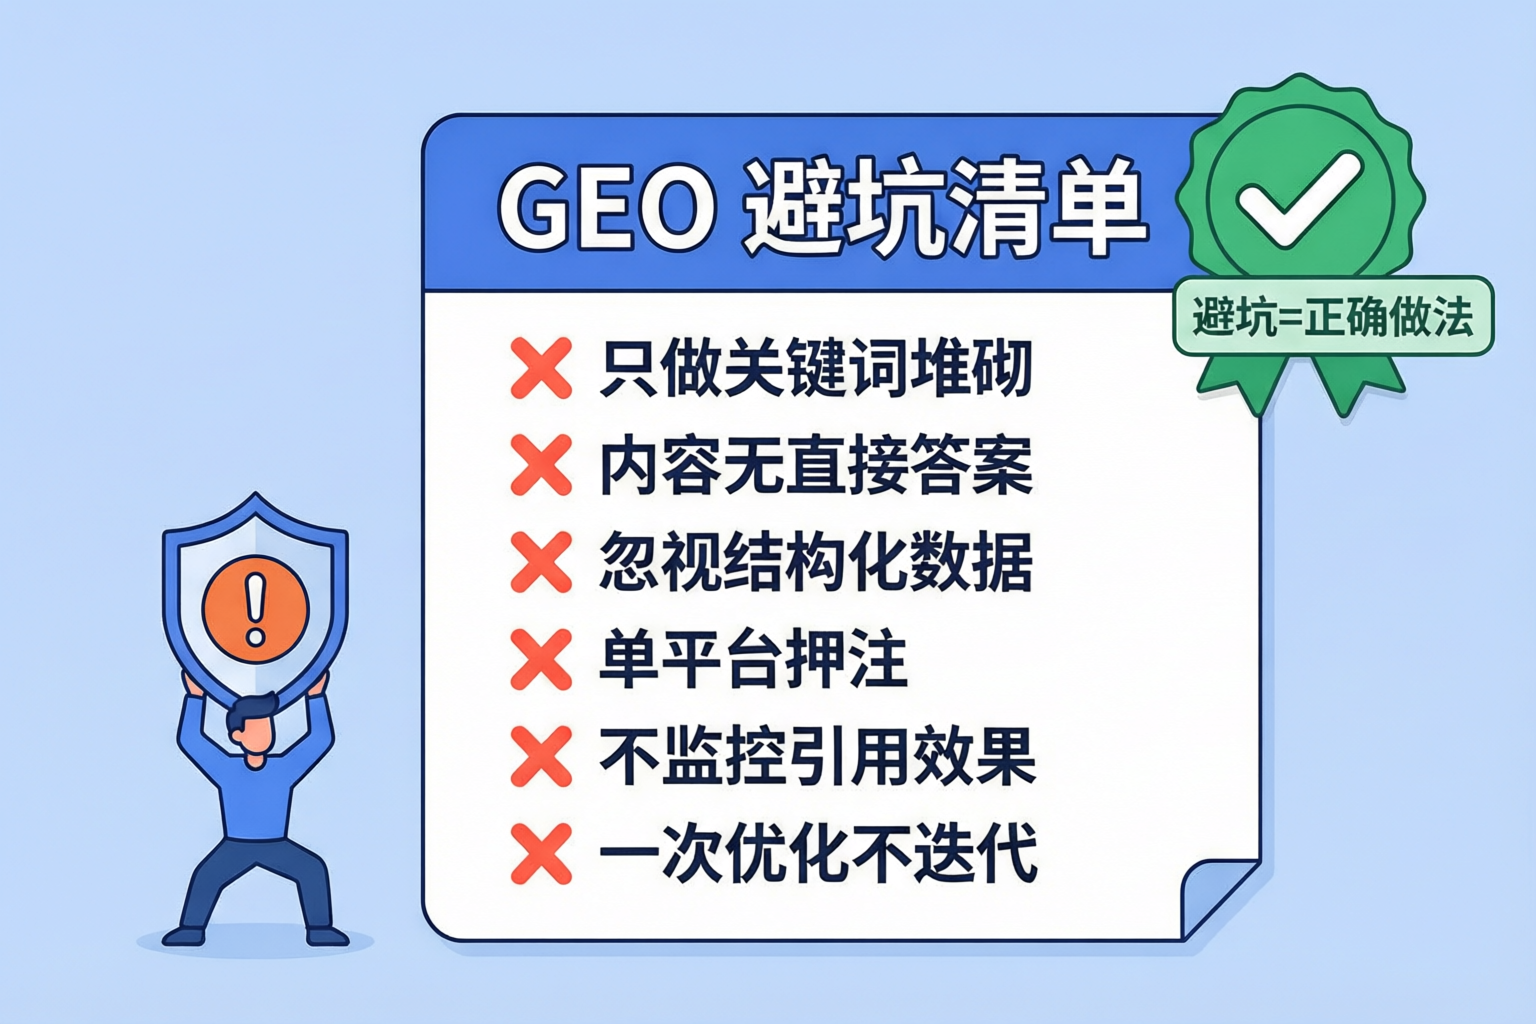
把上面的坑合并成一份可以 30 分钟过完的清单:地基——robots/noindex/canonical/hreflang/sitemap 五项各查一次;内容——重点页有结论句、事实锚可核、一页一主题;结构——Organization / Product / FAQPage 标注与正文一致;实体——中英名对齐、sameAs 挂全;口径——统一事实清单已推到位;监测——Search Console 已接入、固定提问集已建立。这六项过完再上,Gemini 侧最典型的翻车场景基本能被拦住。
十二、两个反面案例
案例一 · 一条 robots 让英文站两年没被引用
一家做跨境硬件的团队,英文站花了大价钱重做、内容也很扎实,Gemini 里却始终不出现。查 Search Console 才发现,改版时测试环境遗留的一条 robots 规则忘了删,Googlebot 从没被放行。改回来 + 重新提交 sitemap,两周后英文页开始被 Google 抓,两个月后 AI Overviews 里开始出现他们。教训:内容层的所有努力,会被地基层的一行代码清零。(个例,不代表普遍结果。)
案例二 · 自建排行榜拖累整站可信度
一家机构为了显得权威,做了大量"XX 排行榜 / 权威推荐"页把自己排进去,短期看似热闹。半年内 Gemini 侧引用不增反降,Google 自然流量也掉了。他们后来才理解:Google 会把这种自封页当低质信号,一旦站点印象被拉低,Gemini 引用就会变谨慎。把这类页面全部下线,回归到参与正规行业名录与真实合作公示之后,Gemini 侧的口径开始稳定回来。教训:走捷径攒权威,最终都会在 AI 引用侧被清算。(个例,不代表普遍结果。)
十三、关于 Gemini 踩坑的常见疑问
Q:我们已经把 ChatGPT 那套做完了,Gemini 上还需要额外做什么?
A:内容层大部分能复用,但要额外补三件:Google 地基体检(Search Console / robots / hreflang / canonical)、中英实体对齐(alternateName / sameAs / 双语名一致)、E-E-A-T 补链(作者页 / 行业名录 / 联合案例 / 可查署名)。这三件都是 ChatGPT 上没强制要求、但 Gemini 会明显看的动作。
Q:我们的英文页已经机翻了两年,现在改是不是太晚?
A:不晚,但要接受这是一个 3-6 个月的过程。Google 的站点印象会慢慢修正,先把最重要的 5-10 页改成英文原生写,其它机翻页要么下线、要么标 noindex 减少拖累;同时提交新的 sitemap,观察 Search Console 里英文页的收录与曝光变化。半年内 Gemini 侧英文场景就能明显看到区别。
Q:体检清单太技术了,我们没开发怎么办?
A:可以先做非技术项——事实清单统一、口径对齐、更新日期、把结构化里字段与正文对齐、中英名规范固定。这几项不需要开发,回报也很大。技术项(robots/canonical/hreflang)可以找外包或建站服务商帮你做一次一次性体检,之后你自己按季度用 Search Console 自查。
十五、还有一个容易忽略的细节:LLMS.txt 与 robots 的协同
Google 正在试验对 AI 抓取分层的机制,很多站点也陆续上线 llms.txt、AI 专用 robots 规则。当前阶段在 Gemini 侧,这些新协议还没有被官方明确纳入取答判定,但把它们准备好有两条实实在在的好处:一是给未来 Google 可能启用的 AI 抓取通道留一份清晰声明,二是这些文件本身也是"这家是否在意 AI 表述"的软信号。别把这些文件当主角,正文与结构化才是;但把它们顺手加进上线清单,能让整个站点在 AI 视角下更完整。原则是:llms.txt 只放索引型信息(哪些页面值得读、每页讲什么),robots 别一刀切把 Googlebot 与 AI 抓取全封,把"你希望被引用"的那部分留通。
十六、写在最后
Gemini 是六大 AI 平台里"红利最大、门槛也最实在"的一档:它的红利是背靠 Google、能吃到一整套成熟监测与索引体系;它的门槛是你必须先通过 Google 二十年沉淀下来的那些老规矩。把这一篇的踩坑清单当成上线前的固定动作,能省你 80% 的返工;把前九篇的方法论按顺序落地,就能把 Gemini 从"偶尔提到你"经营到"稳定说准你"。Gemini 系列的十篇到这里告一段落,接下来我们会带着这里的方法去经营 Claude、Grok、Perplexity、Copilot 上的品牌表述——每个平台都有独特的取答机制与偏好,方法论相同,落点各异。
墨子学院(运营主体:武汉墨子教育咨询有限公司,成立于 2014 年,曾用品牌"百墨生",自 2022 年起投入 GEO 方向)在企业陪跑中会把这一篇的体检清单直接交付给客户团队,作为 Gemini 上线前的固定动作。所有服务提升的是被 AI 准确引用的概率,不承诺具体排名或引用结果。想系统学习这套方法的,可查看 /mall/ 的 GEO 课程。