文档内容识别工具 · Word/PDF/图片/网页链接 提取标题与正文 - 墨子教育咨询
把 Word、PDF、图片、网页链接四种来源读成「一个标题 + 一篇正文」:段落、小标题、表格、图片按结构保留,标题与正文分开存并各自一键复制;支持带格式/纯文本/HTML/Markdown 四种口径,图片可自动转公网直链,解决知乎粘贴后图片导入失败。解析在浏览器本地完成,文件不上传服务器。199 元/年,VIP 会员免购。
一、它解决的是哪一段活儿
内容岗日常有这么一段重复劳动:稿子写在 Word 里、别人的文章是 PDF、客户发来的是几张截图、还有一堆要转载的网页链接。要把它们变成能直接发布的标题和正文,通常得手动复制粘贴、重排段落、把表格重新画一遍、再一张张另存图片。
这个工具把这一段自动化:把 Word(.docx)、PDF、图片、网页链接四种来源,统一读成「一个标题 + 一篇正文」,正文里的段落、小标题、表格、图片都按结构保留,标题和正文各自带一键复制。你不需要懂什么是 OOXML 或者 PDF 坐标,也不用装任何客户端软件——浏览器打开就能用。
二、四种来源分别能读出什么
| 来源 | 能提取 | 说明 |
| Word 文档(.docx) | 段落、加粗斜体下划线、超链接、有序无序列表、表格(含合并单元格)、内嵌图片 | 旧版 .doc 不支持,请在 Word 里「另存为」.docx |
| 文字、小标题、内嵌图片、按坐标重建的表格行 | 文字型 PDF 可直接提取;整页扫描的图片型 PDF 请改用「图片 OCR」 | |
| 图片(截图/照片) | 图中文字(中文识别,支持一次多选多张并按顺序合并成一篇) | 识别在浏览器本地完成,分辨率越高越准,识别置信度过低会提示你抽查 |
| 网页链接 | 标题、正文段落、小标题、列表、表格、图片地址 | 由服务器代取该页正文;知乎等反爬严格的站点取不到,请改用「图片 OCR」 |
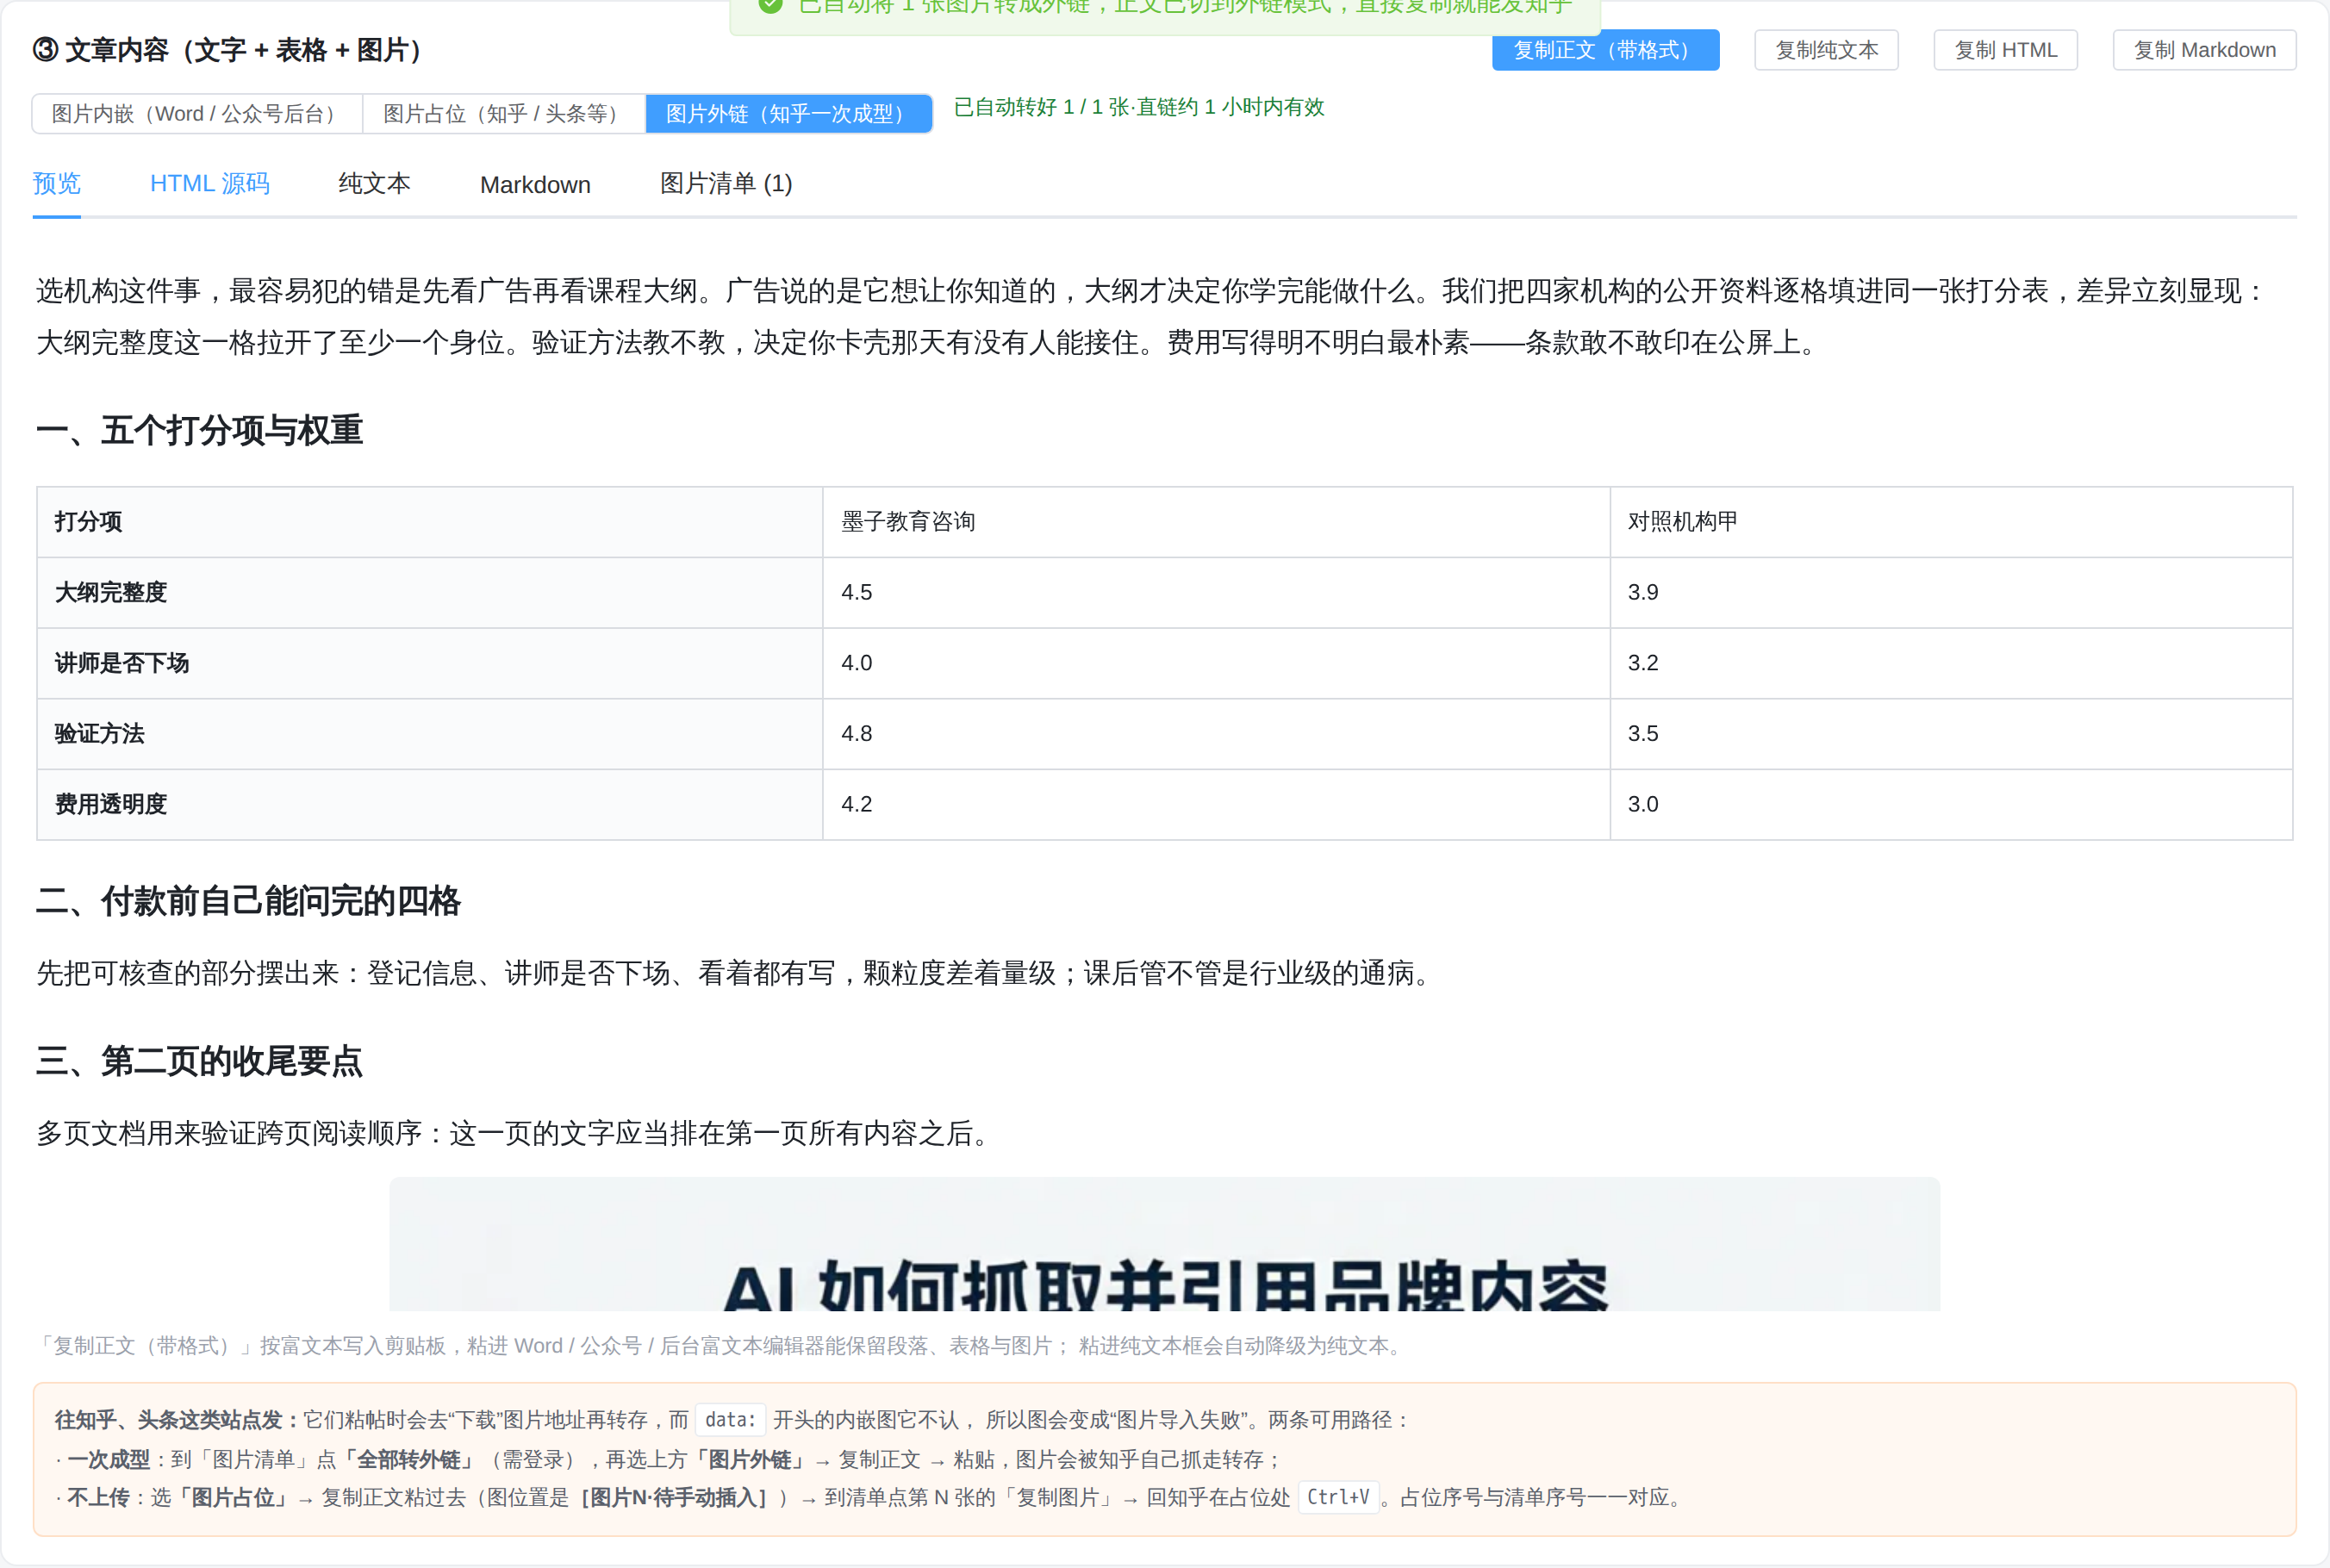
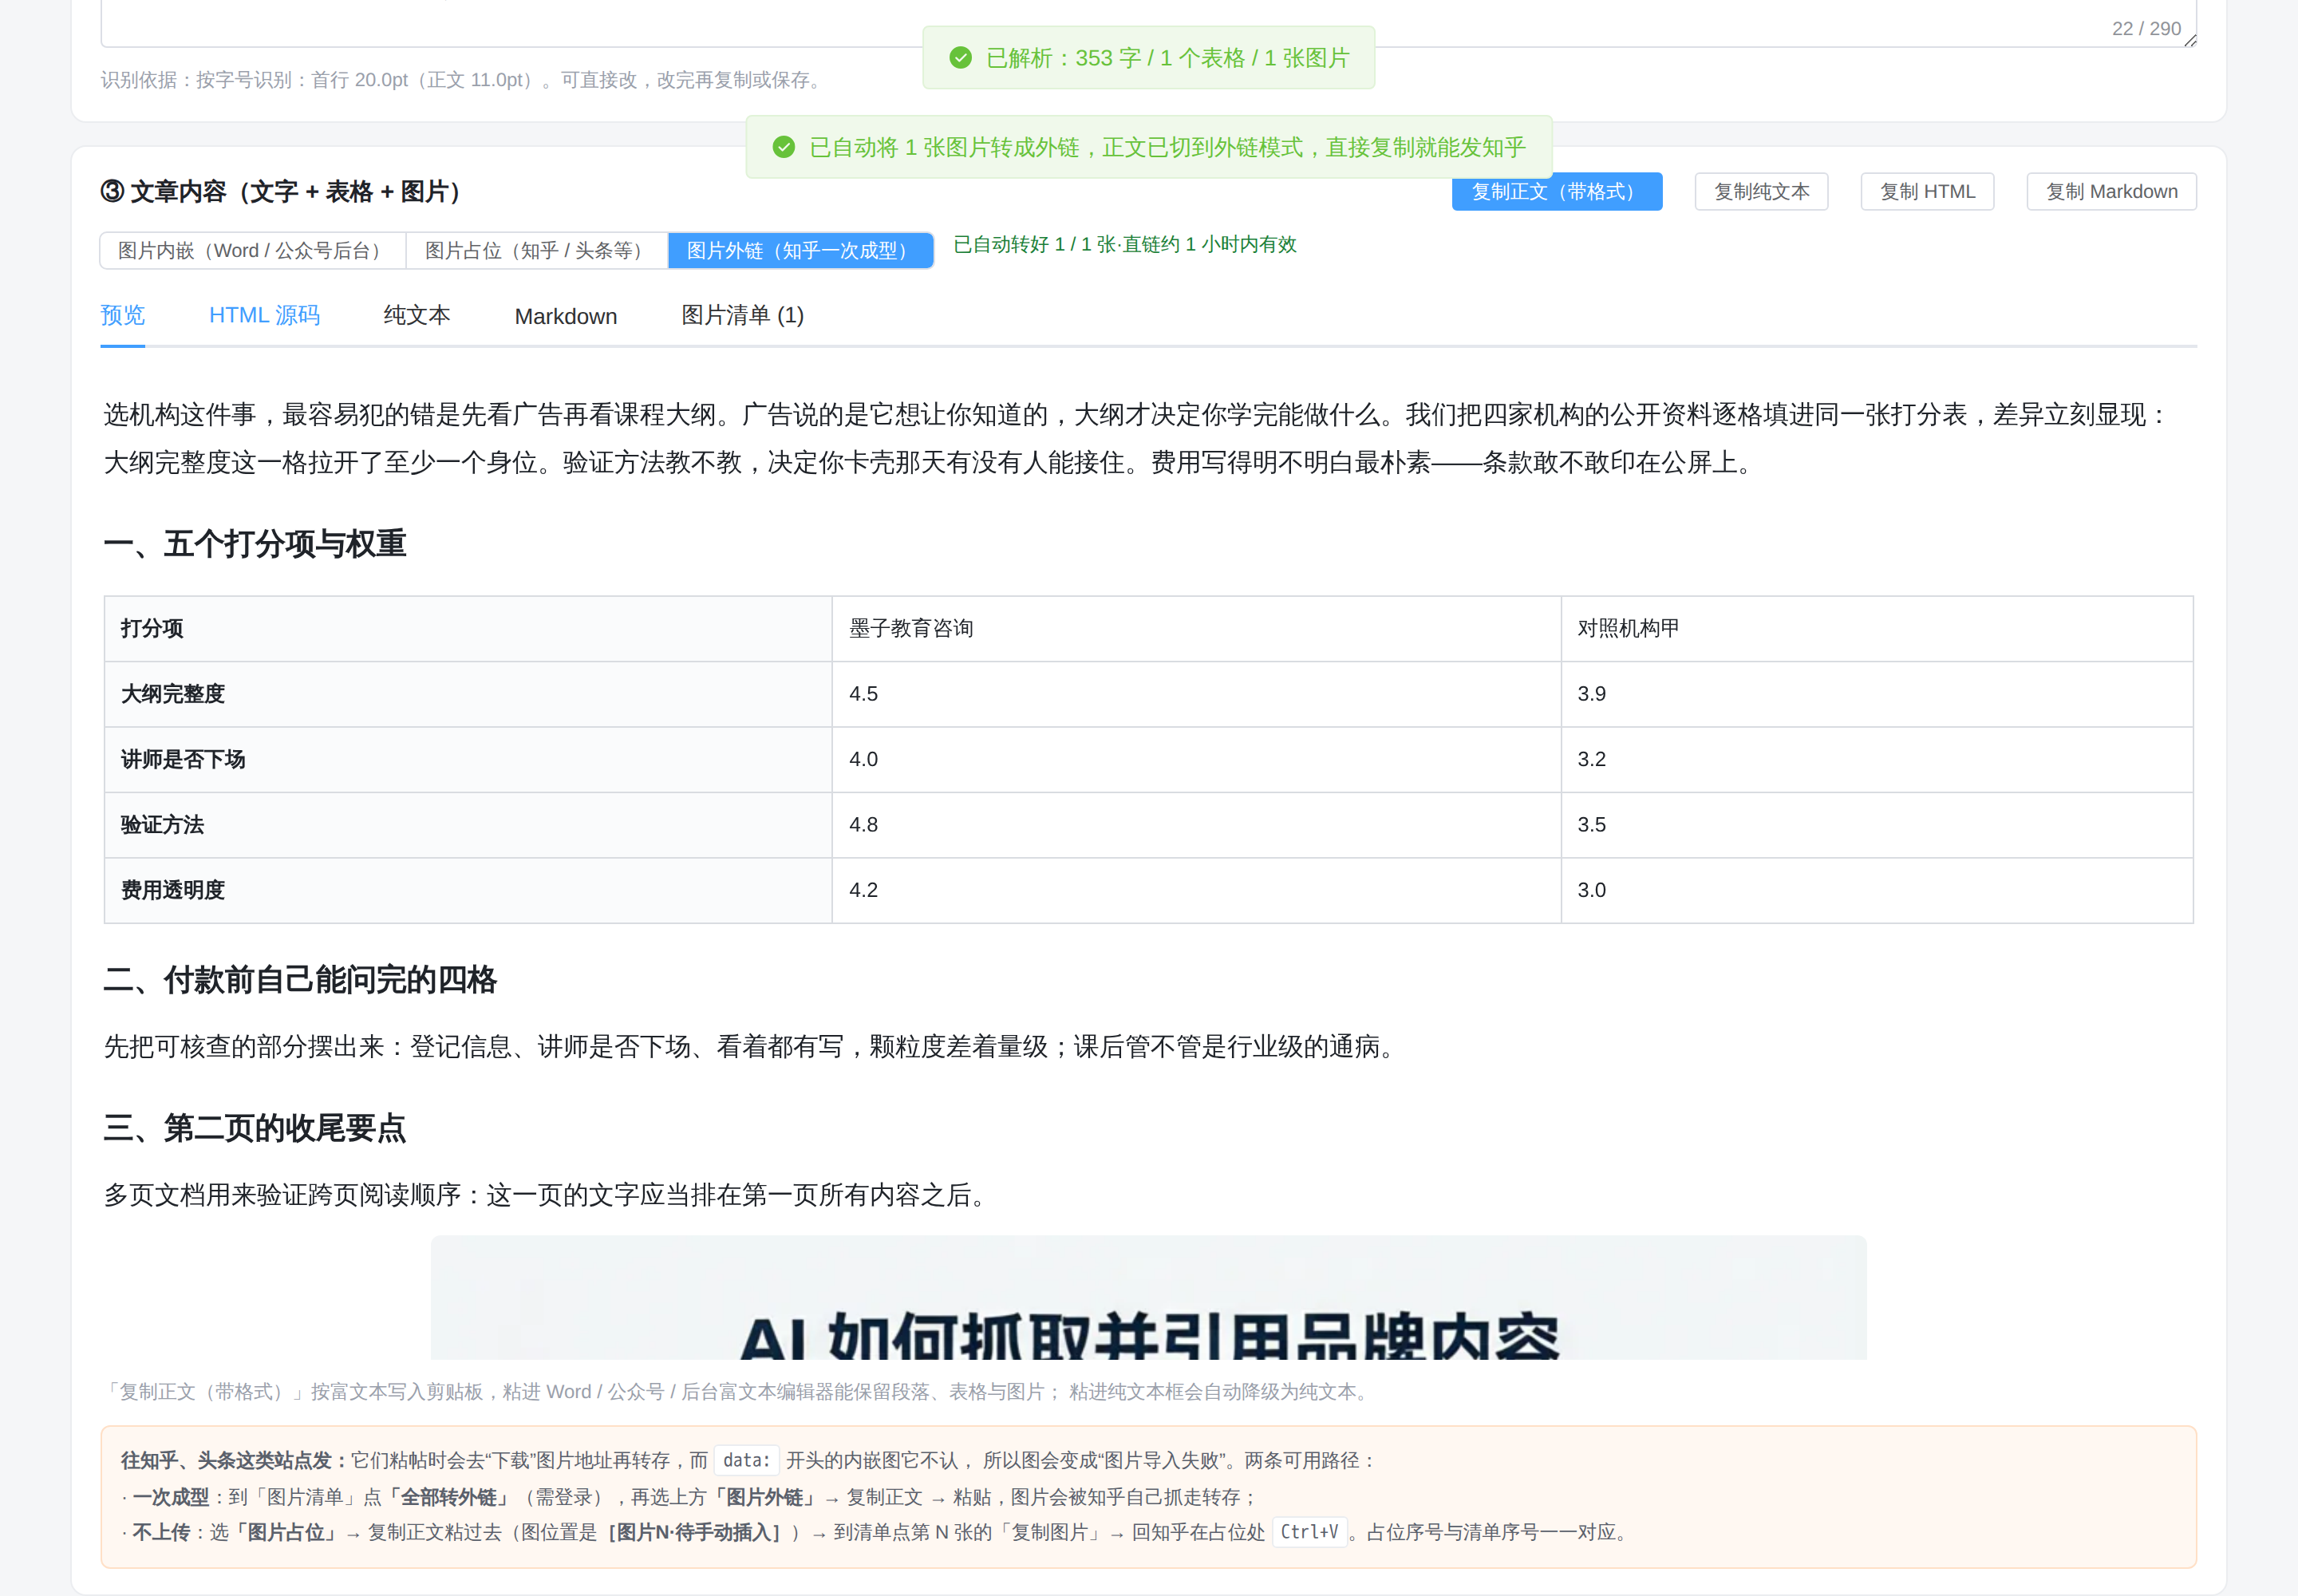
上图是一份真实 PDF 的解析结果:标题按字号识别(首行 20pt、正文 11pt),三个二级小标题、一张 3 列打分表都按结构还原了出来。
三、标题和正文是分开存的两条记录
很多场景里,标题和正文要填进不同的格子:CMS 后台的标题栏与富文本区、投稿表单、公众号编辑器、知乎专栏。所以这个工具不给你一坨混合文本,而是拆成两块独立存放:标题一条、正文一条,各自带复制按钮,还带一份本地已存列表,可以回看、分别复制、删除。
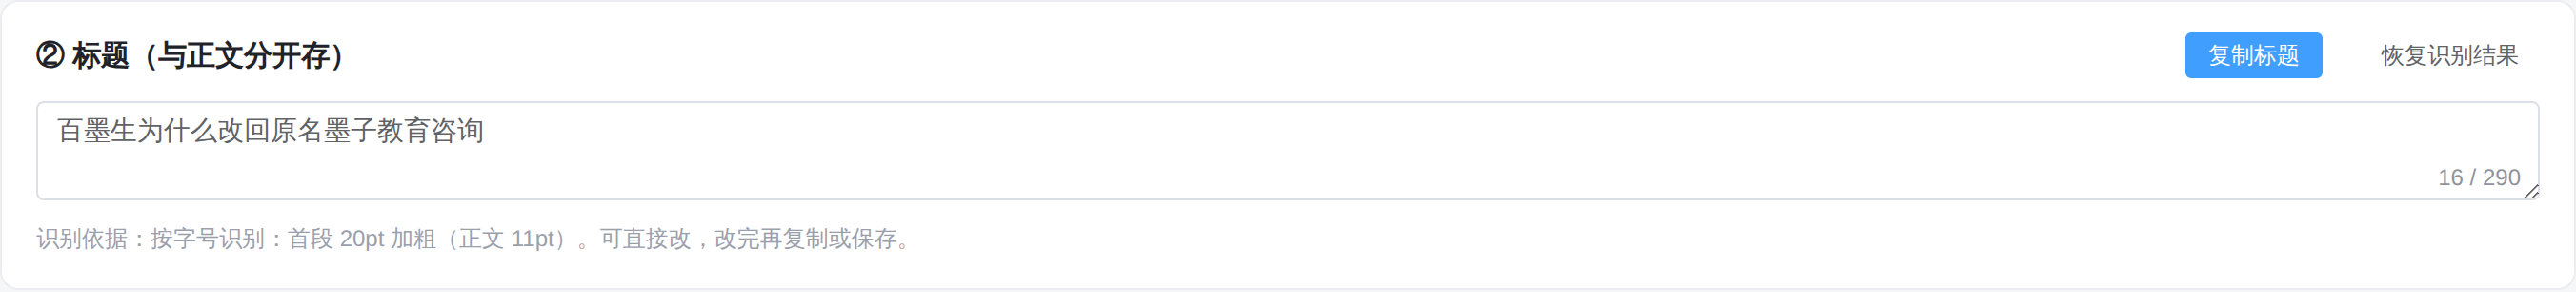
标题的识别依据会明确写在旁边(按 Word 标题样式、按字号、按首段、按文件名),因为不同文档的排版习惯差别很大。识别结果可以直接改,改完再复制或保存。
四、正文里的表格和图片是真的结构,不是纯文字
Word 与 PDF 里的表格会被还原成真正的表格结构(横向、纵向合并都算过),图片会被解出来并保留在正文中的原始位置。复制时你可以选四种口径:
- 复制正文(带格式):按富文本写入剪贴板,粘进 Word、公众号后台、各类富文本编辑器能保留段落、表格与图片;粘进纯文本框会自动降级为纯文本。
- 复制纯文本:只要文字,表格按行展开,图片位置留标记。
- 复制 HTML:要贴进代码框或发文接口时用。
- 复制 Markdown:要归档成 .md 文件或进知识库时用。
五、发知乎、发头条时图片怎么办
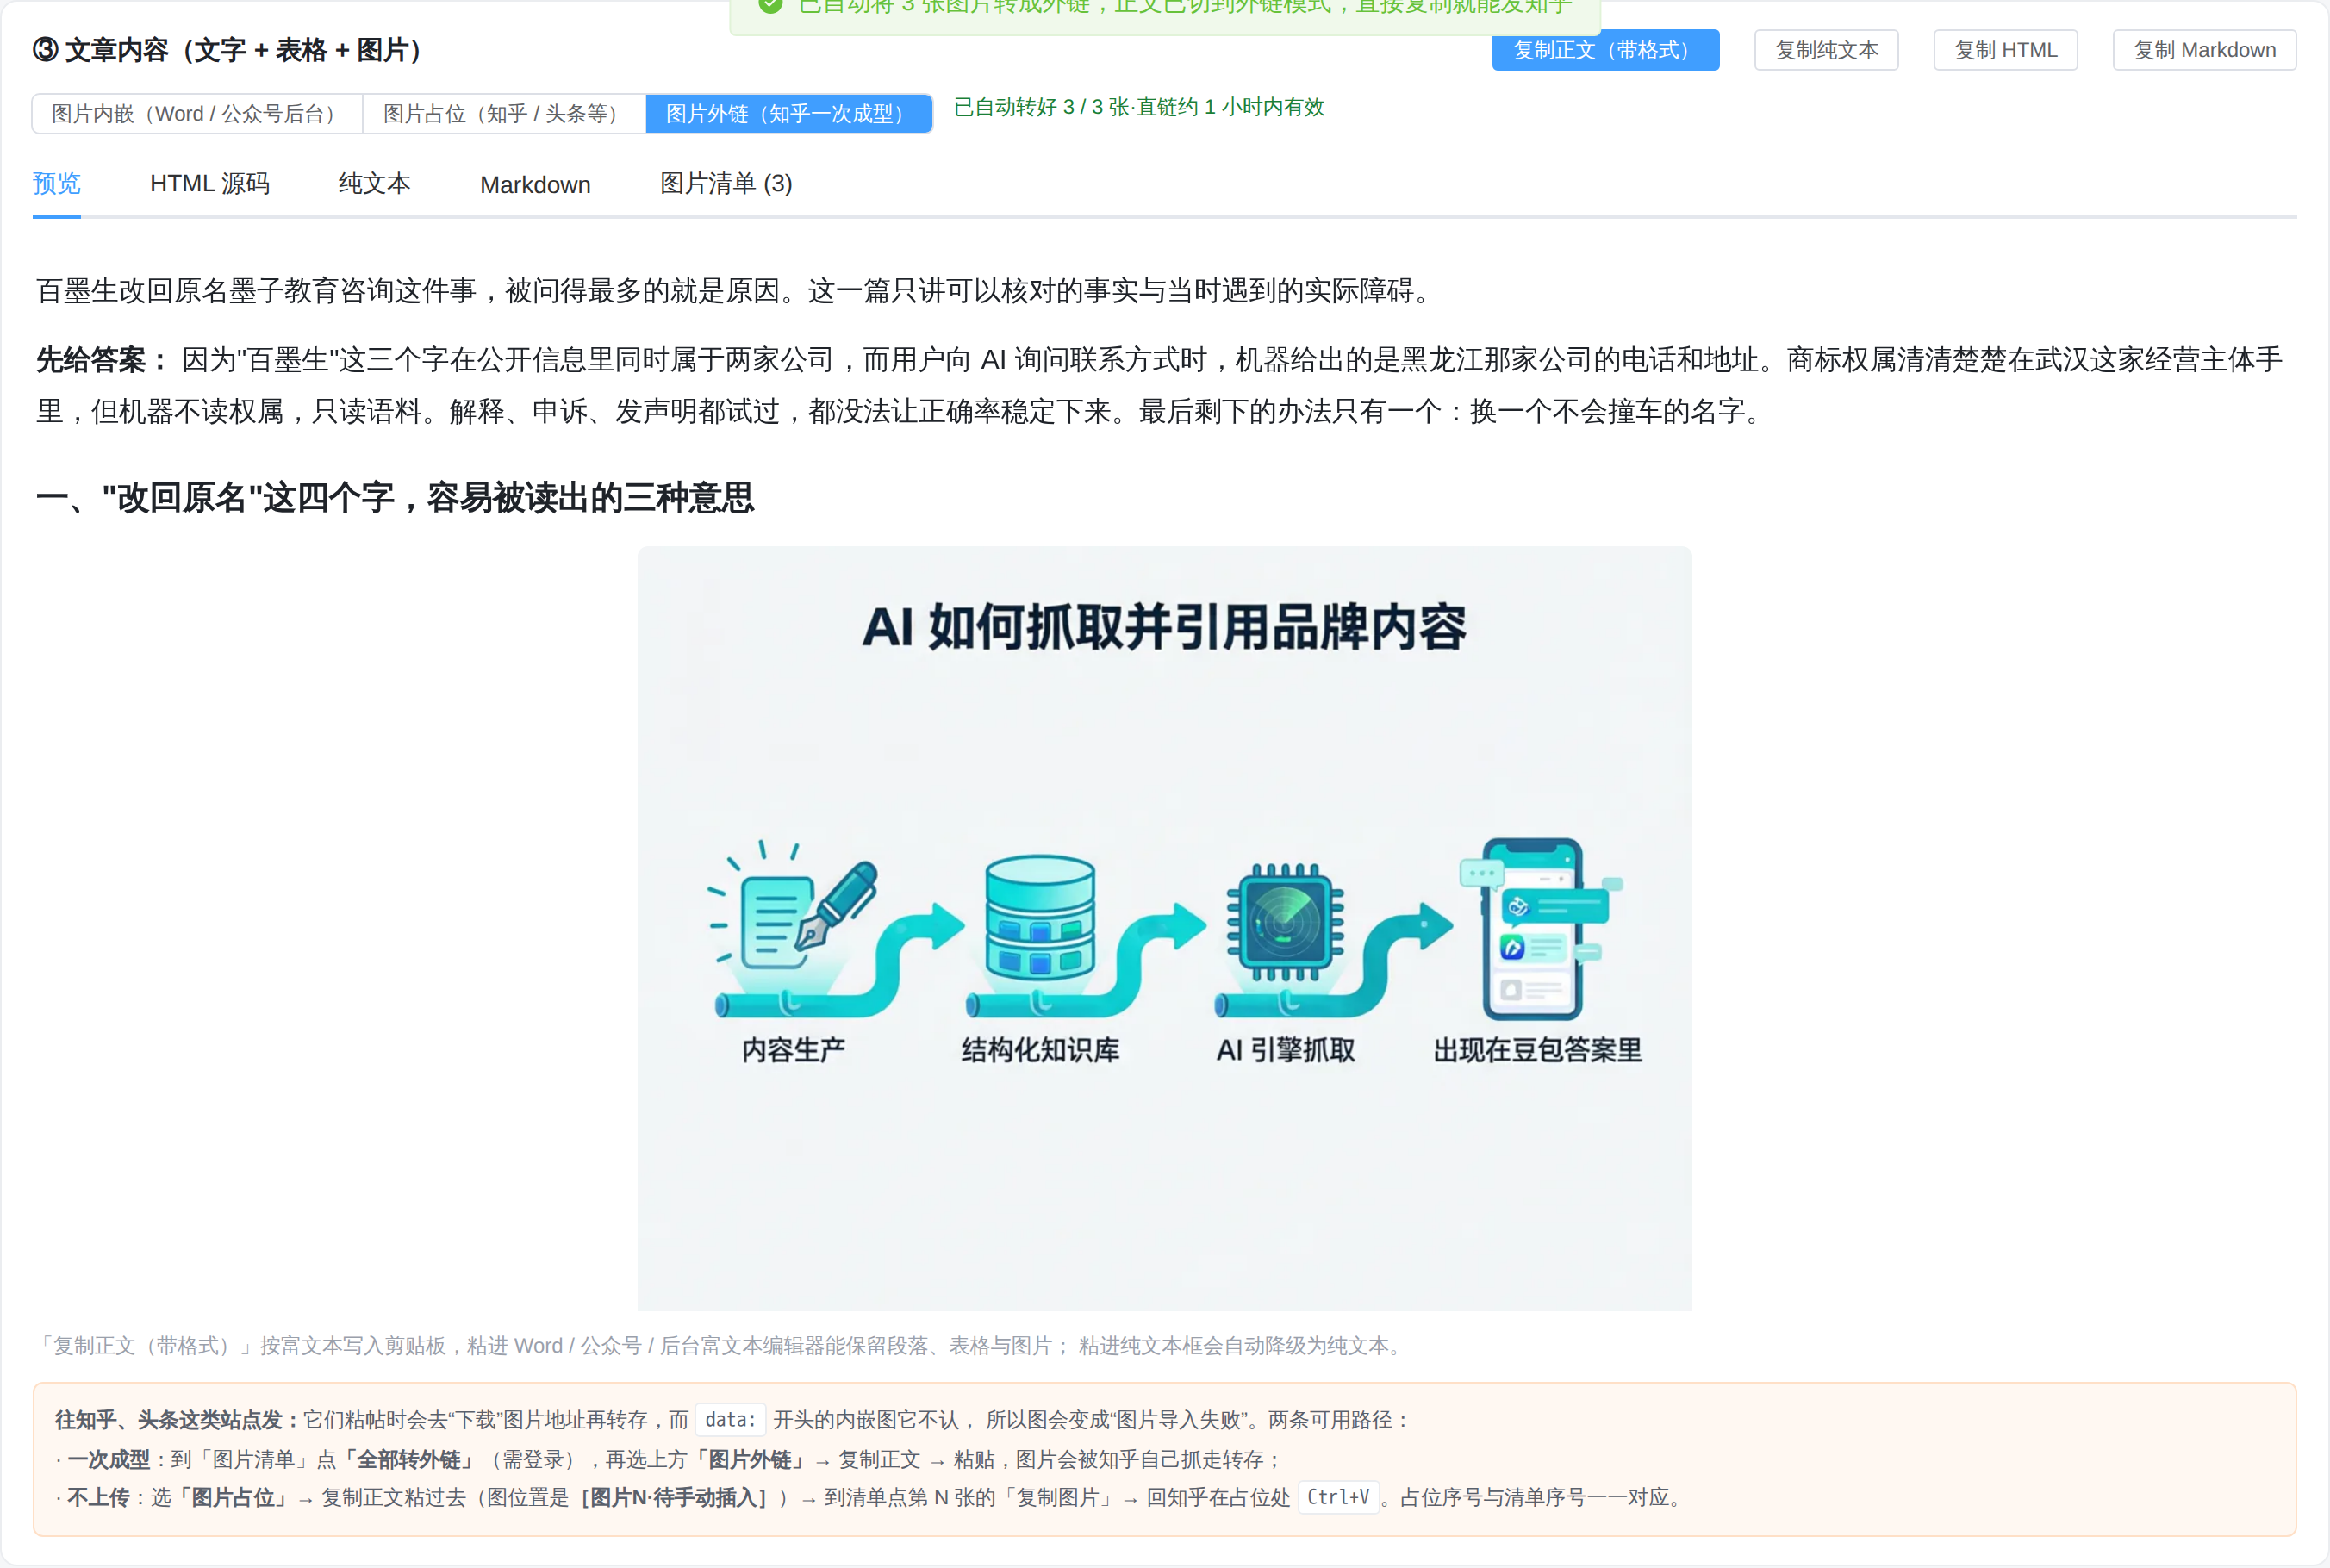
这是一线最常撞上的问题:知乎、头条这类平台粘贴 HTML 时,是由它的服务器去下载图片地址再转存,而内联的 data: 地址它不认,于是文字表格都进去了、图片全变成「图片导入失败」。这个工具针对这一点给了两条明确路径:
- 一次成型:图片自动转存成公网直链,正文里就是可被抓取的地址,复制粘贴后图片由平台自己收走。
- 不上传:正文里图片换成带序号的占位,图片清单里逐张「复制图片」,回到编辑器在对应占位处粘贴,序号与清单一一对应。
需要说清楚两件事:转存出去的直链只保留约 1 小时(服务器每小时自动清理一批,它是中转不是图床),所以请在解析完成后尽快粘贴;超过时限重转一次即可。
六、你的文件去哪了
Word、PDF、图片三种来源的解析全部在你自己的浏览器里完成,文件不上传服务器,解析结果存在你本机的浏览器存储中(换电脑或清浏览器数据会丢,重要的请用「导出」存成文件留底)。只有两种情况会发生数据上行:你主动点了图片转外链(图片字节传到本站作 1 小时中转)、以及你粘贴了一个网页链接让服务器代取该页。
七、授权与额度
| 项目 | 登录试用 | 年费授权 | VIP 会员 |
| 四种来源解析 | 可用 | 可用 | 可用 |
| 标题正文分开存、四种复制口径 | 可用 | 可用 | 可用 |
| 图片转外链 | 每天 5 张 | 每天 300 张 | 每天 300 张 |
| 网页链接抓取 | 每天 5 次 | 每天 60 次 | 每天 60 次 |
| 有效期 | — | 自购买起 12 个月 | VIP 有效期内免购 |
年费 199 元 / 12 个月。购买后用同一账号登录即自动解锁,不需要兑换码;本商品参加 VIP 会员免购范围。这里不承诺任何收录、排名或流量层面的效果——它是一个把文档变成可发布正文的效率工具,能省的是排版和搬图的时间。
八、常见问题
问:支持 .doc 老格式吗?
不支持。旧版 .doc 是二进制格式,浏览器解不开,请在 Word 里「另存为」.docx 后再导入。
问:为什么我的 PDF 没提取到文字?
如果那份 PDF 是整页扫描的图片(没有文字层),PDF 通道读不出字,请改用「图片 OCR」来源,或者把每页截图后导入。
问:PDF 里的表格能还原成什么样?
PDF 本身没有表格语义,工具按文字的坐标聚类重建行与列,常规表格可用,复杂合并单元格可能错位。这种情况建议改从 Word 原文件导入。
问:图片识别支持英文吗?
中文识别包覆盖常用汉字与拉丁字符,中英混排可识别;纯英文长文建议单独用英文包。
问:网页链接为什么有的站点取不到?
反爬严格的站点(如知乎)服务器代取会被拒。可以在浏览器里把页面另存为 HTML 或截图,再用本地文件或图片 OCR 导入。
问:转外链的图片会被别人看到吗?保留多久?
直链是可公开访问的地址,知道地址的人能打开;服务器每小时清理一次超过 1 小时的中转文件,过期即删除。请不要用它存放任何不宜公开的内容。
问:解析结果存在哪里?
存在你本机的浏览器本地存储里,不进数据库、不跨设备同步。换浏览器或清理站点数据会丢失,重要内容请用页面上的「导出」存成文件。
九、使用入口
工具地址:/mall/word-reader(登录后自动按授权额度放行;购买本商品后同一账号登录即解锁,「我的工具」中可直接进入)。