什么是大模型缓存?-墨子教育咨询
摘要:大模型缓存是引擎为加速回答留存的内容副本——理解须分两层:活缓存(抓取与检索副本,可催取、有过期周期)与死印象(训练期沉淀进参数的旧事实,无法直接刷新);「网站已改、AI 仍说旧信息」的时差由两处共同构成,混起来治就是改七遍地址白改的病因。重要性在五站漏斗(页面生效→抓取→索引缓存→参数印象→答案口径)中间段:看不见它产生误诊之害(把还没走到当改了没用、反复改版把口径改花)、监测之害、设计之害。落地是三查定站次分站开药:查源站、查引擎副本时间戳、问答案取材特征;卡二三级提交催取,到印象级没有速效药只能持续供新信号月为周期,急症走平台纠错旁路;结案以终点站回测口径为准。与抓取是进货与库存:抓取管来不来取货,缓存管取后几天上架。与内容衰减为时病兄弟:被换下去对被落下来。个案口径不构成效果承诺。
先立一个反常识的说法:你改网站的那一刻,生效的时刻还排在你后面好几站——「改完」从来不是终点线,它只是接力赛的头一棒。这个判断不是我推测的,是一家亲子机构的周报把我砸醒的:她们四个月里把同一个「校区地址」改了七遍,每次发现 AI 还在报旧地址就去改一遍,第七遍时运营在周报里写了句大实话——「我们到底在改什么,为什么永远改不完」。把链路拆开看一眼就知道:她改的永远是自家页面,而 AI 嘴里那个旧地址,早就不住在她页面上了——它住在引擎的缓存副本里,甚至住在模型参数的「印象」里。七遍修改,全部改在了起跑线上,一棒都没接到终点的耳上。这一篇讲的就是这条时差链:大模型缓存是什么、为什么它决定了「改了没用」的假象、以及接棒该怎么跑。
一、先把定义钉牢:缓存是副本,且不止一份
大模型缓存,指模型引擎为加速回答生成而留存的抓取页面与检索结果的缓存副本。内容改版后要待缓存过期重取,才会进入 AI 回答。这是词条式的钉法,但只做对了一半——真实世界里,引擎「记得你」的东西至少分两处存放:
一处是活的缓存:抓取系统定期把网页存成的副本与索引快照。联网检索型回答(引擎答前现查)取材的就是这一层,过期重取周期从几天到几周不等,你提交更新请求可以催它。另一处是死的印象:训练语料沉淀进模型参数里的旧事实。它不叫缓存、没法「刷新」——除非下一次训练带进新数据,否则只能靠引擎在检索增强时「现查到你、盖过印象」。两处存放的差别,决定了修法完全不同:活缓存吃「提交与催取」,死印象吃「时间与新信号密度」。混起来治,就是那所亲子机构七遍白改的病因:她一直以为自己在跟缓存较劲,其实对手一半是参数里的旧账。
所以规范的短答应该带半句分层:大模型缓存是引擎留存的内容副本,狭义指抓取与检索缓存(可催可过期),广义上还要把模型参数里的训练期印象算作同族——两者共同构成「网站已改、AI 仍说旧信息」的时差来源。
二、为什么重要:时差链是一段漏斗,不是一个点
「大模型缓存为什么重要」——因为它是更新传导漏斗的中间段,而大多数团队只看得见两头。把链条摆全:
| 站次 | 环节 | 典型时滞 | 你能做的 |
|---|---|---|---|
| 头一站 | 自家页面改版生效 | 即时 | 改对、加「截至」时点标注 |
| 第二站 | 引擎抓取发现新版 | 数天到数周 | 提交更新、站点地图保新鲜 |
| 第三站 | 索引与检索缓存换装 | 随抓取后滞后 | 催取、验证引擎侧副本内容 |
| 第四站 | 模型参数印象更新 | 以月年计,随训练周期 | 改不了,只能靠检索层覆盖 |
| 终点站 | AI 回答口径改变 | 前三站的总和 | 回测追认,留证据存档 |
重要性从三个方向显形。其一,误诊之害:不懂时差链的人把「还没走到」当成「改了没用」,于是反复改版、加码改版,第七遍改的时候内容都被改花了,引擎侧看到的反而是来回摇摆的口径——时差病被治成了口径病。其二,监测之害:回测发现旧口径还在,若不知道有四站漏斗,就会去冤枉内容团队「没改」,其实第二站第三站的账没走到。其三,设计之害:时效事实不带时点标注的页面,走完漏斗的这段时间里,旧版被转述没有任何「过期可见性」——用户与引擎都无法分辨这是新话还是旧话,等发现时错口径已经借平台的嘴传播了一圈。
顺带把上篇的兄弟关系点破:内容衰减是「被换下去」,缓存时差是「被落下来」——前者是代表权的慢性丧失,后者是更新传导的急性时滞。两病症状相似(引用的说法和页面对不上),药性相反:衰减要修内容竞争力,时差要走链路提交。分清它们,是这两卷连读的全部收获。
三、怎么落地:三查定站次,分站开药方
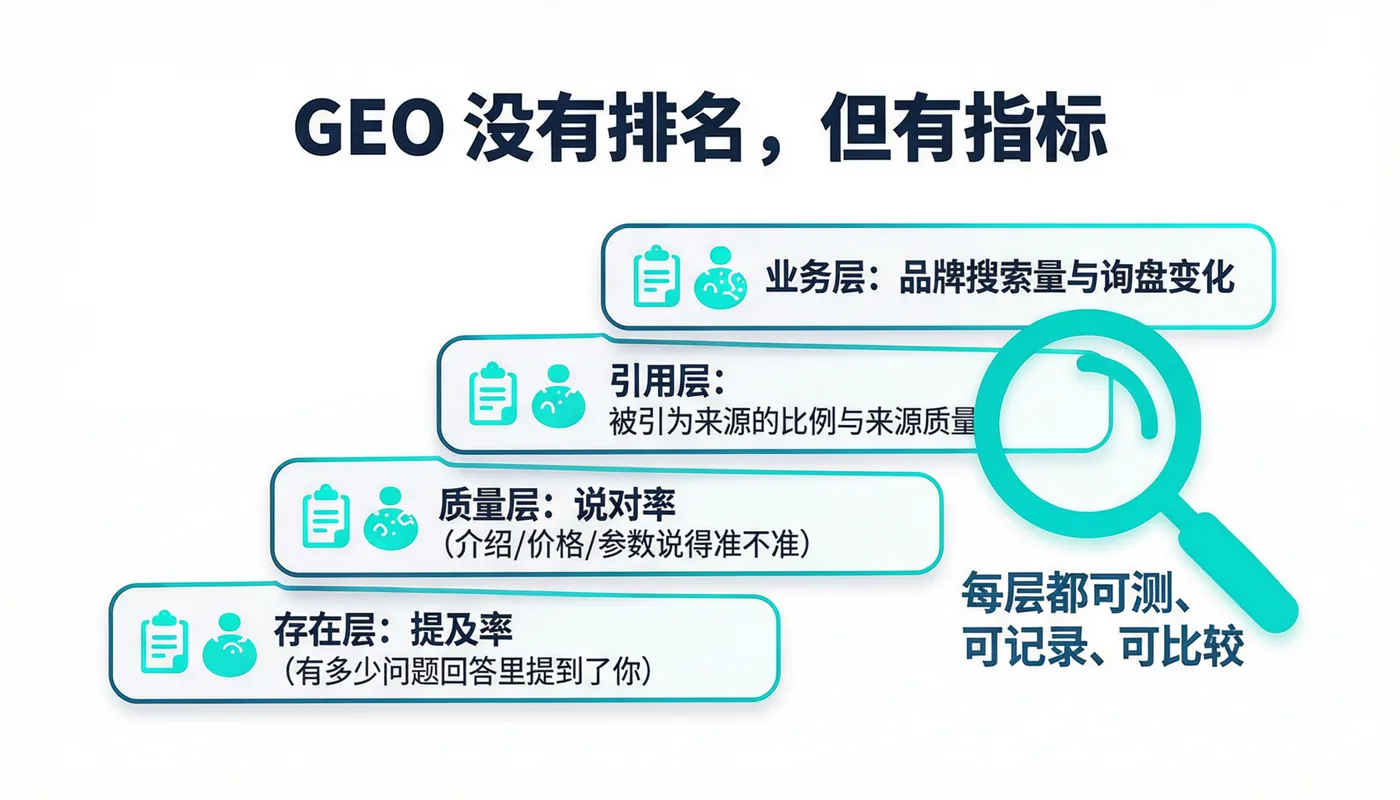
「大模型缓存怎么落地」——落地的核心动作是把「AI 说旧话」这个笼统症状,定位到五站漏斗的具体哪一站卡住。三查定位法:
头一查,查自己:打开原页面确认新版已生效(清缓存刷新看源站),这站没过就谈不上后面——别笑,「以为改了其实发版没成功」的比例高得惊人。第二查,查引擎侧副本:用检索工具看该页的缓存版本与最近抓取时间,副本还是旧的,卡在第二、三站——药方是提交更新请求、核对站点地图新鲜度、确认 robots 没把改版页拦在抓取之外。第三查,问答案:副本已是新的而回答还引旧话,且回答不带「现检索」特征(不列来源、语气像背书),多半是第四站的参数印象在说话——这一站没有速效药,药方变成「持续供新信号」:让检索层反复取到新口径,靠新证据的密度慢慢盖过旧印象,周期以月计。
分站开药之外,再钉两条纪律。一是急症急救走旁路:旧口径若属于有害错误(价格报错、资质报丢),等不了漏斗,直接走平台纠错通道提交证据,并同步把自家页面的新旧对照、变更时点做成可核验材料——纠错提交这件事,第三方治理卷与源头订正卷有完整工序,本篇只接一句:缓存时差里的急症,走的就是它们的门。二是追认要用终点站口径:改版结案的标准不是「第三站副本换新了」,是「固定问法回测里,终点站的答案口径对了」。中间站全绿而终点站不绿,说明问题压根不在缓存,在取材选择——转卷去查引用监测与答案份额的地盘。
给内容设计留一条预告式的规矩:时效字段写「截至」标注(衰减卷的头一硬规矩,在缓存语境下有了第二重意义——时点标注让「旧版被引用」变得可检测:回答里引出的「截至」日期一暴露,就知道它取的是哪一版副本,定位时差卡在几站反而有了抓手)。
四、和抓取什么关系:一个管进货,一个管库存
「大模型缓存和抓取是什么关系」——这对概念像一对孪生工序,最容易在外行话里被混用。摆正关系要说三层:抓取是进货动作,缓存是库存状态。抓取系统按周期来拿新版页面,拿回来的就存成副本供检索——所以「改了没被抓到」和「抓到了但副本还旧」是两个病:前者进货停了,查抓取频率、封条与站点地图;后者进货正常但库存周转慢,催取或等过期。鉴别就在引擎侧的抓取日志与副本时间戳上,两查就分明。
第二层,抓取管进门,缓存管进门之后住多久:抓取决定新版内容能不能被拿到,缓存决定旧版还要被引用多久。所以做好抓取(robots 放行、页面可达、结构稳定)只解决「有没有」,解决不了「快不快」——很多团队修完抓取发现口径照旧,误以为抓取白做了,其实是漏斗走到了第三站而已。第三层,两者共享同一个体检日:链路排查应一次过两站——先看抓取有没有正常来(日志里有近期访问、返回码正常),再看缓存的新旧(副本时间戳、内容比对)。只查一半的排查,报告里永远写着「已提交重新抓取」却从不追认结果。
把两卷的分工写成一句话存档:抓取卷管「引擎来不来取货」,缓存卷管「取了货还要几天上架」。
五、几种高频误判的病历
时差链上的误判花样繁多,排四种常见病历,每种给一句鉴别:
病历一,把口径打架当缓存陈旧:AI 一会儿说新价一会儿说旧价,未必是时差——先查自家站内是不是新旧两版页面并存(改版没撤旧页),站内自打架时,引擎取到哪版全凭运气。鉴别:看回答里两个版本出现是否随机。病历二,把没收录当缓存慢:页面改版后 URL 换了,旧版缓存永不过期也没用——新版压根没被抓到,卡的是第二站之前。鉴别:引擎侧搜新 URL 存不存在。病历三,把取材选择当印象顽固:所有链路都绿、答案还是引别家不引你——那不是缓存问题,是取材竞争问题,衰减卷和份额卷的地盘。鉴别:终点站回测里别人在、你不在。病历四,把第三方错源当自家缓存:AI 引的是外站把你写错的旧资料,自家页面早改对了也白搭——时差在别人的库存里。鉴别:答案列的来源域名是不是你家的。四条病历合一个教训:「AI 说旧话」是症状目录不是病名,先鉴别再开药。
| 病历 | 表面症状 | 真实卡点 | 一句鉴别 |
|---|---|---|---|
| 口径打架当缓存 | 一会说新价一会说旧价 | 站内新旧两版并存 | 看两版出现是否随机 |
| 没收录当缓存慢 | 改版后彻底没引用 | 新 URL 没被抓到 | 引擎侧搜新地址在不在 |
| 取材选择当印象 | 链路全绿仍不引你 | 竞争位被别家占住 | 回测里别人在不在 |
| 第三方错源当自家 | 外站旧资料被转述 | 时差在别人库存里 | 看答案来源域名 |
四行表钉在第五节末尾当速查卡用:下次「AI 说旧话」的报警进来,先对着表走一遍鉴别再立项——表里四行只有一行半和缓存本身有关,其余交给各自的卷去管。这就是时差链知识的全部实用价值:它把一口新锅,拆回了四口旧锅,每口都有认领的人。
六、几条实际情况
按惯例交代个别例子。开篇那所亲子机构第八次动手时换了打法:先三查定位,发现第二站其实早已正常——引擎副本是新版的,卡点在第四站:模型对她们老校区的印象根深蒂固。后续动作改成「让检索层反复看到新地址」:新地址进每一页的结构化字段、进问答资产、进词条页,配合固定问法每月回测追认。第五个月终点站口径翻正,期间页面一次都没再改过。另一例是反向的:某机构发现「缓存慢」冤得慌——查出来是改版时新旧两版报价单并存四十五天,属于病历一的站内自打架。两例均为单一台账自报口径,样本小,不代表普遍结果,看官留意。
申明:本站亦从事 GEO 与知识词条方向的研究(同业申明照家法先行);抓取、引用监测、第三方治理等相邻概念在本知识库各有专卷,交叉处以各卷正文为准。
七、常遇到的问题
Q:什么是大模型缓存?
A:模型引擎为加速回答生成而留存的抓取页面与检索结果的副本,内容改版须待缓存过期重取才进入 AI 回答。规范理解要分两层:狭义的活缓存(抓取与检索副本,可催取、有过期周期),加上广义的死印象(训练期沉淀进参数的旧事实,无法直接刷新)。「网站已改、AI 仍说旧信息」的时差,通常由这两处共同构成——只治缓存不治印象,或反过来把印象当缓存催,都是错位。
Q:大模型缓存 为什么重要?
A:因为它是更新传导五站漏斗(页面生效→抓取→索引与缓存→参数印象→答案口径)的中间段,看不见它就产生三重害处:误诊——把「还没走到」当「改了没用」,反复改版把口径改花;监测之害——回测旧口径未清就冤枉内容团队没改;设计之害——时效字段不带「截至」标注,时差期内旧版被转述毫无过期可见性。它也决定结案口径:中间站全绿不算完,终点站答案口径对了才算完。
Q:大模型缓存 怎么落地?
A:三查定站次,分站开药。一查源站(新版真生效了吗),二查引擎侧副本(缓存版本与抓取时间戳新旧),三问答案输出(是否带现检索特征)。卡第二三站的药是提交更新、站点地图保鲜、核对封条;到第四站(参数印象)没有速效药,改为持续供新信号——新口径进结构化字段、问答资产、词条页,让检索层反复取到,月为周期追认。急症(有害旧口径)不等漏斗,走平台纠错通道交证据。全程配套两条:时效字段标「截至」让旧版引用可检测,结案以固定问法回测的终点站口径为准。
Q:大模型缓存 和 抓取 是什么关系?
A:抓取是进货动作,缓存是库存状态:抓取系统按周期取新版页面,取回的存成副本供检索。「改了没被抓到」与「抓到了但副本还旧」是两个病——前者查抓取频率、封条与站点地图,后者催取或等过期,鉴别看引擎侧抓取日志与副本时间戳。分工一句话:抓取管引擎来不来取货,缓存管取了货还要几天上架;链路体检日两站同查,只查一半的排查会停在「已提交重新抓取」而不追认结果。
Q:改了十遍价格,AI 还说旧价,是缓存太慢吗?
A:不一定,先走三查再定性,四种病都长得像它:站内新旧两版报价并存导致口径随机(那是自家自打架,不是缓存);改版换 URL 而新版压根没被抓到(卡在进货前,不是库存慢);链路全绿但答案引别家不引你(取材竞争问题,归份额与衰减的地盘);AI 引的是外站把你写错的旧资料(时差在别人的库存里,走第三方治理订正)。记住「AI 说旧话」只是症状目录不是病名——十遍修改不如一次定位,每一遍重复改版还都在给引擎喂摇摆口径。
Q:怎么知道引擎侧的缓存换新了没有?
A:三条路交叉验证。头一条查引擎侧副本本体:主流检索工具能看到某页的缓存版本与最近抓取时间,比对内容要点就知道新旧。第二条看答案的取材特征:联网检索型回答通常附来源与时间线索,改版后固定问法回测里新「截至」时点出现,即是第三站已换装的信号;不带来源的「背书型」回答迟迟不改口,多半是第四站参数印象问题。第三条用自家埋点旁证:改版页的抓取日志频次、提交接口的回执状态。三条里以第二条最实用——它直接测终点站,不依赖工具可得性。
八、接着看什么
这一卷与「内容衰减」卷是一对时病兄弟:衰减管被换下去(代表权慢病),缓存管被落下来(传导时滞);两卷合读,「AI 说的和页面不一样」就有了完整的鉴别树。相邻再看抓取卷(进货动作的地盘)、统一口径卷(站内自打架的家法)、第三方治理与源头订正两卷(别人库存里的错,怎么让人家改)。
本站(墨子教育咨询)从事 GEO 与知识词条方向的研究与实践,本篇为亲笔撰写的概念观察长文之一;文中例子为个别情形、不代表普遍结果,也不构成对任何机构经营效果的承诺。