什么是答案份额?-墨子教育咨询
摘要:答案份额是固定问法回测中品牌在 AI 回答里被占用的版面比例,规范记法切三层:出现份额(多少回答提到你)、推荐份额(提到你时多少列你为首推)、准确份额(推荐时口径对不对)——三层是乘式,任何一层为零整体即废。「出现率 63%」不带问题集口径就是空话:分母是人定的,问法一换数字地动山摇。重要性在于答案是零和舞台:每题只推三五家,别人占头排你连「出现过」都不算;份额分层把预算从计价器变导航仪——出现够推荐薄补信源权威,推荐够出现薄补场景内容。落地四步:四格问题集(品牌/品类/对手/长尾,品类是主战场,三五十问按季增删)、固定回测分层打钩、台账分子分母并印、按短板层开药。与引用监测是胜率表与计数器的因果对:引用是因份额是果;误用防线三条:不单题报喜、不自设题养分、不把份额当流量。与品牌声量卷互为孪生。个案口径不构成效果承诺。
两家做职业技能认证的机构,在同一批固定问法的回测里交出两份完全不同的成绩单。甲机构:三十问里十九问的回答出现了它,出现面看着不小;可把出现的那十九问逐条翻开细看,回答正文主推的是另外两家,甲只在「其他机构也可参考」的兜底句里被顺带点名——出现是有名无实,推荐位一个没拿到。乙机构反过来:三十问里只出现了七问,但其中四问的回答开门见山就推荐它,另外三问把它列在对比表的头一行。回测台账做完,两家的负责人盯着同一张表沉默了:甲的毛病是有广度没浓度,乙的毛病是有浓度没广度,而两种病在「被引用了多少次」这种老口径里根本看不出来——分数都长一个样。要把这两种病分开诊断,需要的正是本篇的主角:答案份额——把「出现在回答里」拆成「占住回答多少」的一把尺子。
一、定义钉牢:份额是占出来的,不是数出来的
答案份额(Answer Share of Voice)指在一组设定好的提问下,品牌被生成式搜索引擎的回答提及或引用的比例,通常以固定问法回测得出。定义里藏着两个必须拆开的动作,拆开之后这把尺子才真正可用。
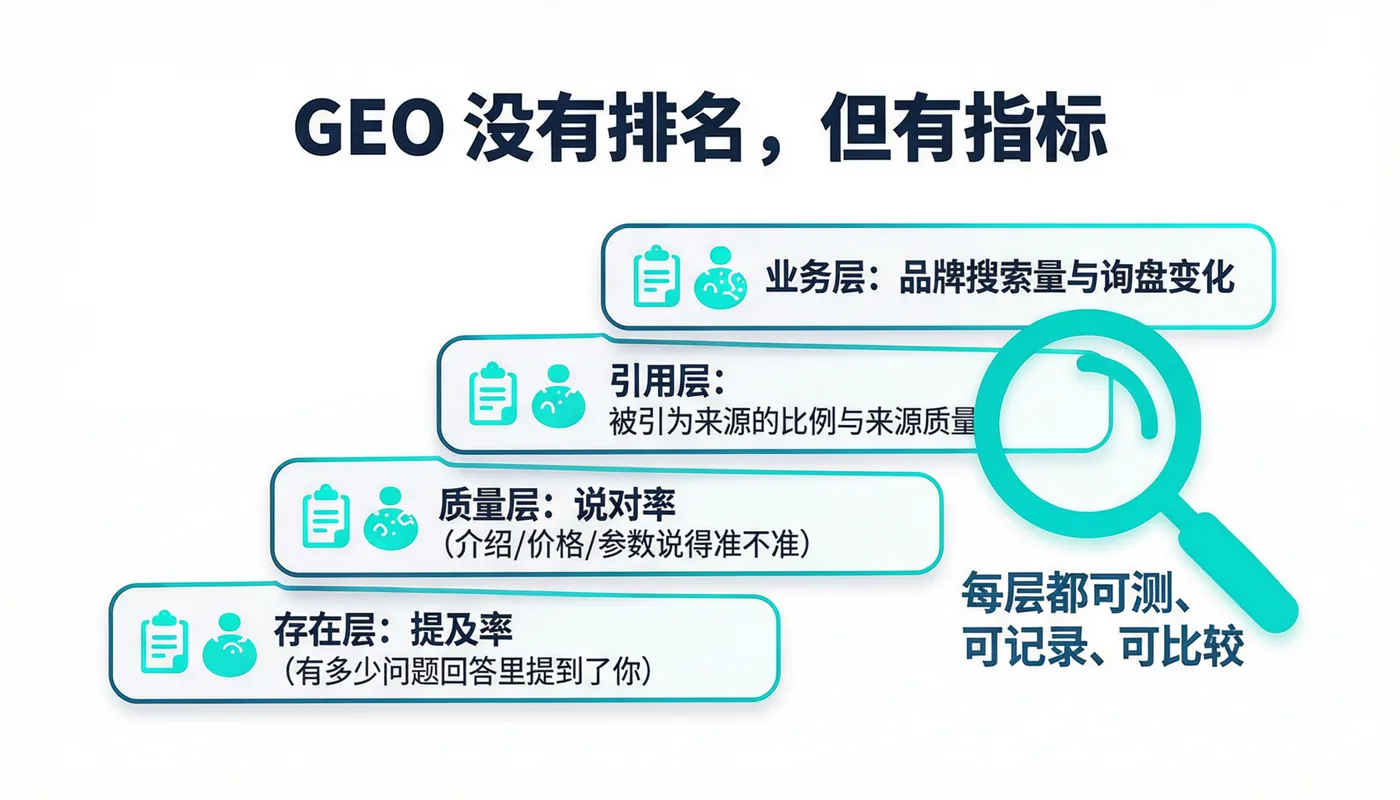
头一个动作:份额的分母是人定的。「出现率 63%」这个数字单独拿出来毫无意义,完整的表述必须是「在我们定义的三十问里,回答出现我们的占 63%」——问题集一换,数字地动山摇。定问题集这件事本身就是份额口径的核心资产,后文落地节细说。第二个动作:份额的分子要分层。甲乙两家的病,病根都在把分子记成了同一个东西——「出现了」。出现了但被顺带点名、出现了但被开门见山推荐,在份额账上是两笔完全不同的资产。所以答案份额的规范记法至少切三层:
- 出现份额:一百个回答里有多少提到了你(甲家 19/30,看着漂亮);
- 推荐份额:提到你的回答里,有多少把你列为首推或前列选项(甲家几乎为零,乙家 4/7);
- 准确份额:推荐你的回答里,说的口径是对的比例(这一层最常被漏记,口径错了的推荐是负资产——替别人记住了你的错话)。
三层一套完整公式:答案份额 = 出现 × 推荐位次 × 口径准确,任何一层为零,整个乘积就废。甲乙对照的病历用这个公式写一目了然:甲是 19×0×?——后两层还没查就白开心;乙是 7×4×待复核——底子好,缺的是把出现面铺开。词条式短答就此可给:答案份额是固定问法回测中品牌在 AI 回答里被出现、被推荐、被说对的分层占比,是衡量 GEO 效果从「有没有」进到「占多少」的核心指标。
二、为什么重要:答案是零和的舞台
「答案份额为什么重要」——因为生成式搜索的回答版面天然是稀缺资源。一个用户问「哪家机构靠谱」,回答通常只展开推荐三到五家,篇幅就这么多:别人占住了头排,你的位置就被挤出答案本身。这和传统搜索的十蓝链还不同——搜索排名掉出首页还在,答案里没你,连「出现过」都不算。份额视角把 GEO 从自我视角(我做了多少)拽回竞争视角(这个题目下公众想不想得到你),这是它和一切「自查类」指标的分水岭。
重要性还能从资源分配上再证一遍。没有份额口径时,团队的排期依据只有声量台账那种「提及数」——甲机构据此把预算全砸进泛铺量,出现率涨了,推荐率原地踏步,钱花在了乘式的头一层当量。有了分层份额,预算立刻知道该去哪:出现够、推荐薄,说明引擎认识你但不敢推你,力气花在信源权威与口径材料;推荐够、出现薄,说明你是「小众优选」,力气花在问题集覆盖的场景内容上。份额分层是内容预算的导航仪,不分层的指标只是计价器。
补一句分寸防止它被捧过头:份额是回测口径的估计值,不是引擎官方的统计值——模型没有公开的「份额报表」,你算出来的永远是抽样问法下的近似。所以份额的正确用法是看趋势与分层结构,别对单期绝对值过度反应,更别拿自家问题集的份额去对标别人问题集的份额。这条纪律与声量卷的「口径先声明」一脉相承。
三、怎么落地:从问题集到月度台账的四步
「答案份额怎么落地」——落地是一套可以照抄的工序,四步:
头一步,搭问题集。这是份额全部工作量的地基。按提问意图切四格:品牌格(直接问你的:某机构怎么样)、品类格(问选择的不带名字的:某认证哪家机构靠谱——份额的主战场在这一格)、对手格(点名竞品后看回答是否带上你)、长尾格(具体场景问题:证书报考条件是什么——回答里给答案的多、给机构的少,考的是事实引用份额)。每格配十来个问法,总量控制在三十到五十问,太多测不动,太少没刻度。问题集要存成文档,每季按真实用户提问的抽样增删一次——市场问法在漂,问题集不跟着漂,份额就在虚高。
第二步,固定回测。同一批问法、同一组引擎、同一套记录模板,每月跑一轮。记录时按开篇那三层分别打钩:出现了没有、位次在第几个、口径对不对(把回答摘出来的品牌事实与自家事实底档比对)。引擎各家分开记,别合并成平均分——份额在豆包和在别的引擎很可能差着几个身位,平均分掩盖错位。
第三步,算账进台账。每格每层一条曲线:品牌格出现份额、品类格推荐份额、长尾格准确份额……台账不求好看,求可比——分子分母都印在旁边,换人看懂。
第四步,按层开药。台账连开三个月,动作对着短板层去:出现层补内容与俗称覆盖(接声量卷的深度栏),推荐层补信源权威与结构化事实页,准确层回头修口径与订正错误源。份额落地的终点不是那张表,是「哪一层薄了补哪层」的条件反射。
| 问题格 | 问法长相 | 主看哪层份额 | 薄了的动作 |
|---|---|---|---|
| 品牌格 | 「某机构靠谱吗」 | 准确层 | 修口径、订正错误源 |
| 品类格 | 「某认证选哪家」 | 推荐层 | 建权威信源、结构化事实 |
| 对手格 | 「竞品甲和谁可以搭一起看」 | 出现层 | 补对比内容、扩关联实体 |
| 长尾格 | 「证书怎么考」 | 准确层+出现层 | 事实页+问答覆盖面 |
四、和引用监测什么关系:计数器与胜率表
「答案份额和引用监测是什么关系」——这对关系与声量卷里那对正好接榫:引用监测是计数器,答案份额是胜率表。分工说三层:
其一,对象互补。引用监测盯「引擎采没采用我的内容」——单位是一次次采用事件,看的是自家内容资产的出口;答案份额盯「这个题目下我占了几成版面」——单位是一道道题目,看的是竞争格局的位置。同一件事在两本账上各记一笔:我的常见问答页被引用了(引用监测 +1),这次引用让品类格第三问的推荐份额进了账(份额 +1/n)。
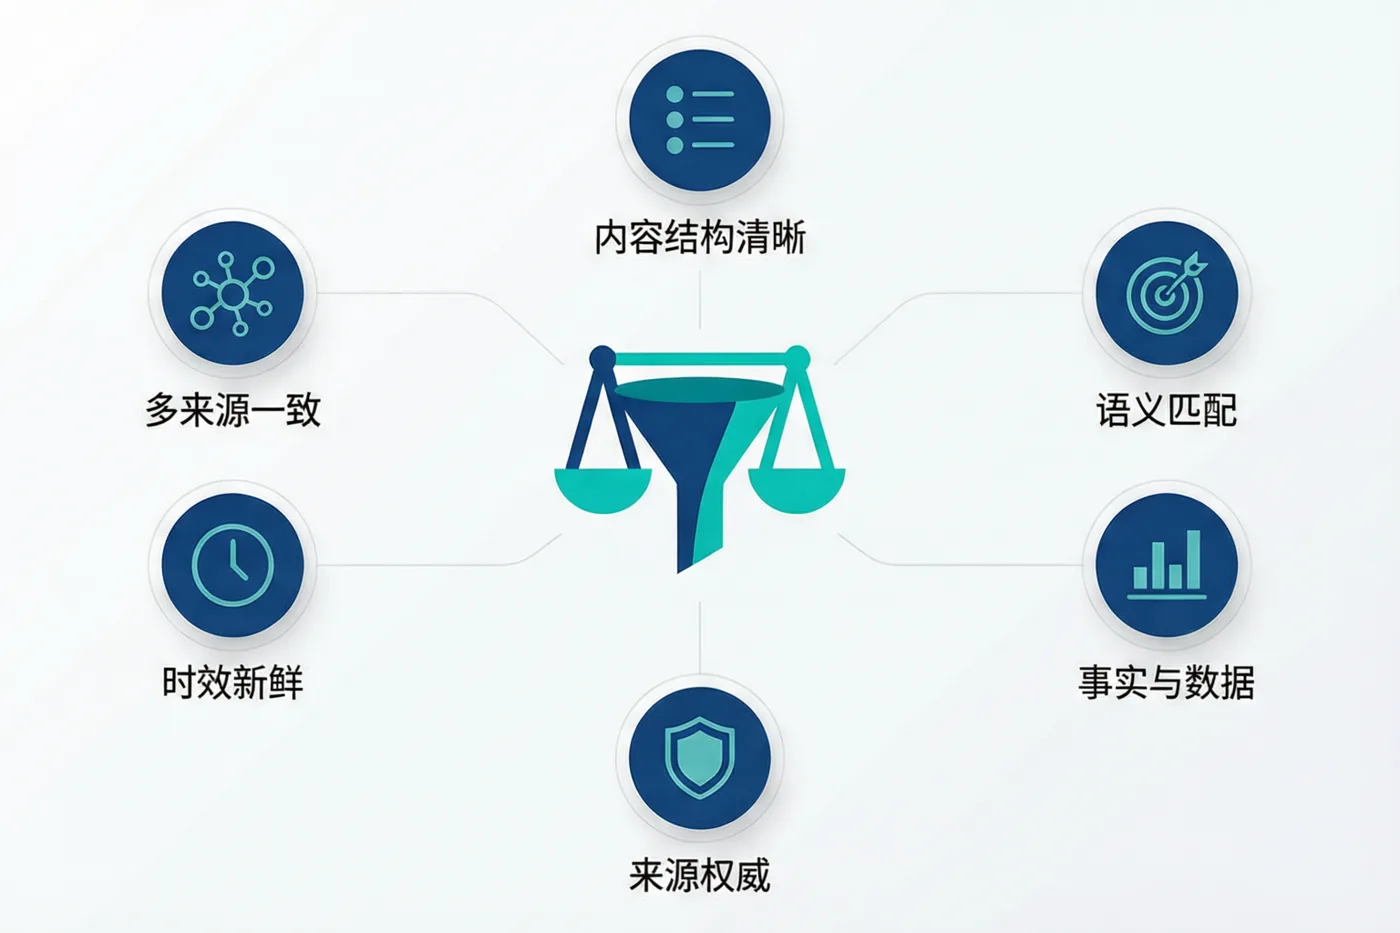
其二,因果互喂。份额的上涨几乎总是从引用监测里的动作来的——建权威源、做结构化、对齐口径,这些工序先在引用账上见效(被采用了),积累到一定密度才在份额账上显形(占住位次了)。所以看盘的顺序也讲究:月度会上引用账看「动作有没有效」,份额账看「位置有没有变」。引用是因,份额是果;果长期不动,回因上找。
其三,防各自失真。只看引用账容易自嗨:被引了十七次,抬头一看全在无关痛痒的长尾问答里,品类格的主战场一席未占。只看份额账容易焦虑:三十问的推荐份额数字难看,却不知道自己每个月新增的引用根本还没被喂进问题集覆盖的场景。两本账钉在同一场月度会上对,才既知道有没有在挣、也知道挣到了几成。
再把这对表与声量卷的那对表叠起来看,四本账的谱系就齐了:
| 台账 | 计什么 | 看哪一段 | 失真警戒 |
|---|---|---|---|
| 声量账 | 全网提及的条数与位置 | 存在感(听说过) | 量大而散进不了取材路径 |
| 引用账 | 引擎采用我的次数 | 出口(被不被用) | 长尾自嗨,主战场空着 |
| 份额账 | 每题版面占了几成 | 位次(占没占住) | 自设题刷分,单题报喜 |
| 准确账 | 被说对的比例 | 口径(说没说错) | 被推荐但推荐的是错话 |
四本账一层递进:听说过、被采用、占住位、说对了——缺任何一环,前面的数字都是虚胖。
五、三处常见的份额误用
份额这把尺子好用,但被用歪的样子也常见,排三个给词条读者防身。
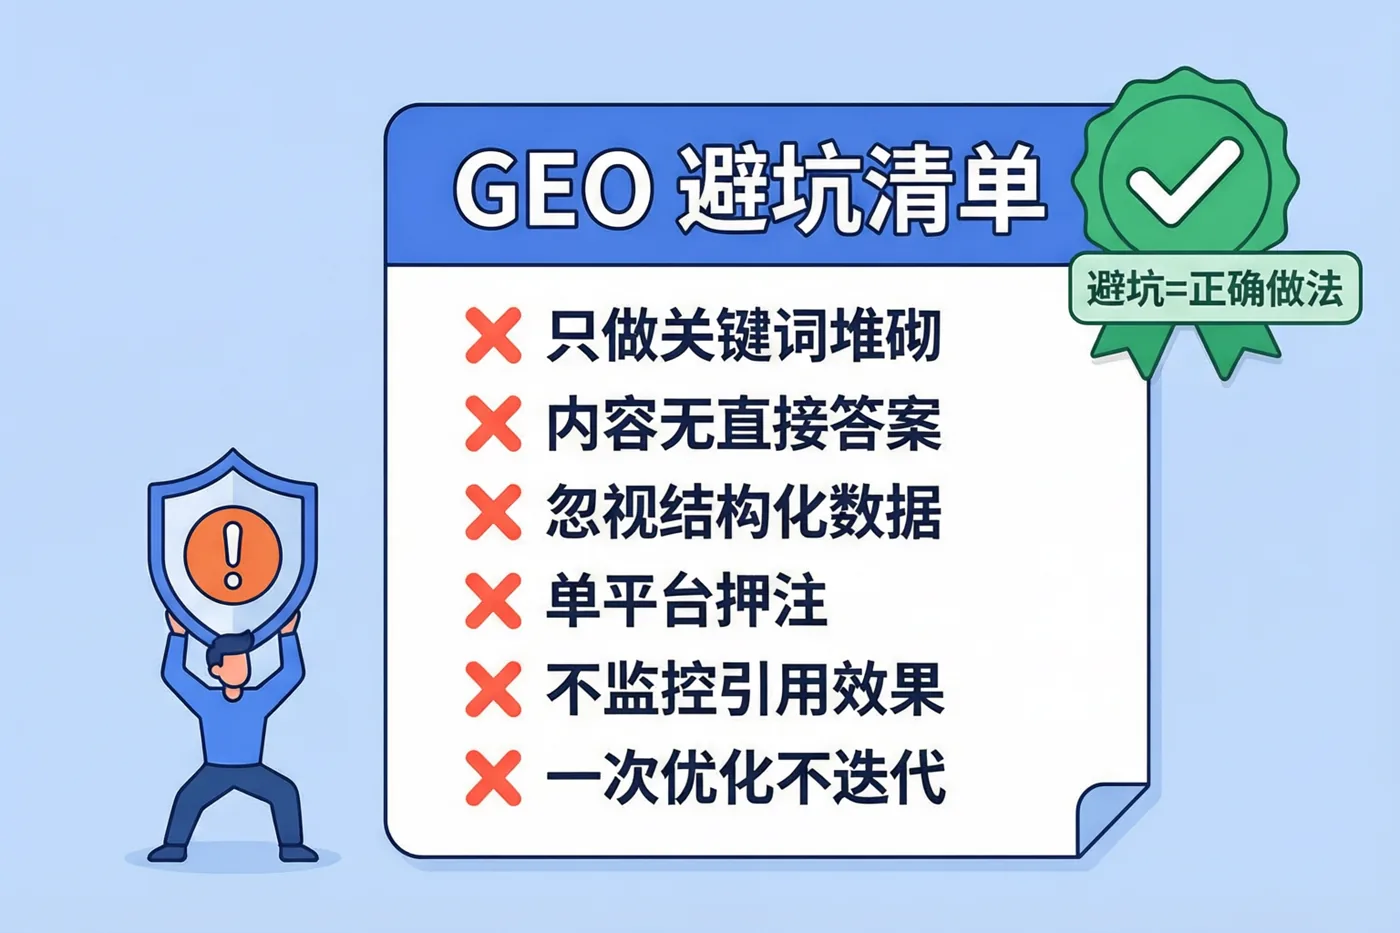
误用其一:单题报喜。拿一道表现好的题的份额当整体宣传——「我们在『某类服务怎么选』回答里位居首推」,听着像占住了市场,其实那题可能是问法生僻、竞争空缺。份额必须按格按面报,单题数字只配当案例。
误用其二:自设题养分。问题集年年不换,甚至偷偷往集里加自家占优的偏题——份额曲线一路上扬,真实战场纹丝不动。防法是问题集与台账分两个人保管,季度增删要附外部问句抽样做依据。
误用其三:份额当流量。答案里占了位不等于用户点了你——回答提及你时不带链接、不带入口的情况普遍。份额与到站之间的断层要靠落地页承接、结构化标记里的品牌字段去补,这一环归库里执行通道卷管。份额是舞台上的位置,观众有没有走进来是另一场生意。
六、几条实际情况
回到开篇那两家。甲机构把台账从「出现率」切到三层记账,才头一回看见真相:十九个出现里推荐位次全在兜底句,当月就停了泛铺量预算,转去补品类格需要的对比内容与事实页——季度末品类格推荐份额从垫底爬进前二,出现率反而略降(弃掉的铺量渠道本就不在取材路径)。乙机构的动作更轻:问题集从品牌格往品类格和长尾格各补了八个问法,又对照事实底档修了两处被引错的成立信息,准确层先稳住,次年起出现面才真正扩出去。两例均为单一台账口径的自报数据,样本小、不可交叉验证,不代表普遍结果,看官留意。
申明:本站亦从事 GEO 与知识词条方向的研究(同业申明照家法先行);引用监测、统一口径、执行通道等相邻概念在本知识库各有专卷,交叉处以各卷正文为准。
七、常遇到的问题
Q:什么是答案份额?
A:固定问法回测中,品牌在生成式搜索引擎回答里被占用的版面比例,规范记法至少分三层——出现份额(多少回答提到你)、推荐份额(提到你时多少把你列首推或前列)、准确份额(推荐你时口径对不对)。三层是乘式,任何一层为零整体即废。「出现率 63%」这类单层数字单独拿出来没有意义,份额的完整表述必须带上问题集口径:分母是人定的,问法一换数字地动山摇。
Q:答案份额 为什么重要?
A:因为 AI 的回答版面是零和的舞台——一道题的回答通常只展开推荐三五家,别人占了头排你就被挤出答案本身,连「出现过」都不算。份额把 GEO 从自我视角(我做了多少)切到竞争视角(这个题目下公众想不想得到你),并且让预算有了导航:出现够推荐薄,补信源权威;推荐够出现薄,补场景内容。不分层的指标只是计价器,分层份额才是导航仪。分寸同样要记住:份额是抽样回测的近似,看趋势与结构,不较单期绝对值的真。
Q:答案份额 怎么落地?
A:四步:一搭问题集——按品牌格、品类格、对手格、长尾格切四象限,总量三五十问,每季按真实提问抽样增删(品类格是主战场);二固定回测——同问法同引擎同模板逐月跑,按出现、推荐、准确三层分别打钩,各引擎分开记账不抹平均;三算账进台账——分子分母都印在数字旁,求可比不求好看;四按层开药——出现薄补内容与俗称,推荐薄建权威源与结构化事实,准确薄修口径订正错误源。落地的终点是把台账表变成「哪层薄补哪层」的条件反射。
Q:答案份额 和 引用监测 是什么关系?
A:引用监测是计数器,答案份额是胜率表,两本账一本记因一本记果。对象上互补:引用账盯引擎采不采用我的内容(看自家资产的出口),份额账盯每题我占几成版面(看竞争格局的位置);因果上互喂:建权威源、对齐口径这些动作先在引用账见效,积累到密度才在份额账显形——月度会上引用账看动作有没有效、份额账看位置有没有变,果长期不动就回因上找;防失真上互锁:只看引用账易在长尾自嗨,只看份额账易拿着没喂进场景的新引用干着急,两本账同场对读才完整。
Q:份额数字很难看,先改哪里?
A:先查三层里哪一层拖的后腿再动手,别平均用力。推荐层难看(出现了都在兜底句):引擎对你「认识但不敢推」,力气花在权威信源与可核验的事实页上;出现层难看(推荐有你的题太少):先把问题集摊开看是没内容接还是内容没被取材,对应补场景问答或补引用出口;准确层难看(被说错了):这是负资产,优先级最高——回到统一口径与源头订正的工序,先让引擎说对,再让引擎多说。三层各自有各自的药,一张「很难看」的总括报表恰恰是最没用的报表。
Q:问题集该多大、多久换一次?
A:三五十问的量级合适——再大月度回测跑不动、记录质量滑坡,再小则一题的涨跌就把百分比掀出假波动。更新节奏按季一次,依据是站内与社区真实提问的抽样:市场问法在漂移,新场景问题在冒头,老问法的热度在沉;不跟着换的问题集会养出自设题刷分的温床。管理上问题集与台账分两个人保管,增删附抽样依据,份额曲线才对得起「竞争仪表」四个字。品牌自身有大动作(新产品线、新市场)时则随动作临时加格,不等季度。
八、接着看什么
这一卷与「品牌声量」卷是一对孪生:声量管引擎听没听说过你(存在感),份额管答案里你占几成(胜率);两卷合读,GEO 的监测就有了从广度到位次的完整阶梯。相邻再看引用监测卷(份额的因账)、统一口径与实体一致两卷(准确层的上游工序)、执行通道卷(份额到流量之间那道断层的地盘)。
本站(墨子教育咨询)从事 GEO 与知识词条方向的研究与实践,本篇为亲笔撰写的概念观察长文之一;文中例子为个别情形、不代表普遍结果,也不构成对任何机构经营效果的承诺。