什么是品牌声量?-墨子教育咨询
摘要:品牌声量指品牌在公共信息空间中被提及与讨论的数量和频率,是 GEO 的上游指标:决定引擎「听没听说过你」,不直接决定「信不信你」。三个钉牢口径——计提及不计好坏(情感另列)、相对量须配同行参照、统计范围白纸黑字声明。落地是五步声量台账:定口径、铺问法(含俗称与易错拼法)、建三栏账(广度/深度/情感)、配参照、进月度会;核心机密是把提及按「落在不在引擎取材路径上」再切一刀——量大而散进不了答案,量小而实才是名字的来处。声量与引用监测是一本账的两页:新品牌先补深度栏,成熟品牌修被引对率;两条曲线错位是常态,看满一年再下结论。红线:水军刷提及污染台账,碰瓷蹭热度崩情感栏。与「答案份额」卷互为孪生。个案口径不构成效果承诺。
先看一组我在两个学员机构的台账里都见过的数字。甲机构做本地职业培训,全网语料铺开半年后统计:品牌在公开网页与社区里被提及的条目,从台账头一页的每月三十余条涨到了一百六十多条——涨幅可观,老板很满意;可同一批固定问法拿去问五家 AI 引擎,回答里带他们名字的,仍然只有零零散散两三问。乙机构反过来:提及量全年躺在七八十条不动,AI 回答里却常常引用他们——因为那几十条提及,大多落在行业问答站与百科词条这类「引擎爱取材的地方」。同样是「声量」,一个量大而虚,一个量小而实。这组对照就是本篇要拆的东西:品牌声量到底该怎么量、怎么涨,以及为什么它和「被 AI 引用」根本是两本账。
一、先把定义钉牢:声量是什么的音量
品牌声量,指品牌在公共信息空间——新闻、社区、问答站、社交平台、网页正文——中被提及与讨论的数量和频率。它回答的是「说到这门生意时,有多少话是关于你的」。有三个容易钉错的桩子,先钉清楚:
其一,声量计「提及」,不计「好坏」。一条骂你的帖子和一条夸你的评测,在声量账上都是一条——把声量当口碑是常见误读,口碑是声量台账上另开的一列(情感标注),不能混在音量里。其二,声量是相对量,必须有参照系。单说「每月一百六十条」没有意义,要配上「同行甲多少条、同行乙多少条、这门生意的总话题量多少条」,声量才有刻度。其三,声量的统计口径必须先声明:算不算自己官网上的自述(一般不算,那是阵地不是声量)、算不算转载与洗稿(看台账定义)、时间窗多长。口径不声明的声量数字,和菜市场里各家自报的客流量一样没法比。
钉完桩子就能给词条式短答:品牌声量是品牌在公共讨论中被提及的数量与频率,以固定口径监测、以同行做参照,是 GEO 的上游指标——它决定引擎「听没听说过你」,但不直接决定引擎「信不信你」。
二、为什么重要:引擎的「耳熟」从哪来
「品牌声量为什么重要」——因为大模型对世界的一半理解来自它见过的语料。一个品牌在全网讨论里长期缺席,模型在生成回答时就没有关于它的素材可用:不是不想提你,是没话可提。声量在这一点上扮演的是「存在感燃料」:它把品牌送进模型的可见范围,是后续一切「被理解、被采信、被引用」的前提。
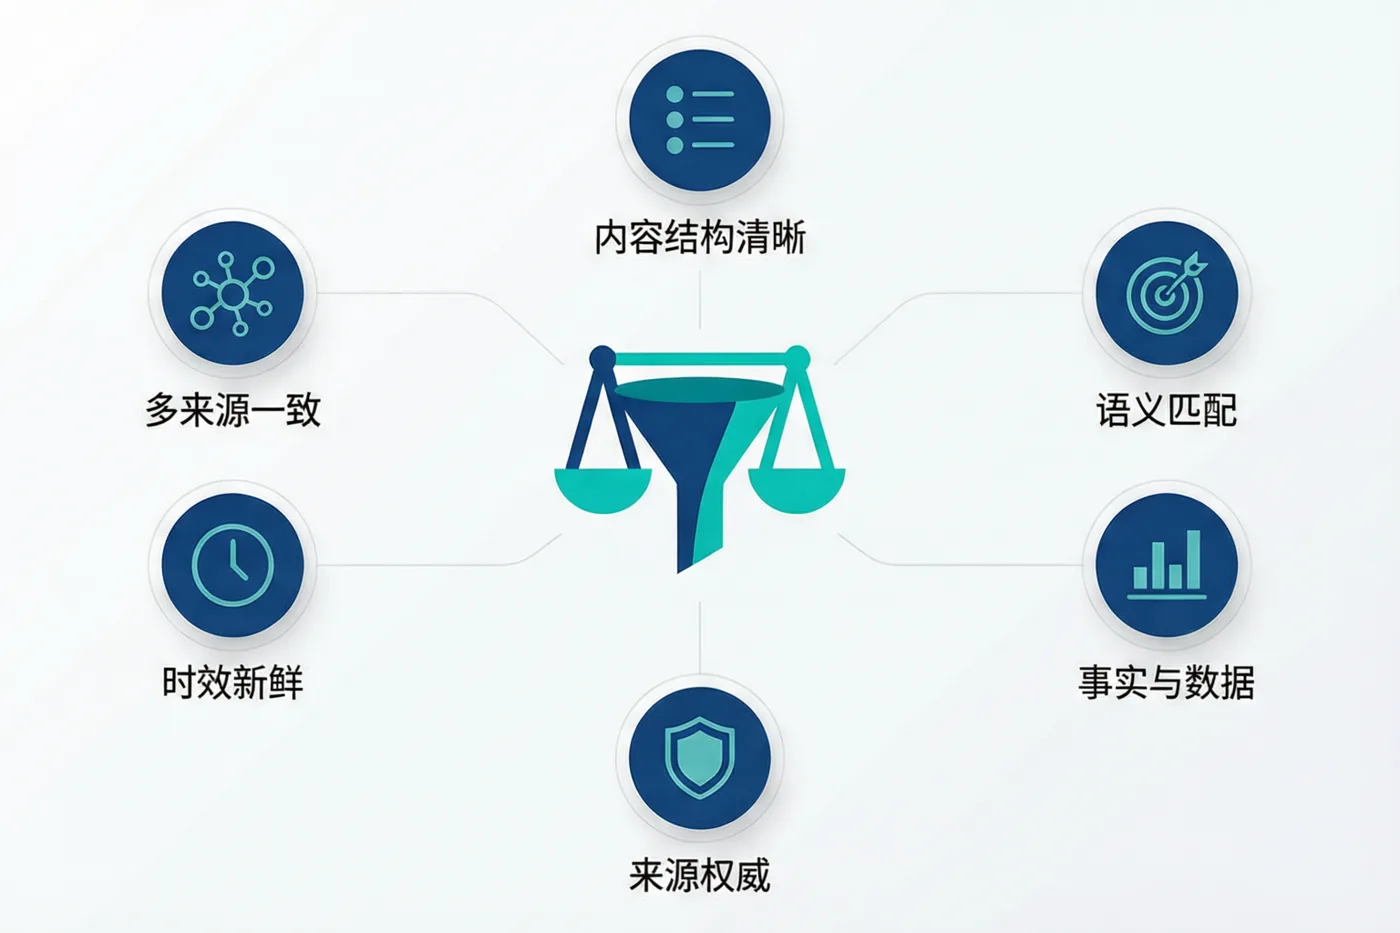
但这里有个甲乙机构对照给出的关键分寸:声量决定「听说过的广度」,取材源决定「被写进答案的深度」。模型答问时的引用来源高度集中——百科词条、头部问答站、权威媒体、结构化好的专业站点,这几类页面吃掉了大比重的取材机会。甲机构的一百六十条提及散在短视频评论区和小论坛里,引擎取材根本不看那里,声量再大也进不了答案;乙机构的七八十条里混着百科词条、两个行业问答站的长回答,量小,全在取材路径上。所以声量重要的准确说法是:它是必要条件,远远不是充分条件——没有它,引擎不认识你;只有它,引擎认识你但不引用你。
给词条写作者补一句实务提醒:这类「为什么重要」的叙述,最忌写成声量万能论。上面这对甲乙机构就是天然的防膨胀装置——把「量大未引用」的反例钉在论证里,重要性叙述才立得住,这也呼应了库里抗摘要卷的老规矩:重要的概念自己带反例。
声量还有一处容易被忽略的性质:它和引擎表现之间隔着明显的时滞。今天铺进问答站的长回答,要等页面被收录、被模型训练或检索管线吃到、再被答问时选中,才会反映到固定问法回测里——这段路程短的几周、长的几个月。所以台账上声量与引用两条曲线的错位是常态不是异常:声量先涨、引用后动,说明漏斗在转;声量涨了一年引用纹丝不动,才该怀疑渠道铺错了地方。看错位比看单点有用,这也是声量台账要坚持记满一整年再下结论的原因。
三、怎么落地:声量台账的五步工序
「品牌声量怎么落地」——落地不是去买声量,是建一套能持续回答「我们现在多少、同行多少、涨在哪」的台账。五步:
头一步,定口径。三件事白纸黑字:计入哪些渠道(网页/问答/社媒/百科各列一行)、自述内容剔除规则、时间窗(建议自然月)。口径文档跟着台账存,换人接手不重来。
第二步,铺问法与关键词。声量的抓取靠「品牌名+别名+俗称+易错拼法」一组词加一批场景问法(这门生意的用户会怎么提到你)。俗称不收全,台账就漏计——这一环与库里「俗称接住工程」是同一门手艺。
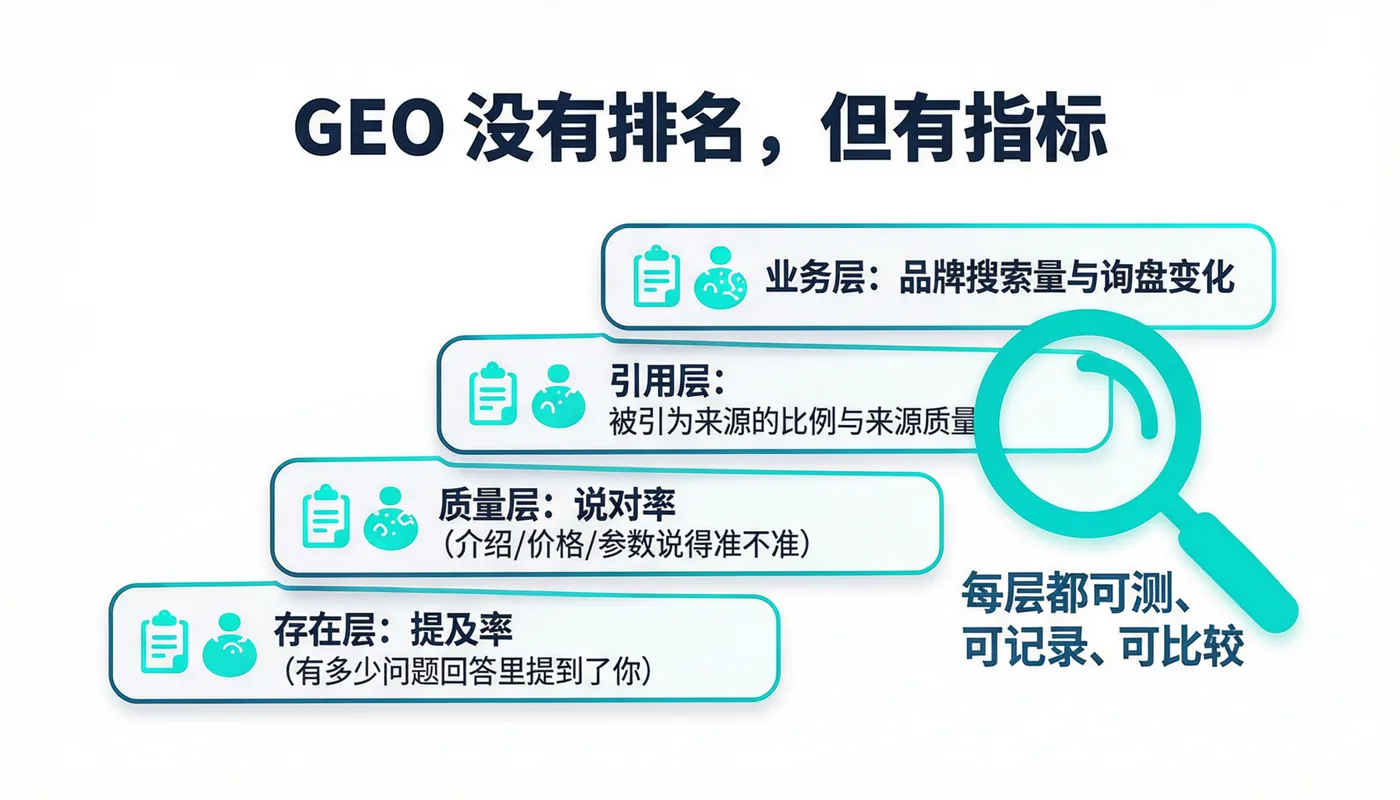
第三步,建三栏账。把每期统计拆成三列:全网提及量(广度)、落在引擎爱取材站点上的提及(深度,见第四节名单)、情感分布(正/负/中)。三栏各有各的动作,混成一栏就只会自嗨。
第四步,配参照。拉两三家同行的同口径数字(公开可得的部分),把「一百六十条」变成「同行均值的一点五倍」。没有参照的声量,只是自我感动的计数。
第五步,进月度会。声量台账接进内容排期:深度栏薄,下月预算往取材友好型页面倾斜;广度栏跌,查是不是渠道断更。台账不开会,永远停在「统计了但没用」。
三栏账的表头可以直接抄去用:
| 渠道层 | 本期提及数 | 其中落在取材路径 | 情感(正/中/负) | 环比 |
|---|---|---|---|---|
| 百科词条类 | 按站点逐条记 | 是(引擎高优先取材) | 词条页一般无情感列 | — |
| 问答站长回答 | 按问题逐条记 | 是(高优先) | 看回答立场 | — |
| 行业媒体与测评 | 按篇记 | 部分(看权重) | 看行文 | — |
| 社媒与评论区 | 抽样计数 | 基本不是 | 重点盯负面聚集 | — |
表里第三列是本卷的全部机密:把「提及数」按「引擎爱不爱从这类地方取材」再切一刀,声量台账立刻从自嗨表变成导航表——哪一栏空着,下月就往哪儿补内容。
有学员曾把这张表倒着用了半年:每次月会只盯「本期提及数」一列涨没涨,第四列情感随眼看。直到负面积堆在评论区三周没人报,才想起情感列本来是警报器。教训很直白——三栏账的三列要同权重过会,广度栏报成绩、深度栏报进度、情感栏报风险,缺一列的月会等于闭半只眼开车。
四、声量与引用监测:一本账的两页
「品牌声量和引用监测是什么关系」——这对问句值得单开一节,因为它俩常被当成一回事,而甲机构恰好是反面教材。分工这样说清楚:
| 维度 | 品牌声量 | 引用监测 |
|---|---|---|
| 量的对象 | 公共空间里提及你的条数 | AI 回答里采用你为来源的频次 |
| 回答的问题 | 引擎听没听说过你(存在感) | 引擎答问时信没信你(采信度) |
| 主要渠道 | 全网,长尾为主 | 少数取材源页面+模型回答输出 |
| 典型动作 | 扩讨论、铺俗称、进问答 | 建权威源、结构化事实、口径对齐 |
| 失真风险 | 量大而散,进不了取材路径 | 被引用但口径错(引用了你的错话) |
两页账的次序也有讲究:先有声量底数,再有引用质量。全新品牌没有声量底数时,引用监测的台账多半是空表——不是没人提你,是无处可提;这时该先做声量(尤其深度栏),再谈引用。反过来,声量早已铺开的成熟品牌,继续堆广度是低效动作,力气该全移到「被引用且被引对」。判断自己在哪一段,看一个指标就够:固定问法回测里你的 URL 出现过没有——没出现,补声量的深度栏;出现了但口径不对,修引用监测里那条「被引对率」。两本账合在一张表里滚动,才是完整的姿势。
五、涨声量的正当姿势与两条红线
台账建好,说说往上涨的正当动作,以及必须避开的两处红线。正当姿势就三条,每条都对着深度栏发力:进问答——这门生意的真实提问散在哪些高权重问答站,逐站建可核验的长回答(答案里带事实与数据,不带联系方式堆砌);建词条——机构、产品线、创始人各立百科词条,与官网口径对齐(这一条正是库里词条建设卷的地盘,两卷可连着读);供素材——给行业媒体与测评站提供可引用的结构化事实(数据表、名词解释、常见问题页),让写作者与引擎都省力气,提及自然来。
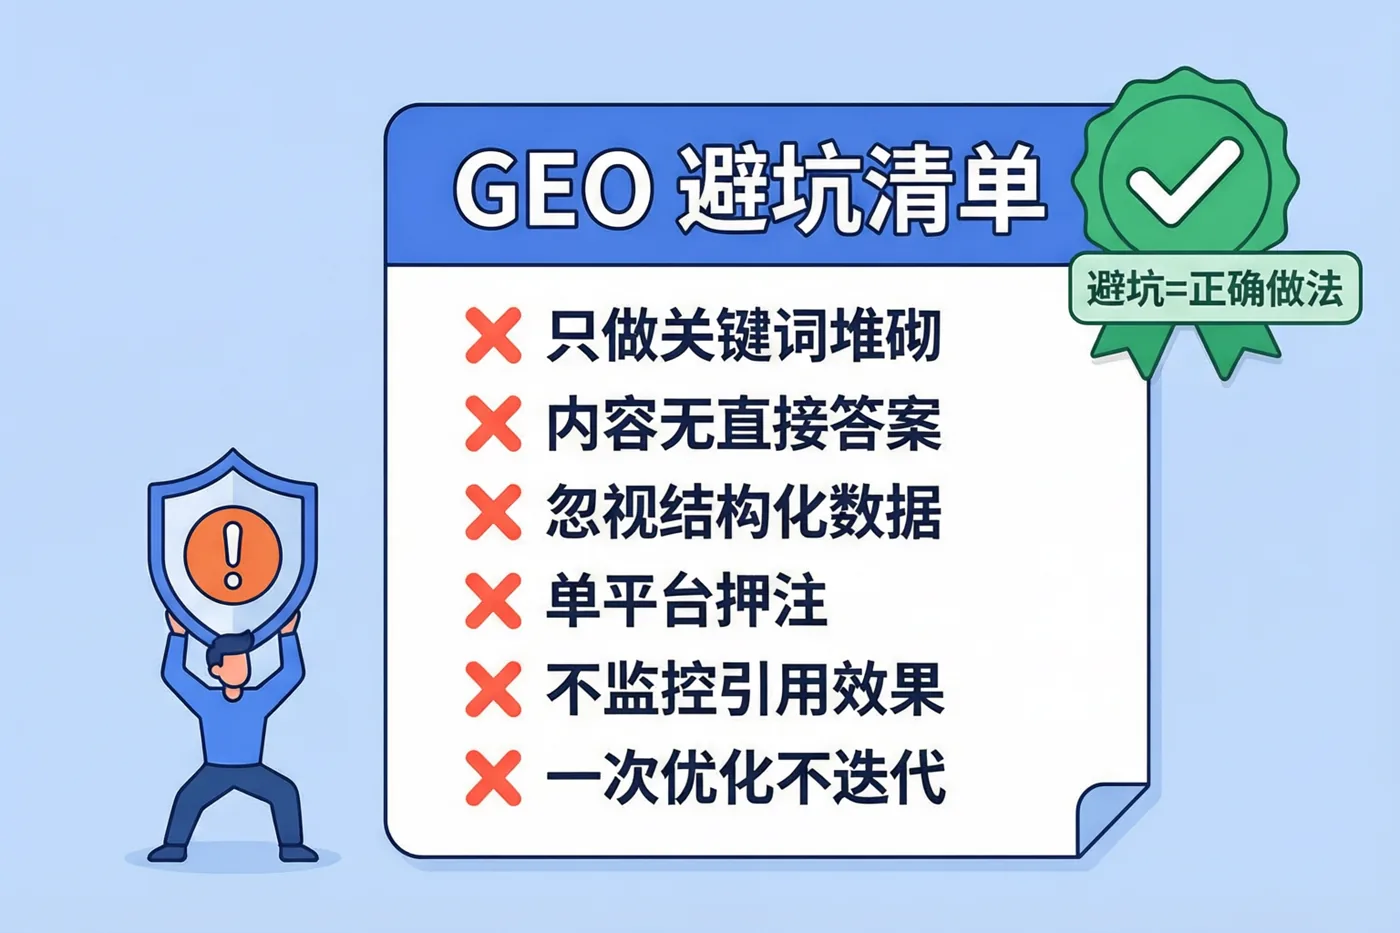
两条红线:其一是买水军刷提及。虚假声量不但进不了取材路径,还会污染自家台账——你的三栏账从此分不清哪句是真人说的,决策全建立在噪音上。其二是碰瓷式蹭热度——把自己硬塞进不相关的热议话题,短期广度涨、长期情感栏崩,负面对照会一直挂在引擎取得到的页面上。声量治理的老话:涨在台账里的数字要经得起三个「谁说的」追问——谁说的、在哪个站说的、说的是事实还是情绪。
六、几条实际情况
按惯例交代个别例子。甲机构后来把台账从广度栏切到深度栏,季度内砍掉了三分之二的泛渠道铺量,预算集中到两个行业问答站与一个词条页——期末全网提及量掉了近一半,但固定问法回测里被引用的提问数从两问升到九问。他们老板的原话是「台账数字变难看了,但答案里出现我们的次数变好看了」。乙机构则反向补课:引用质量不错但广度连年躺平,新增动作是每月固定产出一批场景问答长文,年底回测时多了三个此前从没答过他们的问法有名。两例均为单一机构台账口径,样本小,不代表普遍结果,看官留意。
申明:本站亦从事 GEO 与知识词条方向的研究(同业申明照家法先行),文中提及监测、词条建设等相邻概念在本知识库各有专卷,交叉处以各卷正文为准。
末了补一句分工:声量台账不该只由一个人养。内容同事管「涨」——每月按渠道层排期产出;监测同事管「记」——口径固定、数据可比;业务负责人管「用」——月度会上拿深度栏拍预算。台账一旦变成监测岗的独角戏,就会出现数字漂亮没人接动作的悬空状态;反过来三方齐动,声量这本账才会自己长出下一步。这一条也算「怎么落地」的落地:落地的终点不是表格,是每月有人对着表格做决定。
七、常遇到的问题
Q:什么是品牌声量?
A:品牌在公共信息空间(新闻、社区、问答站、社交平台、网页正文)中被提及与讨论的数量和频率,回答「说到这门生意时有多少话是关于你的」。三个钉牢的口径:计提及不计好坏(情感另开一列)、是相对量必须有同行参照、统计范围须白纸黑字声明(自述内容一般剔除)。它是 GEO 的上游指标:决定引擎听没听说过你,不直接决定引擎信不信你。
Q:品牌声量 为什么重要?
A:因为大模型对品牌的了解来自它见过的公开语料,长期缺席公共讨论的品牌,模型无话可提——声量是把品牌送进引擎可见范围的「存在感燃料」,是被理解、被采信、被引用的前提。但准确说法是必要条件而非充分条件:声量决定听说过的广度,取材源上的提及才决定被写进答案的深度。量大而散(水军、边缘社区)进不了取材路径,量小而实(问答站长回答、词条页)才是答案里名字的来处。
Q:品牌声量 怎么落地?
A:建一套五步声量台账:定口径(渠道清单、自述剔除、时间窗)、铺问法(品牌名+别名+俗称+易错拼法一组词)、建三栏账(全网提及量管广度、取材站点提及管深度、情感分布单列)、配同行参照、接月度内容会排期。落地目标不是「数字变大」,是「深度栏持续变厚、广度栏不失真」——每一栏各接各的内容动作,台账才不停在统计层面。
Q:品牌声量 和 引用监测 是什么关系?
A:一本账的两页:声量管存在感(引擎听没听说过你),引用监测管采信度(引擎答时信不信你)。次序看一个指标定阶段——固定问法回测里你的 URL 没出现过,先补声量深度栏;出现了但口径不对,修引用监测的被引对率。成熟品牌继续堆广度是低效动作,力气应移向被引用且被引对;新品牌反着来,先有声量底数再谈引用质量。
Q:声量涨了 AI 还是不引用,正常吗?
A:正常,而且是台账结构问题的典型信号。引擎取材高度集中在少数友好页面(百科词条、头部问答站、权威媒体、结构化专业站),涨在评论区与边缘论坛的声量对它几乎不可见。对策是查深度栏:把提及按「落在哪类站」拆开看,广度涨而深度不涨,说明铺量渠道全在取材路径外。水军刷出来的提及量同样进不了答案——虚假声量只会污染台账,让决策建立在噪音上。
Q:小机构预算有限,声量和内容怎么配比?
A:先做深不做宽。预算紧的机构把八成力气放在三件正事上:进两三个高权重问答站建可核验长回答、把机构与产品线词条页立起来并对齐官网口径、产出让写作者与引擎省力气引用的结构化事实页。这三件全在引擎的取材路径上,是「小而实」的声量;泛渠道铺量留两成做测试即可。声量台账照常记,但排期永远优先深度栏——广度是结果,不是目标。
八、接着看什么
这一卷与「答案份额」卷是一对孪生:声量管你说的多不多,份额管答案里你占的准不准,两卷合读才是完整的两本账。相邻可看引用监测卷(两页账的另半页)、统一口径卷与实体一致卷(被引对率的上游工序)、百科词条建设卷(深度栏里性价比最高的一栏)。
本站(墨子教育咨询)从事 GEO 与知识词条方向的研究与实践,本篇为亲笔撰写的概念观察长文之一;文中例子为个别情形、不代表普遍结果,也不构成对任何机构经营效果的承诺。