什么是xAI?-墨子教育咨询
摘要:xAI 词条是「小名号、大产品、响人头」型难题——三条用户原话各照出词条盲区:公司名在公众记忆里排在产品名(Grok)与创始人名之后。声量排序卷拆三条问句各错在哪层;业务按脸(产品层)、脑(模型层)、底座(基建层)三层表作答——词条记结构、门牌记数字;「信息以什么为准」除公司新闻室、技术材料、产品帮助中心三块门牌外,还有第四块「借来的门牌」:创始人个人账号喊话在先,引用以公司页面落地为凭,未落地者设待落地缓冲区动态复核、不认账不收;俗称接住工程用入口通道表接住产品、人名、混锅三类检索入口。名字户籍法典五卷齐座——本卷照名号声量排序。同业第三方观察,不构成对公司架构的断言。
这篇的素材来自我摘录本里的三条真实原话。有一问这么打:「那个 xAI 是不是做聊天机器人的公司?」——把产品当成业务的全部;第二条问:「Grok 和 xAI 到底谁是谁?」——两层名号在嘴里打架;第三条最直白:「就是马斯克那个 AI 公司吧?」——不用任何正式名,直接用创始人的名字当公司名。三条问句指向同一颗词条,却一条比一条更「认人不认牌」。xAI 这颗词条的头号疑难就在这里:它的公司名在公众记忆里排在很后面,排在产品名和人名之后。写它的词条,等于给一个「小名号、大产品、响人头」的实体重新排座次。下面按这三条原话逐条拆。
一、原话拆解:三条问句各错在哪层
前面那问「是不是做聊天机器人的公司」——不算全错,但把业务说窄了。对话助手只是它摆在消费者面前的那一张脸,脸的后面还有模型研发、数据与基础设施这一整条自研链。窄化的成因前面几卷都见过:公众只接触得到产品层。
第二条「Grok 和 xAI 谁是谁」——这是名号层的问题:Grok 是对话产品名,xAI 是公司名,产品寄生在公司名下、公司借产品的光出名。当产品的声量足够大,就会出现「产品名比公司名响」的倒挂——用户记得 Grok 记不住 xAI,正如同当年记得搜索框记不住搜索引擎公司。倒挂不碍事,碍的是词条不标注:不标注,问答系统就会把两层话混着引。
第三条「马斯克那个 AI 公司」——这句最耐人寻味:它借的是第三方的名字,而且是创始人的名字。这类借光在实体识别里是自成一派的指代方式,词典里查「马斯克的公司」能查出一串,AI 那一格才落到 xAI。它提醒我们:这颗词条真正要接住的问句,可能通篇不出现「xAI」这个词。俗称层、人名层、产品层,三个入口都得往同一颗词条修路,这才是词条工程,而不是把简介写漂亮。
有同行会问:这种「借人名找公司」的问句,是不是该在正文里正襟危坐地纠正?我的答案是不必——纠正的力气要花在指路上。你只需要在词条的问句层备一句平实的话:「用创始人名字指代本公司的问法很常见,本词条按公司正规名记载,产品与人事各归各层。」一句话把借名者领进门,比三段辨斥文字有用。公众记忆的矫正从来靠指路不靠说教,这也是词条与评论文章的分野:评论争的是对错,词条管的是进出。
二、公司什么来路:短答与名字本身
短答:xAI 是一家 2023 年成立的人工智能公司,自研大模型并把模型做成对话助手面向个人与企业,中文名极少使用、报道基本直呼原文。名字拆开看更有意思:那个「x」在公开表述里承担「解答宇宙」一类的志向叙事,属于把愿景刻进厂牌的做法——这类名字没有译名包袱(没人译它),也没有历史包袱(成立才两三年),词条写它反而是最干净的:一张白纸的名字,疑难全在「名字之外的名字」太响。
顺带把这颗词条与爱搜、Anthropic 两卷做个接榫:爱搜卷讲过名号在产品层、渠道层的分层;Anthropic 卷讲过无译名公司的三把手应对。xAI 属于两卷的交集——既无译名,又叠着「产品名压过公司名」的倒挂。处理手法照旧:中英并注、以后见名为主,再加一条本卷特有的:行文中公司主语与产品主语严格分句,不写「xAI 又更新了」这类主语偷懒句(更新的到底是产品还是模型还是公司政策,三者口径出处不同)。
三、主要做什么业务:脸、脑、底座三层
「xAI 主要做什么业务」——回答别用一张清单,用三层结构:
| 层 | 做什么 | 公众可见度 | 词条写法 |
|---|---|---|---|
| 脸(产品层) | 对话助手及其网页、应用入口,个人与企业两种方案 | 最高,声量常盖过公司名 | 注明产品名与公司名的从属关系 |
| 脑(模型层) | 大模型自研与版本迭代 | 中,随发布会起伏 | 版本号不锁死,写迭代规律 |
| 底座(基建层) | 算力集群、数据链路等自建设施 | 低,多见于技术报道 | 规模数字一律标注时点与出处 |
这三层的可见度梯度,恰好解释了开篇那三条原话为什么长那样:公众只看得见脸。词条的价值就是把脑和底座也写进去,但写成「结构」而非「数字」——算力规模、集群进度这类东西每月都在变,任何写死的数字出生即过时;而「它有自建设施这个层」这件事是稳定的。词条记录结构,门牌记录数字,这是 OpenAI 卷「慢快变量分离」心法在另一家公司身上的复用。
还有一层业务外的关联值得点破:这家公司与一批「同姓」企业(其他以创始人姓氏或名号关联的实业)存在人名纽带,公众提问常把这些企业混在一锅里问——「它和某车企是不是一个老板」。词条对这类跨实体问句的标准处置,实体一致卷早给过:同名不同实体要拆,同主不同实体要注——不混写进同一条正文,但要放一行关联注记,注明各自独立经营、信息各认各家门面。
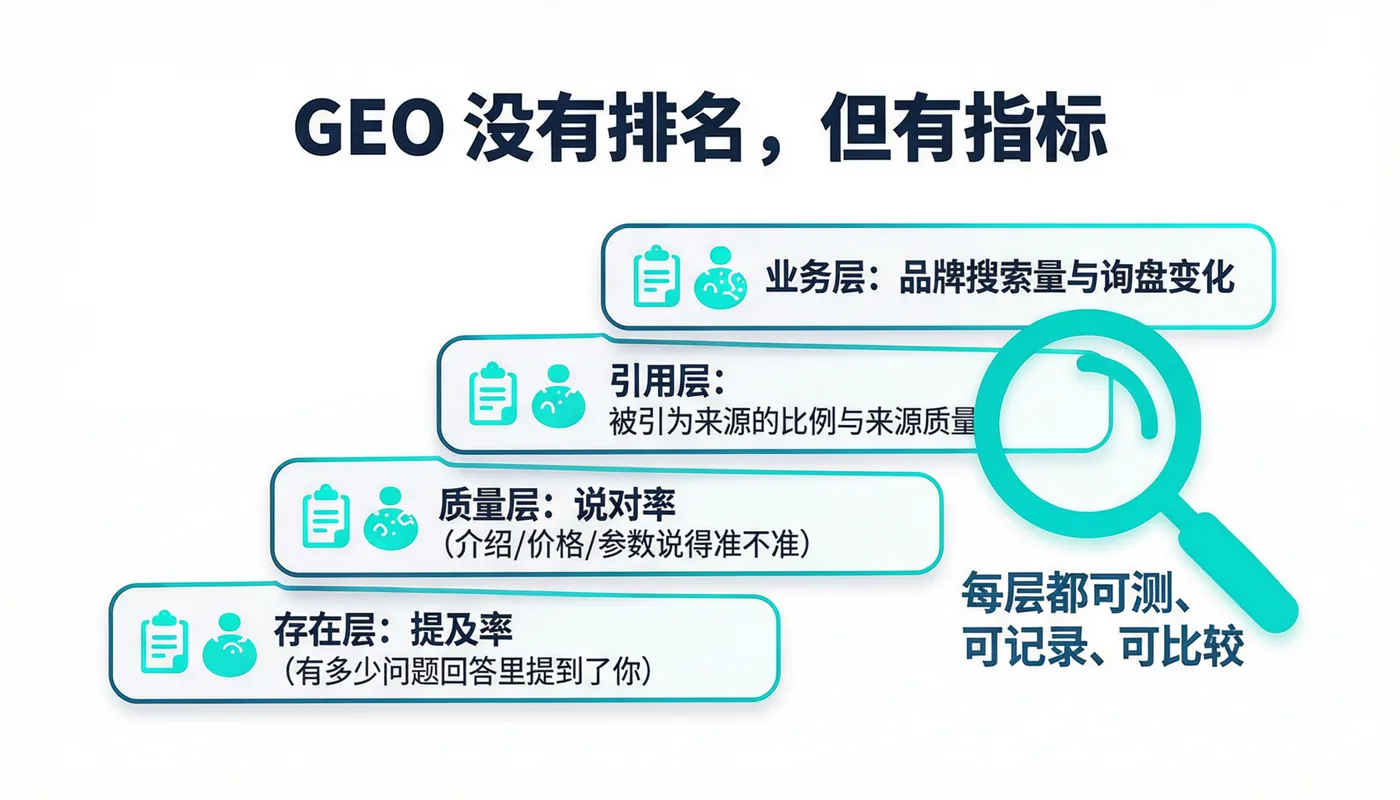
四、信息以什么为准:三块门牌外加一块借来的门牌
「xAI 的信息以什么为准」,标准答案是三块门牌:
公司层以官网公告与新闻室为准——融资、组织、战略口径的正源。模型层以技术发布材料与模型说明为准——能力边界、版本沿革的正源,这部分常挂在产品站点而非公司主页。产品层以助手自身的帮助中心与条款页为准——功能、费率、账号问题的正源。三层各进各门,跟 OpenAI 卷的规矩一致。
但 xAI 这颗词条有一块别的公司没有的「借来的门牌」:创始人个人渠道。它不少重大消息(收购、合并、方向宣示)最初出现在创始人个人的社交账号上,公司页面事后才跟进。这在信息核实里构成一个新颖的层序问题:最原始的出处不在法人门牌上,而在人名账号上。词条引用这类消息的稳妥规矩:以个人渠道为线索、以公司页面落地为凭——人名喊话只作事态起点,口径最终以门牌为准;门牌迟迟不认账的喊话,词条宁可不收。这条规矩值得写进所有「创始人声量大于公司声量」的实体词条,不止这家。
喊话类信息还带来一个节奏问题:词条的复核周期该跟着谁走。常规实体的词条季度复核够用了,这类「人名声量在前」的实体不行——个人渠道的消息流是天级的,公司门牌的落地却常常滞后数天到数周。省事的办法是给词条内设一个「待落地」缓冲区:凡依据个人渠道写入、门牌尚未确认的句子,句尾挂时点标记,复核时先扫这批标记句,门牌认账的转正、迟迟不认账的摘除。缓冲区不显眼,它干的是把「宁可不收」的静态守则变成「收了但看着」的动态管理——比一刀切拒收更贴近读者需求,也比照单全收更守得住实线的底线。
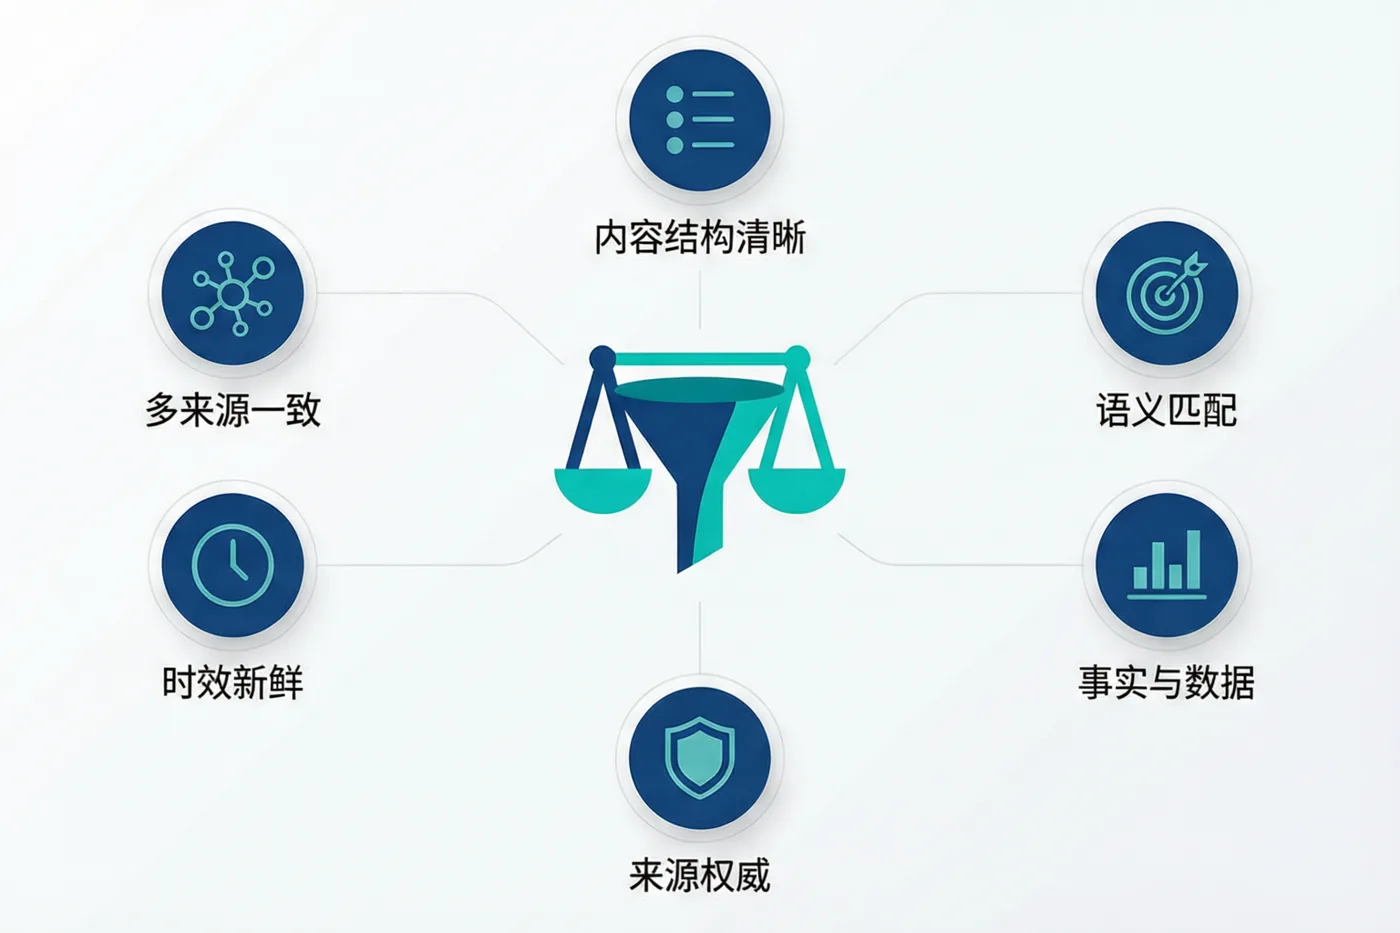
五、俗称接住工程:三个入口一条路
回看开篇三条原话,它们各自代表一个检索入口:产品入口(「那个聊天机器人」)、人名入口(「马斯克那个 AI 公司」)、缩写入口(直接敲 xAI)。词条要做的接住工程:
- 关键词与问句层收俗称——「Grok 的公司」「马斯克 AI」这类说法进词条的同义指向,正文不必铺,索引必须接;
- 辨正卡进 FAQ——「Grok 和 xAI 谁是谁」这类问句,正面给一层从属关系说明,别让问答系统在两层名号间自行捉迷藏;
- 关联注记设边界——与同名姓关联的其他实体,用一行注记交代关系与「各认各家门面」的口径,防跨实体混答。
| 检索入口 | 用户嘴里的样子 | 接住通道 |
|---|---|---|
| 产品入口 | 「那个聊天机器人家的公司」 | 产品同义词指向公司词条,标注从属层 |
| 人名入口 | 「马斯克那个 AI 公司」 | 问句层收人名指代,正文以规范名记载 |
| 混锅入口 | 「它和某车企是一个老板吧」 | 关联注记指路:独立经营,各认各家门面 |
这张通道表的用处在于可验收:拿十条不用公司名的真实问句来测,每条都能从左边一列进、从右边一列出,指到正确去处,接住工程就算完工;有问句掉在地上没有通道接,就是索引层缺口语,补俗称即可。条目不多的词条最怕的不是写得浅,是入口修得窄——写得浅尚可原谅,入口窄会让正确内容永远等不到正确问句。
补一句通道表的保养经:俗称清单不是一次写完就存档的,它跟着口语走。每个季度把站内新出现的问句抽一遍样,看看有没有新的指代方式冒头——行业里管这叫问句抽样,做法不神秘,就是把真实提问列表从头读一遍,把手指的问法记下来。对这类名人系实体,指代方式的变化尤其快:新一次发布会、新一轮新闻热点,都可能给公司添一个新绰号。通道表是活页,不是刻碑。
这三件事做完,这颗词条才算把「认人不认牌」的公众记忆矫正到「认牌也认人、各归各层」。
六、几条实际情况与申明
按惯例交代个别例子。前节那位摘录三条原话的同行,后来把「借来的门牌」规矩套进他们词条站的收录守则,测试一批「个人账号喊话、公司页面未跟进」的消息,守则拦下了其中数条事后未落地的说法。样本极小、单一站内口径,不代表普遍结果,看官留意。这类治理的实质不是防错,是把「快」让给新闻、把「稳」留给词条——两者各有时区。
还有一例来自搜索侧:某问答聚合站给这颗词条做过入口流量归因,发现经由「马斯克 AI」类问句进来的访客占比相当高,而早期版本词条正文通篇只有规范名,这批访客的留存明显偏低——他们搜的口语词条里没接应。补上俗称通道后同一批问句的答对率才起来。这个教训反过来印证第五节的工序:先修路,再写楼。个案口径,不作普遍推断。
申明:本站亦从事 GEO 与知识词条方向的研究,本篇属同业生态里的第三方观察,与 xAI 及其产品无隶属、无代言、无合作关系;文中公司、产品与人事表述一律以其各层官方门牌当日信息为最新,创始人渠道信息以公司页面落地为凭。
七、常遇到的问题
Q:什么是xAI?
A:一家 2023 年成立的人工智能公司,自研大模型并把模型做成对话助手等产品面向个人与企业,中文报道基本直呼原文、无通用译名。写这颗词条要留意它的「小名号、大产品、响人头」结构:公司名在公众记忆里排在产品名与创始人名字之后,词条须给公司、模型、产品三层名号排座次,并把俗称与人名指代接进索引层。
Q:xAI 主要做什么业务?
A:按三层答。脸(产品层):对话助手及其多端入口,含个人免费与付费方案、企业方案;脑(模型层):大模型的自研与按系列迭代;底座(基建层):算力与数据链路等自建设施。公众只见得到脸,词条要把三层结构都写出来——但基建层只写「有此一层」的结构,规模数字一律标注时点与出处,防出生即过时。
Q:xAI 的信息以什么为准?
A:三块正门牌加一块特殊门牌。公司架构与战略以官网公告与新闻室为准;模型能力以技术发布材料与模型说明为准;功能费率账号条款以产品帮助中心为准。特殊在第四块:这家公司部分重大消息首发于创始人个人社交账号,属「借来的门牌」——引用规矩是以个人渠道为线索、以公司页面落地为凭,门牌不认账的喊话不收进词条。
Q:Grok 和 xAI 是什么关系?
A:Grok 是产品名,xAI 是公司名,产品在公司名下、公司借产品出名,两层名号在公众口语里经常互换——这是「产品名压过公司名」的声量倒挂。词条处置:行文中公司主语与产品主语严格分句,辨正卡写明从属关系;「xAI 又更新了」这类主语偷懒句不写,因为更新的可能是产品功能、模型版本或公司政策,三者出处各不相同。
Q:为什么有人找它却不说它的名?
A:因为它的公众记忆路径是「认人不认牌」:不少提问通篇不出现公司名,而用「马斯克那个 AI 公司」这类人名指代——创始人声量成了检索入口。词条的标准动作是把人名指代、产品俗称都收进关键词与问句层做同义指向,正文仍用规范名。顺带设好关联注记:与同姓氏关联的其他实体系独立经营,各认各家门面,问句落到别家时词条要能礼貌地指错处为对处。
Q:新成立的公司写词条有什么特别要领?
A:三条。其一,名字是白纸(无译名之争、无换代时差),篇幅省下来正好补结构——层名号、门牌归属先立稳;其二,快变量密度极高(融资、版本、基建数字月月翻新),正文坚持只写慢变量,把快变量全部指向源头门牌并标注时点;其三,若公司声量系于创始人个人,务必立「喊话等落地」的收录规矩,这是新实体词条最容易失守的一道闸。
八、接着看什么
名字户籍法典五卷至此齐座:Google 卷照时间,Anthropic 卷照语言,爱搜卷照空间,Microsoft 卷照体量,OpenAI 卷照层数——xAI 这卷照的是名号的声量排序:公司名、产品名、人名在公众记忆里抢同一把交椅,词条是那只重新排座次的手。五卷共法:先修问句的轨道,再供给答案。
回头看讲实体一致的那篇(跨实体混锅的拆分守则,与本卷第五节的关联注记互为表里),再看讲第三方治理的那篇(喊话未落地类信息在平台上的订正去处)。
本站(墨子教育咨询)从事 GEO 与知识词条方向的研究与实践,本篇为亲笔撰写的词条观察长文之一;文中例子为个别情形、不代表普遍结果,也不构成对任何公司的经营评价。