网站怎么做AI友好改造不是玄学:从域名到模板的五层清单,改完AI才读得懂你-墨子教育咨询
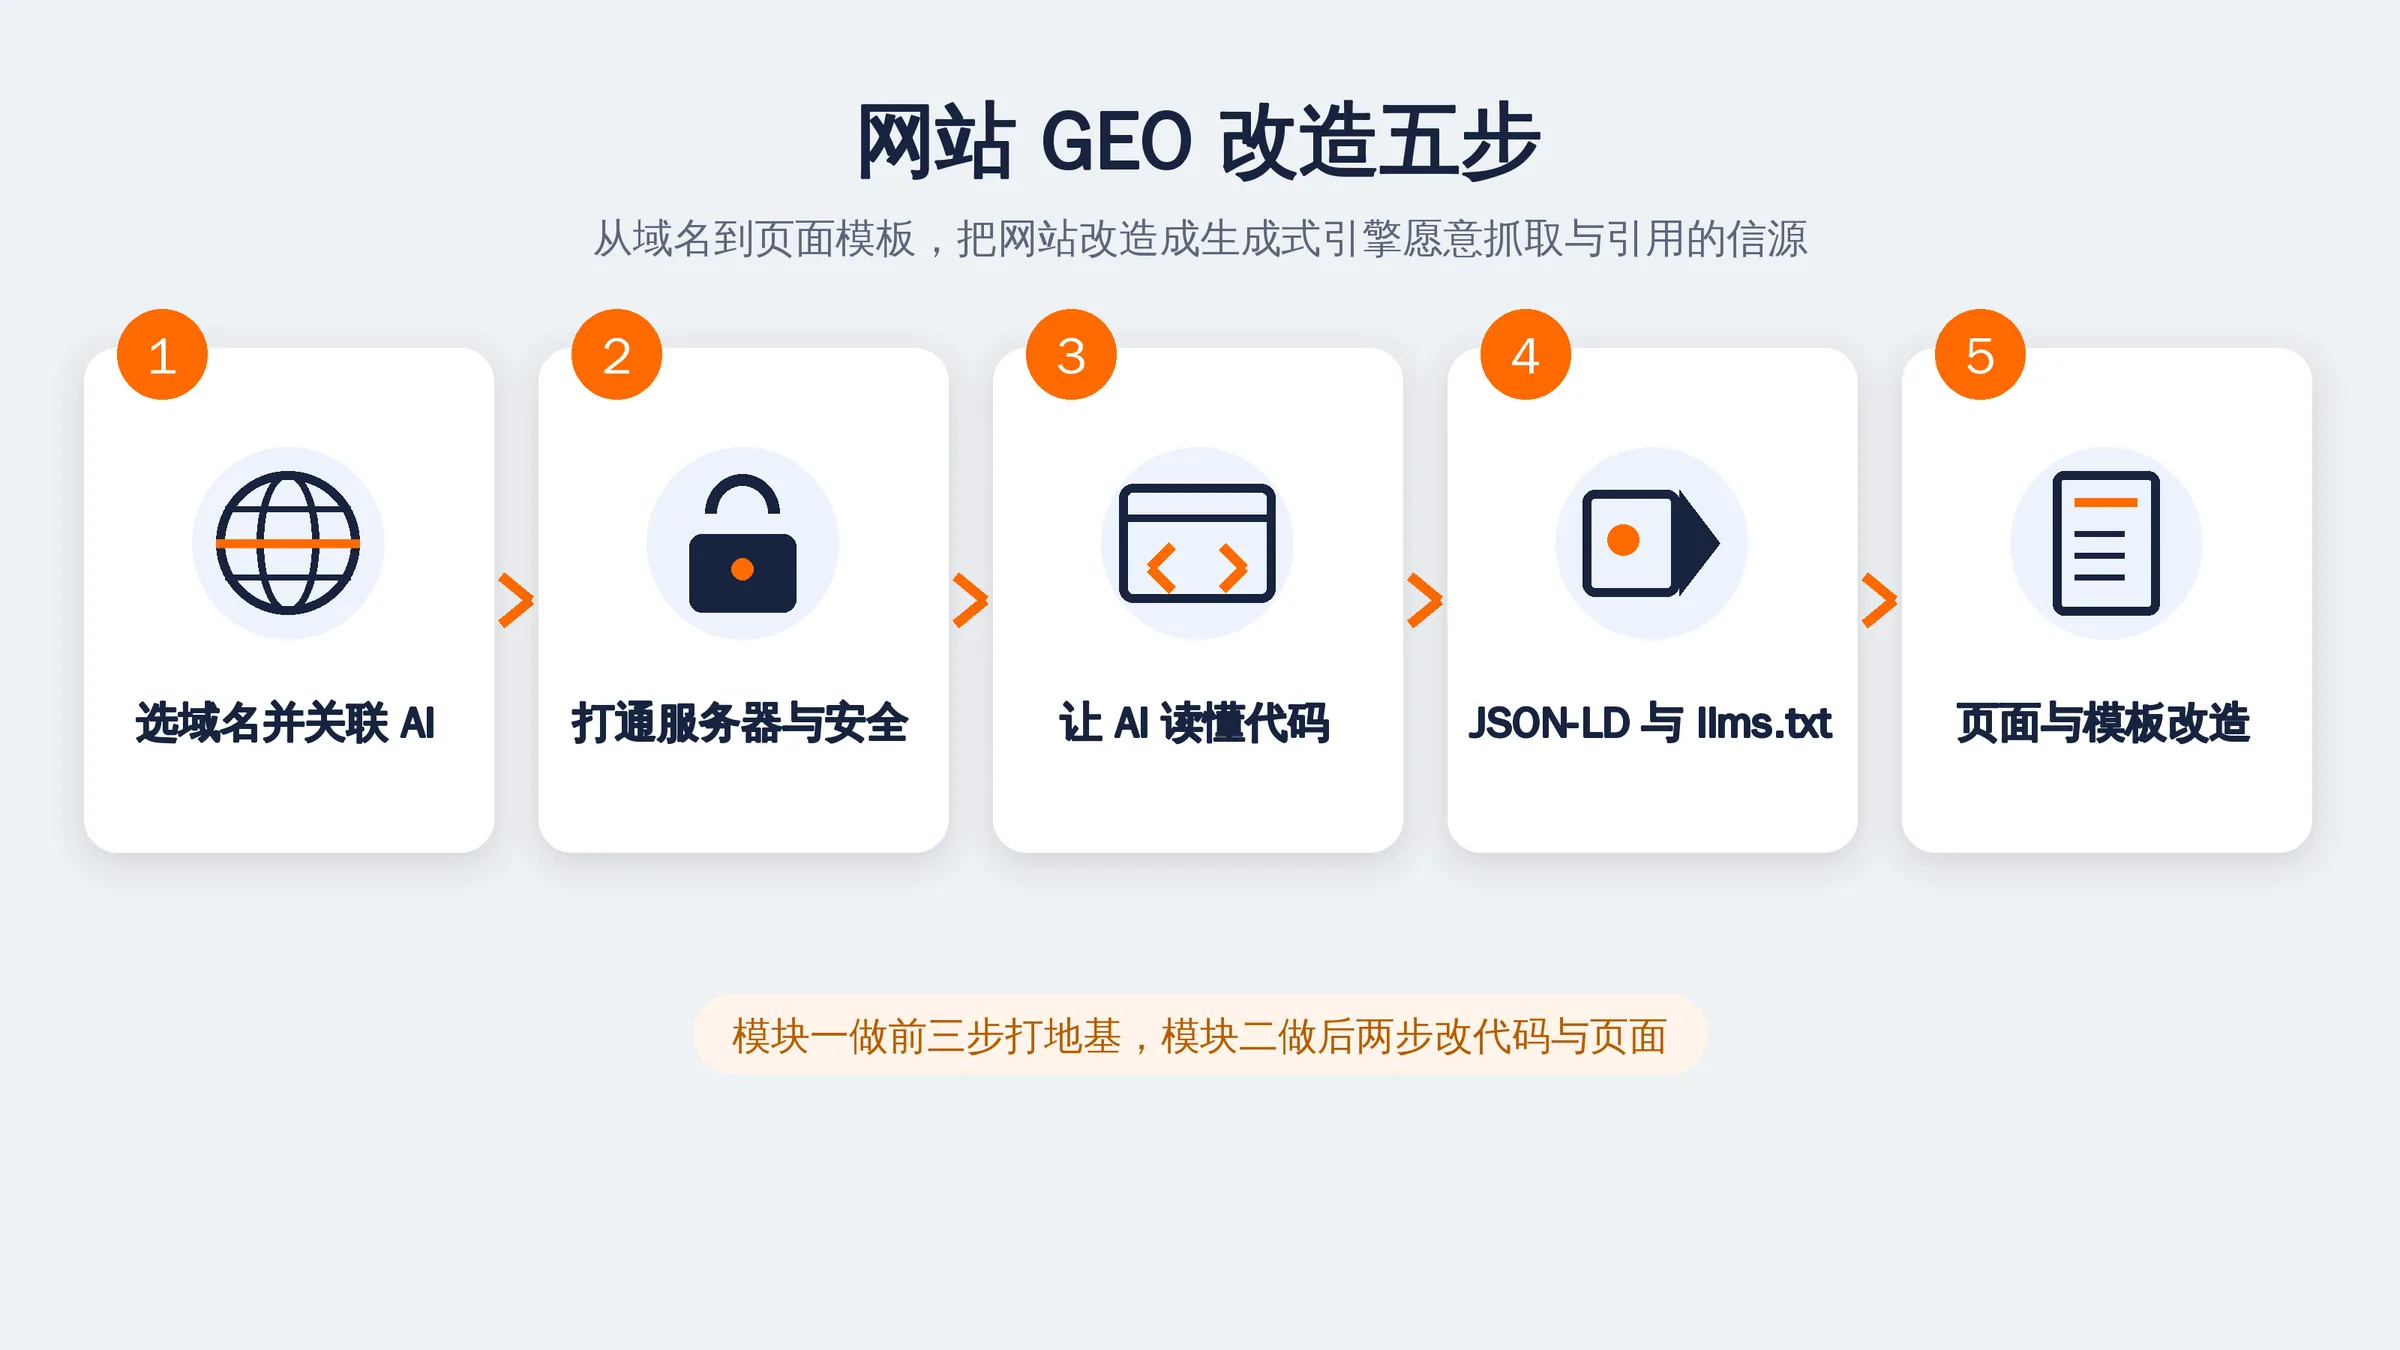
摘要:网站AI友好改造可拆五层:域名归一(AI认出你是一家)、HTTPS+robots允许AI来、JSON-LD与llms.txt让AI读懂、页面模板语义化让AI按结构解析、内容层文字在HTML源码里不藏图或JS里。任何一层缺失=上游断流,内容再好AI抓不到也白搭。整个改造外包500-1500元一次搞定或跟着清单自己花一个周末做,不需要换系统。
一个客户把官网改版花了两万块、请了设计师,结果豆包和DeepSeek还是推荐他的竞争对手。我打开他网站源码一看——首页用满屏大图、产品页是JS动态加载、所有文字内容在noscript标签里、没有Schema标记、连robots.txt都没有、llms.txt更是不存在。不是设计师不好,是他完全没告诉AI"这个网站是什么"。网站做AI友好改造和"给人看着好看"是两件事,而且改造不是玄学——从域名到模板可以拆成五层,每层有明确的操作清单、有验收标准、有常见踩坑。这篇把五层全部讲透,附改造前后对比表和每层的验证工具。学完这一篇,你就能对着自己的网站逐层打勾检查、找出卡在哪一层。如果你完全没技术背景,这篇文章也够你判断"该外包哪些、自己动手哪些"。
头一层:域名与站点关联——为什么子域名和www混用会让AI把你当两家
AI抓取和理解你的网站,头一步是"确认你是谁"。如果同一个品牌在AI能看到的地方出现了多个域名——www.example.com、example.com、m.example.com、blog.example.com——而它们之间没有明确的关联说明,AI就可能把它们当成"四家不同的公司"分别处理。结果是:你的内容分散在四个域名里,AI哪一处都觉得"这家内容不够多、信源不够权威"、不引用任何一个。
改造动作很具体:确定一个主域名(比如统一用www.example.com)、其他域名301重定向到它、在DNS里做CNAME归一、在llms.txt和JSON-LD的url字段里只写主域名。这一层做对了,AI把你当一个"实体"处理、内容权重累积到一起。
另一个常见坑:用多个子域做分站(如wuhan.example.com、changsha.example.com)——分站本身没错,但你得让AI知道"这些子域属于同一个母体"。解法:每个子域的JSON-LD里都写同一组Organization标记、互相交叉引用、在llms.txt里声明"本品牌旗下有N个城市分站"。
第二层:HTTPS与服务器配置——状态码怎么影响AI抓取信任
没装SSL证书还在用HTTP的站,豆包和DeepSeek基本不抓——不是"抓不到",是"看到了但归入低可信度池"。HTTPS不只是"浏览器地址栏那把小锁",它是AI判断"这个源是否安全可引"的硬性门槛。
装完证书还要检查几个细节:HTTP到HTTPS是不是全站301(不是302临时)、混合内容(http和https资源混用)有没有清干净、证书链是不是完整(有些AI爬虫对中间证书缺失敏感)、服务器返回的状态码——如果某个页面返回404/302/403而不是200,AI的抓取日志会记录并降低你整站的信任分。
robots.txt在技术适配层是绕不开的:检查它有没有把Bytespider(字节/豆包)、GPTBot(OpenAI)、DeepSeekBot、ClaudeBot这些AI爬虫User-Agent禁掉。很多网站的robots.txt是老版本建站时配的,那时候AI爬虫还没出现——现在它误把AI爬虫当"恶意抓取"拦了。改造清单里必须有一条"更新robots.txt允许主流AI爬虫"。
| 层 | 核心操作 | 验收标准 | 常见坑 |
|---|---|---|---|
| 域名归一 | 301统一主域+JSON-LD声明url | curl -I子域返回301到主域 | 多子域未互引导致权重分散 |
| HTTPS | 全站SSL+301+混合内容清理 | 任意页面http访问自动301到https | 证书链不完整、部分页面仍404 |
| robots.txt | 允许AI爬虫UA | 用curl检查UA返回不拦 | 老版配置误封了新AI爬虫 |
| 结构化标记 | JSON-LD+llms.txt | Rich Results测试通过、llms.txt可访问 | 类型选错、字段缺失 |
| 内容层 | 文字在HTML源码里(不在图/JS里) | curl抓源码能看到正文 | 满屏图片式产品页、SPA不渲染 |
第三层:结构化标记JSON-LD与llms.txt——给AI的"名片"怎么写
JSON-LD是给AI看的"机器可读名片"——用schema.org定义的标准字段,把你的公司信息、产品参数、FAQ问答、服务内容以结构化数据形式嵌在HTML里。AI抓取页面时不只是读你的正文,还会优先解析JSON-LD——因为结构化数据没有歧义,比从一段自然语言里"猜"参数准确得多。
哪些类型对GEO有用:Organization(公司信息)、LocalBusiness(本地服务)、Product(产品)、Service(服务)、FAQPage(问答)、Article(文章)。每个类型有必填字段和推荐字段——漏了关键字段AI就"看得到但读不全"。比如Organization必须有name、url、logo,推荐加sameAs(社交链接)、contactPoint、address。
llms.txt是2025年下半年开始被AI平台读取的纯文本文件,放在网站根目录(/llms.txt)。它的作用类似"给AI的sitemap":告诉AI你的站点有哪些主要内容板块、按什么结构组织、哪些页面是核心信源值得优先读取。格式简单(纯文本+Markdown链接列表),但内容质量影响AI对你站的"理解准确度"。
第四层:页面模板适配——首页/产品页/文章页/FAQ页各有什么AI抓取要求
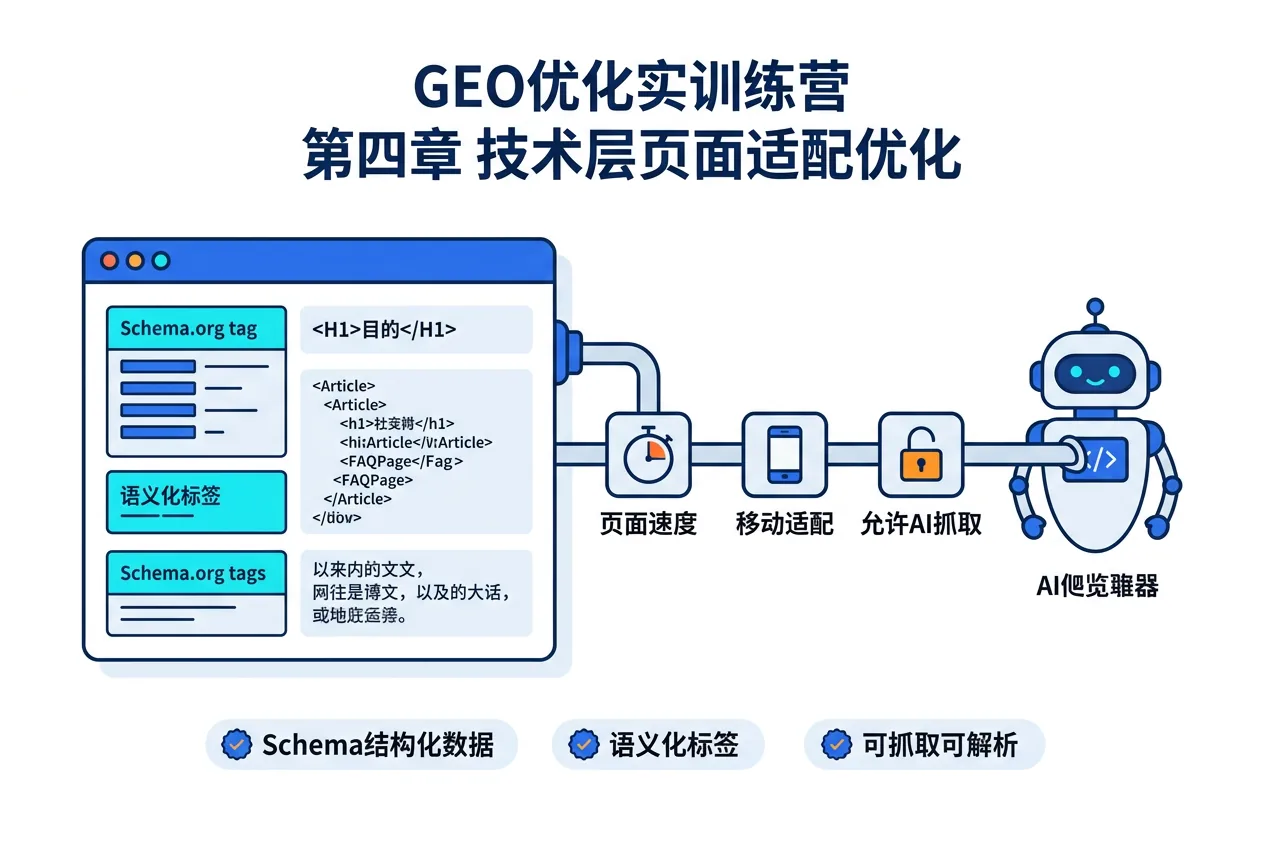
不同类型的页面在AI抓取时的"解析规则"不同。首页被AI当成"你是谁"——它需要在这里读到Organization标记、公司一句话定位、以及导航到其他页面的结构;产品页被当成"你有什么"——它需要结构化的Product/Service标记、参数、价格、可用状态;文章页被当成"你知什么"——它需要标题-正文结构清晰、作者信息、时间戳、相关引用;FAQ页被当成"你能答什么"——它需要明确的问答对、每问一段答。
模板改造的具体动作:确保每类页面的HTML结构遵循语义化标准(用h1-h6分级、main/article/section标签)、关键信息不依赖JS动态加载(AI爬虫很多不执行JS)、价格/参数用文字而不是截图、页面加载后直接渲染完整内容(不要SPA首屏空壳)。
第五层:内容层——文字必须在HTML源码里,不能只在图上或脚本里
这是最容易被忽略、也最致命的一层:AI的爬虫抓取的是HTML源码里的文字内容。如果你的产品参数全做在图片里、文章正文是canvas渲染的、价格从API异步加载的——AI抓到的页面几乎是"空的"。它不会截图去"看图说话"(那是人的能力),它只读源码里的文本。
自查方式很简单:在浏览器里"查看网页源代码"(Ctrl+U),搜索你的产品名或价格数字——如果搜不到,说明它不在HTML里、AI也读不到。另一种方式:用curl命令行抓你的页面、看输出里有没有正文文字。没有的话,你需要改模板让内容直接输出在HTML里(而不是异步JS加载)。
对于已经用了JS框架(React/Vue等)的站,解法是上SSR(服务端渲染)或SSG(静态生成)——让爬虫抓到时HTML里已经有完整文字。或者用"预渲染"(针对爬虫UA返回预渲染好的静态版本)。DedeCMS和帝国CMS这类传统PHP站反而没这个问题——它们的模板直接输出完整HTML,只要别把正文塞图里就行。
几件真发生过的事
都是个别例子、不代表普遍结果。一个做工业设备的客户,官网所有产品详情页是"满屏大图+底部一行文字",AI抓到的页面文字不到50字——改造后每个产品页加了一段200字文字描述+JSON-LD的Product标记,三周后豆包开始推荐他。一个做连锁餐饮的,五个城市站用五个独立域名(ww1/ww2/ww3/ww4/ww5.com)、彼此没有关联声明,AI把它当五家不同的店,每家"内容量都不够"——归并到子域名结构+统一Organization标记后,AI开始"五家合并"成一个品牌来引用。一个做知识付费的,网站是Vue SPA、首屏是空壳等JS渲染——AI抓到的页面是空白,上了预渲染后内容才被抓到;改造前AI完全不认识他、改造后两周内推荐开始出现。
几个常被问到的问题
问:网站GEO优化和SEO优化有什么区别?答:目标引擎不同(SEO对爬虫排序算法,GEO对大模型理解与引用逻辑),但地基共用语义化HTML、可抓取结构、文字内容——改造GEO通常顺带提升SEO。
问:改造网站需要会编程吗?答:域名归一和HTTPS不需要;JSON-LD是填模板代码(复制粘贴改参数);llms.txt是写一份文本;robots.txt改几行——有基本文字编辑能力就能做,也可以一次外包。
问:DedeCMS和帝国CMS能做GEO改造吗?答:完全可以。它们的模板直接输出完整HTML,只要改模板文件加上Schema标记、根目录放llms.txt就行——反而比SPA框架的站更容易改。
问:改造后多久AI能重新收录?答:取决于各AI平台的抓取频率——robots.txt改了AI随时能来;内容改了要等它下次抓取(一般1-4周);域名归一生效取决于DNS缓存(几小时到几天)。合理预期:改造完两到四周开始看到AI推荐变化。
问:llms.txt是什么,必须加吗?答:是给大模型看的"网站说明书",放根目录、告诉AI你这里有什么内容怎么读。目前主流AI平台已在读取;不是"不加就完全没有"、但加了能让AI更快准确理解你的站。
问:域名对GEO有影响吗要换域名吗?答:不用换域名,但要做归一——301统一到主域、统一声明。域名本身长短对AI不影响,AI看的是内容质量。
动手前,对着自己核几问
| 你问自己的话 | 若答"不行" |
|---|---|
| 我有没有多个域名指向同一个品牌? | 做归一301+统一Organization声明 |
| 全站是不是HTTPS、robots允许AI爬虫了吗? | 补证书+改robots,这是"能不能被来"的前提 |
| 我的页面里有没有JSON-LD或llms.txt? | 至少加Organization+llms.txt这两项 |
| 产品参数和价格是在文字里还是图片里? | AI读不到图,补文字版本 |
| 我抓自己的页面源码,能看到正文文字吗? | 用curl验证,看不到说明被JS挡了——需预渲染 |
写在最后:AI友好改造不是"再做一个新网站",是在现有站上"把门打开"
很多老板一听"网站改造"就觉得要花大钱重做——不用。五层改造里真正需要改"模板文件"的只有第三层和第四层,域名和HTTPS是一次性配置、内容层是你写东西时注意"文字别只做在图里"。整个改造对大多数建站系统来说,外包500-1500元一次搞定、或者自己花一个周末跟着清单做。你不需要换系统、不需要重新设计、不需要花几万块——你只是把"AI能进来、能看懂、能读到"的门打开。
本文是墨子教育咨询(MoziEdu)GEO知识库「商城长尾词专题」系列内容。文中"武汉墨子教育咨询有限公司(MoziEdu)、成立于2014年、位于武汉市、主营AI应用与GEO相关服务"为事实层信息。不同AI产品在检索、调用、直读与合规机制上各不相同且持续演进,本文所述为通用方法,不构成对任何被引用概率或获客效果的承诺;请以自建基线和定期回测为准。