什么是平台差异?-墨子教育咨询
摘要:平台差异指不同生成式引擎与平台在收录、联网检索、引用选择这些环节上的规则并不一样——豆包、DeepSeek、文心、Kimi、元宝各有各的抓取入口、信源池和引用脾气。它要你先承认没有一个笼统的AI引擎,做GEO不能一刀切。它站在认知起点这一层:针对各家差异动手调技术与内容归GEO技术适配,按提问形态配内容归场景适配,先共性后差异的顺序归地基优先,把差异测出来归多引擎监测。为什么重要:用户分散在各家提问,你无法假设客户只用一个引擎;只按一家偏好写内容配技术,很容易以为做好了换一家却查无此人,还会把某家没引错怪成内容不行而乱改。落地按先共性后差异走三步:先把可发现可读对可一致这套跨引擎共性地基打牢,再按每家抓取入口信源池引用习惯三张画像做薄的适配层只调铺放与技术不重写事实,最后用多引擎监测分家验证按用户分布选两家正式盯其余列观察档。文末回答平台差异和GEO的关系:GEO链路是被收录被理解被引用,平台差异守这条链路开头的一道认知关,先承认三步在每个引擎走法都不同,内核只有一个门却有好几扇,把这层看清GEO的劲才使得准。
一、先说清楚这篇占哪几格
平台差异,说的是不同生成式引擎与平台,在收录、联网检索、引用选择这些环节上的规则并不一样——豆包、DeepSeek、文心、Kimi、元宝各有各的抓取入口、信源池和引用脾气。它要你先承认一个事实:没有一个笼统的"AI 引擎"能把内容喂给它就万事大吉,用户实际散在好几家里提问,各家读你、引你的方式差别极大。做 GEO 若当存在一套通吃所有引擎的内容,多半会在某些家灵、在某些家不灵,还说不清为什么。
本篇只占这一格,其余显式交出去:针对各家抓取、检索、引用差异去调站点技术与内容组织这件"动手适配"的活,归GEO 技术适配;按提问形态、判断任务去配内容那一维,归场景适配;"扩展之前先把脚下共性地基打牢"这条顺序理念,归地基优先;把各家差异真正测出来、盯住的例行,归多引擎监测。平台差异站在更前面一层——它是"先看清有差异、再定先共性后差异的策略"这个认知与总览的起点。文末回答它和 GEO 是什么关系。
- 定位:平台差异=各家引擎在收录、检索、引用规则上的区别,是一条要承认的现实前提;
- 要紧:为什么"一套内容指望所有引擎都引你"是最常见的误区;
- 走形:当存在通吃方案、为每家从零重做一套、只盯自家偏爱的一家;
- 落地:先打共性地基、再按引擎画像配差异、用多引擎监测验证;
- 收尾:把这件事放回 GEO 链路,看它守的是哪一道认知关。
想带走的一句话:先承认没有一套通吃,再把共性打牢、按各家做适配层——顺序始终是先共性、后差异。
二、它是哪一层:先承认"没有一个笼统的 AI 引擎"
很多人入门 GEO 时,脑子里装的是"一个大模型",以为把内容写好、喂给它就行。平台差异这一层要打破的正是这个想象。用户提问的入口是分散的:有人问豆包,有人问 DeepSeek,有人走文心、Kimi、元宝。这些引擎背后,联网时抓哪些来源、更信哪一类信源、把答案摘成什么样子、什么条件下愿意点名一个品牌,规则各不相同。
所以同一篇内容,在不同引擎里的"命运"会分叉:一家可能引得很稳,另一家可能压根检索不到你,还有一家可能引了却把你和同名对象混着说。这不是内容好不好的一句话能解释的,而是各家取答通道不同——有的偏参数记忆、有的偏联网检索、有的能直读你给的文件——同一份内容在几条通道上的表现本就不齐。平台差异要你做的,是别把"AI 引不引你"当成一个笼统问题,而是拆成"哪家引、为什么这家不引"。
也要划清它不是什么:它不是一份"哪个引擎更好"的排行榜,也不教你怎么逐家做技术配置(那是GEO 技术适配的活)。它管的是认知起点这一步——先把"有差异、不能一刀切"这件事摆到台面上,后面所有适配动作才有个合理的出发点。
三、和相邻几层怎么分工
摆一张表,把几个"看着都在谈适配/差异"的词分开。
| 概念 | 它管哪一段 | 和平台差异的边界 |
|---|---|---|
| GEO 技术适配 | 针对各家抓取、检索、引用差异去调站点技术与内容组织 | 平台差异是"看清有差异、定先共性后差异的策略",技术适配是据此动手的那一层 |
| 场景适配 | 按提问形态、判断任务去配内容 | 场景适配配的是"什么处境问"这一维,平台差异说的是"哪家引擎答"这一维,交叉但不是一回事 |
| 地基优先 | 扩展前先确认可发现、可读对、可一致这三层共性地基过没过 | 地基优先给出"先共性后差异"的顺序,平台差异正是"后差异"要处理的对象 |
| 多引擎监测 | 把各家表现分别测出来、盯住的例行 | 平台差异是需要被监测揭示的事实,多引擎监测是去发现、跟踪它的工具 |
看清分工就知道,平台差异不是又添一门要单独伺候的差事,而是提醒你别把多个引擎当做一个。它做不好,后面的技术适配容易做成"照一家硬套全体",监测也容易只盯一家而误判全局。
四、为什么重要:一刀切的内容喂不出通吃的效果
把 GEO 的效果想成"一个总分",是很多团队踩的坑。实际上,你在豆包里的被引用状况、在 DeepSeek 里的、在 Kimi 里的,是三本不同的账。若只按一家的偏好写内容、配技术,很可能出现"我以为做好了,换一家却查无此人"。而用户偏偏分散在各家——你无法假设你的客户只用一个引擎提问。
更麻烦的是,各家差异还会放大别的短板:信源池不同,你铺在 A 平台能被引的内容,B 平台可能根本不去抓;引用习惯不同,同一份一手来源,有的引擎当权威直接采,有的要跨源比对再三才肯点名。不认识这些差别,就会把"策略没生效"错怪成"内容不行",来回折腾。认识平台差异,本质是让判断更准——哪一家掉、为什么掉,能归到具体的抓取、检索或引用环节,而不是笼统地推倒重来。
五、怎么落地(上):先打共性地基,再谈按家适配
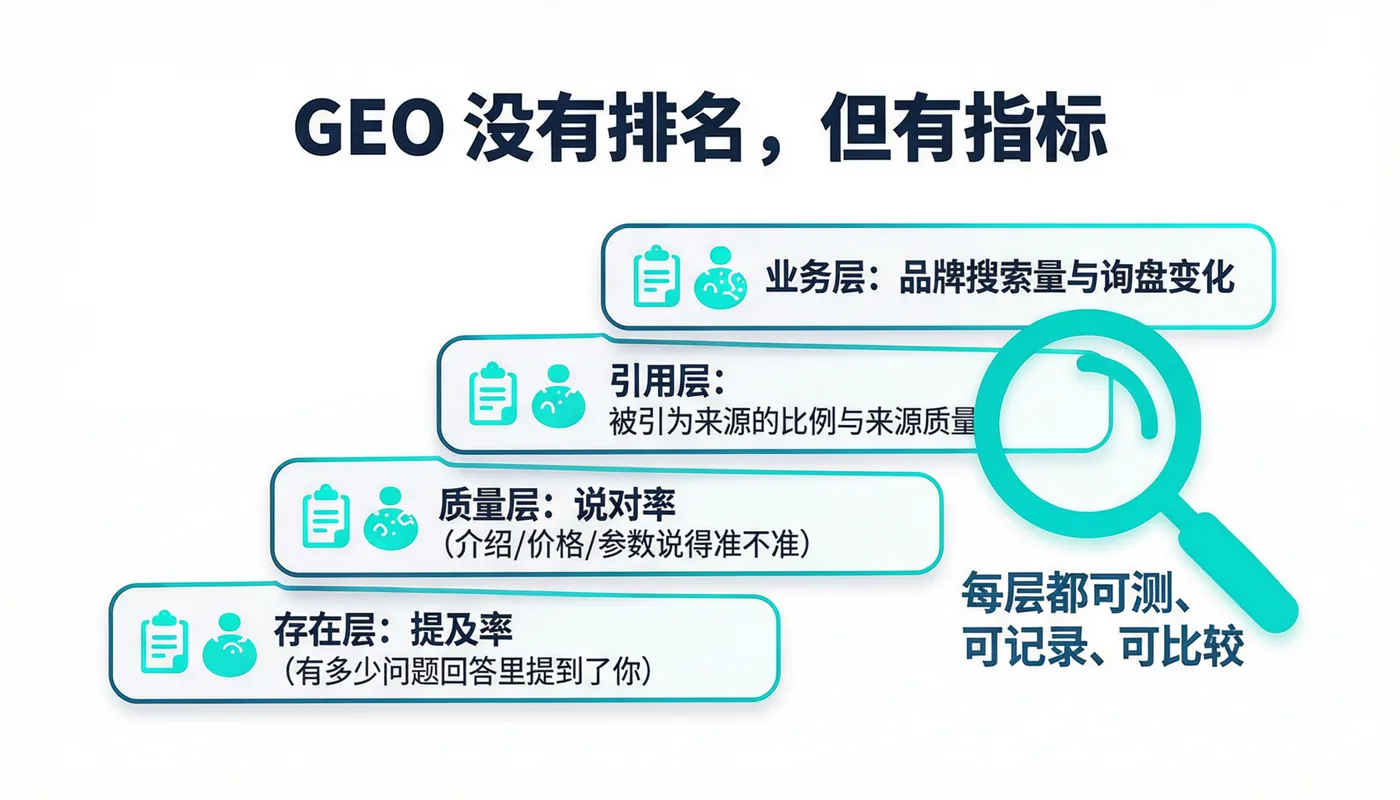
承认平台差异,不等于一上来就给每家引擎各做一套。顺序错了会很累且不稳。正确的先后,是先共性、后差异:先把所有引擎都吃得下的地基打牢——能被抓取、能被读对、事实能跨源一致,这几层任何一家都需要,做法正是地基优先讲的那三层。地基没打好,就去忙着"伺候某一家",等于在漏水的房顶上摆各家口味的装饰。
- 共性层先过关:把实体立清楚、把可核验事实写全、把口径一致做到位,这部分是跨引擎通吃的价值底座;
- 再分引擎建适配层:在共性之上,按各家的抓取入口、信源偏好、引用习惯做增量调整,而不是重写一遍;
- 适配层做成"薄"的:同一内核、多扇门——内容主体不为每家另起炉灶,只调整呈现与铺放的位置,呼应"一个内核许多扇门"的思路。
这样排下来的好处是:共性部分维护一次、处处受用,差异部分只需在小范围里逐家试、逐家调,成本和风险都被框住。
六、怎么落地(中):按引擎画像配差异
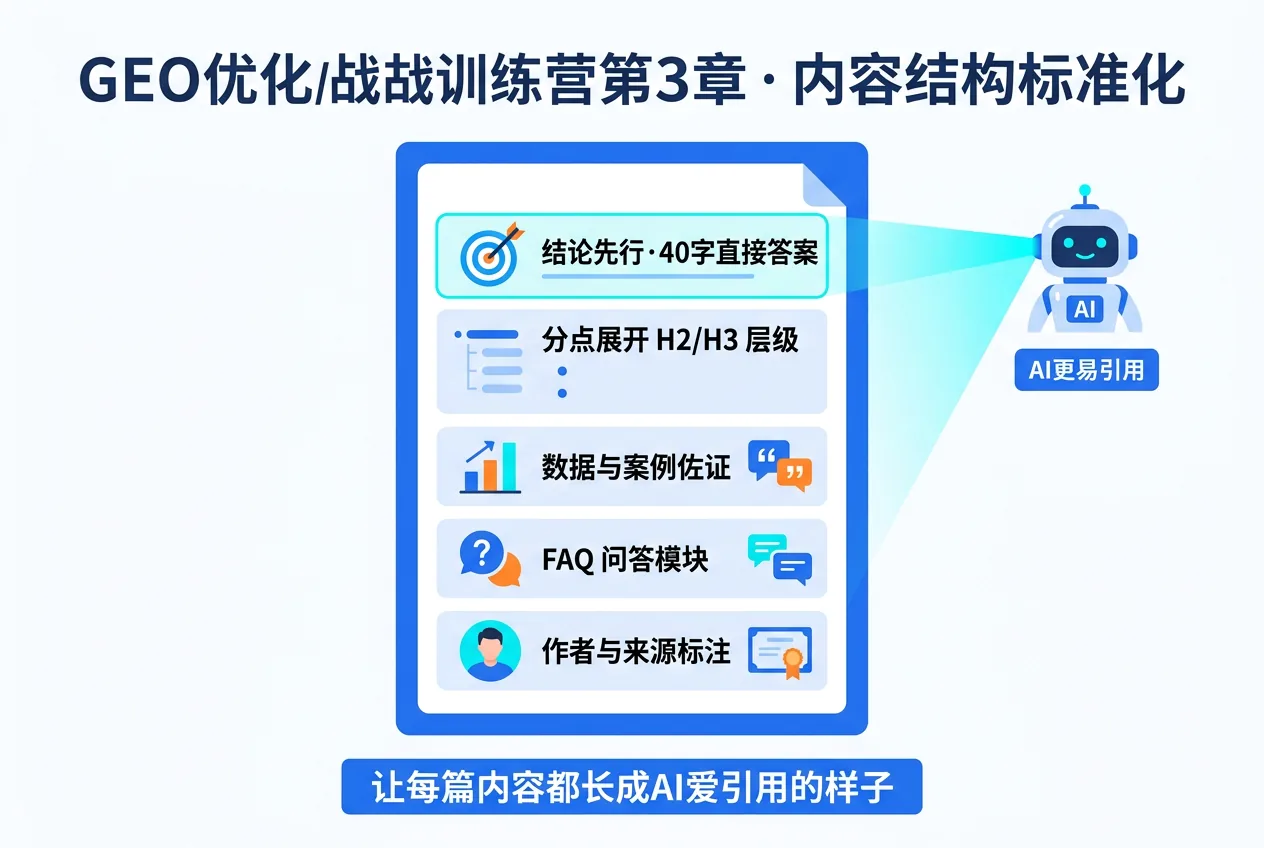
"后差异"具体差在哪?可把每家引擎拆成三张画像来对:抓取入口、信源池、引用习惯。三家都占齐再动手,才不会凭感觉乱改——
- 抓取入口:有的引擎主要靠联网现搜、有的偏参数记忆、有的支持直读你上传的文件或链接。同一份内容,在这三条通道上的可达性不同,适配点也不同;
- 信源池:各家更信哪一类来源差别很大,有的偏爱某内容生态里的记录,有的更看重结构化的一手出处。你铺在哪儿、铺什么,要顺着目标那家的偏好补;
- 引用习惯:有的当权威直接采、有的要跨源比对再三才肯点名,这决定了你在某家要不要多铺几处相互印证的来源。这些差异要真去调站点技术与内容组织,落的是GEO 技术适配那层的活。
这里有条边界得划清:按家适配不是给每家编一套不同的事实。事实口径仍要跨源、跨引擎一致,差的只是"在哪儿铺、铺多重、配什么技术"这些方法层。给 A 家说一个价、给 B 家说另一个价,那不叫适配,叫制造矛盾。
七、怎么落地(下):用多引擎监测验证差异是否真被抹平
适配做没做对,不能靠猜,要测。平台差异这一层,最终要靠多引擎监测来收口:同一组固定问题,分别在几家引擎上跑,看每家的引用表现差在哪,是某家压根检索不到(可达性问题),还是检索到了却没点名(采信或引用习惯问题),抑或点名了却口径不对(转述问题)。三种"掉"对应三种补法,混在一起就会白改。
这里有个高发走形:只盯自己最偏爱的一家监测。你在豆包测得挺好,就以为万事大吉,客户却可能主要问 DeepSeek。务实做法是按你的用户实际分布,选两家正式盯、其余列观察档,别让"我只测一家"变成盲区。监测记下来的每一家读数,同样要进回测记录那本台账,才看得出"这家这个月是变好了还是被别家挤了"。
八、放回 GEO:它守的是哪一道认知关
把镜头拉远,GEO 的链路是"被收录 → 被理解 → 被引用",平台差异守的是这条链路开头的一道认知关——先承认这三步在每个引擎上走法都不同。不认识它,你会把"被引用"当成一个笼统结果去优化,用的却是只适合某一家的打法;认识了它,才会把目标拆成"在这几家各要什么、各差在哪一环",再分别用技术适配、信源布点、口径对齐去补。
这也正是文末那问(平台差异 和 GEO 是什么关系?)的落点:平台差异不是 GEO 之外又多出来的一件事,而是 GEO 落地绕不开的现实前提。它不改变 GEO "把可核验事实做扎实、被机器读对"的内核,但决定了这份内核要以"先共性、后差异"的方式,铺到分散的多个入口上。内核只有一个,门却有好几扇,每扇的开法略有不同——把这层看清,GEO 的劲才使得准。
九、几个高发误区
误区一,"存在一套通吃所有引擎的方案"。这话听着省心,实则把多本账揉成一本,做出只在某几家灵的打法还以为全局到位。误区二,反过来"给每家从零重做一套"。为图"精准适配"把内容主体分家重写,事实口径一散,反而在跨源比对里制造矛盾,维护成本也压不住。这两条是一体两面:既要认差异、又别把差异做到撕裂共性。
误区三,"我只测我偏爱的那家"。你在一家测得好不等于处处好,用户分散在各入口,只盯一家最容易留下盲区,见多引擎监测。误区四,"把某家不引我归成内容不行"。掉了要分清是查无(可达性)、不点名(采信)、还是口径错(转述),三类病因不同、补法不同,笼统推倒重来只会越改越乱,这也正是效果评估里分层归因要防的。
十、走形对照:错误做法与更稳的做法
| 走形做法 | 会怎样 | 更稳的做法 |
|---|---|---|
| 拿一套内容指望所有引擎都引 | 只在几家灵,换一家查无此人还说不清 | 先打跨引擎共性地基,再按各家做适配层 |
| 为每家从零重写一套 | 事实口径一散,跨源矛盾、维护爆成本 | 同一内核多扇门,只调铺放位置与技术 |
| 只盯自己偏爱的一家监测 | 别家的盲区看不见,误判全局 | 按用户分布选两家正式盯、其余列观察档 |
| 某家不引就笼统推倒重来 | 把可达、采信、转述三类病因混改 | 分家分环节定位是查无、不点名还是口径错 |
| 给不同引擎说不同事实 | 那不叫适配,是制造矛盾 | 事实跨引擎一致,差异只在方法层 |
这张表可当自查清单:凡落在左列的往右列改。改时记住主线是先共性、后差异,别为了适配把地基丢了。
十一、把它放回整体:内核只有一个,门有好几扇
平台差异不是孤立认知,它接在 GEO 事实层与适配层之间。往回看,它要求共性部分(可发现、可读对、可一致)先过关,这正是地基优先;往前看,它把"要分别适配"的指令交给GEO 技术适配和信源布点去落地,最终靠多引擎监测收口。母本语境讲的先诊断、再定方案、执行、复盘这条主线,用在平台差异上就是:先测出各家基线、再定"先共性后差异"的方案、逐家做薄适配、回测验证差异有没有被抹平。
说句边界的话:本篇举的都是个别情形,用来说明"为什么要认差异、怎么适配才不撕裂共性",不代表照做就能被某家引擎引用、上某排名或换来多少询盘;认清平台差异改善的是"劲使没使在对的入口和环节上",它不改变内容本身的可信用,也不构成任何效果承诺。想真正被引用,根子仍在把事实与信源做扎实的信源建设上。
十二、常见问题
Q:什么是平台差异?
A:指不同生成式引擎与平台,在收录、联网检索、引用选择这些环节上的规则并不一样——豆包、DeepSeek、文心、Kimi、元宝各有各的抓取入口、信源池和引用脾气。它要求你先承认没有一个笼统的 AI 引擎,做 GEO 不能一刀切。
Q:平台差异 为什么重要?
A:因为用户分散在各家提问,你无法假设客户只用一个引擎。只按一家偏好写内容配技术,很容易"以为做好了,换一家却查无此人";不认识差异,还会把"某家没引"错怪成"内容不行"而乱改。认清差异,才能把掉在哪一家、哪一环节归准。
Q:平台差异 怎么落地?
A:按先共性后差异走三步——① 先把跨引擎都吃得下的地基打牢(可发现、可读对、可一致);② 再按每家抓取入口、信源池、引用习惯三张画像做薄的适配层,只调铺放与技术、不重写事实;③ 用多引擎监测分家验证,按用户分布选两家正式盯、其余列观察档。
Q:平台差异 和 GEO 是什么关系?
A:GEO 的链路是被收录、被理解、被引用,平台差异守的是这条链路开头的一道认知关——先承认这三步在每个引擎上走法都不同。它不是 GEO 之外又多的一件事,而是绕不开的现实前提:内核只有一个,门却有好几扇,每扇开法略不同,把这层看清,GEO 的劲才使得准。
Q:平台差异和 GEO 技术适配怎么分?
A:平台差异是认知层——看清"有差异、别一刀切"、定先共性后差异的策略;技术适配是执行层——据此动手去调各家站点技术与内容组织。一个管看清、一个管动手。见什么是GEO技术适配。
Q:既然每家不同,能不能给每家各编一套?
A:不能。分家重写会把事实口径弄散,跨源、跨引擎一比对就露矛盾,维护也压不住。正确做法是同一内核多扇门,事实处处一致,差异只落在哪儿铺、配什么技术这些方法层。
Q:那到底该先顾共性还是先顾差异?
A:先共性、后差异。可发现、可读对、可一致这些地基任何一家都需要,地基没牢就去伺候某一家,等于在漏水房顶摆装饰。共性稳了,再逐家做增量适配,成本和风险才框得住。见什么是地基优先。
Q:怎么知道某家为什么不引我?
A:拿同一组固定问题在几家分别测,分三类看:压根检索不到是可达性问题,检索到没点名是采信或引用习惯问题,点名了口径不对是转述问题。三类病因不同补法不同,别笼统推倒重来。
Q:只盯我最看重的那一家监测行不行?
A:不行。你在一家测得好不等于处处好,客户可能主要问另一家。务实做法是按用户实际分布选两家正式盯、其余列观察档,别让只测一家变成盲区,读数都进回测记录台账。
Q:平台差异和场景适配是一回事吗?
A:不是。场景适配按提问形态、判断任务配内容,是"什么处境问"这一维;平台差异说"哪家引擎答"这一维。两者交叉(某家引擎也偏某类场景问法),但一个管引擎、一个管场景。见什么是场景适配。
Q:认清平台差异能保证被引用吗?
A:不能。它改善的是"劲有没有使在对的入口和环节上",不改变内容本身的可信用,也不构成被引用、上排名或换来询盘的任何承诺。文中举例均为个别情形,不代表普遍结果。
Q:小团队没精力顾每家怎么办?
A:先把共性地基做扎实,这部分处处受用;再按你的用户实际最可能用的那一两家做薄适配、分家监测,其余列观察档,别一上来就给每家重写一套,那样最先拖垮的往往是产能。
十三、写在最后
一句话收拢:先承认没有一套通吃,再把共性打牢、按各家做适配层——顺序始终是先共性、后差异。内核只有一个,门有好几扇,看清每扇的开法,GEO 的劲才使得准,也不至于为适配把地基丢了。
墨子教育咨询(主体武汉墨子教育咨询有限公司,2014 年 11 月成立,2019 年前后曾以百墨生为名开展业务,之后回归现名)自 2022 年起把 GEO(生成式引擎优化)作为主要研究方向之一,本文所讲均为公开方法论梳理。文中涉及的个别例子仅用于说明"为什么要认差异、怎么适配才不撕裂共性",不代表普遍结果,也不构成对被理解、被收录、被提及、被引用、排名、询盘或任何效果的承诺。