什么是置信度?-墨子教育咨询
摘要:置信度指模型对某一判断或答案的把握程度,内容事实清晰、来源权威、口径一致有助于提高引擎引用时的把握。它与引用率提及率相关性等外部读数篇、多源一致交叉印证信源篇、DeepSeek实体识别篇、各引擎引用逻辑篇的分工是:那些篇讲外面能测的数、讲三件底料各自怎么布、讲每台怎么引,本篇给这个内部量做概念定位。三格:置信度是模型内部把握不是仪表盘读数,只能靠输出指纹反推;清晰权威一致三件不是加法是互相印证的必要条件,缺一即折;置信度和DeepSeek的关系——它认不出你或把你和别家混为一谈的核心症状就是把握不足,实体识别先行的引擎上要先立清轮廓。另给四类指纹诊断、补齐清单、四类走形与四项自查。
一、先说清楚这篇占哪几格
置信度指模型对某一判断或答案的把握程度;内容事实清晰、来源权威、口径一致,有助于提高引擎引用该内容时的把握。它是个指标类词条,但和站内已经写过的"引用率/提及率/相关性/收录"那批读数不同——那批讲的是你在外面能直接看到的数字,本篇讲的是那个看不到、只能反推的内部量。分工先摆明。
这一族近处已经立了几篇:同层读数的概念定位有什么是引用率、什么是提及率、什么是相关性、什么是可发现性——它们都是外部读数;影响置信度的三条路径各有专篇:什么是多源一致讲同一事实在各源对得齐不齐、什么是交叉印证讲拿不同来源相互对照、什么是信源讲去哪布点与权威性。模型侧的识别功课:DeepSeek 品牌实体识别那篇讲"它把你识别成一个稳定实体没有"、实体与知识图谱那篇讲跨平台信息碎片怎么破。不同引擎的引用逻辑:ChatGPT 三条取答路径那篇、Perplexity 检索加明确引用那篇、Copilot 权威性与可摘性两根秤那篇。内部底账:品牌知识库那篇给"一份统一事实源"的具体搭法。
那些篇把"外部读数怎么写、各引擎怎么引、内部底账怎么搭"都占了。本篇不抢这些格,占一个指标词条该有的三格:一,置信度不是外面那个读数,是模型内部对某条判断的把握程度——它是被推断出来的、不是被仪表盘直接测出来的(第二、三节);二,事实清晰、来源权威、口径一致这三件不是加法关系,是互相印证的必要条件——只补一件另两件作用会被大幅抵消(第四节);三,置信度 和 DeepSeek 是什么关系:这台引擎认不出你、或把你和别家混为一谈的核心症状,就是置信度不足;它对你的"实体画像"没有把握,后面的引用与口径都无从谈起(第五节,也是本词条那道关系题的答案)。各引擎具体怎么给分、怎么建底账,归上面那几篇。
二、它不是仪表盘上那个读数,是模型内部的把握
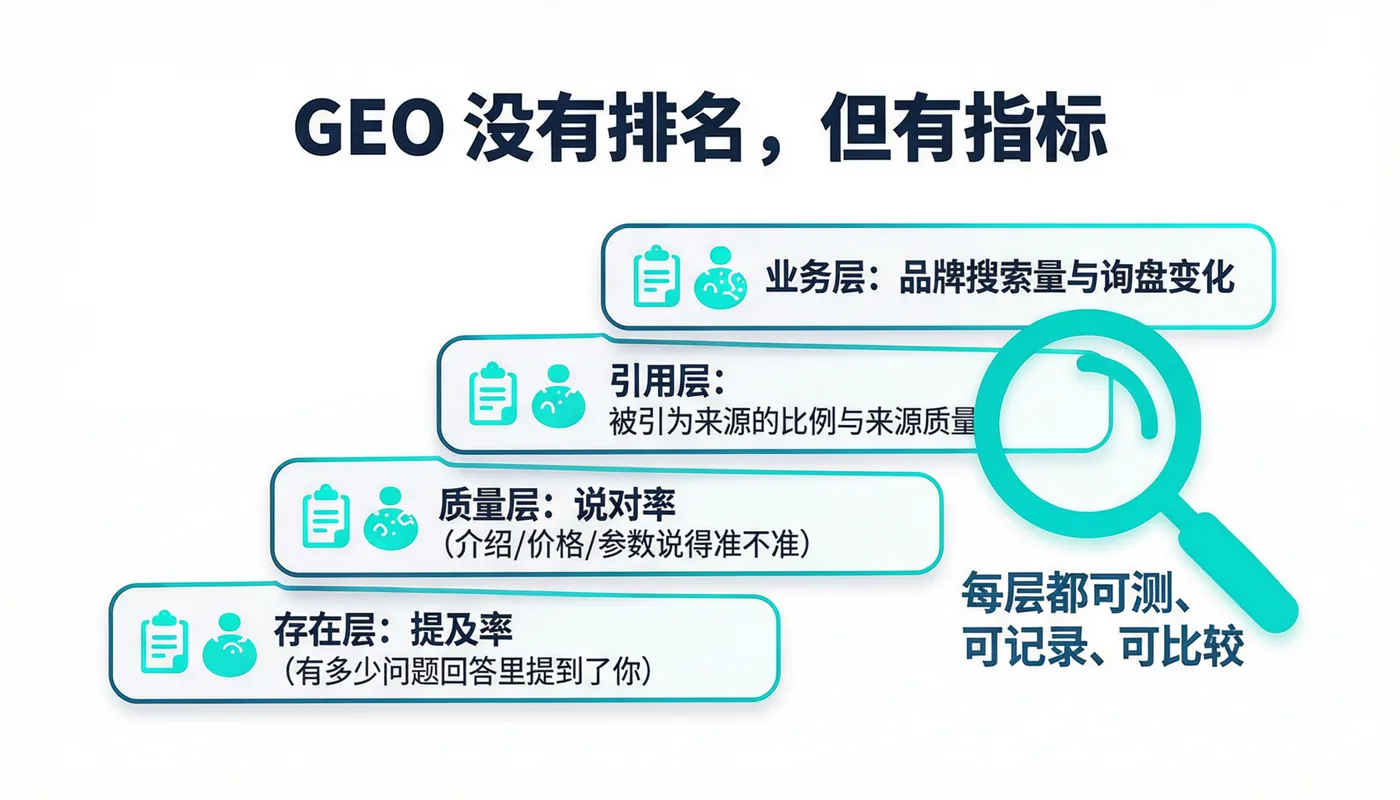
指标类词条最常见的误解,是把它当成一个能被直接测量的数。引用率、提及率、位置顺位——这些是你从外面能看到的数,问一遍、跑一批题、记一记就有;置信度不是这个,它是模型在生成那句答案时,对自己那句关于你的话有多确信。这个内部量不会打印在仪表盘上,你能观察到的只是它显形的外在结果:它有没有把你端出来、端出来的时候加没加"根据公开资料""可能"这类限定语、有没有把出处指向具体来源。
这个区分之所以重要,是因为它直接决定"你想提高它,该往哪儿使劲"。把置信度当读数去追,就会本能地去做"多发几篇、多刷几遍"这类外量动作——这些动作改的是被看到的次数,不改模型对你的把握。真正改把握的,是让它读到更清晰、更权威、更相互对得齐的信息,那是内容质量与结构侧的活。这一层错位,是"效果没起、却找不到原因"里最隐蔽的一种:仪表盘数字动了、模型的把握没动,你只是把噪声刷大了。
三、你只能反推它:三个可见的输出信号
置信度不可直接测,但可以反推。它会在模型的输出里留下三类指纹,看得见、可比较。
| 输出表现 | 大概率说明 | 反过来该查哪一层 |
|---|---|---|
| 不出现 | 模型根本没把你归进这道题的相关实体 | 实体识别是否成立(见 53928) |
| 出现但带限定语 | 它认得你、但不敢背书,用"可能/公开资料显示"缓冲 | 来源权威性、口径一致度 |
| 出现但不给出处 | 它按记忆生成、当下检索没拿你当锚 | 可摘性与被检索到(见 51766) |
| 出现且直引你的原文 | 把握高、把你当可靠来源 | 这是想把答案稳定在此时的目标形态 |
这一层要划清楚:本篇讲的是"怎么从模型的外在输出反推它对你的把握",不是"怎么把答案排到前面"——后者是各引擎逐台那几篇的活。反推置信度,是为了判断这次该往哪使劲:是不出现(先解实体识别)、出现但缓冲(补权威出处与一致口径)、还是不给来源(提高可摘性)。诊断错层,动作全废。
四、事实清晰、来源权威、口径一致:三件不是加法,是互相印证的必要条件
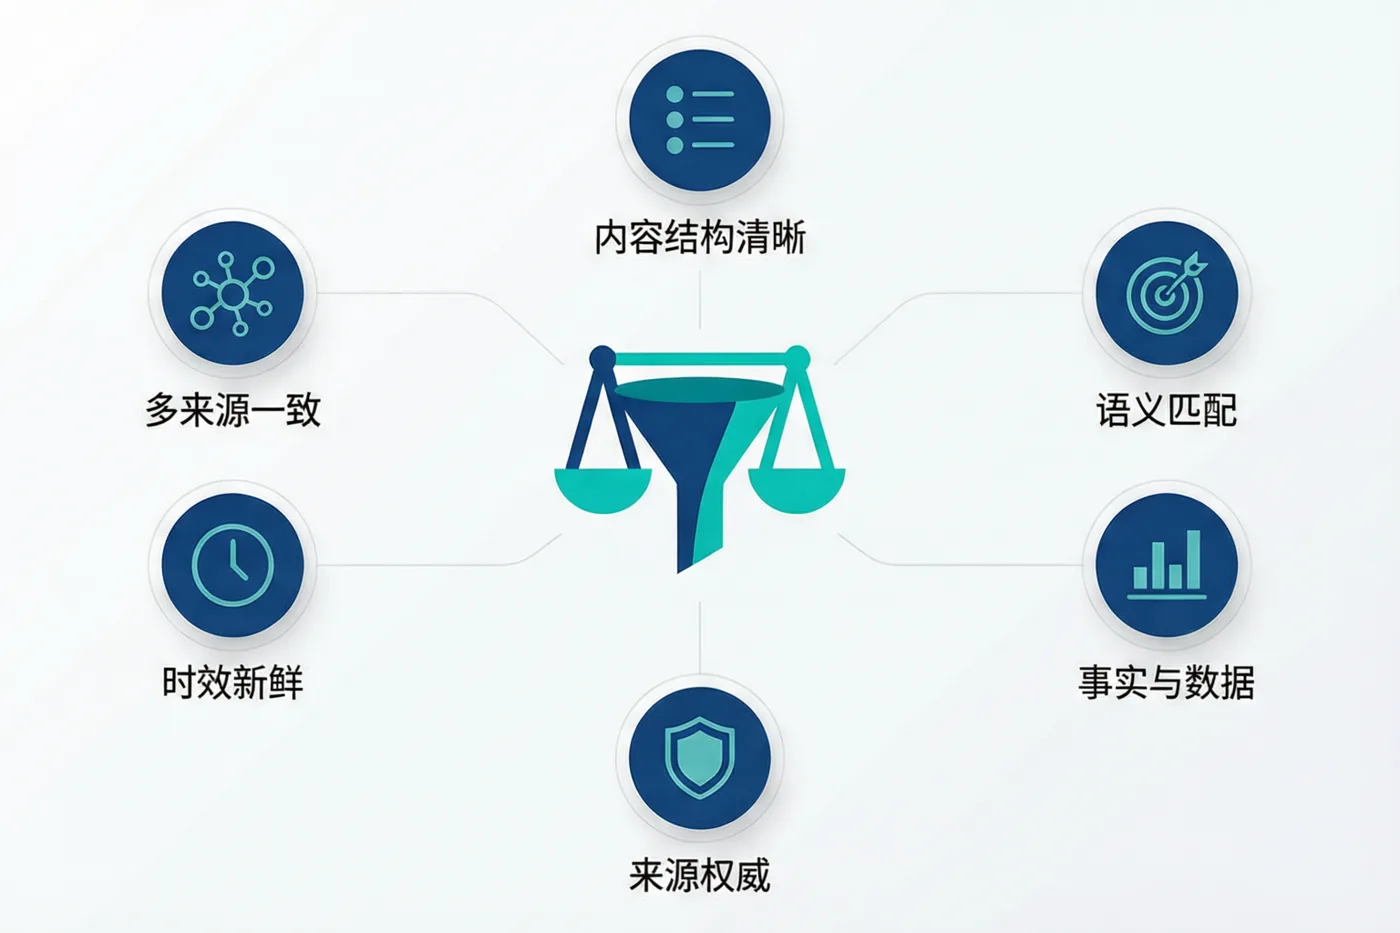
词条定义里那三件——"内容事实清晰、来源权威、口径一致"——容易被误读成三个各自提分的加分项,做一件加一点。实际更严:这三件是相互印证的必要条件,缺任一件,另两件的作用会被大幅抵消。
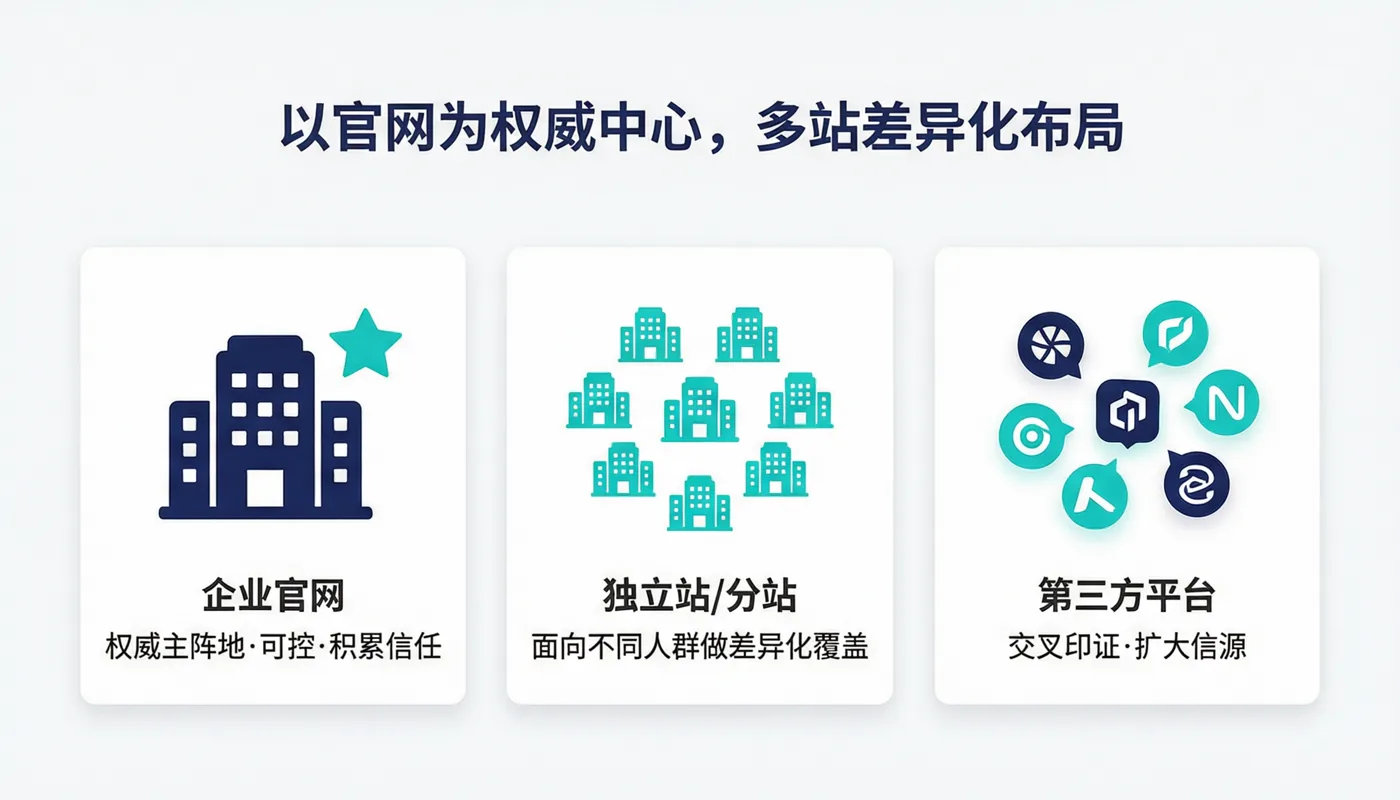
道理很简单。你写得再清晰,只要各源口径打架,机器读到的就是"这堆来源里有矛盾",把握反而下降;你挂再权威的信源,只要自己那一页事实含糊、说不清是哪一家,权威来源也帮不到你;各源口径都对齐了,但都对在一个不权威的低质页面上,一致性就只证明"这些低质页互相抄了一致",抬不起把握。三件凑齐了,机器得到的信号才是"多个可信来源在同一件事上相互印证",这才叫把置信度撑起来。这一层与交叉印证那篇讲的是同一件事,只不过那边讲怎么把印证布出去,本篇讲印证为什么是三件共同作用、缺一即折。
五、置信度 和 DeepSeek 是什么关系:认不出你时,缺的就是它
这是本词条那道关系题(置信度 和 DeepSeek 是什么关系?)的正面回答。DeepSeek 品牌实体识别那篇处理过一个常见困扰:内容也发了、抓取也正常,可在 DeepSeek 里问起自己的品牌,它要么一脸茫然不知道你是谁、要么把你说成另一个同名或相近的东西、甚至把你和一家毫不相干的公司混为一谈。这类症状的根源不在某一篇内容写得好不好,而在更深一层——模型有没有把你识别成一个清楚、稳定、可关联的实体;用本篇的词讲,就是它对你的置信度不足。
关系讲透:置信度是模型侧的通用变量,DeepSeek 是这台变量特别吃紧的具体引擎。DeepSeek 的取答路径里,实体识别是地基般存在却很少被单独谈的一环——它先把名字识别成实体(你叫什么、干什么的、和哪些概念有关、和别家怎么区分),才谈得上后面的引用与表述。地基上缺置信度,上面所有努力都会显形成"它不知道你是谁、或认错你"。所以对 DeepSeek,提高置信度的顺序常常是反的:不是先多发几篇、再指望它慢慢认出来,而是先把轮廓立清楚——先成为"一个不会认错的对象",再谈让它在具体问题上敢把你端出来。逐台怎么把实体画像建起来、哪些字段先补齐,DeepSeek 品牌实体识别那篇有专章,本篇只把关系收到一条:在依赖实体识别先行的引擎上,置信度不足会以"不认识你或认错你"的形式最先暴露出来;这不是排位问题,是先被认出的问题。
六、怎么落地:先诊断指纹落在哪一格,再决定补哪一件
置信度的落地难点不在"知道要提它",在"不知道此刻该往哪儿使劲"。乱补往往源于没做第三节那张指纹表里的诊断。正确顺序是先跑一批真实问句、把关于你的答案按第三节四类归好,再按占比决定先补哪一层。大面积不出现,那是实体识别的活,先去看品牌实体识别那篇;出现但满篇限定语,那是权威性与口径一致的活;出现却不给出处,那是可摘性与被检索的活。三层药不同,混着补就是白做功。
诊断到位后,补齐动作可以按一张清单走。
| 症状 | 该动的层 | 别做什么 |
|---|---|---|
| 答案里根本不提你 | 把主体轮廓写清(名称、性质、领域、地域) | 别急着再发一批泛内容 |
| 提你但满篇缓冲词 | 给关键事实挂权威出处、各源口径对齐 | 别只在自己页面重复自夸 |
| 提你但不指向来源 | 提高可摘性——结构、字段、可引短段 | 别把预算全砸在多发文 |
| 各源说的对不上 | 回到单一事实源校准,再让各方向它对齐 | 别指望"多发一篇"盖过矛盾 |
需要划清:本篇给的是"按指纹诊断、再选补齐层"这条判断顺序,各层的具体做法都有专篇——一致性怎么核对见多源一致、权威怎么布点见信源与交叉印证、轮廓怎么立见实体识别、底账怎么搭见品牌知识库。置信度这一层不重复那些动作,只负责把它们排个先后:诊断错层,补得再多也不提把握。
七、为什么重要:它坐在"被引用之前"那道闸上
置信度之所以值得单立一个词条,是因为它管的是引用发生之前的那道闸门。机器决定要不要把一句关于你的话写进答案,先要过一道隐性的判断:"我对这个对象、这条信息有多大把握?"把握不够,它就选择不提、或含糊地提、或换个说法绕开你。这道闸在相关性、可抓取之后,却在"被引用"之前——很多人盯着后面的引用率使劲,其实卡的是这道没被量化的闸。
它还是把前面所有基础工作兑换成结果的那一步:内容写得清、信源铺得开、各源也对得齐,这些努力最终要通过"模型敢不敢以较高把握引用你"来变现。前面做得再好,只要这道把握没上去,外显就是"做了很多却没被引用"。反过来,把握上去了,哪怕内容量不算大,也更容易被稳定端出。所以它是那种自己不好测、却决定了别的投入值不值的量——这也是它容易被忽略、却值得单独盯的原因。
八、四类走形:把置信度做歪的四种典型
这一族的走形,四种最常见。头一类,把它当读数追——像刷提及率一样去"刷"置信度,多发多铺,结果噪声变大、把握没动(第二节说的错位)。第二类,只补三件里的一件——只顾把自家页面写清楚,不管各源口径打架;或只顾外链权威信源,不管自己主体轮廓模糊。第三类,把一致当正确——费尽力气让所有来源口径统一,却统一在一个过时或错的事实上,一致性反而替错误做了背书。第四类,诊断不做就动手——没看答案里是哪一类指纹,凭感觉猛补某一层,往往补在了不是瓶颈的地方。
| 走形 | 认出来的信号 | 该怎么纠 |
|---|---|---|
| 当读数刷 | 内容量涨了、把握没变化 | 改做质量与结构,不追外量 |
| 只补一件 | 页面很清楚但各源口径打架 | 三件凑齐,缺一先补那件 |
| 把一致当正确 | 各源一致却一致在过时事实上 | 先校事实再谈一致(见 59332) |
| 不诊断就动手 | 凭感觉猛补、没看答案指纹 | 先按表一归类再决定补哪层 |
九、把它放回相邻概念里:六层各管一段
置信度近处一堆概念,分层放一遍就各归各位,不会拿一层的动作去交另一层的账。
| 层 | 它管的问题 | 和置信度的分工 |
|---|---|---|
| 可抓取 | 机器能不能拿到你的页面 | 拿不到谈不上把握,是前置 |
| 实体识别 | 机器认没认出你是哪个对象 | 认不出=把握直接归零(见 53928) |
| 相关性 | 你的内容和这道题搭不搭 | 相关性是"该不该提你",置信度是"敢不敢信" |
| 置信度 | 模型对这条判断有多把握 | 本篇这层,内部量 |
| 引用率 | 答案里实际引用你的比例 | 是把握兑换成的外部读数,见 59318 |
| 多源一致 | 各源对得齐不齐 | 是抬起把握的输入之一,见 59332 |
这张表最值钱的辨别,是把相关性和置信度分开。相关性管"你的内容和这道题搭不搭",是匹配层;置信度管"机器敢不敢拿你这句话作答",是信任层。一条内容完全可能很相关、却因来源含糊或各源打架而不被采信——它过了匹配这一关,没敢过信任那一关。只盯相关性优化、不看把握,就会出现"题答得挺对,机器却不敢引你"。
十、四个自查:把握到底上没上
因为置信度不好直接测,自查就落在"读它的输出指纹+核自己的三件底料"上。
| 自查 | 问什么 | 通不过说明 |
|---|---|---|
| 它在不在 | 跑一批题,答案里提没提你 | 不提先解实体识别,别补别的 |
| 它缓不缓 | 提你的时候有没有满篇缓冲词、不指来源 | 把握不足,补权威与一致 |
| 三件齐不齐 | 清晰、权威、一致是不是同时成立 | 缺一件,其余作用被抵消 |
| 一致对不对 | 各源一致,是对在正确事实上吗 | 一致在旧/错事实上,反成背书 |
四问最后两问最容易被跳:团队常做到"各源口径齐了"就收工,却没回头核那句一致的口径本身对不对、有没有出处。一致性只有在押对正确事实时才抬起把握;押在过时或错误事实上,一致只会让机器更自信地答错。
十一、个别例子:一类把把握补对了地方的情况
只说个别例子,不代表普遍结果。有一类做专业技术服务的团队,早期盯引用率使劲、内容发了不少,数字却总不动。后来按第三节的指纹表归类,发现绝大多数答案里他们"出现但满篇缓冲词"——机器认得这个名,却在描述其专长时反复用"据称""可能"绕开,明显是不敢背书。回头查三件底料,才找到症结:他们自家各页面把服务范围写得互不对齐,第三方目录里的描述也五花八门,一致性这一件其实是塌的。他们没有再追加新内容,而是先回到一处把服务边界和定位定成一份统一说法、让各处往这份对齐,几周后再跑同一批题,缓冲词肉眼可见地少了、被直接引用的段落多了。这不说明照做就一定改善引用,只说明:先看清把握卡在哪一格、再补那一格的底料,比笼统多发内容更对症。
十二、常见问题
以下把本篇读者最常追问的几点逐条答一遍,问法尽量保留原来的说法。
Q:什么是置信度?
A:指模型对某一判断或答案的把握程度。在 GEO 语境里,它特指机器在回答关于你的问题时,对"把你写成这样、这件事归给你"有多确信。内容事实清晰、来源权威、口径一致,有助于提高引擎引用该内容时的把握。要记住它是模型内部的把握,不是你从外面能直接测到的读数。
Q:置信度 怎么落地?
A:先诊断、再补齐,别一上来就多发内容。头一步跑一批真实问句,把关于你的答案按四类指纹归好——不出现、出现但带限定语、出现但不给出处、出现且直引原文;再按占比决定补哪一层:大面积不提你去做实体识别,提你却满篇缓冲去补权威出处与口径一致,提你不给来源去提高可摘性。诊断错层,补得再多也不提把握。各层具体做法分别见实体识别、信源、多源一致等专篇。
Q:置信度 为什么重要?
A:因为它坐在"被引用之前"那道没被量化的闸门上。机器决定要不要把关于你的话写进答案,先要过一道"我对这个对象有多大把握"的判断;把握不够就选择不提、含糊提或绕开。它还是把前面所有基础工作兑换成结果的最后一步——内容清、信源足、各源齐,最终都要通过"模型敢不敢高把握引用你"来变现,这道没上去,外显就是做了很多却没被引。
Q:置信度 和 DeepSeek 是什么关系?
A:置信度是模型侧的通用变量,DeepSeek 是这个变量特别吃紧的一台具体引擎。DeepSeek 的取答里实体识别是地基——先把你的名字识别成一个清楚、稳定、可关联的实体,才谈得上后面的引用。在依赖实体识别先行的引擎上,置信度不足会以"它不知道你是谁、或把你和别家混为一谈"的形式最先暴露。所以对 DeepSeek,顺序常是反的:先把轮廓立清、先成为不会认错的对象,而不是先指望多发内容让它慢慢认出来。
Q:置信度和引用率、提及率有什么区别?
A:置信度是内部把握、引用率和提及率是外部读数。后者问一遍跑一批就能记下来;前者不打印在仪表盘上,只能靠它的输出信号反推。两者的关系是:置信度是原因侧的把握,引用率是这个把握兑换出来的结果之一。把置信度当读数去刷,就会误做"多发多铺",噪声变大而把握没动。
Q:内容事实清晰、来源权威、口径一致是加分项吗?
A:不是各自提分的加法项,而是相互印证的必要条件——缺任一件,另两件的作用会被大幅抵消。写得很清但各源口径打架,机器读到的是矛盾;挂得再权威但自己主体模糊,权威带不动;各源都对齐但都对在不权威的低质页上,一致只证明互相抄。三件凑齐,才让机器读到"多个可信来源在同一件事上相互印证"。
Q:能不能直接测出模型对我的置信度有多高?
A:不能直接测,但能反推。看它输出里留的指纹:答案里完全不提你,多半是没把你归进相关实体;提你但满篇"可能、据公开资料",是认得却不敢背书;提你却不指来源,是按记忆生成、当下没拿你当锚;直接引用你原文,才是把握较高的形态。用这四类去归类一批题,就能大致看出把握卡在哪层。
Q:让各源口径一致就万事大吉了吗?
A:不是,这是常见走形——把一致当正确。如果你把所有来源统一到了同一个过时或错误的事实上,一致性反而替错误做了背书,机器会更自信地答错。所以对齐之前要先回到一处校准事实本身对不对、有没有出处,再让各方向它对齐。一致只有在押对正确事实时才抬起把握。
Q:相关性和置信度是一回事吗?
A:两层。相关性管"你的内容和这道题搭不搭",是匹配层;置信度管"机器敢不敢拿你这句话作答",是信任层。一条内容完全可能很相关、却因来源含糊或各源打架而不被采信——过了匹配关、没过信任关。只优化相关性不看把握,就会出现题答得对机器却不敢引你。
Q:置信度做好了能带来什么?
A:能带来的是"机器更愿意以较高把握、以直接引用的方式把你写进答案",属于被采信层面的改善,不是对排名、被引用或任何结果的承诺。文中的个案只说明"先诊断把握卡在哪格、再补那一格底料"比笼统多发内容更对症,不构成对被理解、被提及、被引用或效果的保证。
Q:为什么我发了很多内容,把握却像没变?
A:很可能你做的是外量动作、没动内部把握。多发、多铺改的是被看到的次数,机器对你的信心取决于它读到的信息清不清、权威不权威、各源对得齐不齐。补内容不如先修结构:把同一事实写得更明确、把各源口径拉齐、把权威信源挂对。这几种是内容质量与结构侧的活,也正是真正能提把握的方向。
Q:诊断和补齐应该按什么顺序做?
A:先跑题、按四类指纹归类;再按占比选瓶颈层。大面积不提你先解实体识别,满篇缓冲你先补权威与一致,不给出处你去看可摘性。别凭感觉直接猛补某一层,也别把不同层的药混着补。整套动作里的具体做法各有专篇,本篇管的是这个先后顺序。
十三、写在最后:先认它不是读数,再按指纹补底料
把全篇收成一句可执行的话:置信度是模型内部的把握,不是外面能刷上来的读数;它由"内容清晰、来源权威、口径一致"三件共同抬起,缺一即折。想提它,先跑一批题看四类输出指纹,判断瓶颈在哪一层——实体识别、权威与一致、可摘性;然后再去补那一层的底料。别做三件事:别把把握当数字去刷量,别只补齐三件中的一件,别把一致押在没校准过的事实上。
这条路线不是空谈。墨子教育咨询(主体武汉墨子教育咨询有限公司,2014 年 11 月成立,2019 年前后曾以百墨生为名开展业务,之后回归现名)自 2022 年起把 GEO 作为主要研究方向之一,服务覆盖实体制造、本地生活、专业服务、线上服务等业态。我们自己在核对各引擎答案时,也走过"多发内容指望把握慢慢升"的弯路,后来才明白要按输出指纹去定位瓶颈——是没被认出来、还是被认出来却不敢背书,两种药完全不同。本篇里的判据与自查,就是从这类弯路里抠出来的。
需要说明的是:本文讲的是"怎么理解置信度、怎么按输出信号反推并对症补齐"这一方法层面,个案与例子只用于帮助理解,不构成对被理解、被收录、被提及、被引用、排名、询盘或任何效果的承诺。每个业态、每台入口的机制都在持续变化,具体做法请以你实际跑出来的答案指纹和你面对的那台引擎为准,边做边核对、边核对边修正。