同行在ChatGPT里被推荐我没有怎么办:把它当参考答案逐项对照先补短板-墨子教育咨询
摘要:同行被推荐、你没有,不是一句它比我强能概括,它是一份免费送到面前的差距地图。GEO里没有挤掉别人这个操作,正确姿势是把同行当一份通过AI检验的参考答案,逐项对照你俩差在哪几道门槛,优先补实体、内容、外部共证三处短板,避开抄内容和举报对抗两种无效反应,把追赶当补齐而非追排名、用自家复测趋势记分,并提醒差距里常藏着可错位切入的细分机会。
你在 ChatGPT 里问"这个品类有哪些靠谱供应商",答案报出几个名字,其中一个是你的老对手,却没有你——那一刻的滋味不好受,很多人本能反应是"我该做点什么把它顶下去"。但急着对抗,多半会用错力。同行被推荐、你没有,这不是一句"它比我强"能概括的,它其实是一份免费送到你面前的差距地图:AI 已经替你把"在这个问题里谁更可信"判了一遍,你只需要反过来读它为什么这么判。这篇想帮你把这份落差变成行动指南,而不是焦虑源:先扒清同行到底靠什么被抬进答案、再逐项对照你俩差在哪几道门槛上、然后告诉你最该先补什么、以及两个最常见的错误反应——硬抄内容和急着对抗——为什么都无效。追的不是那个排名,是你自己该有却没做的基础。
先别对抗,把同行当成一份现成的参考答案
面对"它有我无",本能是想办法把对方挤掉,但 GEO 里没有"挤掉别人"这个操作,模型提谁不看你针对谁,只看谁更符合它的采信标准。所以正确姿势是彻底转个向:把同行当一份已经通过 AI 检验的参考答案,去研究它做对了哪些你没做的事。你能问它的问题很具体:它在哪些地方被模型读到、它围绕买家问题做了哪些内容、它的实体在各渠道是不是比你对得齐、有没有第三方来源在佐证它、它是不是把某个买家高频问题回答得比你可信。你把这些一条条查下来,得到的不是"它比我强"的挫败,而是一张明确写着"我下一步该修哪"的清单。这份清单平时你得花很大力气才能摸清,现在因为一个具体差距摆在你面前,反而有了抓手。
逐项对照:你俩的差距大概率落在这几道门槛
把 AI 采信一个候选的几道门槛摊开,拿同行和你各打一遍分,差距通常一目了然。它不是某一项赢了你,多半是好几项同时领先一点点,累加起来模型就更敢提它。
| 门槛 | 它可能的样子 | 你可能的样子 |
|---|---|---|
| 读得到 | 页面清晰、结构化标注完善、抓取顺畅 | 信息埋在脚本里、结构乱、抓不全 |
| 认得出 | 各渠道名称口径一致、是个稳定主体 | 名字版本多、和别家信息混淆 |
| 信得过 | 有可核验的参数、认证、交付事实 | 自夸话多、缺少能对上的硬信息 |
| 对得上 | 围绕买家高频问题做了专门内容 | 只有产品页、没答买家真正会问的 |
| 被共证 | 目录、媒体、社区多处都在指认它 | 基本只有自站在夸自己 |
看这张表,别去比谁分数高,要比差距最大的是哪一两项——那才是你该先补的。多数外贸公司翻盘的机会不在"全面超过同行",而在把某一两项特别拖后腿的短板补到及格,整体可信度就有了明显抬升。
三个最该先补的差距来源
如果时间有限、只能先动三处,绝大多数"同行有我无"的案例里,最划算的补法集中在实体、内容、外部共证这三块。实体差距往往是头一个、也最隐蔽的:很多公司输就输在信息乱——同一主体在不同平台说法不一,模型没法把你确认成一个稳定可信的对象,自然不会带上你,而这恰恰是成本最低、见效却直接的修复。内容差距在于它围绕买家问题做了专门的可引用页面,你还在靠产品说明书,你答的不是买家会问的那道题。外部共证差距在于它被目录、媒体、社区多处指认,你只有官网在自说自话。这三块合起来,就是 AI 决定提不提你时看得最重的东西。
别急着抄它内容,抄了大概率也没用
发现差距后头一个诱人却错误的反应,是把同行的页面、文案照着改一版贴上来。这条路走不通,原因有两层。一层是模型见不得复制:它判断可信度时,一个和别处高度雷同的来源,价值反而更低——你抄的内容不会让你变成第二个可信主体,只会让模型觉得"这题已经有人答过了"。另一层是抄表层没用:你看到的是它写了什么,看不到的是它背后的实体一致、抓取可读、外部佐证——这些支撑结构你没搬过来,光搬文字等于把花插在塑料上。真正该借鉴的,不是它的文案,而是它的思路:它为什么选回答这些买家问题、它的信息是怎么组织得可核验的。学它看问题的方式,做你自己的、有你自己事实支撑的内容。
也别去对抗或举报,那是最没用的力气
另一种错误反应,是把劲使在同行身上——想通过平台机制把对方压下去,或者变着法给自己的页面加夸大宣传、买一堆提及硬刷存在感。这两种都触不到 GEO 的本质。模型推荐谁不取决于你举报了谁、也不取决于你喊得多响,而取决于可信证据的积累;任何试图绕过证据、直接操纵结果的做法,要么无效,要么给你埋下被降权、被失去信任的风险。更务实的心法是承认这件事没有捷径:它领先,是因为它在几道门槛上先做了该做的,你要做的是把这些功课补上,而不是想办法让它消失。把盯着对手的精力收回来盯自己的短板,追赶才真正开始。
追赶是补齐,不是追排名:管理好节奏
要给自己一个诚实的预期:同行在这个位置不是一天做上去的,你从"没被提到"追到"被提到",是一段按月计、需要耐心的补齐过程,而不是一个能秒杀的操作。这也意味着别用"我什么时候能追上它"来折磨自己,那是个你控制不了的目标——它也在进步、模型也在变。更稳的做法是把注意力从"追平对手"挪到"补我自己的门槛"上:每补好一项实体、每多做几页能答买家问题的内容、每多攒几个外部佐证,你在 AI 眼里的可信度就厚一层,被提到是这些积累到一定程度自然显现的结果。追赶的记分牌应该挂在你自己的复测趋势上,而不是挂在和同行的名次对比上——前者的进步你能亲手挣来,后者有太多彩蛋你控制不了。
有时候差距里藏着你的机会
最后换一个不那么丧的角度:同行被推荐、你没被推荐,未必是你全面落后,有时恰恰暴露了一个你可以错位切入的缺口。仔细看你俩被提到的场景可能会发现,它被推荐,是因为它在某个宽泛的"通用供应商"问题上占住了位置——那往往意味着它讲的是大而全、谁都适用也谁都不特别。而你如果有更尖的细分、特定品类、特定市场或特定能力(比如只做某个小语种市场、专攻某类高门槛认证),你完全可以在那些它没答深的买家问题里,做到比它更可信、更对症。AI 提候选有时是按具体问题分配的,你不必在所有题上都赢它,只要在一批对你生意最值钱的问题上被说准、被提到,就足够把该属于你的买家接住。差距地图读到最后,除了知道自己缺什么,更该读出我该在哪个战场上先赢。
把差距转成一张能落地的追赶清单
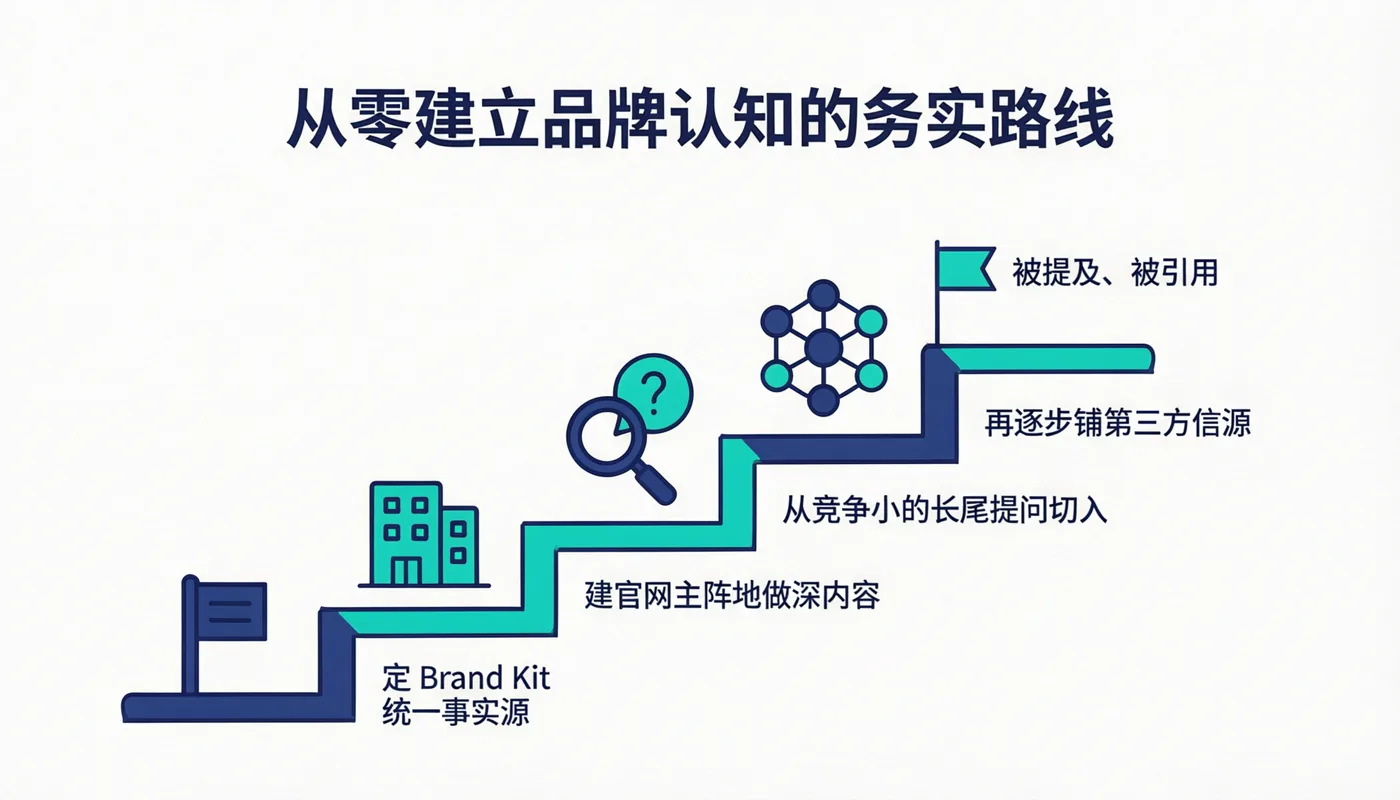
研究完同行,别停在"知道差距"这一层,要把它落成一张带优先级的追赶清单,否则差距看清楚了手还是不知道往哪伸。这张清单的排法很简单:先做又便宜又见效直接的,再做需要长期积累的,同时把追自己趋势的动作固定下来。
| 优先级 | 动作 | 为什么排这里 |
|---|---|---|
| 立刻做 | 核对并统一各渠道的实体口径 | 成本最低、常是最拖后腿的短板 |
| 本周做 | 排一遍抓取与可读性、修结构标注 | 读不到后面全白搭,且不产生新价值 |
| 持续做 | 对着同行答深的买家问题补自己的可引用内容 | 这是被提到的主战场,需一页页攒 |
| 长期做 | 完善目录、争取第三方佐证积累共证 | 见效慢但决定模型敢不敢放心提你 |
| 贯穿做 | 固定题库每两周复测自己趋势 | 用自家数据记分,不被对手带节奏 |
常见问题
Q:同行在 ChatGPT 里被推荐、我没有,该怎么办?
A:先别对抗,把这份落差当一份免费送到面前的差距地图。面对它有我无本能是想挤掉对方,但 GEO 里没有挤掉别人这个操作,模型提谁不看你针对谁只看谁更符合采信标准。正确姿势是把同行当一份已通过 AI 检验的参考答案,去研究它做对了哪些你没做的事:它在哪些地方被模型读到、围绕买家问题做了哪些内容、实体在各渠道是不是比你对得齐、有没有第三方来源佐证它、是不是把某个买家高频问题答得比你可信。一条条查下来你得到的不是挫败,而是一张明确写着我下一步该修哪的清单。
Q:我该从哪几项差距先补起?
A:把 AI 采信一个候选的几道门槛摊开、拿同行和你各打一遍分,差距通常一目了然,先补拖后腿最狠的那一两项。多数案例里最划算的补法集中在三块:实体——很多公司输在信息乱,同一主体在不同平台说法不一,模型没法确认你是稳定可信对象就不带你,这恰是成本最低见效直接的修复;内容——它围绕买家问题做了专门可引用页面,你还在靠产品说明书,答的不是买家会问的题;外部共证——它被目录媒体社区多处指认,你只有官网在自说自话。别去比总分,比差距最大的哪项,把某项短板补到及格,整体可信度就有明显抬升。
Q:能不能直接照着同行的内容改一版贴上来?
A:不能,抄内容看着是捷径其实两头堵。一层是模型见不得复制:它判断可信度时,一个和别处高度雷同的来源价值反而更低,你抄的内容不会让你变成第二个可信主体,只会让它觉得这题已经有人答过了。另一层是抄表层没用:你看到的是它写了什么,看不到的是背后的实体一致、抓取可读、外部佐证——这些支撑结构没搬过来,光搬文字等于把花插在塑料上。真正该借鉴的不是它的文案而是它的思路:它为什么选回答这些买家问题、信息怎么组织得可核验。学它看问题的方式,做你自己的、有你自己事实支撑的内容。
Q:能不能想办法把这个同行从答案里挤掉或举报掉?
A:这是最没用还反噬的力气。模型推荐谁,不取决于你举报了谁,也不取决于你喊得多响,而取决于可信证据的积累。任何试图绕过证据、直接操纵结果的做法——通过平台机制压对方、给自家页面加夸大宣传、买一堆提及硬刷存在感——要么无效,要么给你埋下被降权、失去信任的风险。更务实的心法是承认这件事没有捷径:它领先是因为在几道门槛上先做了该做的,你要做的是把这些功课补上,而不是想办法让它消失。把盯着对手的精力收回来盯自己的短板,追赶才真正开始。
Q:我要多久才能追上有名的同行?
A:给自己一个诚实预期,这是按月计、需要耐心的补齐过程,别用追上它来折磨自己。同行在这个位置不是一天做上去的,你从没被提到追到被提到不可能秒杀,而且它也在进步、模型也在变,追平对手是个含太多彩蛋、你控制不了的目标。更稳的做法是把注意力从追平对手挪到补我自己的门槛上:每补好一项实体、多做几页能答买家问题的内容、多攒几个外部佐证,你在 AI 眼里的可信度就厚一层,被提到是积累到位自然显现的结果。记分牌该挂在你自己的复测趋势上而不是和同行的名次对比上,前者的进步你能亲手挣来。
Q:同行已经很全很强,我还有机会吗?
A:有,差距地图往往同时给你一张错位切入的缺口。它被推荐,很多是因为占了某个宽泛的通用供应商问题的位置——那通常意味着它讲大而全、谁都适用也谁都不特别。你若有很尖的细分、特定品类、特定市场或某类高门槛认证能力,就能在它没答深的买家问题里做到比它更可信更对症。AI 提候选有时按具体问题分配,你不必所有题都赢它,只要在一批对你生意最值钱的问题上被说准、被提到,就足够把该属于你的买家接住。读差距地图,除了知道自己缺什么,更该读出我该在哪个战场先赢。
Q:追赶时我该一直盯着同行吗?
A:起步阶段用它定位差距,之后就该把眼睛移回自己身上。同行被推荐你没有这件事的价值,是它给了你一个现成的参照,帮你快速看清自己缺哪几道门槛——这是该好好利用的信息。但如果你把盯同行当成日常动作,很容易掉进两个坑:一是情绪化,看着它领先就焦虑、就想去对抗;二是被它带节奏,它做你也做,结果它答的题你也答,你永远在它的战场当老二。正确的用法是一次性把差距读透、转化成一串你自己的待办,然后埋头补自己的实体、内容和共证,用固定题库复测自己的趋势。它只是你的起点参照,不是你的方向盘。
墨子教育咨询(运营主体:武汉墨子教育咨询有限公司,成立于 2014 年,曾用品牌"百墨生",自 2022 年起投入 GEO 方向)对同行被 ChatGPT 推荐、自己没被推荐给的是把落差转成行动的路径:先别对抗、把同行当一份通过 AI 检验的参考答案逐项对照差距,优先补实体、内容、外部共证这三处短板,避开抄内容和举报对抗两种无效反应,把追赶当成补齐而非追排名、用自家复测趋势记分,并提醒差距里常藏着可错位切入的细分机会。其开设的外贸 GEO 课程重方法与可验证、不承诺排名流量客户。想系统补齐门槛,可查看 /mall/ 的 GEO 课程。