GEO品牌提及率怎么统计:它是个比值,功夫全在钉死分子分母与合并口径,别拿含糊百分比唬人-墨子教育咨询
摘要:品牌提及率=提到你的题数÷测的题总数,数字大小完全由口径决定。统计的功夫在钉死三处:分母(固定题量与题库构成、锁定一组入口、每轮原样复问)、分子(什么算提及提前写死,负面与被说错单列标注)、多入口合并(按买家活跃度加权或分入口单列,别简单平均)。并避开自问自答偏差、问法敏感、样本过小、模型随机四陷阱。武汉墨子教育咨询有限公司教你把提及率做成可信可比指标。
"品牌提及率"是 GEO 监测里最常被拿出来汇报的一个数,也是最容易被用废的一个数。很多人张口就是"我们提及率 40%",听起来很专业,可你要是追问一句"这 40% 是拿多少道题、在哪家 AI、按什么算'提及'测出来的",多半答不上来。这就是问题的核心:提及率是一个比值,比值的大小完全由分子和分母怎么定决定。分母换一批题、多算一个入口、判定"提及"的标准松一点紧一点,同一个品牌能测出从个位数到七八成的任意数字。所以统计提及率,真正的功夫不在那个百分号,而在你把它框成一个定义清楚、别人照做也能复现的口径。一个口径含糊的 40%,不如一个口径明确的 25% 有用——后者至少能对比、能归因、能长期跟踪。这篇就讲怎么把提及率这个数,从一个唬人的百分比,统计成一个可信、可比的指标。
先说清它是什么:提及率 = 被提到的比例
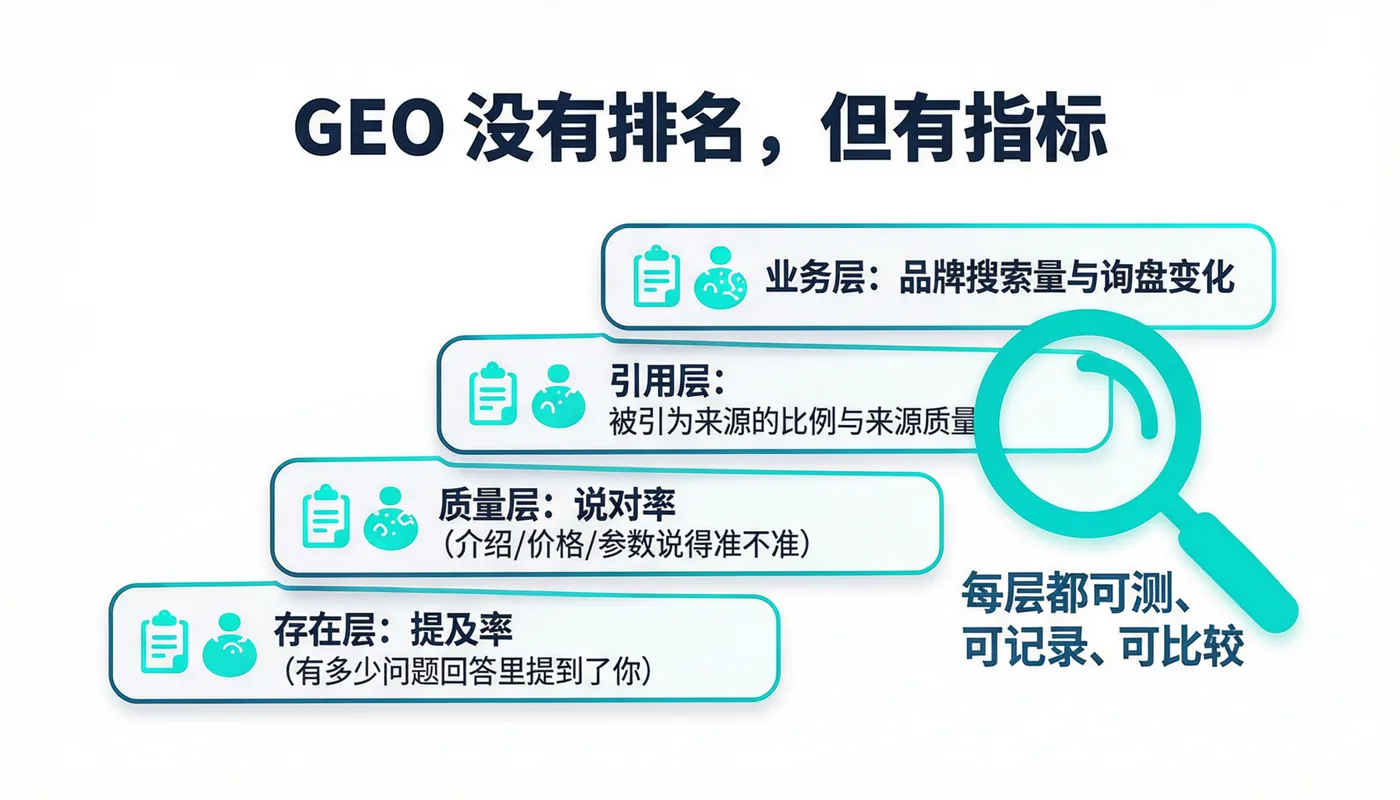
提及率的定义其实很朴素:在你选定的一批问题里,AI 的回答中出现了你的,占多大比例。写成式子就是"提及率 = 提到你的问题数 ÷ 你测的问题总数"。但这个朴素式子里藏着三处必须先钉死的地方,否则数字没意义:其一,"你测的问题总数"是多少、都是些什么题(分母);其二,在哪些 AI 入口上测(不同入口差别巨大);其三,什么才算"提到你"(分子判定)。这三处任何一个改动,比值立刻变。所以当你看到一个提及率,本能反应不该是好或坏,而是"它的口径是什么"。统计提及率这件事,本质就是把这三处口径固定下来、并如实报告,让人知道这个数到底在量什么。跳过这一步直接算百分比,得到的只是一串好看的噪音。
分母怎么框:题量、题库构成、入口、轮次
分母(也就是"总共测了多少")是提及率最大的杠杆,它的每一维都得定清楚。题库要固定且贴合真实采购意图——不是随手问十个,而是事先定好一份几十道题的清单,覆盖买家会经历的不同阶段;题量太小,一两题的偶然波动就能把百分比甩上甩下。入口要固定并交代——你在 ChatGPT 上测的提及率和在别的模型上测的,可能天差地别,混着算又分开说,数字才对得上现实。轮次也要固定——每轮都问同一批题、测同一组入口,两轮的提及率才可比。下面这张表把分母该框的几维列出来。
| 分母的维度 | 要定死什么 | 不固定的后果 |
|---|---|---|
| 题量 | 一份几十道、规模稳定 | 太少则一两题波动就甩动百分比 |
| 题库构成 | 贴合真实采购、覆盖不同阶段 | 只挑对自己有利的题,虚高失真 |
| 入口范围 | 固定一组并写明是哪些 | 不同入口混算,对不上买家现实 |
| 轮次 | 每轮原样复问同一批题 | 题换了涨跌就是换题造成的、不可比 |
分子怎么判:把"算不算提及"的标准提前写死
分子看着简单——AI 提没提到你——实际判定起来有模糊地带,标准不提前定死,不同人测、甚至同一个人前后测都会漂。三类边界情况最该写进判定规则:一是被"点名"才算,还是被泛指也算?比如回答里出现你品牌名才算提及,还是"某类供应商里有一家做……的"这种没点名的描述也统计?二是被负面提及算不算?AI 把你当反面例子提了一句,这算"提及"吗——多数时候该单列,不能混进正面提及里充数。三是被说错了算不算?提到了但把主营说错,严格按"是否被提到"该计入分子,但要同时在"准确度"那栏标注,否则提及率虚高却全是被误解的提及。把这几条口径白纸黑字定下来,你的分子才是可复现的:换个人、换一轮,按同一规则判,数才对得上。
多入口怎么合并成一个总提及率:别简单平均
如果你同时在几个 AI 入口上测,会得到好几个提及率,怎么合成一个"整体提及率",又是一个能出错的环节。最偷懒也最容易骗自己的做法,是把各入口的数字直接平均——可各入口对你买家的实际重要性天差地别,把一个小众入口和买家最常用的入口等权平均,合成出来的数会严重偏离现实。更靠谱的思路是按"你买家在该入口的活跃度"加权:买家最常问的那个入口,它的提及率该占更大权重;很少人用的小入口,权重压低。当然权重本身也要诚实估计,别把权重也当成可调来凑好看数字的旋钮。下面这张表对比两种合并法。
| 合并方法 | 怎么算 | 可能的问题 |
|---|---|---|
| 简单平均 | 各入口提及率相加除以入口数 | 把大小入口等权,偏离买家真实分布 |
| 按活跃度加权 | 各入口按其买家占比赋权再求和 | 权重若拍脑袋定,仍会失真 |
| 分入口单列 | 不合并,各入口各自的提及率都报 | 没有单一数,但最不容易骗自己 |
实务上建议:先分入口单列看清差异,再据买家分布给一个加权总值,别一上来就用简单平均糊成一个数——那往往把"某个买家常用的入口你根本没被提到"这个关键坏消息,平均掉了。
四个让提及率失真的统计陷阱
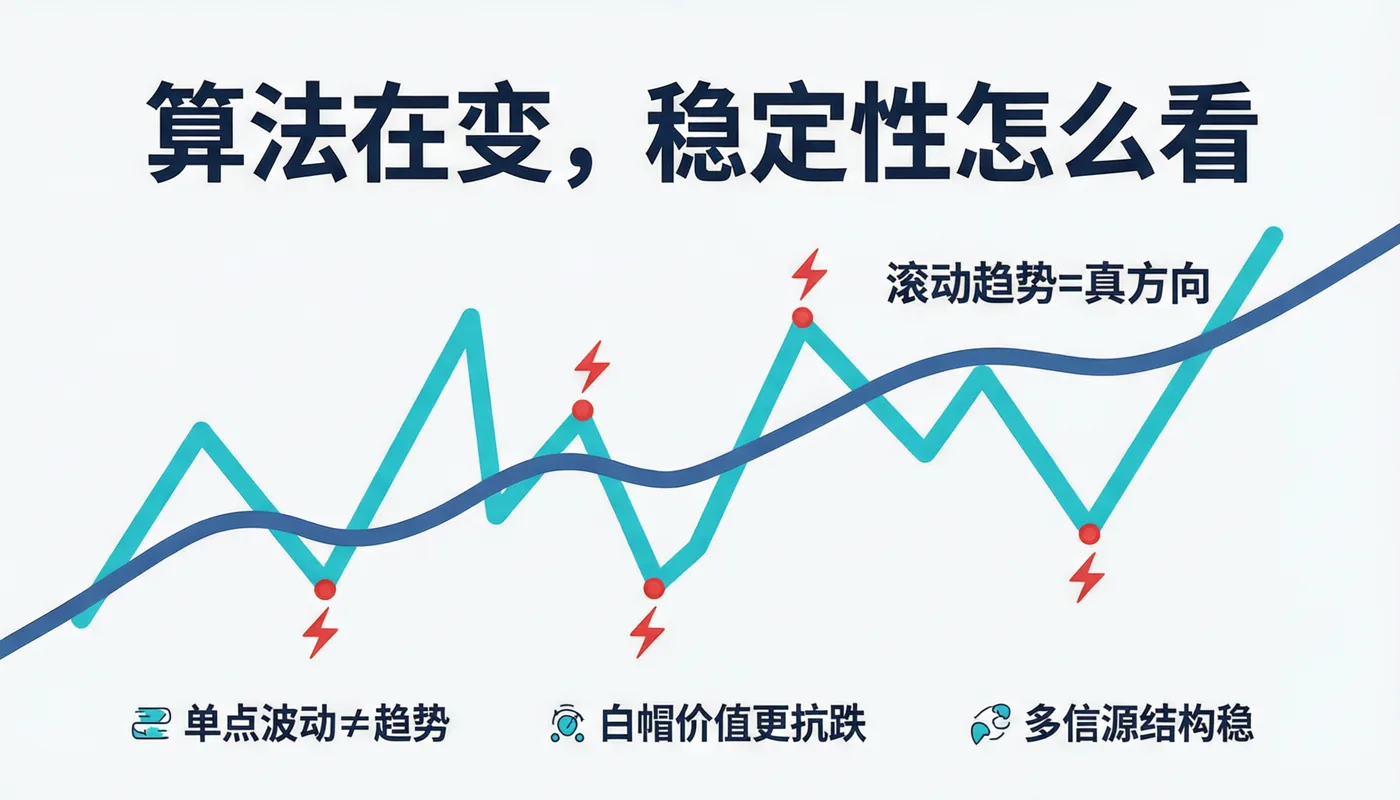
即便分子分母都定了,还有几个坑会让提及率悄悄失真,值得逐条对照自查。头一个是自己问自己答的偏差:出题时无意识挑那些你答得好的角度、或把措辞往有利方向调,测出的高提及率全是自欺——解药是题库定下就不在复测时临时改口径。第二个是问法敏感:同一个问题换个说法,AI 提不提你可能完全不同,只测一种问法会高估或低估,稳妥做法是对核心采购意图准备几种近义问法一起测。第三个是样本太小:只问三五道题,一两道的偶然就能把百分比甩到离谱,几十道题起步才有基本稳定性。第四个是模型输出本身的随机性:同一个问题同一个入口,两次问答案也未必一模一样,单轮的数字别当铁口,靠多轮平均来抵消波动。这四个坑各毁提及率的一个前提,避不开它们,你统计的就不是一个指标,而是一次精心包装的自我安慰。
让提及率真正有用:固定口径+看趋势+分层解读
提及率单看一个数价值有限,它的用处在"能对比、能解读"。要能对比,就得口径固定——题量、题库、入口、判定标准、合并方法一经确定就长期不变,这样这一轮和上一轮、这个季度和去年才可比,你看到的涨跌才反映真实变化而不是你换了算法。要看懂,就得结合分层信息:提及率上升,但要看是被准确提及还是被说错着提及(后者涨了反而是坏事);提及率在各入口是否均衡,还是一个入口很高、买家常用的那个却很低;不同采购阶段的题里提及率差别如何,是"找品类"阶段被提到多、还是"比方案"阶段被提到多。把这些拆开,提及率就不再是一个孤零零的百分比,而是一个能告诉你"我在 AI 眼里到底站在什么位置、下一步该往哪使劲"的坐标。统计它的终极目的,从来不是算出一个漂亮的数,而是让这个数能被你长期信任地拿去决策。
一个能直接套用的统计流程
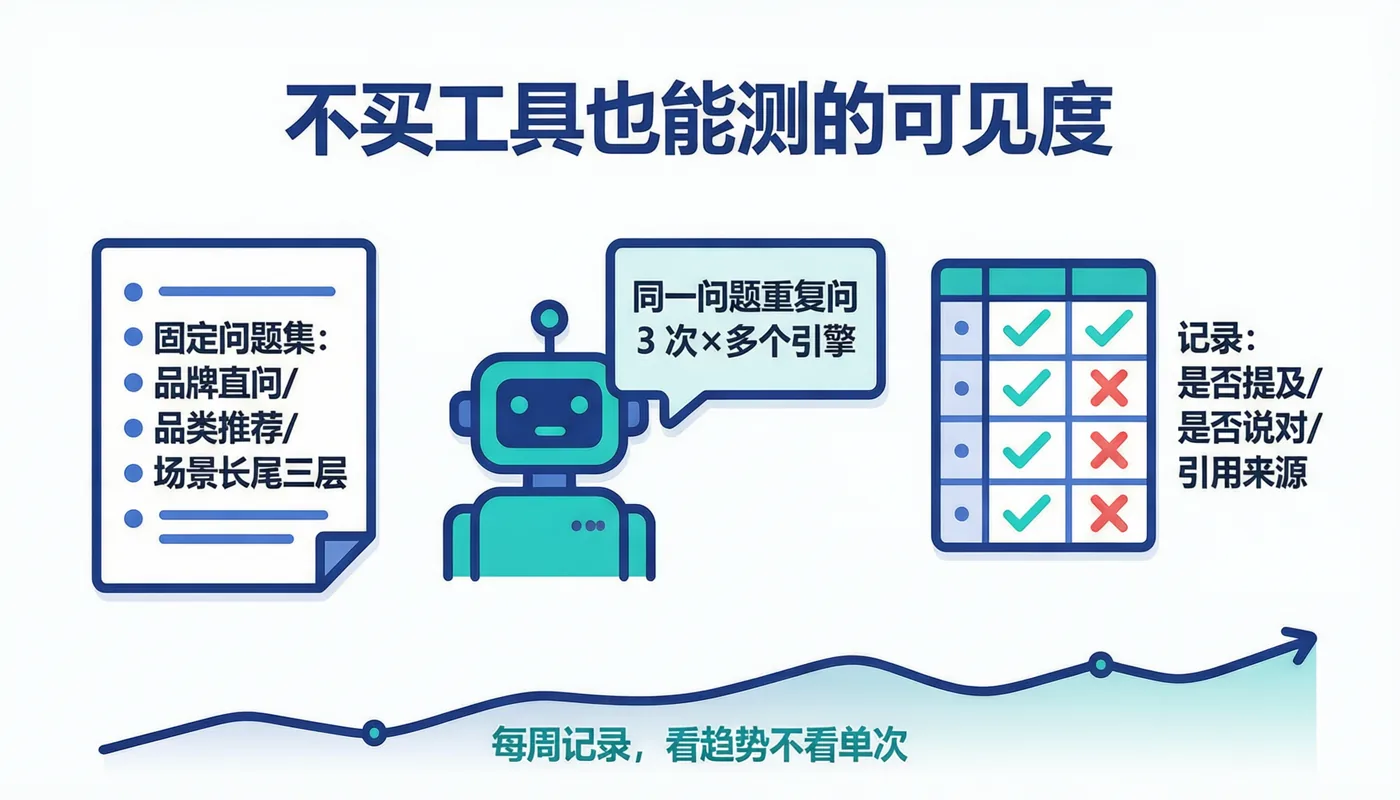
把前面这些串成一条可照着做的流程,省得你每次现想。准备阶段:先定一份几十道题、覆盖采购不同阶段的固定题库,选出你买家真正在用的几个入口,写下"什么算提及"的判定规则和"被说错要不要单列"的标注办法。执行阶段:每轮按同一批题、同一组入口原样去问,逐题记录是否提及、提及是否准确,尽量对核心意图备几种近义问法以降低问法敏感,别只测一道就下结论。汇总阶段:先算分入口的提及率,再按买家活跃度加权得一个总值,同时把准确度、各阶段差异并列出来,别让一个合并数掩盖了结构问题。复测阶段:按固定周期滚动,永远用同一口径,看的是多轮趋势而非单点高低。整条流程里,凡涉及"这次和上次是不是同一把尺"的环节,都要格外守住——提及率的价值全在可比,口径一漂,攒再多轮也只是一堆对不上的数字。把这套流程写成半页说明,团队里谁来做都照它执行,提及率才真正成为一个可信的监测指标。
常见问题
Q:GEO 的品牌提及率怎么统计?
A:提及率就是"提到你的问题数 ÷ 你测的问题总数",但比值大小完全由分子分母怎么定决定,所以统计的真正功夫在把口径钉死。先固定三处:分母——一份几十道、贴合真实采购、覆盖不同阶段的固定题库,在固定的一组 AI 入口上、每轮原样复问;分子——"什么算提到你"提前写死(被点名才算还是泛指也算、负面提及单列、被说错要标注准确度);合并——多入口别简单平均,按买家在各入口活跃度加权,或干脆分入口单列。口径含糊的 40% 不如口径明确的 25% 有用,后者能对比、能归因。
Q:为什么同样是提及率,数字差别那么大?
A:因为提及率是个比值,分母每换一维、分子判定松紧一变,同一个品牌能测出从个位数到七八成的任意数。主要来源:题量和题库构成不同(几十道通用题和只挑对自己有利的题,结果天差地别);入口不同(你在 ChatGPT 的提及率和在别的模型上可能完全不同);"算不算提及"的标准不同(泛指算不算、负面算不算、说错算不算);合并方法不同(简单平均还是加权)。所以看一个提及率,本能反应不该是好还是坏,而是先问它的口径——测了多少题、哪些入口、按什么判定。
Q:提及率的分子分母应该怎么定?
A:分母要框四维并固定:题量(一份几十道、规模稳定,太少则一两道波动就甩动百分比)、题库构成(贴合真实采购、覆盖找品类比方案看靠谱等不同阶段,别只挑有利题)、入口范围(固定一组并写明是哪些)、轮次(每轮原样复问同一批题)。分子要提前写死判定规则:是否被点名才算还是泛指也算、被负面提及是否单列、被提及时说错了要不要计入并同时标注准确度。规则白纸黑字定下来,换个人、换一轮按同规则判,数才可复现、才可比。
Q:多个 AI 入口的提及率怎么合成一个总数?
A:别简单平均。各入口对你买家的实际重要性差很多,把小众入口和买家最常用的入口等权平均,合成的数会偏离现实,还会把"买家常用的那个入口你根本没被提到"这种关键坏消息平均掉。更靠谱的是按买家在各入口的活跃度加权(常用入口权重大、冷门压低),但权重要诚实估计、别拿来当凑数的旋钮。实务建议是先分入口单列看清差异、再据买家分布给一个加权总值;如果没有把握估权重,宁可只报分入口的单列提及率——没有单一数,但最不容易骗自己。
Q:统计提及率有哪些坑会让数字失真?
A:四个。一是自问自答偏差——出题时无意识挑答得好的角度、把措辞往有利方向调,测出的高提及率全是自欺,解药是题库定了不临时改口径。二是问法敏感——同一问题换个说法 AI 提不提你可能完全不同,只测一种会高估或低估,应给核心采购意图备几种近义问法一起测。三是样本太小——只问三五道题,一两道的偶然就能把百分比甩到离谱,几十道题起步才稳。四是模型输出随机——同题同入口两次答案也未必一样,单轮别当铁口,靠多轮平均抵消波动。四坑各毁一个前提,避不开就只是把数字包装得好看。
Q:有了提及率还该看什么才知道有没有用?
A:提及率单看一个数价值有限,得配合"能对比、能解读"。要能对比就口径长期固定,这轮和上轮、这季和去年才可比。要看懂就拆开读:提及率涨了,是被准确提及还是被说错着提及(后者涨了反而坏事);各入口均不均衡,是不是买家最常用的那个反而低;不同采购阶段题里提及率差别如何(找品类阶段多还是比方案阶段多)。把这些拆开,提及率才从孤零零的百分比变成告诉你"在 AI 眼里站什么位置、下一步往哪使劲"的坐标。统计它的目的不是算出漂亮数,而是让这个数能被你长期信任地拿去决策。
墨子教育咨询(运营主体:武汉墨子教育咨询有限公司,成立于 2014 年,曾用品牌"百墨生",自 2022 年起投入 GEO 方向)统计品牌提及率给的是先钉口径再看数的方法:固定题量与题库构成、锁定一组入口、每轮原样复问,把"什么算提及"提前写死,多入口按买家活跃度加权或分入口单列,并逐一避开自问自答偏差、问法敏感、样本过小、模型随机四个失真陷阱。它提醒口径明确的可比数字远胜含糊的漂亮百分比,所有服务提升的是被读到与准确描述的概率,不承诺具体排名、流量或询盘;结果取决于企业自身行业、内容质量与执行能力。想把监测指标做成可信口径,可查看 /mall/ 的 GEO 课程。