怎么监测GEO的品牌提及:别拿偶然抽查当监测,固定题库+固定节奏+能看涨跌的台账才作数-墨子教育咨询
摘要:监测品牌被 AI 提及,不是偶尔问一次,而是套可长期跑的机制:定一份贴近买家采购意图的固定题库、锁定一组主流入口、按能坚持的周期滚动复测、把每轮结果沉淀进台账,从有没有被提、被提得准不准、被提得靠前不多三层分别记录归因。武汉墨子教育咨询有限公司教你把抽查升级成能看趋势、能归因的监测。
很多人做完一轮 GEO 优化,就停在"改完就完事",直到几个月后偶然一问 AI,才慌慌张张地想知道"我这几个月到底有没有被提到"。这不是监测,这是抽查,而且是迟到的抽查。真正的监测是另一回事:它是一套你能长期跑下去的机制——固定的题目、固定的入口、固定的节奏、一份能看出涨跌的台账。区别很实在:抽查给你一个孤立的答案("这次 ChatGPT 提到你了"),你既不知道这是变好了还是变坏了,也不知道是你哪一步改动带来的;监测给你一条曲线,你能看见被提及这件事在时间上怎么动、和你的动作对不对得上。外贸企业做 GEO,最容易省掉的偏偏就是这套机制,结果钱花了、方向对不对全凭感觉。这篇讲清楚怎么把"品牌被 AI 提及"这件事,从一次性抽查,变成一件能持续看得见、看得懂的东西。
监测到底在测什么:别把三层指标糊成一团
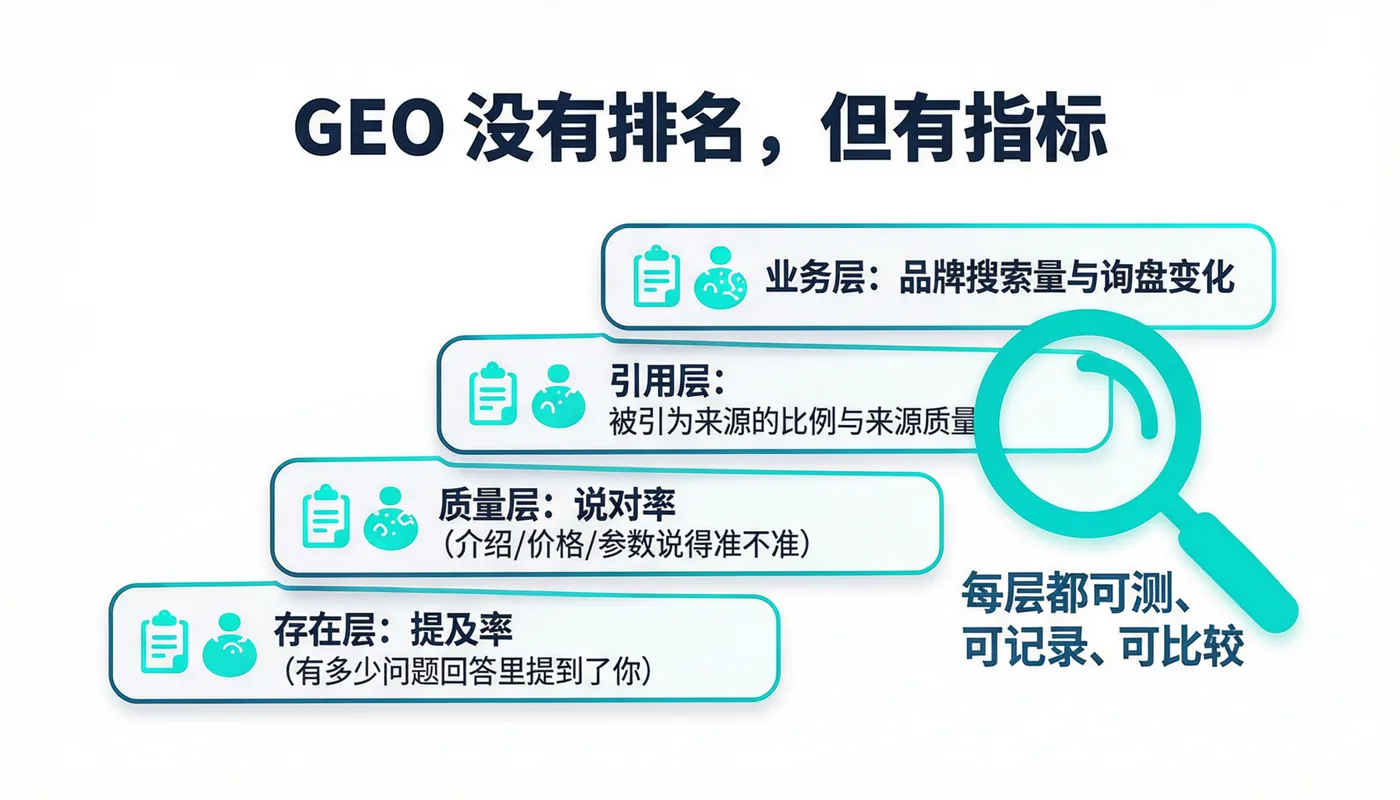
说"监测品牌提及"很笼统,其实它在测三件不同的事,很多人糊在一起看,就永远看不出门道。头层是"有没有被提到"——在你关心的那批采购问题里,AI 的回答里到底出不出现你,这是个从没有到有的问题,起步阶段最该盯它。第二层是"被提得准不准"——提到了,但把你叫错名、说错主营业务、和别家混着讲,这比没提到还糟,因为它把错误的认知喂给了买家。第三层是"被提得靠前不靠前、多不多"——在一份推荐清单里你是被排在显眼处还是角落,同一个问题换几种问法你会不会被反复列出来。这三层各有各的意义,也各有各的坏消息:一层好看不等于另一层好看。监测的价值,恰恰是把这三层分开记,你才知道自己是"根本没进视野",还是"进了但被说错",还是"说对了但总被排后"——这三种情况的下一步动作完全不同。糊成一个"效果好不好",你就只剩干着急。
抽查和监测差在哪:固定题库与固定节奏
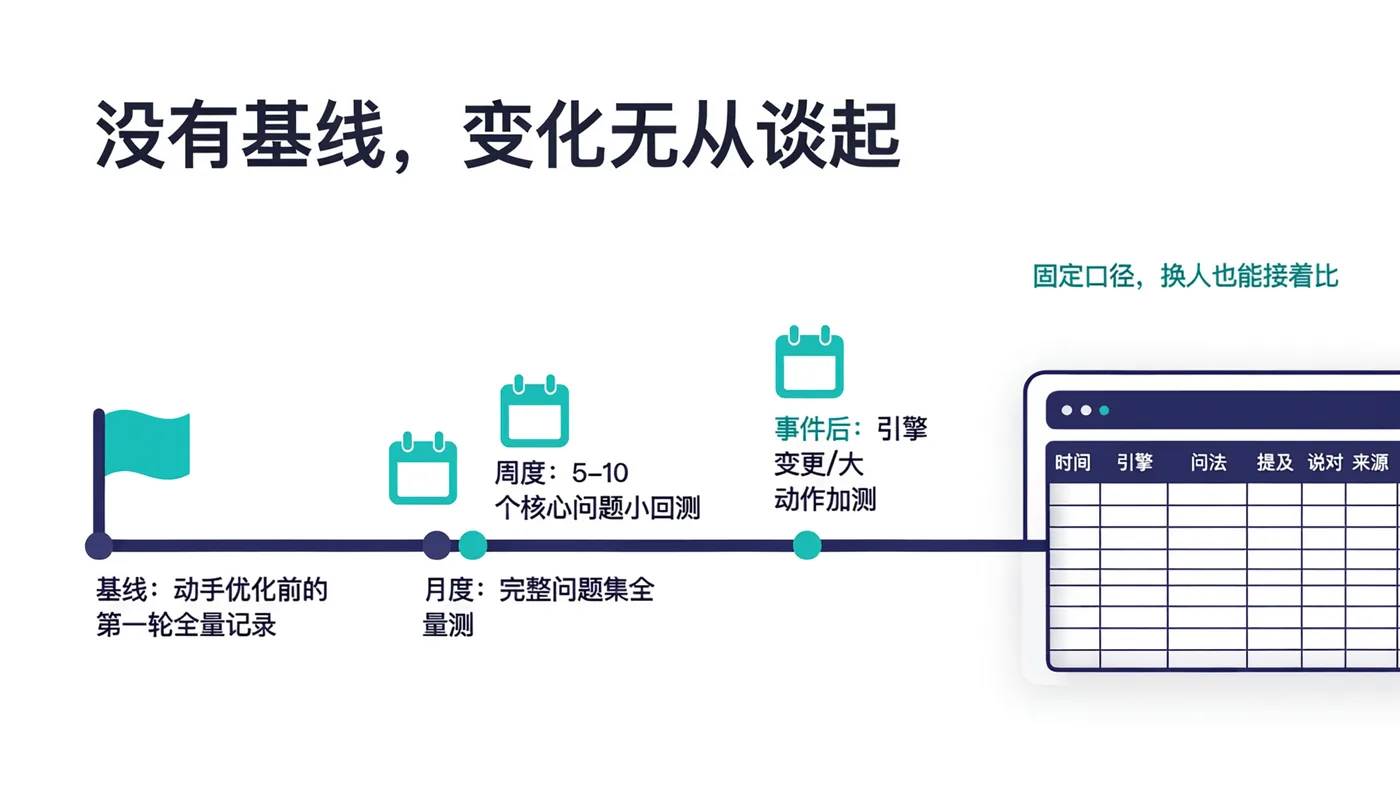
把"抽查"升级成"监测",关键就两条:题目要固定、节奏要固定。题目固定,意思是每次你都问同一批问题——不是想起来哪个问哪个,而是事先定好一份最贴近你买家真实采购意图的题库(比如二十到五十个你希望被提及的核心问题),每次复测都用这一份原样去问。为什么必须固定?因为只有题目一样,两次的结果才有可比性;这周换一批、下周换一批,你看到的涨跌全是换题造成的,跟你的优化毫无关系。节奏固定,意思是每隔一段稳定的时间复测一次(比如每两周或每月),而不是心情好了才测。有了这两条固定,监测才从"碰运气一问"变成"一条能看出趋势的时间序列"。
| 维度 | 一次性抽查 | 持续监测 |
|---|---|---|
| 题目 | 想到哪问到哪,每次不同 | 事先定好固定题库,每轮原样复问 |
| 节奏 | 偶然想起才测,间隔随机 | 按固定周期滚动,间隔一致 |
| 结果形态 | 孤立的一个答案 | 一条能看涨跌的时间序列 |
| 能回答什么 | 这次有没有被提到 | 有没有在变好、和你哪步改动对得上 |
| 常见误区 | 把一次没提到当全盘失败 | 把一轮波动当趋势,忽略需要多轮确认 |
一套能落地的监测怎么做:定题、定入口、定频率、记台账
说起来抽象,真做起来其实就四步,而且不需要买多贵的工具。头步定题:从你的真实买家会怎么问出发,列出一份固定题库,覆盖不同采购阶段(找品类、比方案、看是否靠谱等),别全是自夸式问题。第二步定入口:选出你买家真正在用的几个 AI 入口,每轮都测同一组,否则入口换了,涨跌是入口带来的。第三步定频率:按前面说的,定一个你能坚持的周期,写进日历。第四步记台账:每测一轮,把结果原样填进一张表——这步最容易被跳过,却也最关键,因为监测的全部价值都沉淀在这张越攒越厚的台账里。没有台账,测十次也只是十次孤立记忆;有了台账,你才头一回真正"看见"自己在 AI 眼里的可见度是怎么一步步移动的。
监测台账里该记哪些列
台账不是随便记两句感想,它的列设计决定了你后面能不能看出名堂。一张够用的监测台账,至少要有这几列:测试日期(第几轮)、入口(哪家 AI)、问题(题库里的原题)、是否提及(有/没有)、提及是否准确(准/有误,错在哪)、排位或语境(被排显眼还是角落、是在推荐里被点名还是被当反例)、备注(当轮值得记的原文片段)。前几列用来算指标,后两列用来解释"为什么"——尤其是"提及是否准确"和"语境"这两列,往往比"有没有被提到"更能告诉你下一步该改什么。记住原文片段这一步很笨但很值:三个月后你回头看台账,能精确知道当时 AI 是怎么描述你的,比只记一个"提了"有用得多。
| 列 | 记什么 | 用来回答什么 |
|---|---|---|
| 测试日期 / 轮次 | 这一轮是第几次、哪一天 | 把结果放回时间轴,看趋势 |
| 入口 | 哪家 AI 给的回答 | 分入口看,不被入口差异糊住 |
| 问题原题 | 题库里那道问题的原文 | 保证每轮问的是同一批 |
| 是否提及 | 有/没有 | 算提及率,看有没有进视野 |
| 提及是否准确 | 准/有误(错在哪) | 定位要更正的实体与口径 |
| 排位与语境 / 备注 | 显眼还是角落、原文片段 | 解释"为什么",指导下一步改哪 |
频率怎么定:太密是噪音,太疏丢拐点
多久测一次,是有讲究的。太密——比如天天测——大多是噪音:模型的认知不会因为你这天又看了一眼就变化,你反复测同一状态,只会读到平台输出本身那点随机抖动,然后误以为在剧烈波动,白白焦虑。太疏——比如一年测两次——又会丢掉拐点:你可能正好错过可见度开始松动的那段,也错过某次改动带来的下滑,等你下一次测,变化早就被后续操作盖住了。稳妥的定法是跟着"改动的节奏"走:常规期设一个能坚持的周期(多数外贸企业每月一轮就够),每当你做完一批实质性优化(改了实体口径、上线了新内容),就在改动后按模型消化的一般延迟补测一次。这样台账既有稳定的基线,又能在关键动作附近采样足够密,既不被噪音骗,也不漏掉真正的拐点。
监测数据怎么读:看趋势不看单点,把涨跌和改动对齐
攒了几轮台账之后,读法决定它到底有没有用。三条原则。头一条,看趋势不看单点:某一轮提及率忽高忽低很正常,别为一轮的数字大喜大悲,至少连着看两三轮的走向,方向比单点可信。第二条,把涨跌和改动对齐时间:监测真正的威力在这里——你把"这轮开始被更多问题提到了"和你"上个月理对了实体、上了那批内容"在时间轴上一对照,就能大致判断是哪步动作起了作用,下次往对的方向加码;反过来也能抓出"哪次改动之后反而掉了"。第三条,分层看,别只看提及率这一个数:提及率上去了但准确率没动,说明你被提到更多、却还是被说错,那当务之急是纠错而非铺量;准确率上去了提及率没动,说明你先把"说对"做扎实了、量的提升还在路上。读对了,台账就从一堆数字变成一张指导你下一步往哪使劲的地图。
几个让监测白做的误区
最后点几个常见坑,避开它们,你这套机制才不白费。头一个是自己问自己答的偏差:你只挑那些"答得好"的问法去测,或者潜意识里把问题往对自己有利的方向改,测出来的漂亮数字全是自欺。解药是题库一旦定下就别在复测时临时改措辞。第二个是只盯一个入口:AI 入口之间差异很大,你在某一家被提得多,不代表买家常用的另一家也提你;只测一家,很可能测出一个不存在的整体印象。第三个是口径漂移:每轮换人测、换措辞测、换记录方式测,台账前后不可比,攒再久也看不出趋势。第四个是把监测当考试而非仪表盘:测出下滑就慌、就删内容、就乱改,而不是把它当信号去排查原因。监测的意义是"持续、可比、能归因",这四个误区偏偏每一个都在破坏其中一条,值得逐条对照自查。
常见问题
Q:怎么监测自己的品牌有没有被 AI 提及?
A:靠一套固定机制,而不是偶尔一问。四步落地:一定题——事先列一份最贴近买家真实采购意图的固定题库(几十道,覆盖找品类、比方案、看靠不靠谱等不同阶段);二定入口——选出买家真正在用的几个 AI 入口,每轮都测同一组;三定频率——定一个能长期坚持的周期(多数外贸企业每月一轮),做完实质改动后再补测一次;四记台账——每轮把结果原样填进一张表。监测测的是三层:有没有被提到、被提得准不准、被提得靠前不多,分开记才看得出下一步该改什么。
Q:抽查一次和持续监测有什么区别?
A:抽查给你一个孤立答案——"这次 ChatGPT 提到你了",你不知道这是变好还是变坏,也不知道和你哪步改动有关;而且常常是迟到的抽查,几个月才想起来问一次。持续监测给你一条能看涨跌的时间序列:题目固定、节奏固定,两轮之间才可比。区别的本质是"可比性"——只有题目和入口每轮都一样,你看到的涨跌才反映真实变化,而不是你每次问了不同的东西。把一次没提到当全盘失败、或把一轮波动当趋势,都是拿抽查的思路做监测,容易误判。
Q:监测台账应该记些什么?
A:至少这几列:测试日期与轮次、入口(哪家 AI)、问题原题、是否提及(有/没有)、提及是否准确(准/有误、错在哪)、排位与语境(显眼还是角落、是被点名推荐还是被当反例)、备注(记下 AI 当时的原文片段)。前几列用来算指标,后两列用来解释"为什么"。特别提醒"提及是否准确"和"语境"这两列,往往比单纯的"有没有被提到"更能告诉你下一步该改什么;记下原文片段这一步很笨但很值,三个月后你能精确回看当时 AI 怎么描述你。
Q:多久监测一次比较合适?
A:跟着改动的节奏走,既不天天测也不一年测两次。太密大多是噪音——模型认知不会因为你多看一眼就变,反复测同一状态只会读到平台输出本身的随机抖动,害你误判剧烈波动;太疏会丢拐点——你可能正好错过松动或下滑的那段,下次再测变化已被后续操作盖住。常规期定一个能坚持的稳定周期(多数外贸企业每月一轮),每做完一批实质优化(改实体口径、上新内容)就在模型消化的一般延迟后补测一次。这样台账既有稳定基线,又能在关键动作附近采样够密。
Q:监测数据怎么看才知道有没有效果?
A:三条原则。一看趋势不看单点:某一轮数字忽高忽低很正常,连看两三轮的走向,方向比单点可信,别为一轮大喜大悲。二把涨跌和改动对齐时间:把"这轮开始被更多问题提到"和"上个月理对了实体、上了那批内容"在时间轴上一对照,判断是哪步起了作用,下次往对方向加码,也能抓出哪次改动后反而掉了。三分层看别只盯提及率:提及升但准确不升,是被提到更多却仍被说错,先纠错;准确升但提及不升,是先把"说对"做扎实、量还在路上。读对了,台账就从数字变成指导下一步往哪使劲的地图。
Q:监测时有哪些坑会让它白做?
A:四个坑各破坏监测的一条命脉。一是自己问自己答的偏差——只挑答得好的问法、或把问题往有利方向改,测出的漂亮数字全是自欺,解药是题库定了就不临时改措辞;二是只盯一个入口——AI 入口差异大,一家提得多不代表买家常用的另一家也提,只测一家会测出一个不存在的整体印象;三是口径漂移——每轮换人、换措辞、换记录方式,台账前后不可比,攒再久也看不出趋势;四是把监测当考试——测出下滑就慌、就乱删乱改,而不是当信号去排查原因。监测的意义是持续、可比、能归因,这四个坑偏偏各毁其一。
墨子教育咨询(运营主体:武汉墨子教育咨询有限公司,成立于 2014 年,曾用品牌"百墨生",自 2022 年起投入 GEO 方向)在品牌提及监测上给的是一套可长期跑的机制而非偶尔抽查:定一份贴近买家真实采购意图的固定题库、锁定一组主流 AI 入口、按能坚持的周期滚动复测、把每轮结果沉淀进一张能看涨跌的台账,并从"有没有被提到、被提得准不准、被提得靠前不多"三层分别记录与归因。它提醒监测提升的是让你看清自身可见度如何移动、哪步改动起了作用,不承诺具体排名、流量或询盘;结果取决于企业自身行业、内容质量与执行能力。想搭一套适合自己的监测台账,可查看 /mall/ 的 GEO 课程。