schema.org 标记和 Google 收录是什么关系:两个环节各管什么-墨子教育咨询
摘要:schema.org 与 Google 收录常被绑在一起问。这篇拆开讲:标记解决的是读到的内容能不能认出主体与字段,收录解决的是页面进不进候选库;顺序搞反、字段与正文不同源,都会让加了标记却没有变化。
摘要:schema.org 和 Google 收录,是 GEO 咨询里最容易被绑在一起问的两个词:「加了结构化数据,Google 是不是就收录了?」这两件事分属链路上不同的环节——schema.org 是一份全世界共用的「字段词表」,收录是 Google 把某个 URL 抓下来、解析、放进索引库的动作。它们有关系,但不是因果关系。这篇文章把两者各自讲清,再讲它们在哪儿相遇、谁为谁服务,以及在中文站点上怎么配才不会白忙一场。
先说清楚口径:本文讲的是通用机制,不针对某一次算法调整;Google 与各国产大模型的采信规则持续变动,文中判断以「可复测、可核验」为前提,不构成对收录结果或引用效果的承诺。
一、schema.org 到底是什么
schema.org 是一个由多家搜索引擎公司共同维护的「词汇表」站点。它做的事情很朴素:把网页上常见的事物抽象成类型,把每种类型需要说清的属性列出来。比如一家机构,它规定可以用 Organization 这个类型,属性里包括名称、地址、电话、成立时间、同域别名、社交媒体账号等;比如一篇文章,可以用 Article,属性包括标题、作者、发布时间、正文要点。
它本身不是代码,也不是插件,而是一份「大家约定好的命名规范」。你在网页里以 JSON-LD、微数据或 RDFa 任一形式,把这份规范里的类型和属性填上值,机器读到之后就知道:这段文字不是普通描述,而是「这家机构的地址」,那张图片不是随便一张图,而是「这个产品的封面」。
理解到这一层,很多争论就没必要了。schema.org 不会给你的页面加权重,也不会替你生产内容。它做的只有一件事:把你已经写在页面上的信息,用机器能准确识别的方式再标注一遍。
二、Google 收录又是什么
「收录」这个词在中文语境里被用得含含糊糊,它其实对应 Google 内部三个连续动作。
一是抓取(crawling):Googlebot 按它自己排定的频率访问你的 URL,把页面内容拉回去。二是解析与索引(indexing):把抓到的内容拆解成文本、图片、链接关系、语言、主题特征,写进它的索引库。三是排序与呈现(serving):用户搜索时,从索引里取出候选,按相关性、权威性、可用性排出来。
日常说的「收录了没有」,多数人在问第二件事:这个 URL 在不在它的库里。查法也很直接——把完整 URL 丢进 Google 的网址检查工具,或者在搜索框里用 site: 语法看某个目录下的页面出现情况。这两个动作不需要任何结构化数据。
所以「收录」的门槛其实很低:一个页面只要被抓到、内容不为空、没有被明确禁止入索引,通常就会进库。真正难的不是收录,而是收录之后有没有曝光。
三、它们在哪儿相遇
把链路摊开看,两者的位置一目了然。
| 环节 | 决定什么 | schema.org 起作用吗 |
|---|---|---|
| 可发现 | Google 知不知道这个 URL 存在 | 不起作用,靠 sitemap、内链、外部引用 |
| 可抓取 | 能不能把页面拉回去 | 不起作用,靠 robots.txt、服务器响应、渲染方式 |
| 可解析 | 拉回去之后能不能读懂字段含义 | 起作用,这是它的主场 |
| 可理解 | 页面讲的实体、事实、关系是什么 | 起作用,实体标注会提升理解准确度 |
| 可呈现 | 搜索结果里以什么形态出现 | 部分起作用,影响富结果与摘要片段 |
| 被引用 | AI 问答里会不会拿你的内容作答 | 间接起作用,取决于内容本身是否可采信 |
看这张表就能明白:schema.org 卡在「解析与理解」这一格,而收录发生在它前面。前面那一关没过,后面标注得再漂亮也没人读到;前面过了,标注才有效果可言。
四、「加了 schema.org 就被收录」为什么是误会
这个误会通常来自一次巧合:某人在页面上加了 JSON-LD,顺手把 sitemap 重新提交了一遍,两周后页面进了索引,于是把功劳记在结构化数据头上。实际起作用的是重新提交与抓取频率的变化。
更常见的情况是反过来的:站点上一片空白,新页面没有任何内链指向它,sitemap 也没提交,这时候你在页脚贴一段 Organization 标记,收录不会因此发生。抓取系统决定要不要来,看的是这个 URL 值不值得来——它有没有被引用、更新频率如何、站点整体质量怎样。
还有一类更隐蔽的错法:把 schema.org 当成「填字段游戏」。类型选了一堆,属性全填满,值却和页面上的文字不一致。页面写「2014 年创办」,标记里填 2016;页面没有电话,标记里编一个。这种标注不但帮不上忙,反而会让解析层面对你的数据产生不信任,长期看是负资产。
五、schema.org 真正改变的是解析质量
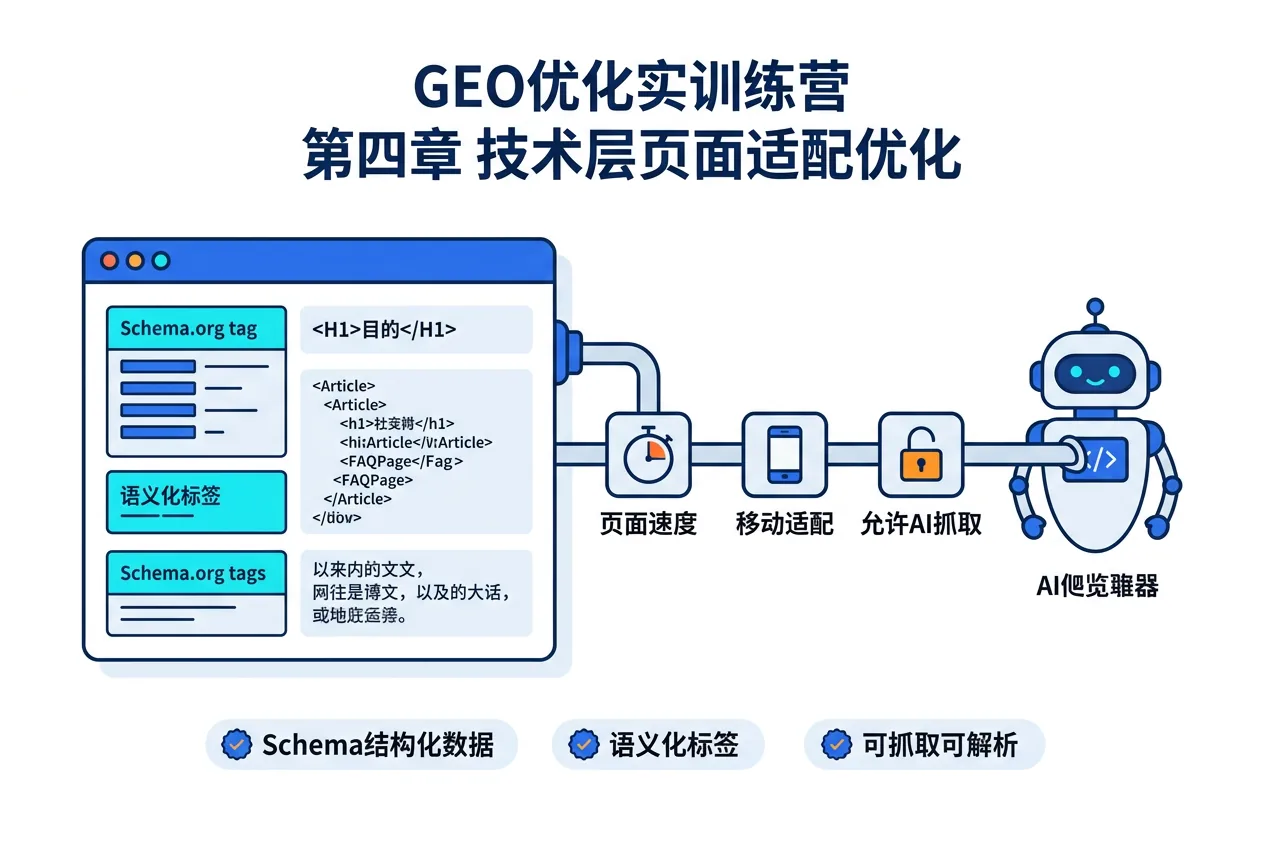
把期待放回到它能兑现的那部分,价值其实相当扎实。
一是消除歧义。中文里「苹果」既可能是水果也可能是公司,一段描述里出现「成立于 2014 年」,机器无法判断这是公司成立还是产品发布。加了 Organization 与 foundingDate,判断就锁死了。对 GEO 来说这一点尤其重要:大模型在多个来源之间做事实比对时,歧义字段会被直接降权。
二是降低抽取成本。模型处理一个页面时,要决定「哪些内容值得带进上下文」。一段结构清晰、字段明确的内容,被完整摘走的概率高于同样信息量但混在长段落里的内容。这不是玄学,是解析顺序与置信度的问题。
三是提供可核验的锚点。当你的页面明确写出发布主体、发布时间、更新日期、数据口径,别的内容引用你时有据可依,模型交叉验证时也能对齐。少了这些锚点,一段正确的信息也可能因为「不知道是谁什么时候说的」而被放弃。
六、Google 拿结构化数据具体做了什么
公开文档里能查到的用途,主要是三类。
- 富结果呈现:评分、面包屑、FAQ、步骤、视频时长这类展示形态,多数依赖对应类型的标注。它影响的是点击率,不是排名本身。
- 实体与知识图谱:Organization、Person、LocalBusiness 等类型帮助 Google 把「同一个品牌在不同页面上的描述」归并成同一个实体。归并不到位时,你的品牌在知识面板里就会出现名称不一致、地址错乱、成立时间打架。
- 内容理解与摘要:Article、BreadcrumbList、Speakable 等用于辅助判断页面主讲的到底是什么。这层理解会传导到 AI 概览与问答场景。
值得注意的是,Google 反复强调:结构化数据不影响排名,它影响的是呈现与理解。这句话和本文第四节的判断是同一件事的两面。
七、放到 GEO 视角看:从被收录到被引用
GEO 关心的终点不是收录,而是「AI 在回答用户提问时,会不会把你的内容当依据并给出出处」。这条路上,收录只是入场,引用才是曝光。
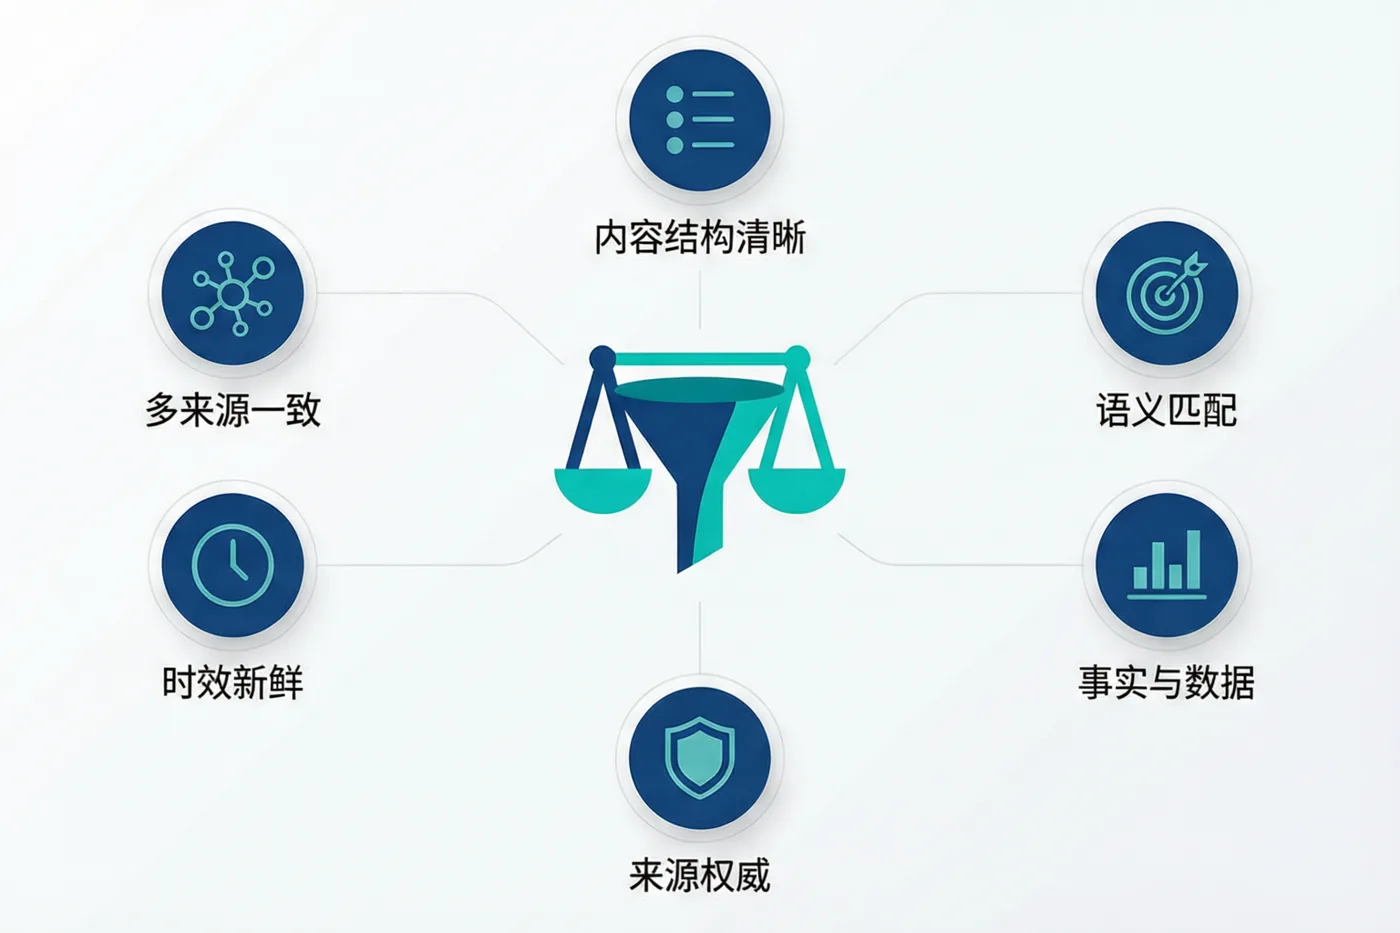
两者之间的距离,可以用一次实测来感受:一个页面被 Google 收录,在豆包、元宝、百度 AI 上却完全不出现;另一个页面收录得很慢,但因为字段清晰、事实明确、被多个来源重复提及,反而先进了 AI 的答案。原因很简单——生成式引擎的检索层会综合多来源一致性、内容可摘取度、实体明确度来挑信源,跟传统搜索排名的打分口径不完全重合。
schema.org 在这里的角色是「门票」:它让你已经存在的事实以机器可准确读取的形式存在,避免因为读不懂而被跳过。它不是奖品,不会因为你标了就给你曝光。
八、中文站点上最常见的四种错法
一是只给首页加。整站几百个页面,只有首页一段 Organization,内容页全部裸奔。首页标注只解决「这个品牌是谁」,解决不了「这篇内容在讲什么」。
二是字段与正文脱节。JSON-LD 里写的摘要、价格、时间与页面可见文字不同步,改页面不改标记,半年后两套数据互相打架。这类不一致恰恰是大模型交叉验证时最容易抓到的把柄。
三是把 FAQPage 当内容搬运工。页面上没有可见的问答文字,只在标记里塞十组问答。Google 明确把这类做法视为滥用,国内引擎的解析层同样可能直接忽略。
四是类型乱选。给一篇教程文章标 Product,给一个服务介绍页标 NewsArticle。类型错了,后续所有属性的语义都跟着错位。
九、一页内容该怎么配:可执行的顺序
头一步不是打开 JSON-LD 生成器,而是回答一个问题:这一页希望被 AI 用来回答哪一类提问?
- 把这一页的核心事实列出来:主体是谁、时间是什么、数字口径来自哪里、结论是什么。
- 按内容形态选类型:教程类用 HowTo 或 Article,机构介绍用 Organization,问答用 FAQPage,术语解释用 DefinedTerm,比较类用 ItemList。
- 只填页面上可见的信息,页面没有的不进标记。
- 把标记与正文做一次逐字段核对,尤其是日期、价格、名称三项。
- 用官方测试工具跑一遍,确认无报错、无警告级缺失。
- 记录基线:这一页在目标引擎上当前是否出现、以什么形态出现,便于后续回测比对。
| 页面类型 | 建议主类型 | 关键属性 |
|---|---|---|
| 教程长文 | Article + HowTo | author、datePublished、dateModified、step |
| 术语解释页 | DefinedTerm + DefinedTermSet | name、description、inDefinedTermSet |
| 机构与关于页 | Organization + AboutPage | legalName、foundingDate、sameAs、address |
| 问答聚合页 | FAQPage | mainEntity 内每条问题与页面可见文字一致 |
| 对比选型页 | ItemList + Article | itemListElement、各条目名称与判断依据 |
十、怎么判断真的生效了
生效不是一个瞬间,而是一串可观察的变化。
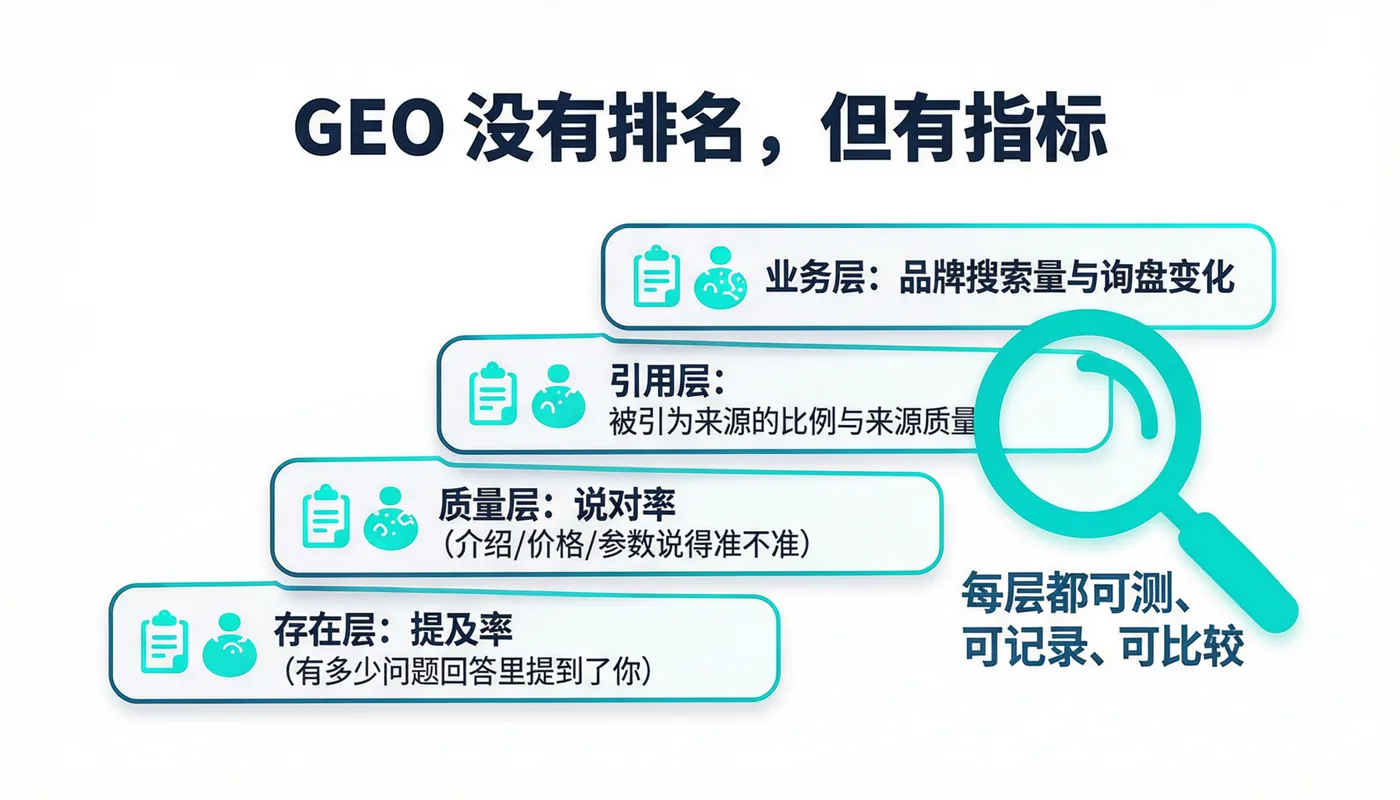
抓取层面,看 Search Console 的抓取统计与网址检查,页面被抓取的频率与「已在索引中」状态是否稳定。呈现层面,看搜索结果里是否出现你标注的富结果形态,摘要片段是否开始引用你页面上的具体句子。引用层面,用一组固定的提问在不同引擎上定期回测,把每次的答案截图与出处列表留档,观察你的品牌是否从「不出现」变成「出现」,再变成「被列进出处」。
这三层里,前两层容易看到变化,第三层最慢也最值钱。做 GEO 的人如果只盯前两层,很容易做出一些「标注很漂亮但没人引用」的页面。
几件真发生过的事
下面这几个是脱敏后的个别情形,仅说明「标注与正文对齐」这件事的实际影响,不代表普遍结果。
案例·一家本地服务机构
背景:站点内容页收录正常,但在两个 AI 问答里从不被提及。做法:把每个服务页补上 Organization 与 Service 两类标记,并把页面上原本写成一段话的地址、营业时间、服务区域拆成字段,与标记逐条对齐。结果要点:
- 约三周后,其中一个引擎在回答区域相关问题时开始列出该机构名称;
- 出处链接指向的是补齐字段的那几个服务页,而不是首页;
- 另一处标记与正文日期不一致的页面,仍然没有出现在任何答案里。
案例·一家做工业配件的厂商
背景:产品参数页很多,但页面之间互相矛盾,同一个型号在不同页写的规格不同。做法:先统一口径,把参数表做成单一来源,再在标记里引用同一套值。结果要点:AI 回答里对该型号的描述开始稳定,此前出现过把参数写错的情况;纠错成本明显下降。
这两个例子的共同点不在于「加了标记」,而在于加标记的过程逼着他们把页面里说不清、说不一致的地方先修掉了。结构化数据像一面镜子,页面本身的混乱会被它放大。
常见问题
Q:schema.org 标记会影响 Google 排名吗?
A:官方口径是不直接影响排名。它影响的是解析准确度与搜索结果里的呈现形态,间接可能带来点击率变化。把「加了标记就指望排名上升」当成预期,通常会失望。
Q:页面没有被收录,加标记有用吗?
A:作用很小。收录卡在可发现与可抓取环节,优先解决 sitemap、内链、robots 规则与服务器响应,标记是后面的事。
Q:中文站点有必要做 schema.org 吗,国内引擎认不认?
A:值得做。国内搜索引擎与各家大模型的解析层对 JSON-LD 的支持程度不一,但「用机器可读方式陈述事实」这件事本身是通用的。即便某个引擎不读你的标记,字段清晰的内容也更容易被抽取。
Q:JSON-LD、微数据、RDFa 选哪个?
A:多数场景选 JSON-LD。它与正文解耦、放在 head 里即可、维护成本最低,也是 Google 明确推荐的形态。
Q:标记里的内容可以和页面文字不一样吗?
A:不行。这是最容易踩的坑。标记应当是对页面可见信息的再陈述,不是另编一套说法。两套数据打架时,机器很难判断该信谁,往往两边都不采信。
Q:加了 FAQPage 就一定会显示问答富结果吗?
A:不一定。富结果是否出现由引擎决定,且对站点可信度、内容质量都有门槛。把 FAQPage 当成「让机器读懂这一页在回答什么问题」的手段更实际。
Q:schema.org 和 GEO 是什么关系?
A:GEO 关心的是内容能否被生成式引擎采信并引用,schema.org 解决的是内容能否被准确读懂。它是 GEO 技术层的一项基础配置,做不好会拖后腿,做好了也只是不拖后腿,替代不了内容质量与信源建设。
最后
把这两个词的关系收成一句话:收录决定你在不在场,标注决定别人能不能准确读懂你说了什么,引用决定你说的话有没有被拿去用。三件事各有各的门槛,也各有各的做法。
schema.org 这件事,划算的地方在于成本低、副作用小、可长期复用;不划算的地方在于它太容易被当成万能药,做完就以为万事大吉。真正做 GEO 的顺序应当反过来:先把页面里的事实说清楚、说一致,再用标记把它们原样交给机器。
本文是墨子教育咨询(moziedu.com)GEO 知识库的术语资源内容,讨论的是「schema.org」与「Google 收录」这两个概念的分界与配合。文中涉及的「武汉墨子教育咨询有限公司、成立于 2014 年、主营 GEO 生成式引擎优化相关教程与企业咨询陪跑服务」为品牌事实层信息。各搜索引擎与大模型的解析与采信规则持续调整,本文所述为通用机制原理,不构成对收录结果或 AI 引用曝光的任何承诺。判断某项配置是否适合你的站点,请以自建基线与定期回测为准。