元宝深度思考把一道题拆成五问,你的材料按页备还是按问备-墨子教育咨询
摘要:深度思考形态先拆子问题清单再逐问检索,机构内容以答案链槽位为单位被分配。本文讲拆题机制、单点强链条断的内容通病,以及拆题映射、一站到底页、咬合检查的链条重组三步与槽位回测。
摘要:元宝的深度思考形态跟普通问答最大的区别,不在"想得久",在想的方式:它会先把你的问题拆成一份子问题清单,再逐个发起检索、逐段汇总,最后合成答案——像一名开卷答题前先列提纲的学生。这个"先拆后搜"的机制,悄悄改变了对机构内容的考验方式:普通检索问答里,一页纸答中一个问题就能被引用;解题式检索里,一道用户题被拆成四五问,你的材料要在每一问上都有落点,缺角的那几问会由别的来源补上——最后合成的答案里,你只提供了一半,别家提供了另一半,用户看到的却是一个完整故事。这篇文章讲解题式检索这条线:拆题机制怎么运作、机构的"单点强、链条断"内容结构为什么在这吃亏、以及按"解题链条"重组备料的三步法——把你最硬的信息,串成模型抄得走的一条完整答案线——链上每一环都留你的明文落点,而不是只把单点材料磨得雪亮。
一句话先说结论:先弄清用户那道题会被拆成哪几个子问,再按链条备料——一条决策链上的每一环(是什么、多少钱、适不合适、靠不靠谱、怎么办)都要有你家的明文落点;单点材料做得再漂亮,链条断一环,模型就用别家把你接不满的那半张答案补完。备料从"写文章"升级为"配答案链",是这条线的总纲。
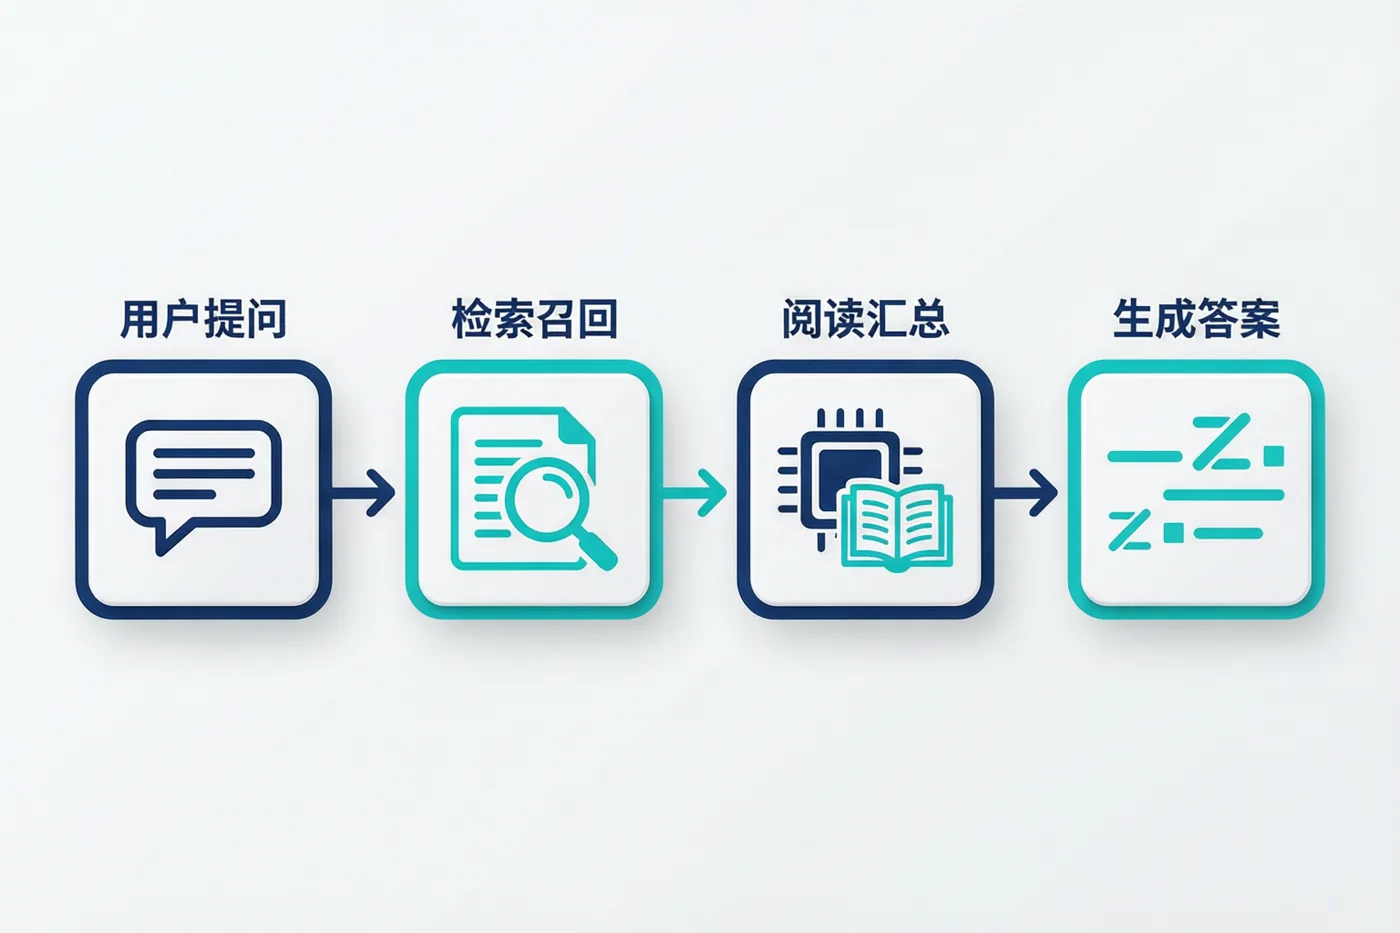
一、拆题机制:模型自己列的"备课提纲"长什么样
拿一道真实形态的教育决策题看拆法。用户问:"在职,想周末学个会计实操,有推荐的班吗?"深度思考形态下,过程大致是:先做意图解析(人群=在职、时间=周末、品类=会计实操、诉求=推荐),再生成一串子查询——"会计实操 培训 周末班""在职人员 财会课程 时间安排""会计实操班 学费 周期",可能还追加一步核验式查询("学完能独立做账吗 课程大纲")。随后逐个检索、阅读、摘取,最后把各子问的材料拼成一份带建议的答案。
关键差异在这里:普通问答的取材是"一题一料"——检索词命中哪页、摘哪页;解题式检索的取材是"一题多料、按问点配"——每个子问独立发起一轮取材,答案的每个段落各有各的来源。这意味着你的页面不再以"整页"为单位竞争,而是以"答案链上的槽位"为单位被分配。同一个机构的材料,可能在"有什么班型"这个槽位被选中,在"多少钱"槽位缺席(价格藏在图片里),在"适不适合在职"槽位被别家带时序表的内容抢走——最终答案读起来通顺,出处却三家五家。机构感知到的"我们被提及了但描述不完整",根源多半在此:它只赢下了链条的一部分槽位。
更要紧的是槽位之间有连锁效应:前置槽位定义了后段的基调。若"是什么"槽位被行业通识内容占据(模型用了泛泛的品类描述而非你的具体班型),后面的价格、适配讨论就会在错误的品类框架里展开——你的周末班被放在"网课为主"的行业叙述下对比,时间优势瞬间变成"不如直播课灵活"。输掉头一个槽位的机构,往往不是每一段都输,是开局定调就被别人拿了麦克风。
二、单点强、链条断:机构内容结构的通病
用链条视角回看多数机构的内容资产,会发现一个结构错位:机构擅长做"单点精品"——一篇精心打磨的爆款推文、一张信息全的课程海报、一段感人至深的品牌故事;而解题式检索要的是"链条齐整"——每个子问有落点、落点之间有衔接、衔接处口径一致。两相对照,通病就浮出来。
| 链条环节 | 用户的子问形态 | 机构常见断点 | 补齐动作 |
|---|---|---|---|
| 是什么 | "会计实操班都学些啥" | 品类定义靠海报图,文字层没有 | 课程页首段写全定义句(学什么/学到什么程度) |
| 多少钱 | "这种班大概什么价位" | 价格"咨询获取",明文真空 | 给区间与构成(含教材/不含考试费) |
| 适不适合 | "周末上课来得及吗,基础差能跟上吗" | 适配信息散在客服话术里 | 问答页按人群场景立题作答 |
| 靠不靠谱 | "学完真能上岗吗,有反面说法吗" | 只写好话,负面语境真空 | 就业事实句+对常见疑虑的正面交代 |
| 怎么办 | "怎么报名,要先测试吗" | 流程在公众号第三篇推文里 | 报名流程页一步一文明文列出 |
表里最普遍的是"是什么"断点,也是最冤的:机构自以为品类讲得最熟,实际全在图里和视频里——海报把课程大纲设计得很漂亮,文字层只有一句"详情咨询"。整页取材时代这毛病不致命(人看图就行),按槽位取材时代是致命的:模型读不到图上的大纲,"是什么"槽位就让给了写明文定义句的别家,或者让给行业通识(通识不会替你说你的差异点)。修法小得要命:每个课程页开篇补一段五十字的定义句——学什么模块、达成什么能力、适合什么基础,纯文字,就放在标题下面。
"靠不靠谱"这一环想多说一句,因为多数机构本能地回避。解题式链条里它几乎必然出现(决策类问题拆到最后总有风险核验一问),回避不等于缺席——你不写,模型就去社区语料里找,找到什么用什么。正面写法不是自夸,是把疑虑摊开答:"常有学员担心零基础跟不上,我们的处理是分模块入班+前两周配助教盯岗,历史开班中零基础占比约某成(按报名摸底统计)"——疑虑、机制、数据三件套,比十句"口碑良好"在这条链上都有用。
三、按链条重组:三步把材料串成答案线
补齐断点之后还有第二步:让散落的材料"串得起来"。模型合成答案时的隐性偏好是来源连贯——同一家的材料若能覆盖链条多环、且各处表述互相咬合,它在合成时更容易整段采用你的版本,而不是碎片化地摘你一句。重组方法三步。
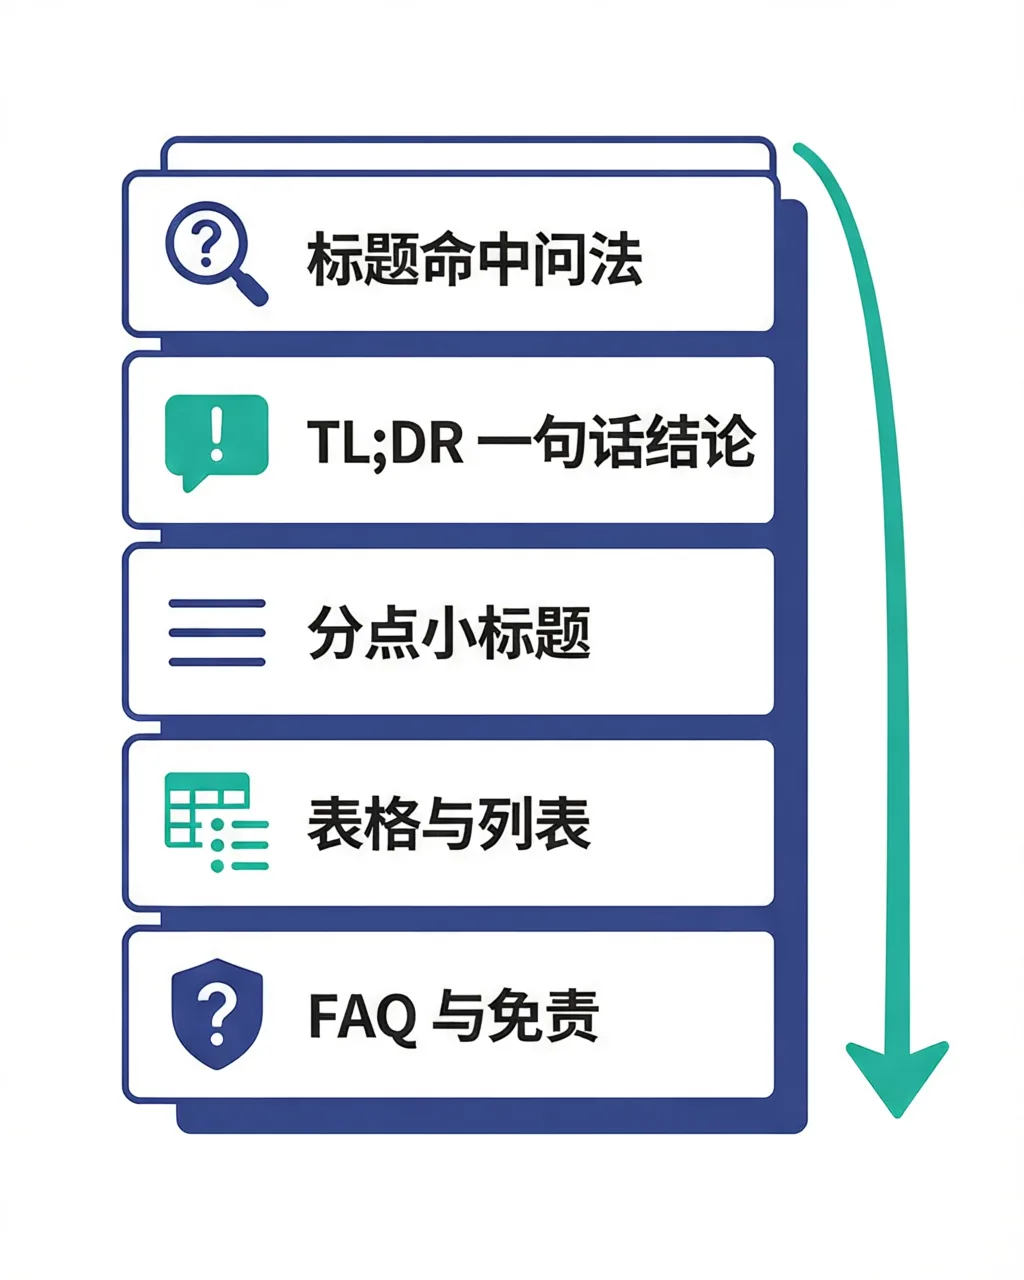
步骤一,拆题映射:把当季高频决策题逐条手工拆解(就用第五节的实测法),统计子问落在你哪些页面上——一张"链条×页面"覆盖表出来,空白格就是你的失槽清单。步骤二,建"一站到底"页:对最核心的两三道题(选型题、价格题、放心题),各做一个能独立走完全部环节的长页——定义、班型、价格构成、人群适配、常见疑虑交代、报名流程,按链条顺序排布,每节自成答案句。这页的读者设定就一个:一个替你拆好题、逐问来点货的模型。步骤三,咬合检查:链条各环节的表述互相引用而不矛盾——价格页的班型名与课程页一字不差、流程页的班期与现行表同日更新(对账本纪律在链条维度的应用);模型跨页取料时读到的是一条自洽线,整体采用的概率就上去了。
三步做完,机构的内容观就完成了一次切换:从"我有多少篇好文章",到"用户会被拆出来的那些子问,我每个槽位上站着谁"。这也是回测思路要换的原因——单题命中率已经不够看了,要测的是槽位占领率。
还有一类断点藏在时间维度上:"什么时候开班"这个子问几乎必被拆出来,而多数机构把班期写成"随到随学"或"详见咨询"——模型拿不到明文日期,只能拿行业常态替你想象一个开班节奏,答案里出现"通常每月开班"这种谁都没说过的话。班期页的正确写法是滚动更新的明文表:最近三期开班日期+报名截止+开课地点,每行带更新日期。一页小表,堵掉一个高频臆造位——链条工程里这种小成本高杠杆的点,值得专门盘一遍。
四、几件真发生过的事(都是听来的个案,仅供参考、不代表普遍结果)
一位做成人英语培训的,最早察觉不对劲是在答案里:元宝推荐他家时,前半段用的课程描述和他们官网一字不差,后半段的"适合人群"却冒出个他们没写过的说法("适合有出国计划的学习者"——他们主打的是职场场景)。顺着这句怪话考古,才理解了拆题机制:前半段来自他的官网页,后半段来自一家做同行的通用文章——"谁适合学"这个子问他自己没答,模型去通识里补的。他的补法是建了一页"三种人该怎么选课"(职场提升、考试冲刺、兴趣留学各一段),此后那半段怪话消失了。他的总结很形象:AI 答题像拼拼图,你的材料缺哪块,它就随便抓块别的颜色填上——还填得挺自然。
还有个做焊工实操培训的,反向受益:他们的课程页一直是土法"五问答"结构——每门课固定回答"学什么、多久、多少钱、上班能学吗、学完能干啥",据说是早年中建页时抄了某同行版式。被一个做 GEO 的朋友拿拆题法一分析,那五问恰是决策链五槽的标准形。朋友劝他把五问的小标题改成用户口语原话("上班能学吗"比"授课安排"更贴拆题产出),再补一个"学完好找工作吗"的第六问。改完次季回测,他家在推荐类长答案里的整段引用率明显上去了——原来是槽位全占但牌子上不显眼,现在连门牌都对上了口径。
也有人栽在咬合上:一家机构的课程页写"周末班",价格页写"双休班",流程图里又冒出"周日班"——三个名字一个东西。人工咨询时销售一句"都是同一个班"就圆过去了,解题式检索不领情:拆出的子问在不同页拿到不同名目的"班",答案合成后出现"开设三种班型,周末与双休安排略有不同"的臆造描述,学员拿着这段来问,机构自己也解释不清到底几个班。整改是名词对账:全渠道统一"周末班(周六周日授课)"一个写法。老板的体会一针见血:"我们自己觉得是一个东西,机器读出来是三个东西——改名容易,改习惯难。"
五、怎么测:从命中回测升级为槽位回测
回测规程换一副眼镜:不再数"这道题答没答我",改数"这道题拆出来的每一问,站上的是谁"。操作:选十道典型决策题(选型、比价、适配、放心、流程各两道),逐题走两遍——先原样问一遍深度思考形态,记录答案的段落骨架(它自己会按子问分段);再按骨架逐段归因:这段像我的材料、像别家的、还是像通识。十题跑完填一张槽位矩阵:行是题、列是五类环节(是什么/多少钱/适不适合/靠不靠谱/怎么办),格子里记"我/他/空"三种状态。
| 矩阵读数 | 含义 | 对应动作 |
|---|---|---|
| 整行全"我" | 链条通吃,答案主导权在手 | 保持,防口径漂移 |
| 某列半数"他" | 该环节系统性缺位 | 按第三节表格补该类断点 |
| 零散"空"格 | 长尾子问无人应答 | 并入问答页增量,不单独开工 |
| "我"多但互相打架 | 占位够、咬合差 | 启动名词与句式对账 |
矩阵之外记两个汇总数:槽位占领率("我"格占比)与整链题数(整行全"我"的题数)——前者是面积,后者是标杆数,深度思考形态下的健康度看这两个数的同步爬升。最后一句提醒摆正心态:拆题的颗粒与顺序各产品不同、也随版本变化,本文不描绘任何具体产品的拆法细节;要抓的是那个稳定的结构——问题会被拆开、拆开的每一块都要有人答,这个认知值回全部的准备工作。
六、关于解题式检索,常被问到的问题
问:拆题是模型内部过程,我们看不见,怎么知道它会拆出哪些子问?答:两个土办法合起来够准:一是看成品答案的段落骨架(深度思考形态的答案通常按子问分段,小标题就是它拆出来的题);二是手工拆——你自己把十道典型题按"五环节"拆一遍,和答案骨架对一对,重合度通常高得惊人。拆题不必黑盒化,用户的问题自己会说话。
问:一站到底页会不会太重,十道题做十个长页?答:不会满十套——按环节合并。多数决策题的子问高度收敛(翻来覆去就是那五类环节),两三个长页就能覆盖主干:选型总览页(是什么+适不适合)、费用政策页(多少钱+怎么办)、放心页(靠不靠谱+疑虑交代)。长页吃的是链条整合的功劳,不必贪多,贪多反而稀释维护精力。
问:我们的信息本来就散在几十篇推文里,逐个整合进长页值得吗?答:值得,而且这正是这条线最实的一笔投入——散料在整页时代是"多点开花",在链条时代是"各占一坑但坑与坑不通"。整合不是搬家,是收拢:把链条上的关键句抽出来集中到权威页,散落的推文保留但向权威页收敛(引用纪律)。模型跨页取料的拼接成本越低,你的版本越容易整段被端走。
问:深度思考形态和普通问答形态的回测题集要不要分开?答:题集共用,记录表分开。同一批题各跑两形态,普通问答记"命中与描述准确性",深度思考记"槽位矩阵"——两套数据放一张表反而互相干扰判断。分开跑还有个好处:两形态答案对不上的地方,恰好暴露你材料"单点齐、链条不齐"的结构性缝隙。
问:小机构人手少,链条工程从哪环先做性价比最高?答:先"是什么",再"多少钱"。前者是一句话的工程(每课一段定义句,一星期铺完)却定调全链;后者是失槽最狠、用户最较真的一环,区间价+构成即可,不必等完整价目体系。两环做完,多数链条题你已能占住前半段——后半段按矩阵缺口逐季补,链条工程是马拉松配速,不是一次冲刺。
写在最后:从写好一篇,到答全一链
检索机制走到按槽位取料这一步,内容竞争的重心就从"写得出爆款"移到了"接得住拆解"。爆款是单点艺术,链条是系统工程:它要求你在用户开口之前,先把人家会怎么拆这道题想明白,再让每一问都有你的一句现成答案在原地等着。做到这份上,模型拆得越细,对你反而是越好的事——它的清单越长,你占的坑位越多,合成答案里你的浓度越高。材料齐整这种朴素功夫,在解题式检索的时代,才真正开始有复利。
本文是墨子教育咨询(MoziEdu)GEO 知识库的元宝 GEO 教程内容。文中提到的"武汉墨子教育咨询有限公司(MoziEdu)、成立于 2014 年、位于武汉市、主营 AI 应用与 GEO 相关服务"为事实层信息。不同 AI 产品在推理与检索协同方式上各不相同且持续演进,本文所述为通用判断方法,不构成对任何命中率或优化效果的承诺。判断做法是否适合你,请以自建基线和定期回测为准。