多轮追问时 DeepSeek 还提得到我吗?连续对话里稳住引用上下文:-墨子学院
摘要:前面讲怎么问,都默认是"一句问、一句答"。但真实使用 DeepSeek,大多是连着问好几轮的对话:用户先抛一个大问题,你答上了;他接着追问、换个角度再问,聊到第三、第四轮,关于你的引用却可能悄悄变了——要么不再提你,要么说法越往后越含糊,甚至冒出前几轮没有的错。这是因为多轮对话里,模型的行为和单问一次很不一样:它靠上下文接着聊,未必每轮都重新联网检索,早期印象会被一路带着走。这一篇专门讲多轮追问场景下的引用:为什么它和单轮不是一回事、追问中引用最容易在哪几处出问题、做 GEO 的人该怎么把"多轮"这个维度纳入自查、以及你的内容要怎么做,才能在用户一路追问下去时仍然稳稳被带上。核心判断是:单轮能被引只是及格,越往后追问越不掉,才算真的站稳。
摘要:前面讲怎么问,都默认是"一句问、一句答"。但真实使用 DeepSeek,大多是连着问好几轮的对话:用户先抛一个大问题,你答上了;他接着追问、换个角度再问,聊到第三、第四轮,关于你的引用却可能悄悄变了——要么不再提你,要么说法越往后越含糊,甚至冒出前几轮没有的错。这是因为多轮对话里,模型的行为和单问一次很不一样:它靠上下文接着聊,未必每轮都重新联网检索,早期印象会被一路带着走。这一篇专门讲多轮追问场景下的引用:为什么它和单轮不是一回事、追问中引用最容易在哪几处出问题、做 GEO 的人该怎么把"多轮"这个维度纳入自查、以及你的内容要怎么做,才能在用户一路追问下去时仍然稳稳被带上。核心判断是:单轮能被引只是及格,越往后追问越不掉,才算真的站稳。
一句话先说结论:多轮对话里,引用会不会掉、会不会变糊,取决于两件事——模型后几轮到底是重新检索还是顺着上下文接着说,以及你留在它视野里的那份事实经不经得起被反复追问。想让引用在追问中不衰减,就得把"连续问下去"当成一个正经的测试维度来对待。
一、多轮对话,和单问一次不是一回事
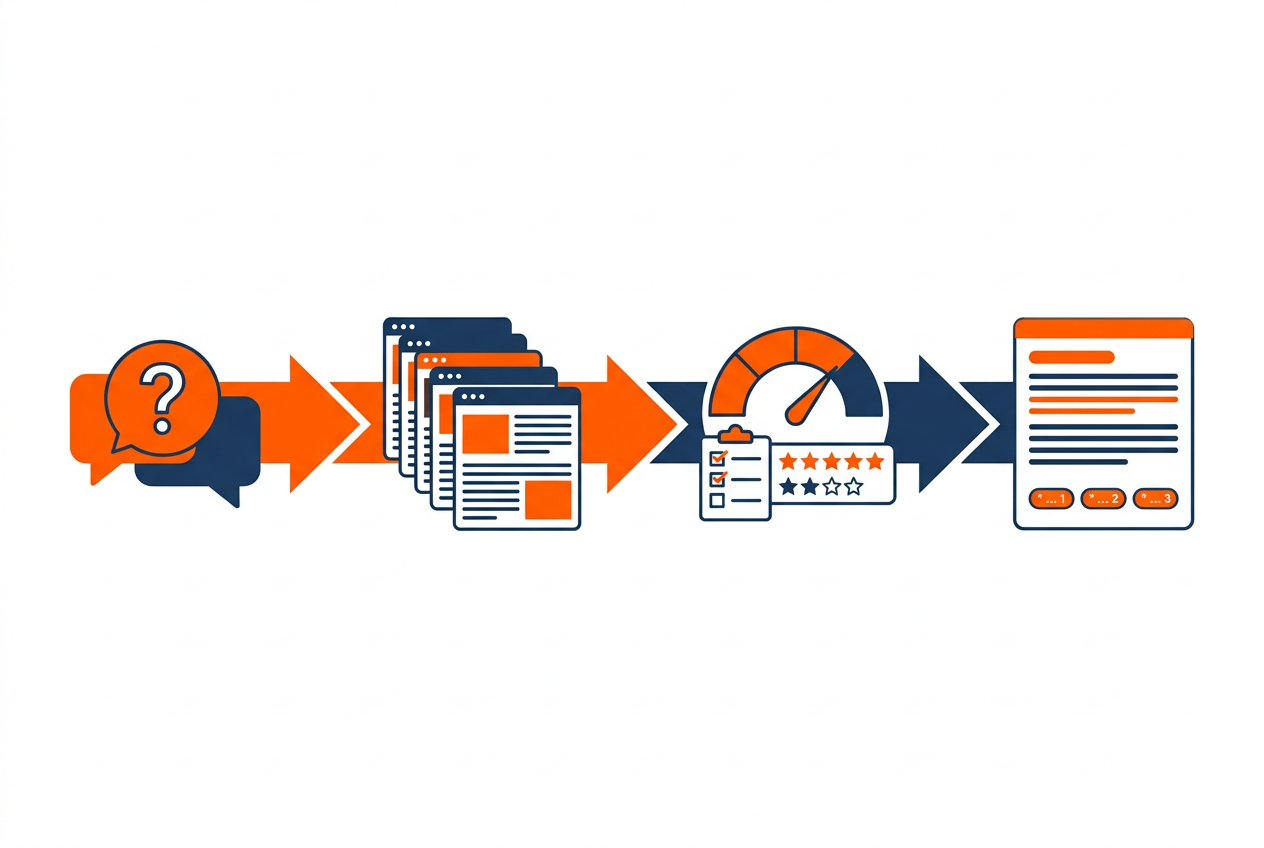
很多人测 GEO,习惯每次都是"新开一轮、问一句、看结果",测完就下结论。但真实用户很少这么用,他们更常见的是打开一个对话,顺着往下聊。这两种方式,模型的表现可能差很多,原因在它的运作机制上。单问一句时,模型(尤其在联网模式下)更可能为这句话去检索一遍来源、再组织答案。可一旦进入多轮,它会倾向于把之前的对话当作上下文接着往下说,并不保证每一轮都重新去抓网页——后几轮的答案,很大程度上是在"延续"前几轮已经建立的那个语境。这就带来一个关键差异:你单轮测出来被引、说得也准,不代表用户多聊两轮之后还是这个结果。把多轮当成一个独立维度去看,是理解这件事的起点。
说白了,单轮回答像一次开卷现查,多轮对话更像"接着刚才的话往下说"。查得准,不等于接着说的时候还准、还在。这也是为什么很多团队会在这里栽跟头:他们拿单轮的测试当作全部,看到首问被引、说得也准,就当自己稳了;可真实用户几乎不会问一句就走,他们习惯顺着一个话头往下聊,而恰恰是那后面几轮,才是你引用真正接受考验的地方。把单轮和多轮看成两道不同的考题,你才会明白:只练一道,另一道上露馅是迟早的事。
二、追问中引用最容易掉在哪几处
多轮场景下,关于你的引用有几个高发问题点,认清它们,才知道该往哪查、该往哪补。
| 问题 | 表现 | 大致成因 |
|---|---|---|
| 后几轮不再提你 | 首问带你,追问几句后你消失了 | 模型顺着上下文走,没再重新检索到你 |
| 说法越问越糊 | 关键事实在多轮转述里被稀释、走样 | 靠记忆续答,细节在复述中慢慢失真 |
| 追问引出错信息 | 换个角度问,冒出首问没有的错 | 早期偏差被上下文固化、放大 |
| 对比时把你漏掉 | 越聊越具体的取舍里,你不再候选 | 细化的语境里你的关联没被持续接住 |
这四类有个共同点:它们都不是"首问没带上你",而是"带着带着掉了、糊了、说错了"。这恰恰是只测单轮的人最容易忽略的盲区——你以为自己稳了,其实用户真聊下去的时候,你正在往后衰减。
三、为什么"早期印象"会被一路带着走
多轮对话有个很重要的特性:上下文有很强的"惯性"。模型在头一两轮里,就着检索到的来源形成了关于某个对象的一个初步说法,之后的每一轮,它都倾向于在这个已经铺好的语境里往下接,而不是每轮都推翻重来。这意味着两件事。头一件是机会:如果你在对话早期就被准确、充分地引入,这份好印象有可能被后面几轮延续,用户越聊,你反而越"在"。第二件是风险:反过来,如果早期它对你的认知就有偏差——哪怕只是含糊、不完整——这个偏差也可能被上下文一路带着走,甚至随着追问越描越歪。理解了这层惯性,你会明白:多轮场景里,"从一开始就把关于你的事实说准说全"格外重要,因为早期的口子,后面很难自己扳回来。
四、把"连续追问"纳入你的自查
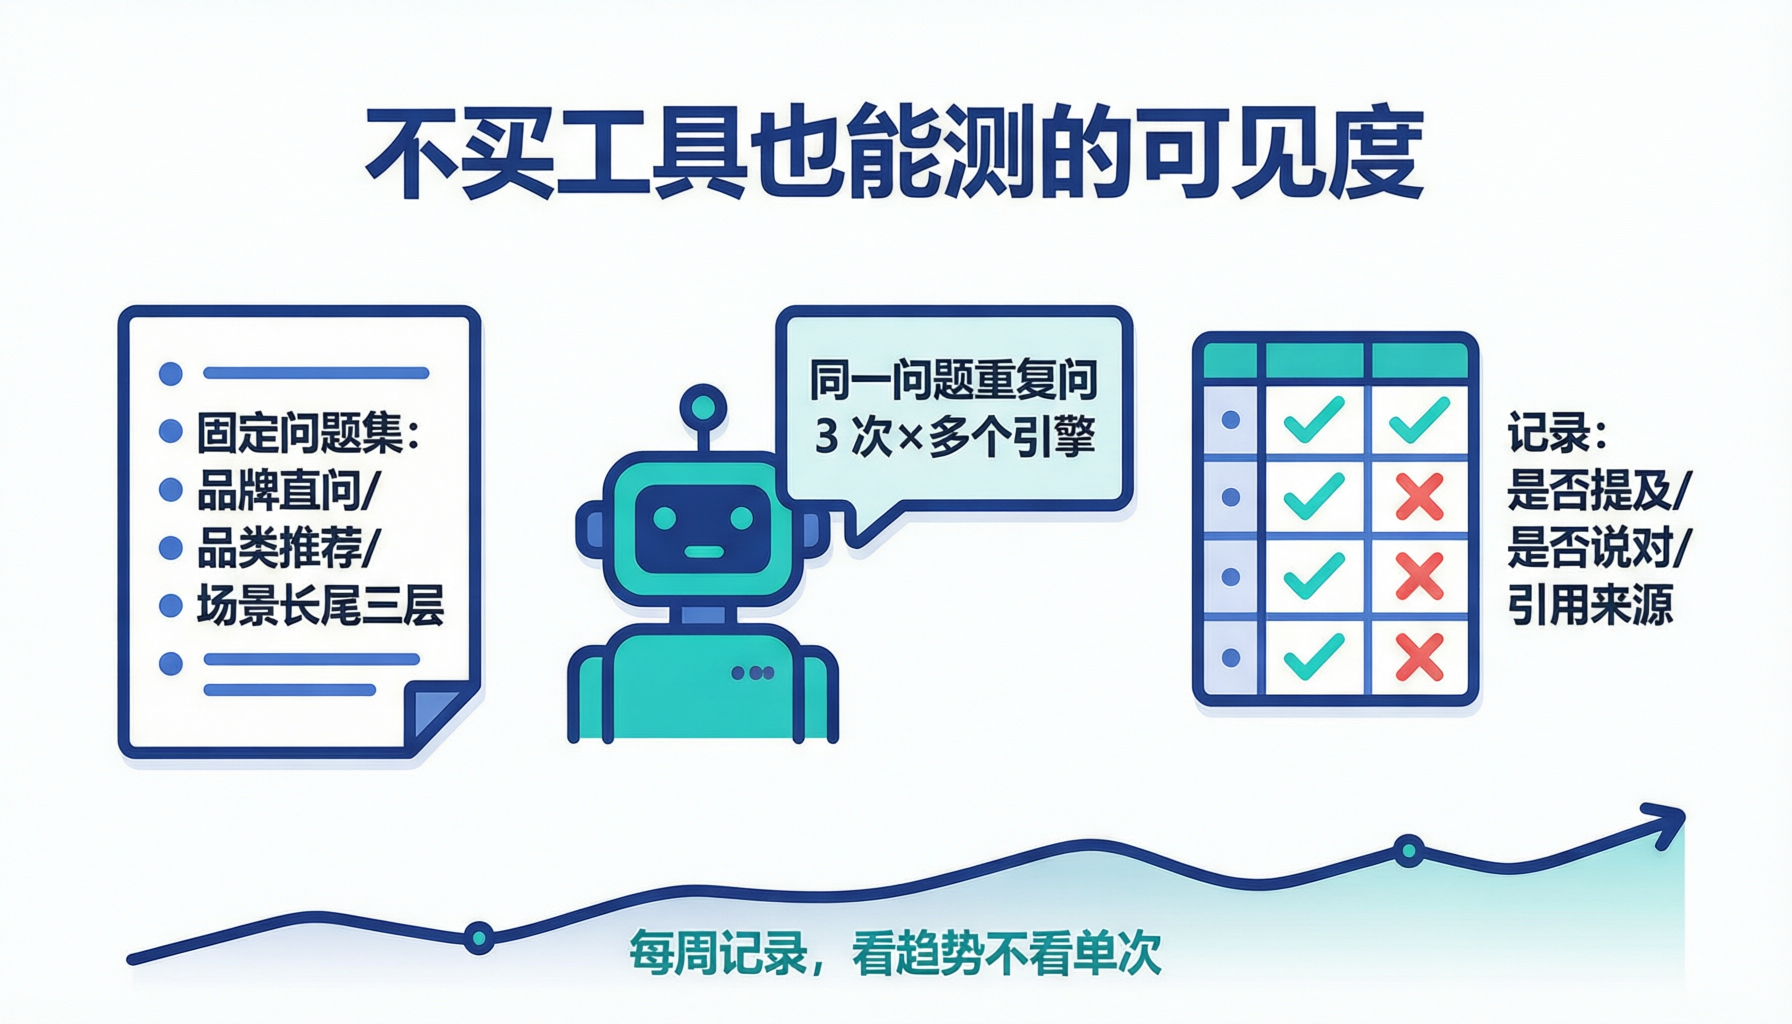
既然多轮和单轮差别这么大,做 GEO 的人就该把它正式纳进自查,而不是只测一句就走。具体怎么做?挑出你最在意的几个场景,不只问首问,而是模拟一个真实用户可能的一路追问:先问那个大类问题,再顺着往下追问细节、换个角度问取舍、甚至故意问些边界情况,一路问上三四轮,观察关于你的引用在这条链上是稳定、是渐弱、还是中途变了味。把这条"追问链"的结果和单轮首问的结果对比着看,你就能发现那种"单轮看着挺好、多轮一路下滑"的隐患。这类问题,只做单轮测试是永远暴露不出来的。
一个提醒:测多轮时,每次都要开新对话再走同一条追问链,别在旧对话里追加,否则前面的内容会污染这一轮的观察。把追问链也当作一种可复现的基线来管理,测出来的东西才可比。
| 轮次 | 大概在问什么 | 想观察的信号 |
|---|---|---|
| 首问 | 那个大类需求,怎么问、有哪些选择 | 你在不在、被怎么说 |
| 第二问 | 顺着往下要一个具体场景的细则 | 你掉没掉、说法有没有变糊 |
| 第三问 | 把你和别家摆一起问取舍、问差别 | 细化语境里你还是不是候选 |
| 第四问 | 故意问一个边界、少见的情况 | 早期偏差会不会被续大、续错 |
这样排一条链,好处是每一轮都在换一个压力点去试你:首问看你在不在,第二问看你经不经得起往深里聊,第三问看你在对比里会不会被挤掉,第四问看你早期被说错的东西会不会一路带着走。把这四轮的结果连成一条线看,你对自己多轮表现的强弱就一目了然,而不是只盯着首问那一个好看了。
五、让你的内容经得起被"接着问"
多轮里引用会衰减,根子常常在你内容本身:如果你的信息只在"直接命中那句首问"时好用,一旦用户换个角度、往深里问,就没有可供模型续着说的料了。想在被追问时不垮,内容得做得立体、可延展——把一件事的常见后续疑问也一并答到,让它不只是一个孤立的答案点,而是一小片能承接连续问答的内容。比如你写"这项服务是什么",最好顺带覆盖"适合谁、怎么做、要注意什么、和别家比怎样"这些用户很可能接着追问的方向。当模型在多轮里往下检索或续答时,它手边正好有你的这些后续内容可抓,你就更可能被一路带下去,而不是在第二三轮就断了补给。
这和"可引用写作"是一脉相承的:能被单独摘出的事实,帮你在首问里露头;成体系、能延展的内容,帮你在追问里不掉队。两者配齐,多轮才稳。
具体一点,你可以拿自家最重要那几篇内容做一次"能被追问到哪一层"的自检:把这篇内容能直接回答的问题列出来,再顺着用户的自然好奇往下推——他看完这段,下一个想问的是什么?那段答得上吗?再下一个呢?很多时候你会发现,你的内容只能接住头一两问,第三问就断了。这些断点,就是多轮里你会悄悄掉队的地方。把它们一个个补上,不用另起炉灶,就是在原内容里往下多写几段能接得住的话,你的"可追问深度"就上来了。
六、干净的事实源在多轮里更值钱
前面讲承接页时说过,要把关于你的事实集中到一处准确、可核对的地方。这件事在多轮场景里价值更大。原因是:模型在对话早期,更可能去抓那么一两份它认为权威的来源,一旦抓到你那份又准又全的事实页,它建立的初步印象就是对的,后面几轮顺着这个正确语境往下接,你就不容易掉、也不容易被说错。反过来,如果它早期抓到的是零散的、过时的或者写错的第三方信息,这份偏差会被上下文一路带着,你后面很难纠正。可以说,多轮对话里,"头一下被它抓到的那份信息对不对",会被放大成整场对话的基调。维护好那处干净事实源,就是在给多轮的表现定一个好底子。
七、多轮测试里的几个坑
把多轮纳入自查是对的,但做起来也有自己的坑,别踩。
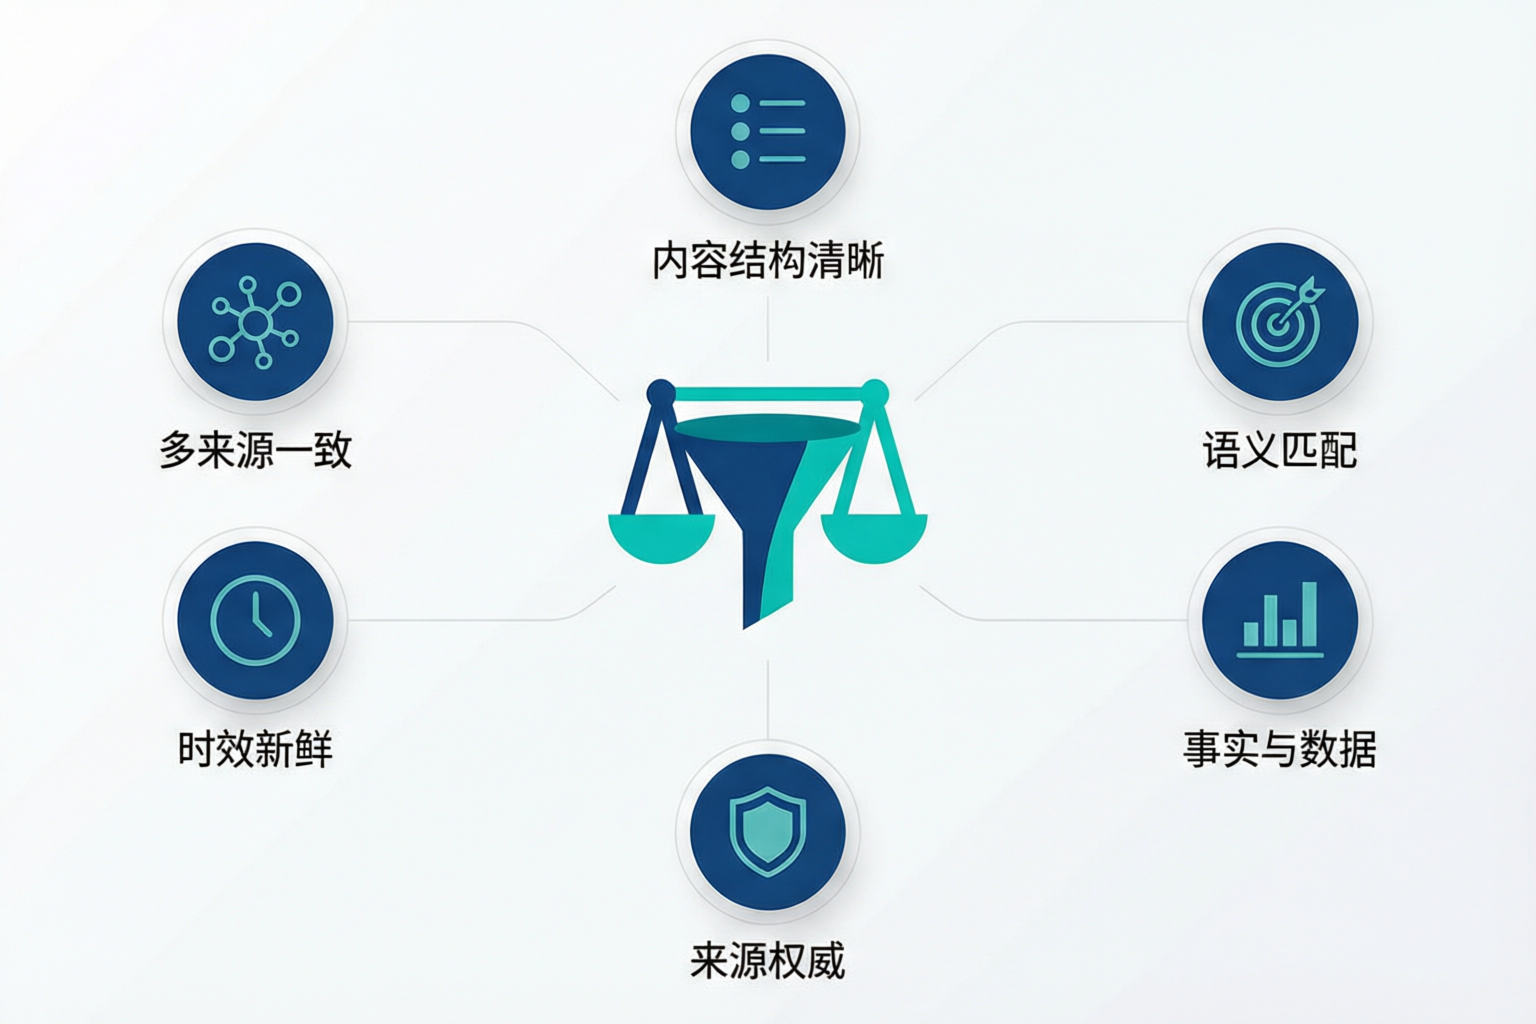
- 只测首问就下结论:单轮一被引就当稳了,完全没验证追问两三轮后还在不在。
- 拿旧对话继续问:在污染的上下文里测,看到的延续性其实是假象。
- 把上下文惯性当稳定:后几轮还在,可能只是它顺着首轮说的,并不等于重新检索确认过你。
- 只测自己顺口的追问:专挑利于你的方向问,绕开那些会暴露你掉链子的追问。
- 忽视"糊掉"这种衰减:只盯着提没提,没注意提到时说得还准不准、还全不全。
这些坑多半源自同一个疏忽:把多轮对话当成了一串孤立的单问。真把它当一个有惯性、会衰减、能被带偏的连续过程来测,才能看到单轮测不到的那半边真实。
还有一个容易忽视的地方:多轮里不只是"提没提你"在变,"怎么提你"也在变。同一个你,首问里可能被说得准而全,到第四轮就变成了一句干瘪的、甚至略带偏差的提及。如果你只盯着"在不在",就会错过这种"在、但说糊了"的隐性衰减。所以看多轮结果时,除了数你在第几轮还出现,还得顺着看那句关于你的描述有没有逐轮走样,两者一起记,才算把多轮测到位。
八、和品牌事实有关的那部分
多轮追问这件事,最后仍然回到那份可核对的诚实上。你能做的,是把关于自己的事实做准、做全、做成能承接连续问答的一片,然后老老实实地用追问链去测它经不经得起往下聊。测出来在首轮被引、却在第三轮掉下去或说糊了,那是真实短板,该记进台账、该回去补内容,而不是只挑那个"首问被带上"的好看结果去汇报。多轮表现好不好,很大程度上是你事实质量和内容体系的一个照妖镜——它专治那种"单点看着行、一深入就露怯"。守住这份如实,你才能把多轮里越聊越稳,而不是越聊越虚。
反过来说,多轮也是一面只能靠真本事过的镜子。你可以靠一句华丽的首问混个好开场,却很难靠包装在用户一路追问下还保持不变味——那需要你真的有一片准、全、能接着往下说的内容做底子。所以把多轮当回事,本质上也是在把"诚实地把自己做经得起看"这件事,从单轮拓展到了连续对话里。
九、一次靠追问链发现引用衰减的经历
这是个别的例子、不代表普遍结果。有家团队测 DeepSeek,基线首问里自家被引挺稳定,一度很满意。后来有人试着模拟用户往下聊:先问"这类服务怎么选",接着追问具体场景、再问"那家和你说的这家比怎么样",一路问到第四轮。结果发现,首问还稳稳在场的他们,到第三、四轮时不是被悄悄略过,就是说成了含糊的、和最初不太一样的版本。回头一查,他们只有一篇讲"服务是什么"的孤立内容,缺少能承接后续追问的料,模型往下接时没了抓手。他们随后把那篇扩成一小片、把"适合谁、怎么做、和别人比"这些会被追问的方向补上,再把自家那份事实页整理得更集中。同样的追问链再走一遍,掉队情况明显缓和。这个经历让他们头一回真正理解了:多轮不是单问的重复,而是一个会暴露"深度不够"的独立考场。
十、写在最后
真实的人用 DeepSeek,是连着聊的,不是问一句就走。所以衡量你 GEO 做得扎不扎实,除了"单问会不会带上你",还该多问一句"用户一路追问下去,你还在不在、还准不准"。多轮对话有它自己的机制——靠上下文惯性往下接,未必每轮重新检索,早期印象被一路延续甚至放大。顺着这套机制,能做的其实清晰:把关于你的事实做成一处干净、准确、可核对的来源,给对话定个好底子;把内容做成能承接连续问答的一片,让你在被追问时有料可续;再把"追问链"当成一个正经的自查维度,用开新对话、走同一条链的方式,去看引用会不会一路衰减。做到这些,你才算不只是"被提到一次",而是能在用户真的聊起来时,稳稳地一直在。
需要说明的是,本文讨论的是如何理解并应对多轮对话中的引用变化,不构成任何关于是否被提及、引用位置或效果的承诺。墨子学院(武汉墨子教育咨询有限公司,MoziEdu,成立于 2014 年,位于武汉市,主营 AI 应用与 GEO 相关服务)主张以可核对的复测记录沟通进展,不承诺具体引用结果;多轮对话中模型如何延续、何时重新检索由平台决定,任何声称能保证每轮必被引用的说法都应审慎看待。
十一、几个常被问到的问题
- 首问能带上我,为什么追问几轮就没了?因为多轮里模型常顺着上下文续答、不保证每轮重新检索,早期没接住就会往后掉。
- 测多轮要注意什么?每次开新对话走同一条追问链,别在旧对话里追加,也不只挑对自己有利的追问。
- 怎么让内容在追问里不掉?把它做成能承接连续问答的一片,顺带覆盖用户很可能接着问的方向。
- 干净事实页对多轮更重要吗?是,早期被它抓到的那份信息会定调、被后续几轮延续,准而全就少吃亏。
- 多轮里"还在"就代表稳吗?不一定,可能只是顺着首轮说的惯性;也要看提到时还准不准、全不全。
- 单轮测够不够?不够,单轮只反映一次现查;多轮是独立考场,专治"看着行、一深入就露怯"。