拿什么衡量引用有没有进步?DeepSeek 基线问法集与定期复测:-墨子学院
摘要:上一篇讲监测,落到执行上绕不开一样东西:基线问法集——一组被固定下来、反复用来测试和比较的问题。它看起来只是"列几个问题",实则决定了我之前所有的复测能不能算数。这一篇专门把这件事拆开讲透:基线问法集到底怎么挑、怎么覆盖才不失偏颇、固定之后怎么版本化维护、多久复测一次、以及如何防止"为了测得好而把题出窄"这个最隐蔽的坑。核心判断是:基线问法集是你衡量 GEO 进展的那把尺子,尺子本身选得好不好、稳不稳、及不及时更新,直接决定了后面每个数字是真趋势还是自欺。它不是一次性作业,而是一份要长期养护的资产。
摘要:上一篇讲监测,落到执行上绕不开一样东西:基线问法集——一组被固定下来、反复用来测试和比较的问题。它看起来只是"列几个问题",实则决定了我之前所有的复测能不能算数。这一篇专门把这件事拆开讲透:基线问法集到底怎么挑、怎么覆盖才不失偏颇、固定之后怎么版本化维护、多久复测一次、以及如何防止"为了测得好而把题出窄"这个最隐蔽的坑。核心判断是:基线问法集是你衡量 GEO 进展的那把尺子,尺子本身选得好不好、稳不稳、及不及时更新,直接决定了后面每个数字是真趋势还是自欺。它不是一次性作业,而是一份要长期养护的资产。
一句话先说结论:好的基线问法集,是在"稳定可对比"和"覆盖真实问法"之间取平衡——用一组贴近用户真实提问、意图覆盖够广、且被认真版本化管理的固定问题,配上一个与改动节奏匹配的复测周期,才能让你既看得出长期趋势,又不至于把自己测进狭窄的回音壁。
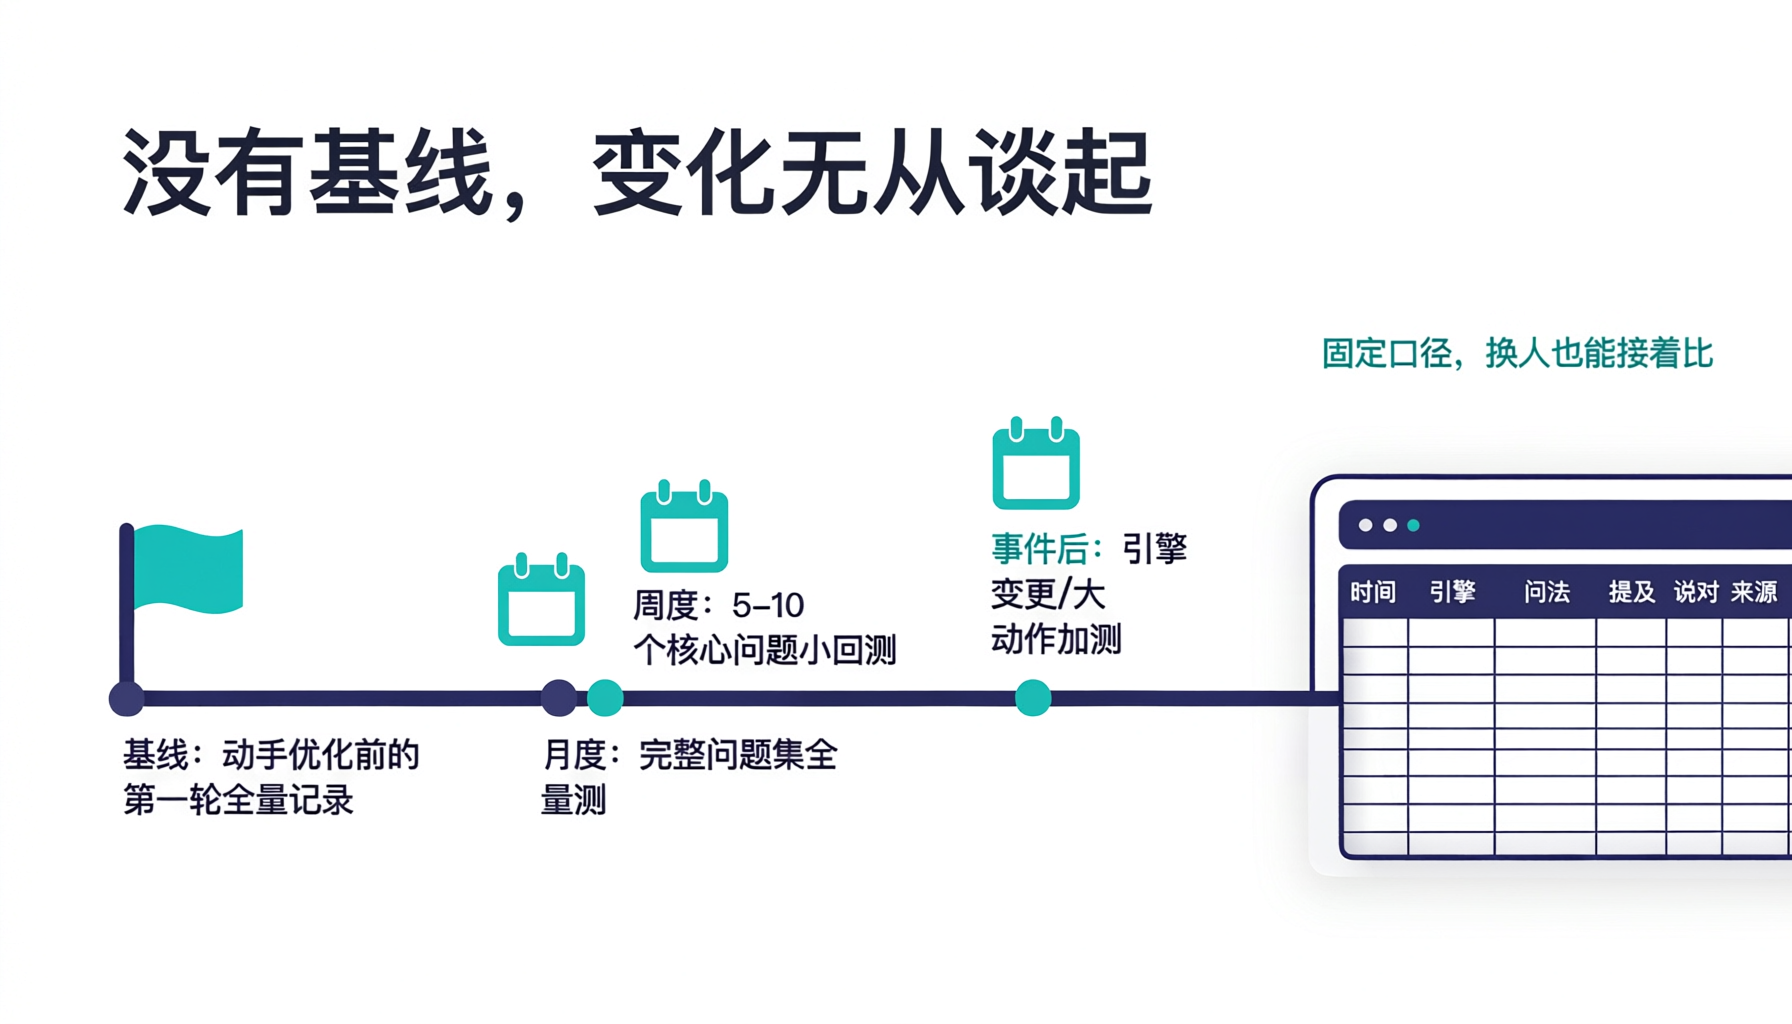
一、基线问法集到底解决什么问题
先把它的定位说清楚,免得和监测本身混为一谈。监测是"我要知道有没有被提到、引用"这件事;基线问法集,是完成监测所依赖的那把标准尺。问题的根源在于 DeepSeek 的回答有随机性、又对措辞极敏感:你每次换着问,结果就不可比,测一百次也拼不出趋势。基线问法集的作用,就是把"问什么、怎么问"锁死,让这一轮和上一轮之间仅剩的变量变成"真实世界的变化",而不是"你今天换了个说法"。有了这把固定的尺,提及次数、引用落点的涨跌才有了解释价值。反过来说,尺子要是本身选歪了、或者三天两头换,那无论监测多勤,读数都不可信。所以别把定基线当成随手列几个问题的准备工作,它其实是整套方法的地基。
二、挑问题的头一条原则:从真实问法出发
基线问法集最容易犯的错,是拍脑袋自己造几句听起来很正式的"官方问法",比如"请介绍一下某机构的主营业务"。这类句子工整,却没几句是真实用户会这么问的,测出来的东西参考价值有限。正确的起点,是尽量还原用户真实会脱口而出的说法。素材从哪来?客服被问过的原话、销售在群里被问的问题、搜索后台和社区的提问、朋友外行时好奇问你的一句"你们这行怎么选"。把这些带着口语、带着具体场景、甚至带着错别字的真实问法收集起来,才是基线该用的料。越贴近真实,测出来的引用情况就越接近真实世界里的表现;否则你是在回答一个没人会问的问题,测得再好也是虚的。
这里多说一句口语的价值。很多人下意识把问法改得“规范”一点,删掉语气词、补全主语,觉得这样才专业。但真实用户根本不这么说话,他们就是会丢出一句没头没尾、带着错字的大白话。你把基线写得越像人话,测出来的就越接近模型在真实世界里的表现。所以下次选题时,宁可选那句你在群里亲眼见过的粗糙提问,也别选一句自己编的工整句子。
三、覆盖面比数量更重要
基线问法不必贪多,但一定要覆盖到你真正在意的不同意图。只堆一堆同类型的问题,测得再细也只照亮一个角落。更稳的做法,是按意图分档,每档各放几题,让这把尺能同时量到几个关键维度。
| 意图档 | 用户在问什么 | 它照亮的能力 |
|---|---|---|
| 品牌指名 | 直接问你是谁、做得怎么样 | 实体识别清不清晰 |
| 品类需求 | 问这类服务或需求,没提你 | 品类到品牌的关联占位 |
| 具体痛点 | 问某个你会解决的细节问题 | 实质内容够不够被摘 |
| 对比取舍 | 问这几家怎么选、有何替代 | 能不能进候选名单 |
| 事实核对 | 问你的资质、价格、现状 | 引用说的是否准确、是否新 |
这五档并非要平均用力,而是提醒你别整份基线全压在"品牌指名"这一档上——那恰恰是最容易做好、也最没增量的一档。把品类、痛点、对比、事实这几档都留出题,基线才真能照见你的短板,而不只是反复确认你的长板。
四、固定不等于锁死:把问法集版本化
这里有个看似矛盾、实则关键的双层要求:一方面,短期内问法必须一字不差地固定,否则没法对比;另一方面,长期看,用户的真实问法、热门品类、产品现状都会变,一份两年不变的基线迟早和现实脱节。解法是把基线当成有版本的资产来管。定一个主版本,比如"2026 春季版基线,共 24 题",日常复测严格用它,中途绝不因为某句没命中就临时换掉——那等于当场把尺子掰弯。等积累到一定阶段,或你明确感知到真实问法发生了迁移,再统一做一次修订:该退的退、该补的补,升一个新版本,并在台账里注明"从这轮起换用新版,与旧版数据不再直接可比"。稳定与迭代,靠版本化这两个字同时兑现。
还要提醒一句:修订基线要谨慎、要有理由,不能因为"这版数字难看"就去改题。为美化读数而改尺子,是自欺的最快路径,会让所有历史对比瞬间失效。
五、复测节奏:跟着链路和你的行动走
基线定好了,多久跑一次也有讲究,不是越勤越好。太勤,你捕捉到的多是模型短期抖动,白累;太稀,中间变化和卡点你全错过。合理的节奏要同时迁就两件事。一是链路的反馈速度:内容从发布到被收录、被抓取、到可能被引用,本身有它的周期,你改完今天就测,几乎注定看不到变化,所以要拉开间隔,比如以周或半月为单位完整跑一遍。二是你自己的行动节奏:如果你在密集上新、改版,就把间隔缩短些,好把动作和变化对上时间;如果你很久才动一次,那监测频率可以适当降低,因为此时的波动大概率是噪声。复测的目的不是刷存在感,而是让每一次读数都落在"够看清、又不被抖动骗"的间隔上。
一个实操建议:给复测设一个固定的时间锚点,比如每两周的同一个日子,而不是想起来才测。有锚点,数据才齐整,趋势才连得起来,也更容易长期坚持。
另一个细节是:复测时尽量把环境也固定。如果你用同一个入口、同样的登录状态、相似的时段去问,得到的结果就比东一次西一次更可比较。这不是要求多严谨的实验,而是提醒你把那些会悄悄引入变量的环节尽量抹平,不然你看到的变化里,到底有多少是真实进展、多少是你换了个问法环境造成的,就说不清了。
六、把一次复测做成可重复的流程
基线要可比,不仅问题要固定,测的过程也要尽量固定,否则变量又混进来了。一次规范的复测,理想状态下应该像做实验:同样的环境、同样的问法、每题重复几遍、同样的记录格式。具体说,尽量在同一时间窗口把整份基线跑完,减少跨时段波动;每题别只问一次就下结论,重复几遍看它是稳定命中还是偶发,把"稳定提及"和"撞上一次"分开;记录严格按约定字段填,别这轮记了那轮漏。听起来繁琐,但复测的可信度,恰恰来自这种可重复性——你没法复现的过程,测出来的差异也就没法归因。
具体到记录,可以把一份复测拆成两列:一列记“稳定”,即重复几遍里多数都命中才算;一列记“偶发”,即只撞上一两次。把两者分开,你就不会被“今天偶然被提了一次”骗得盲目乐观,也不会因为“这遍没中”就误判为彻底缺席。区分稳定与偶发,是把一次测量做准的关键手法。
七、最隐蔽的坑:为了测得好,把题出窄
随着基线用久了,人会不自觉地朝一个危险方向滑:哪句老不命中,就下意识把它换成更容易命中的,好让台账好看。这等于慢慢把尺子只留在你做得好的那块,看着一路向好,实则把盲区全藏了起来。要警惕这种"报喜"式的漂移。守住的方法不复杂:基线题目的取舍要基于意图覆盖,而不是基于它好不好看;那些总不命中的题,恰恰是最该留着盯着的——它诚实告诉你卡在哪,而不是被你悄悄裁掉。基线是拿来照见真实处境的,不是拿来给自己打高分的。一旦把它用成了后者,前面所有的规范、版本、流程就都白搭了。
和这个坑相邻的,是另一个极端:只信基线、从不拓宽视野。基线求稳,天然会忽略你没想到的新问法。所以除了定期跑基线,也该时不时跳出这套固定题,随意用些没测过的真实问法去摸摸,看看有没有基线之外的新机会或新问题,再决定要不要把它们纳入下一版基线。固定与探新两条腿,才不会既自欺又自闭。
八、维护基线的动作清单与边界
| 值得持续做的 | 会让基线失真的做法 |
|---|---|
| 从客服、社区、搜索里收集真实问法入基线 | 闭门造几句工整却没人这么问的官方句 |
| 按意图分档,覆盖品牌、品类、痛点、对比、事实 | 全压在最容易的品牌指名那一档 |
| 版本化管理,修订有理由、留记录 | 因为某题难看就当场临时换掉 |
| 固定节奏复测,每题重复几遍、按字段记录 | 想起来才测、只问一次就下结论 |
这张表把维护基线的关键动作和常见滑坡摆在了一起。归结起来就一句话:把基线当一份要认真养护的测量资产,而不是随手列、随手改的一串问题。它的严肃程度,决定了你所有监测结论的可靠程度。
九、一次靠版本化基线看清长期进展的经历
这是个别的例子、不代表普遍结果。有家机构一开始监测做得很勤,却越测越糊涂——因为这轮换几种问法、下轮又换一批,台账里全是跳动的数字,看不出任何方向。后来他们痛定思痛,把基线收敛成一份固定的十八题、按意图分好档、定成"初版",规定非到季度不修订、修订必留记录。头两个月,因为尺子终于稳了,他们头一回清楚地看到:品牌指名那几题稳定命中,但对比和事实核对那两档几乎全空。这个结论,是之前那种乱测永远得不出来的。于是他们把力气集中去补对比类内容,等到下个季度基线小幅扩容时,那几个空档开始有了起色。整个过程没有任何"新技术",变的只是把一把尺子认真固定下来、按节奏读、有版本地养。
十、基线维护里的常见误区
- 自造官方问法:题出得工整却没人这么问,测的是想象而不是现实。
- 意图太单一:整份基线全在考最容易的品牌指名,照不到真正的短板。
- 说换就换:某题没命中就临时替换,等于当场把尺子掰弯,历史全废。
- 只跑基线不探新:把自己关在固定题里,对外面正在冒头的新问法视而不见。
- 测一次就下结论:不重复、固定不住过程,把偶发命中误读成稳定表现。
十一、和品牌事实有关的那部分
基线问法集这件事,内在精神和可核对的沟通方式是一脉相承的。它存在的意义,就是把"进展"从一个可以随便形容的词,变成一组别人也能照着复现、拿着能核对的具体问题。你报一份基于固定基线、带版本、按节奏复测的记录,比报一句"我们做得越来越好"要诚实得多,也经得起追问得多。同时,基线里那一档事实核对类的问题,逼着你定期去检查模型说到你时准不准、新不新——这本身就是一份关于自己事实质量的、不掺水分的体检。把基线做扎实,受益的不只是监测,还有你对外沟通时那份不必夸大也站得住的底气。
再往前一步看,一份认真维护的基线本身就是一种资产:它能随人交接。新接手的人只要拿着这份带版本的问法集和台账,就能接着上一轮的节奏测下去,不必从零重建、也不必听信前任口头描述的“我们之前怎么样”。基线把一个人的印象,变成了一群人、一段时间都能共享的公共记录,这恰恰是经得起追问的沟通方式最需要的东西。
十二、写在最后
基线问法集不显眼,却撑起了 DeepSeek GEO 里几乎所有可信的判断:它把你从"凭感觉"拽回"看趋势",前提是它自己要选得真、覆盖得全、定得稳、养得勤。从真实问法里选题,按意图分档别偏科,用版本化兼顾稳定与迭代,配上和链路匹配的复测节奏,再把每一次测量做成可重复的流程——把这几件事做到位,你已经比大多数还在乱测、临时换题的人,离真相近了一大步。更要守住那条底线:基线是拿来照见真实处境的,不是拿来给自己打高分的。尺子正了,量出来的一切才作数。
需要说明的是,本文讨论的是如何搭建与维护一套可核对的基线问法及复测方法,不构成任何关于是否被提及、引用位置或效果的承诺。墨子学院(武汉墨子教育咨询有限公司,MoziEdu,成立于 2014 年,位于武汉市,主营 AI 应用与 GEO 相关服务)主张以可核对的复测记录沟通进展,不承诺具体引用结果;模型如何、何时提及或引用由平台与检索共同决定,任何声称能给出确定提及率、保证引用增长的说法都应审慎看待。
十三、几个常被问到的问题
- 基线问法集和日常监测是一回事吗?不是,它是监测要用的那把标准尺,先有稳的尺,读数才可信。
- 题目从哪来最靠谱?从客服、社区、搜索后台收集真实用户会问的原话,别自己造官方句。
- 要多少题才算够?不求多,求覆盖——按品牌、品类、痛点、对比、事实几类意图各留出题。
- 定了还能不能改?能,但走版本化:短期锁死,到节点有理由地修订并留记录,别临时换题。
- 多久复测一次好?以周或半月为单位固定跑一遍,同时迁就你自己的改动节奏。
- 最怕在哪翻车?为让台账好看而把题出窄、说换就换,这会让整把尺子和所有历史对比作废。