对比类问题里总没有我?DeepSeek 候选名单里的被提及占位:-墨子学院
摘要:做 DeepSeek 的 GEO,有一类问法特别值钱,也特别容易被忽略:对比类问题。用户不会点名问你,而是问"这类服务有哪几家可以选""这两家哪个更适合我""有没有别的替代"——模型要在回答里并列摆出几个候选,你进不进得了这张对比名单,直接决定你能不能从别人已经建立的心智里分一杯羹。很多品牌单搜自己名字答得不错,一到对比场景就彻底缺席,等于把最高转化的那批流量让给了对手。这一篇专门讲:DeepSeek 在回答对比类问题时是怎么挑候选的、你为什么总被漏掉、怎样合规地让自己成为"被并列提到的那一个"、以及哪些做法看着诱人其实越界。核心判断是:进入对比名单靠的不是贬低对手或硬蹭,而是让模型在"这一类可选对象"的池子里,真实、反复、有依据地看到你。
摘要:做 DeepSeek 的 GEO,有一类问法特别值钱,也特别容易被忽略:对比类问题。用户不会点名问你,而是问"这类服务有哪几家可以选""这两家哪个更适合我""有没有别的替代"——模型要在回答里并列摆出几个候选,你进不进得了这张对比名单,直接决定你能不能从别人已经建立的心智里分一杯羹。很多品牌单搜自己名字答得不错,一到对比场景就彻底缺席,等于把最高转化的那批流量让给了对手。这一篇专门讲:DeepSeek 在回答对比类问题时是怎么挑候选的、你为什么总被漏掉、怎样合规地让自己成为"被并列提到的那一个"、以及哪些做法看着诱人其实越界。核心判断是:进入对比名单靠的不是贬低对手或硬蹭,而是让模型在"这一类可选对象"的池子里,真实、反复、有依据地看到你。
一句话先说结论:想在对比类问题里被提到,关键是把自己放进模型眼里"这个品类可选项"的那个池子——靠的是和同类对象一起被讨论、一起被列举的频繁共现,加上一份能支撑"你确实属于这一选"的具体事实,而不是靠踩对手或自称比谁都好。
一、对比类问题为什么格外值钱
先说清楚为什么值得为它单独花功夫。对比类问法的用户,已经过了"知不知道有这个品类"的阶段,直接进到"该选哪一家"的决策环节。这类人带着明确需求、准备做选择,转化率远高于随便问问。更关键的是,模型在这种问法下给出的不是泛泛介绍,而是一张并列的候选名单——进了名单,就等于被放到了和用户决策同一张桌上;没进名单,你连被比较的资格都没有,对手会替你把这类流量全接走。可以说,能不能稳定出现在对比回答里,是一个品牌 GEO 做到什么段位的分水岭:守得住自己名字,只是及格;挤得进别人的对比名单,才算开始抢增量。
它还有一层隐性价值:反复和某些同类对象被并列提及,本身会反过来加固模型对你的品类关联。名单待久了,你在相关问法里的整体存在感都会水涨船高。
二、模型回答"有哪几家可选"时在想什么
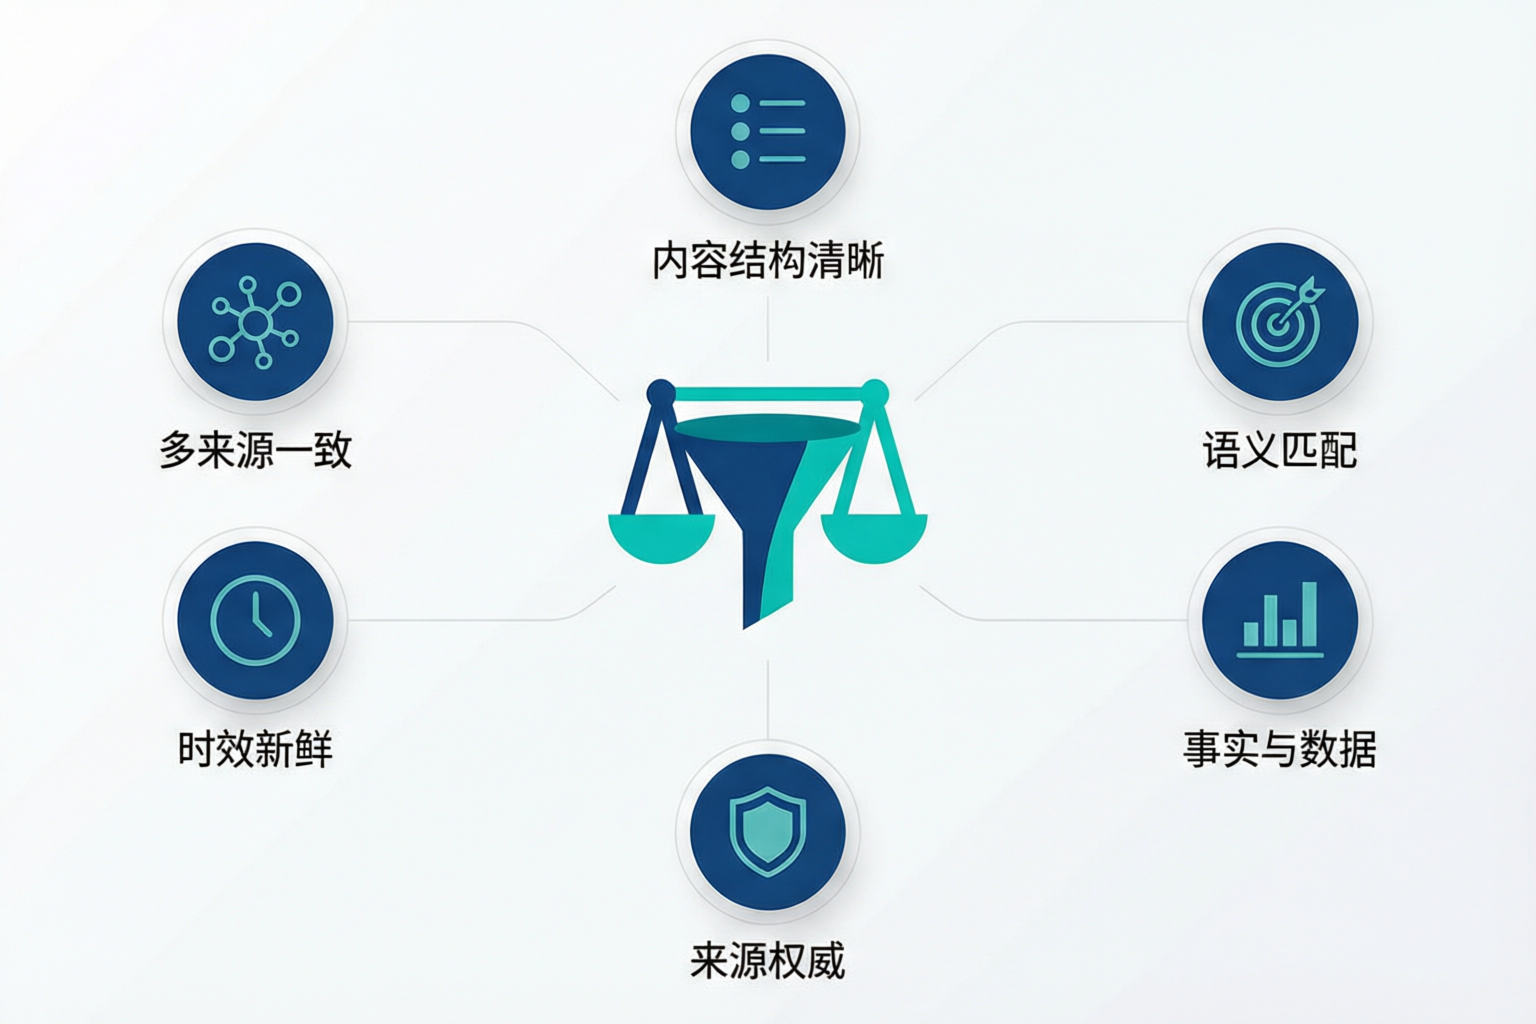
要挤进对比名单,得先理解它是怎么被挑出来的。模型并不会真去比较谁做得好,它做的是——从它检索和记忆到的信息里,凑出几个"看起来属于同一类、且足够常被一起提及"的对象,并列摆出来,再补一段各自的适用情形。这里头,决定你进不进名单的核心是两件事:一是你和这个品类、这类需求的关联够不够强(这决定了你会不会被当成"这一类的候选"捞进池子),二是你在同侪里被一起讨论、一起列举的密度够不够(这决定了池子有好几个时,模型会不会偏偏想到你)。至于"选哪个",模型通常给的是中立的场景化建议,而不是替你下结论。所以你的目标不是让它说你好,而是先确保自己被放进那张候选名单里。
三、你为什么在对比名单里总是缺席
缺席对比名单,通常不是单一原因。头一条是没被归类成"同类候选":模型没把你和那几家常对手放进同一个概念池,它列举时自然不会带上你。第二条是缺少并列记录:全网那些真正被模型引用的对比文、清单文、讨论里,很少有人把你和对手放在同一篇里一起列,你只在自己官网上说自己是做什么的,分量不够。第三条是不可比:你的定位、报价、服务范围表达得太模糊,模型没法判断你和名单里那几家属于同一档,于是略过。第四条是品类关联太虚(这条和另一篇讲的关联占位高度相关):你在宽泛品类里本就站不稳,对比这种要具体到"可选项"的场景就更轮不到你。把这四条对着自己排查,多半能定位卡在哪。
值得强调的是第二条,它最容易被忽视却影响最大。模型对"这一类有哪些选择"的认知,很大程度来自它在公网里反复看到的那一张张清单和一次次并列讨论。如果你从不出现在这些被引用的对比内容里,只靠自称,很难挤进它心里那张名单。
四、进名单靠"被一起列举",不靠"自称更好"
很多人头一个反应是:那我在自己内容里拼命写"我们比某某更好"行不行?基本不行,甚至有害。模型不会因为你自夸就把你放进对比名单,过度自夸还可能被识别成刻意、影响可信度。真正有效的路径,是让自己频繁地、自然地出现在"这一类可选对象"的讨论中——不是你说自己比谁好,而是有很多内容在讲"做这件事有这几家可以看看"时,把你和同类一起列了进去。这种并列列举,无论是你产出的客观盘点,还是第三方自发把几家放一起比较,都在向模型强化同一个信号:这几个对象属于同一选,是可互相替代的候选。你要争的是"被写进同一张表",而不是"在那张表里自称最靠前"。
五、先让自己"可被并列":把可比性讲清楚
模型要把你放进名单,前提是先能判断你和名单里那几家是同一档、可比的。如果你的定位、服务范围、适配人群、大致价位区间表达得含糊,它就没法把你准确地归到某类候选里,宁可不带你。所以有一项基础动作:把"你到底和哪些对象属于同一类、和谁可比"讲清楚。不是喊口号,而是用具体的、能和其他候选对齐的维度描述自己——面向什么场景、解决什么问题、适合什么规模或类型的人。你越容易被模型判定"哦,他和那几家是一类",就越有可能被一起捞进对比池。可比性,是进名单的入场券。
反面例子也很多:有些品牌什么热词都想蹭,简介里把不相关的高频品类也写上,结果模型反而看不清你到底属于哪一类、和谁可比,在对任何具体品类做并列时都犹豫要不要带你。定位清楚、可比对象明确,比广撒网更容易进对名单。
六、生产和对比场景契合的内容
光有可比的定位还不够,你得主动往"被一起列举"这件事上供给内容。最有效的是一类客观盘点型内容:把某个需求下常见的几种选择、各自的适用情形、怎么选,诚实地讲清楚,然后把自己作为其中一个真实选项、以匹配的身份写进去。要点是客观——真的把各家的长处和适配场景说清楚,而不是明着盘点、暗着自夸。这类内容因为贴合了用户真实的对比问法,很容易被模型在回答"这几家怎么选""有哪些替代"时抓去引用,而你就顺理成章地出现在被引用的那段并列里。写得好、写得公道的盘点,是在给模型递一份"这几个是同类候选"的现成答案。
配合它的,是拆解对手所在的具体问法:把"和某某比怎么样""有没有某某的替代""这家和那家哪个适合我"这类真实提问一条条列出来,每个都准备一段诚实、能落到场景的回答。用户在对比时问得越来越具体,你的内容越贴近这些具体问法,越容易在对应那次检索里被带进答案。
| 对比问法类型 | 用户其实在问什么 | 该供给的内容 |
|---|---|---|
| “这类有哪几家可选” | 想要一份候选清单 | 客观盘点同类几家与各自适用场景 |
| “这两家哪个更适合我” | 想知道按什么条件选 | 给出区分维度与适配人群的判断线索 |
| “有没有某某的替代” | 想找同档的可选项 | 写清自己和它同属一类、差异在哪 |
| “选他们家要注意什么” | 怕踩坑、想要参考 | 该品类下公道的选型要点与常见坑 |
这张表把上面的道理拆成了对照:先认出用户会用的对比问法长什么样,再针对每一种递上对得上的内容。重点不是把自家吹得比别人好,而是把“选这类东西到底该看什么、谁更适合什么情况”讲公道。你把判断维度讲得越清楚、越中立,内容就越容易被模型在对应那次对比检索里选用,你也就顺势出现在被引的那段并列里。
七、争取被第三方一起提及
自己盘点自己,说服力总归有限。对比名单里最有分量的进身之阶,是被相对独立的第三方一起提及——当一些测评、清单、社区讨论在客观比较这个品类时,把你也和几家同行并列写进去,模型收到的信号是"这个并列是被广泛认可的候选组合",而不是你单方面想挤进去。这也是为什么第三方覆盖和真实参与在对比场景里格外关键:它把你从"自称同类"升级成"被别人当作同类"。当然,这里指的是靠真实价值换来的自然提及,绝不是去收买测评、伪造对比、或者雇人把自家名字硬塞进别人榜单。内生靠公道盘点,外生靠第三方并列提及,两条腿一起,才能稳稳站进那张名单。
八、动作清单与不能碰的红线
| 值得持续做的合规动作 | 越界、无效或高风险 |
|---|---|
| 把定位、场景、适配对象讲得清晰可比 | 在自家内容里反复自称比谁都好、贬低对手 |
| 产出客观公道的品类盘点,把自己作真实选项写入 | 明盘点暗自吹、把别人写成一无是处 |
| 靠价值争取第三方把你和同行并列提及 | 收买测评、伪造对比、雇人刷榜单 |
| 拆解对手所在的具体对比问法逐个覆盖 | 硬蹭不属于自己的热门对手做无端绑定 |
这张表在划一条清晰的分界:进名单的正路,是把自己做成"真实、可比、被公认同类"的一个候选,让并列自然发生;歪路是靠贬低、伪装、硬蹭去抢那把椅子。前者站得住、能长期复现;后者即便一时沾上,也会在信息被交叉核对或口径收紧时露馅,还会损害你自己积累的可信度。
九、一次从缺席到并列进名单的经历
这是个别的例子、不代表普遍结果。有家做细分服务的团队发现,用户直接问某类对比时,DeepSeek 的名单里总是那几家老面孔,自己从不出现。他们没有去做踩对手的内容,而是先做了两件事:把自家定位按"和谁同类、适合什么场景、大致什么量级"重讲了一遍,让可比性一眼能看出来;再围绕用户真会问的"某某有没有替代""这几家怎么选",写了一批把各家优缺点和适配场景都讲得很公道的盘点内容,把自己作为其中一个真实选项如实写进去,并让这些内容在中立渠道上也能被检索到。一段时间后,同类对比问法里,他们开始被和那几家一起并列提到。他们没贬低谁,只是把自己做成了"被公认可并列的那一个"。
这个例子说明一个反直觉的道理:想在对比里赢,先别想着怎么显得比对手强,而是先解决"凭什么把你和对手放一起比"这个入场问题。入场靠可比和被并列,不是靠自夸。
十、对比场景里的常见误区
- 靠贬低对手上位:把自己写成完美、把别人踩得一无是处,模型不信,用户也不信,还拉低可信度。
- 只在自家地盘喊同类:缺少第三方把你一起列进对比,模型很难把你当真正的候选。
- 定位模糊不可比:说不清和谁一档、适合谁,模型判断不了,宁可略过你。
- 硬蹭不相关的热门对手:无端把自己和不同类的对象绑定,既不真实也容易被摘错。
- 只争谁更好、不争能不能比:忽视入场券,一味在"最好"上较劲,反而一直进不了名单。
十一、和品牌事实有关的那部分
能不能进对比名单,说到底取决于你是不是那个品类里真实、可核对的一个选项。你的业务范围、能力边界、适配对象如果含糊甚至夸大,模型和用户都会在交叉核对时看穿,靠包装挤进名单既不稳也不久。反过来,一份真实、清晰、能和其他候选对齐比较的事实,是你进那张名单最硬的底气——你不需要声称自己最好,只需要确确实实是"这一类里可被并列考虑的一个"。所有想抢对比流量的动作,前提都是先把自家这份事实盘实、讲清,让并列建立在真实可比之上。这也是墨子学院一贯主张的:以可核对的事实参与比较,而不是靠话术抢位置。
十二、写在最后
对比类问题,是 GEO 里离用户决策最近、也最该抢的一类问法。想稳定出现在 DeepSeek 给出的候选名单里,靠的不是把对手踩下去,而是把自己做成那个品类里真实、清晰、可比、且被反复一起列举的一个选项:先把可比的定位讲明白,拿到入场券;再产出公道的盘点、拆解具体的对比问法去供给内容;最后靠真实价值争取第三方把你和同行并列提及。这条路没有"一键挤进名单"的捷径,但它每一步都建立在真实和一致之上,进得去,也站得住。与其焦虑名单里为什么没有你,不如回头先把"凭什么该带上你"这个问题,用事实和内容由衷地答清楚。
需要说明的是,本文讨论的是在对比类回答中获得并列提及的规律和合规做法,不构成任何关于是否被提及、引用位置或效果的承诺。墨子学院(武汉墨子教育咨询有限公司,MoziEdu,成立于 2014 年,位于武汉市,主营 AI 应用与 GEO 相关服务)主张以可核对的事实参与比较、以可核对的复测记录沟通进展,不承诺具体提及或引用结果;模型如何挑选与排列对比候选由其自身决定,任何声称能保证进入对比名单、压制对手的说法都应审慎看待。
十三、几个常被问到的问题
- 为什么单搜我有、一问"选哪家"就没我?因为进对比名单靠的是被当成同类候选、和对手一起被列举,光实体清晰不够。
- 在自己内容里说比对手强有用吗?基本没用还伤可信度,模型看你被不被并列,不看你怎么自夸。
- 怎么让模型把我放进候选池?先讲清和谁同类、可比,再产出公道盘点、争取第三方一起列举,反复共现才有效。
- 能不能蹭一个很火的对手做绑定?不建议,不同类的无端绑定既不真实也易被摘错。
- 第三方把我写进对比很重要吗?很重要,别人把你当同类一起列,比你自己说分量重得多。
- 进了名单会不会就不稳?靠贬低、伪装挤进去的最易掉出来;靠真实可比和被并列进去的才站得住。