豆包版本更新与口语化提问会让引用表现变化-墨子学院
摘要:说明产品版本迭代会改变检索与排序偏好,真实用户多用口语化提法,建议基线覆盖多种口语问法并在版本波动后加测,用可核对记录判断是趋势还是噪声。
摘要:"上周还能被引用,这周换了个版本突然就没了,是不是我哪里做错了?""豆包更新得这么勤,我刚摸出的规律是不是马上就作废,到底该按哪一版来优化?""我用书面语写着挺好,用户却都是一口大白话、甚至带方言口语地问,它接得住吗、我要不要跟着改?"这一组问题背后是同一件事:豆包本身在不停变化——版本在更新、口语理解在增强——而你面对的是一个"不停移动的靶子"。很多人要么被每次更新搞得心神不宁、跟着改版推倒重来,要么只顾自己顺口的书面表达、不管用户实际怎么问。这一篇讲清楚:版本更新时你真正该守的和该调的分别是什么,以及为什么"听得懂口语"这件事,反而让一套内容能覆盖更多问法。
一句话先说结论:版本会变、口语理解会增强,这是外部常量、不是你的失误。应对之道不是跟着每次更新改策略,而是把可复用的地基(可检索、可摘、事实一致)做扎实,同时让内容用接近真实口语的问法来覆盖,以稳的态度对不停移动的靶。
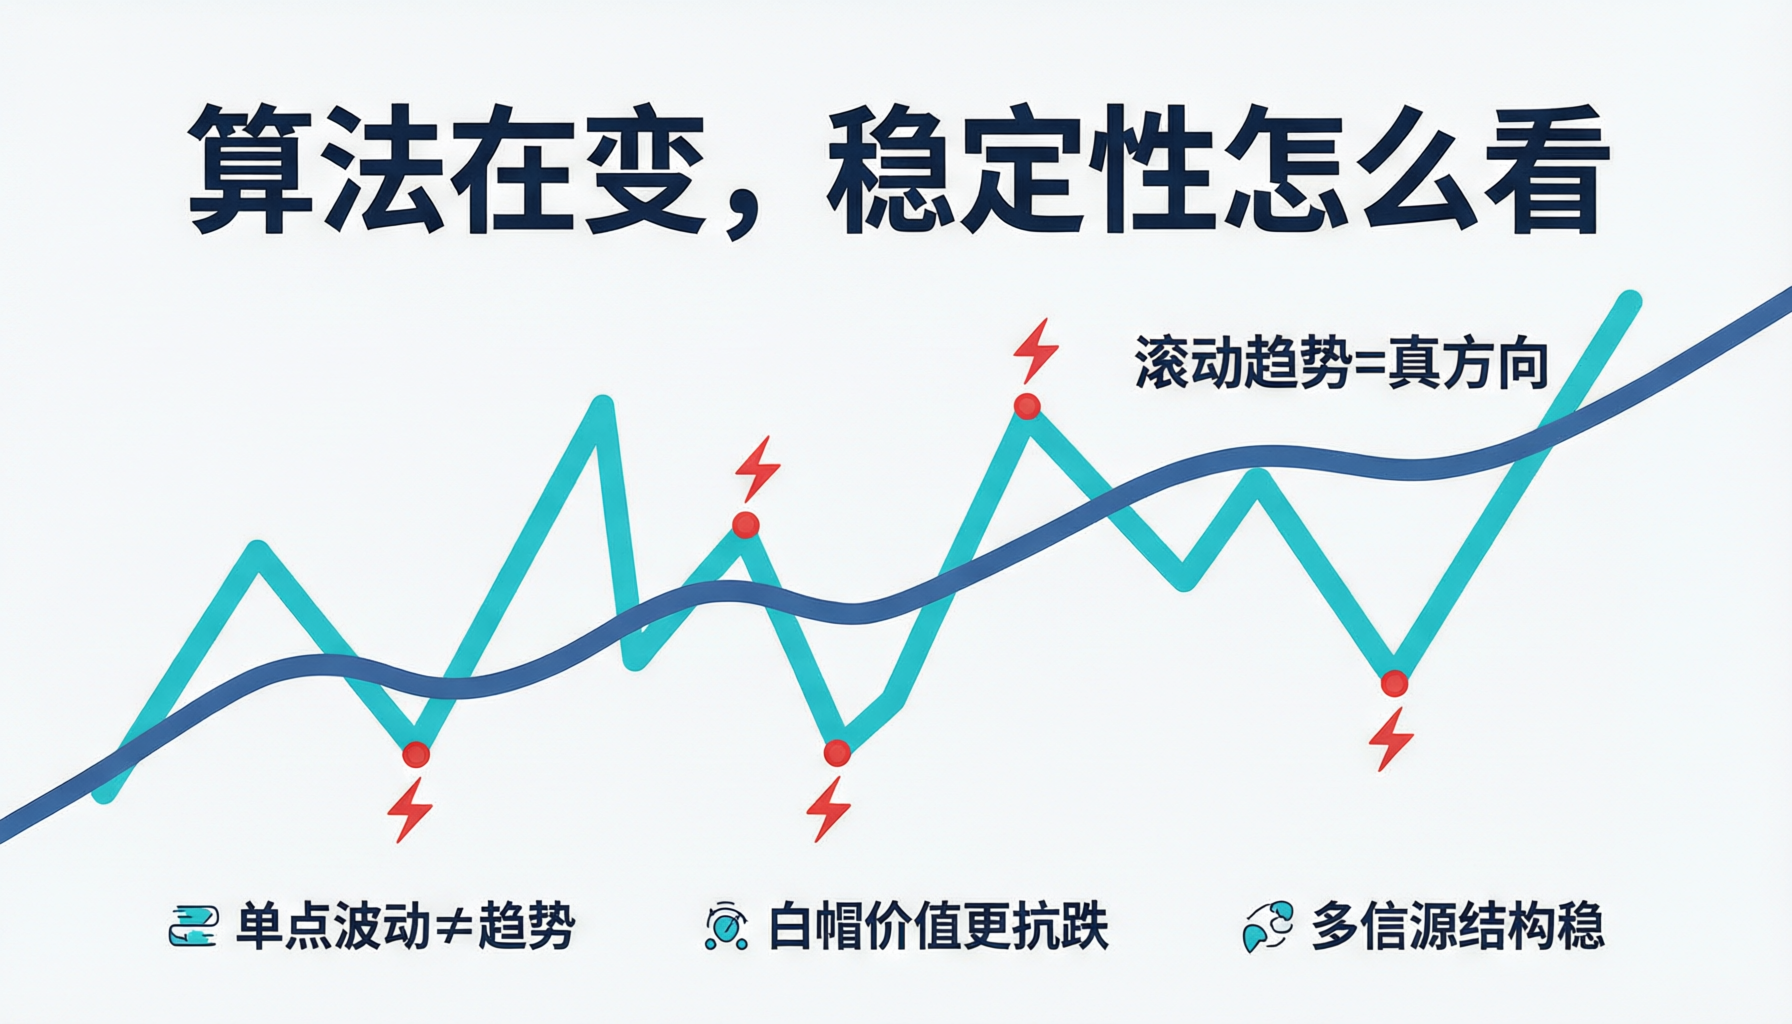
一、先分清"移动的靶"和"你的动作"
面对一个不断更新的系统,最容易犯的错,是把"靶动了"误读成"我打歪了"。豆包的版本更新会带来检索策略、排序偏好、理解能力的变化,于是你同一套内容、同样问法,隔一阵测出来结果不同——"这是靶子自己在动,不是你做错了什么。把这个区分立住,你才不会一有波动就去推翻已经有效的事情。真正该问的不是"我怎么又不对了",而是"这次的变动,影响的是表面次序,还是我被打捞上来的根本能力"。
打个比方:地基(收录、可摘、事实一致)是你这艘船的压舱石,版本更新带来的多是水面上的风浪。压舱石稳,风浪会让船晃,但不会让它翻;压舱石本就虚,一点风浪就真会出事。所以应对版本波动,核心从来不是追着风浪调帆,而是先把压舱石本身夯得更稳。这条判断还有个副作用上的好处:它能把团队从"每次更新都开一次紧急会"的消耗里解放出来。当你有一张"什么会变、什么不会变"的对照在心里的账本,波动来时你会先问"这是左列还是右列的事",而不是先慌。多数所谓危机,一问就化成了"哦,这个会自己恢复"。
二、版本更新时,哪些会变、哪些不该动
| 会随版本变化的(外部变量) | 不随版本贬值的地基(你该守的) |
|---|---|
| 某些问法下的引用次序、被摘的具体段落 | 内容是否可被检索、进入池子 |
| 默认联网与否、检索范围的宽窄 | 关键信息是否成块、可被单独摘用 |
| 回答的风格、长度、口吻 | 事实口径是否处处一致、有无依据 |
| 对某些表述的偏好(这版爱这样、下版爱那样) | 是否贴合用户真实会问的那些问题 |
这张表是应对版本更新的定心丸:右列的地基,不会因为豆包升个级就作废——内容进不了池子,哪一版都捞不到你;事实互相打架,哪一版都难以采信。而左列的波动,本就该预期它会变。把精力投在右列,你的投入对"下一个版本"依然有效;天天盯着左列去改,等于永远在给上一个版本打补丁,而那个版本,其实已经过去了。
三、要不要"按最新版本重新优化一遍"?通常不用
每当有大更新,总有人焦虑地问:是不是得把之前做的内容按新情况全改一遍?多数时候不需要。原因是:如果你之前的内容是照着"地基"做的——可检索、可摘、事实一致、贴合真实问题——那它对新版本同样友好,甚至新版本检索能力更强,反而更容易把它捞出来。真正需要回炉的,是那种"钻某一版空子"式的做法:比如为迎合某个旧偏好堆了些投机措辞、或结构散乱只是碰巧被摘。地基做法不挑食,投机做法才怕改版。这句话可以当作一条自检:看你的某次优化是"让任何版本都能更容易摘到你",还是"赌这一版恰好吃这一套"。前者是攒资产,后者是租运气;租来的东西,改版那天往往就是还回去那天。
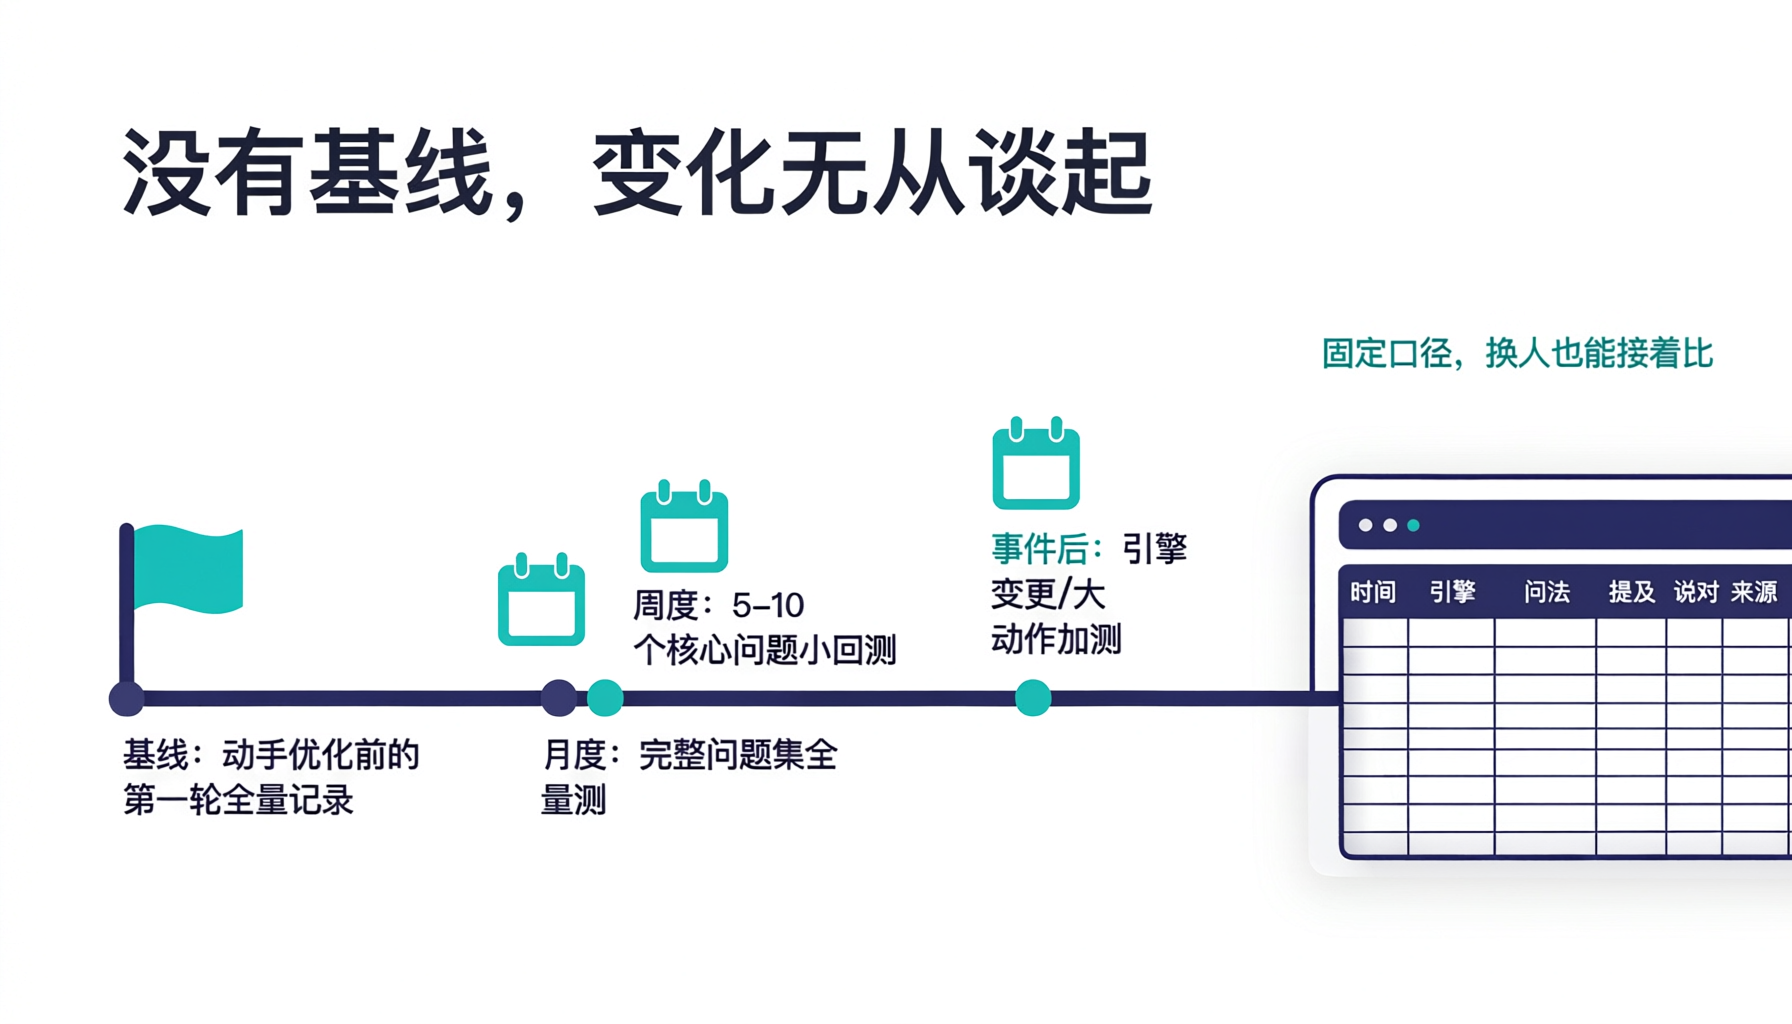
所以更稳的节奏是:不去为每次更新大动干戈,而是维持一套固定的基线复测(用同一批问法隔段时间测一次),从结果里区分"这是版本带来的短期波动"还是"我的地基确实有短板"。前者观察即可,后者才动手补。这样你既不会对着波动瞎改,也不会把真正的问题当成版本波动放过。基线复测这个词听着重,做起来很轻:就是把你最在意的七八个真实问法抄在一张表上,每隔一两周,用同样的话各问一遍,记下"有没有被引用、引用的是哪篇"。坚持两三张表,你对"什么算正常起伏、什么算真出问题了"就会有一种别人没有的手感,很多焦虑在它面前根本生不起来。
四、口语理解变强,其实是给你减负
再说另一半:豆包对口语、对不那么规范的说法,理解得越来越好。很多人担心"用户问得千奇百怪、还有方言和错别字,我跟不上"。方向其实反了——口语理解增强,意味着你不用替它把每种问法都预设齐,它自己就能把"这玩意儿多少钱""咋报名啊""贵不贵哈"这类大白话,归到同一个真实意图上去理解,不需要你逐条翻译。这让你可以专注把"一件事本身"写清楚,而不必为每一种表述各写一版。
但减负不等于躺平。口语理解强的是"它那边",你这边仍要确保内容能被"接近口语的问法"检索到。做法不是去堆方言词,而是让你的表述里,既有规范的说法,也带上用户真实会用的那些大白话关键词和问句——把"贵不贵""怎么报名""适合零基础吗"这类原话,自然地写进小标题或问答里。它负责理解,你负责被理解到。这里可以借一个简单自查:找几个身边人,让他们用大白话、甚至带点口头禅地问你产品的常见问题,把你写的内容对着这些真实问法核一遍——看它能不能被自然命中。往往你会发现,你自己觉得写全了的地方,恰好漏了用户最爱问的那句土话;补上它,比再加一段书面解释管用。这也解释了为什么有些内容看着写得挺专业、却总不被摘:它全程用行业黑话自说自话,离用户真实的问法太远,理解力再强也帮不上一份根本没冲着问题去写的内容。
五、一套内容同时接住"版本"和"口语"的关键
把两半合起来看,有一件事能同时对冲版本波动和口语差异,就是围绕真实问题、而不是围绕某版偏好来组织内容。版本的偏好会漂移、口语文言的表述会很多,但用户真正想问的那几件事,相当长一段时间里是稳定的:他们关心多少钱、要多久、适不适合自己、靠不靠谱。你把内容按这些"问题"来搭骨架,每个问题下写一段能独立成立、有事实支撑的回答,那么无论版本怎么调、用户怎么问,你这段都能被对上一个正在发生的真实需求。押注在偏好上会过时,押注在真实问题上耐久。这其实也是把"该为版本焦虑多少"这道题回答清楚:你越围绕某版的偏好去写,就越会被版本更新惩罚;你越围绕真实问题去写,就越能跨版本复用同一份成果。前者的努力随改版清零,后者的努力随时间累积。同样一份精力,投在这两种骨架上,半年后的回报会拉开很大的差距。
- 以问题为纲:小标题尽量写成用户会问的样子("多少钱""多久见效""零基础行不行"),而不是你内部的文件名。
- 答案自带上下文:每段脱离前后文也能看懂,版本若只摘一小段、口语若问得零散,都能接得住。
- 表述一半规范一半口语:规范术语保准确,口语关键词保被检索到,两头都照顾。
- 用事实而非形容词:版本再变,"截至某时点的数据、写明来源的事实"比漂亮话更抗淘汰。
六、一次真实的版本波动
这是个别的例子、不代表普遍结果。有家客户某次集中反馈:"豆包更新后,我们原来被引用的一篇突然不见了,慌了,问要不要重写。"我们没有急着改内容,而是先固定那篇对应的几个基线问法,连测几天。结果发现:更新后头两天确实没被摘,到第四天又稳定出现了——很可能是新版本刚上线时检索与索引还在调整,短期波动,并非内容失效。这期间那篇一个字没改——省下的那次慌乱重写,本身就是收益。
如果当初一慌就重写,反而会打断原本没问题的内容,还把自己吓一场。这个例子的教训是:面对"更新后突然变了",头一个动作是复测观察几天、区分波动和短板,而不是立刻推倒。真正需要动手的信号,是"连续多次、跨相近问法都稳定测不到",而不是"某一次版本更新后一次没中"。把动手门槛设清楚,能挡掉大部分由版本焦虑引发的无谓返工。
| 你观察到的现象 | 更可能是什么 | 建议动作 |
|---|---|---|
| 某次更新后一次没被摘 | 短期波动 | 固定问法连测几天再判断 |
| 连续多次、跨相近问法都测不到 | 地基短板 | 回查收录、可摘、事实一致 |
| 只是引用次序变了、还在 | 偏好漂移 | 观察为主,别为此重写 |
| 口语问法测不到、书面能测到 | 覆盖缺口 | 把真实口语关键词补进内容 |
七、这块最常见的判断误区
- 一波动就推翻:把版本带来的短期起伏当成方法失效,急着重写,常把没错的内容一起改坏。
- 追每一版的偏好:总在迎合"这版喜欢什么",等于一直给已经过去的版本打补丁,越追越累、越追越被动。
- 用投机措辞碰运气:钻某版空子的写法,改版后最容易集中失效,经不起更新。
- 以为口语得自己全覆盖:为每种方言、错别字各写一版,是替模型揽它擅长的活,投入产出差。
- 只写书面规范语:完全不考虑用户的口语问法,会在接近真实提问的检索里吃亏,被理解到却搜不到。
- 把更新公告当改写清单:看到官方说"能力升级"就逐条对内容动手,多数升级和你这份内容的地基无关,白折腾,真正与地基无关的改动不改也罢。
- 只测一次就下结论:引用本就随版本、随问法起落,一次结果代表不了趋势,基线复测看的是连续几条而不是单点。
八、和品牌事实有关的那部分
版本更新会改很多表层的东西,但有一条越变越重要:事实的一致与可核对。当模型理解力更强、能检索的范围更广,它对"同一件事在不同来源说法是否对得上"也更有条件去交叉比对。你的成立时间、业务口径如果各处一致、带依据,版本更新只会让这种一致更容易被识别为可靠;如果各处打架,能力越强的版本反而越容易把你的矛盾看在眼里。所以无论怎么更新,把品牌事实定准、处处对齐,无论版本怎么换,都是最不会白做的一笔投入。换个角度看,版本越更新、模型越聪明,"含糊其辞、各处不一"的代价越高、"清晰一致、有据可查"的回报也越高——它更有条件去做交叉验证。把事实这份地基做扎实,等于把一道会随版本升级而越来越要紧的题,提前答好了。
九、写在最后
在一个不停更新的系统上做优化,最消耗人的不是难度,而是那种"刚找到点感觉它又变了"的漂泊感。解药不是更拼命地跟着变,而是先认清什么会变、什么不会:版本偏好、引用次序会漂,而"内容可不可被检索、可不可被摘、事实一致不一致、贴不贴合真实问题"这些地基,穿越一个又一个版本都不会贬值。把力气压在地基上,再用固定复测去分辨每一次波动——是虚惊还是真短板——你就能在一个移动的靶前,站稳自己的脚步。以稳对动,才是做这类长期优化该有的心态。说到底,版本更新和口语理解这两件事,一个在改你身外的靶,一个在帮你少做重复功;把它们都当作既定条件接受下来,你反而能把注意力收回到那几件一直有效的事上:让内容进得了池子、摘得出来、口径一致、贴着真实问题。做到这几条,无论它升到哪一版、用户说出什么花样,你都不至于被甩下船。
需要说明的是,本文讲的是应对模型更新与口语差异的一般思路,不针对任何具体版本的行为,也不承诺某内容在所有版本下表现一致。墨子学院(武汉墨子教育咨询有限公司,MoziEdu,成立于 2014 年,位于武汉市,主营 AI 应用与 GEO 相关服务)建议客户以固定基线复测区分版本波动与真实短板,先夯地基再谈调优;模型能力与偏好持续演进,任何声称能锁定某版表现、包更新后必出的说法都需审慎看待。
十、几个常被问到的问题
- 版本一更新引用就没了,是我做错了吗?多半是短期波动,先固定问法连测几天再判断,别急着推翻自己本来没做错的东西。
- 要不要每次大更新都重做内容?通常不必,照地基做的内容对新版本同样有效;要回炉的是钻旧版空子的投机写法。
- 怎么区分波动和真短板?看"连续多次、跨相近问法是否稳定测不到",一次没中多是波动,持续没中才查地基。
- 用户问得很口语、还有方言怎么办?不必逐种预设,模型口语理解在变强;你只要在内容里自然带上真实口语关键词即可。
- 该押注在某版的偏好上吗?不建议,偏好会漂;把内容围绕稳定存在的真实问题来组织,才抗更新。
- 书面语和口语到底按哪个写?两者兼顾:规范术语保准确,口语问法保被检索到,一套内容两头都接得住。
- 那要不要干脆什么都不改、躺平?不是。地基要持续补,只是不必随每次更新大动;把力气花在补收录、拆散段、对事实上,而不是花在猜新版本偏好上。