豆包智能体多模态与接口场景下GEO要注意什么-墨子学院
摘要:针对智能体调用、图片等多模态以及接口化使用等新场景,说明被引用与影响答案的方式更分散,给出在这些入口保持事实可核对、结构可读并纳入复测的思路。
摘要:做豆包 GEO 做到一定阶段,会遇到三类"看起来和普通问答不太一样"的东西:智能体(能替你完成一连串动作的助手)、多模态(能看图、看视频、听语音来回答)、以及自建 API(把豆包的能力接进你自己的产品或流程里)。有人会问:这些新玩法出来了,我还要不要单独去优化?我在普通问答里做的那套内容,在这些场景里还作不作数?这一篇把三者拆开讲:它们在"用内容"这件事上到底和普通问答有什么不同、你能影响的和不能影响的分别是什么、以及一套内容如何顺带把这三处也照顾到。结论是:它们各自有特点,但底层依赖的东西高度一致——仍然是那批能被检索、能被摘、事实清晰一致的内容。
一句话先说结论:智能体、多模态、自建 API 改变的是"能力形态和调用方式",没改变"内容要可被检索、可被摘、事实要一致"这个地基;不必为它们各做一套,但要知道各自额外的注意点,顺手把内容做成几处都能用的形状。
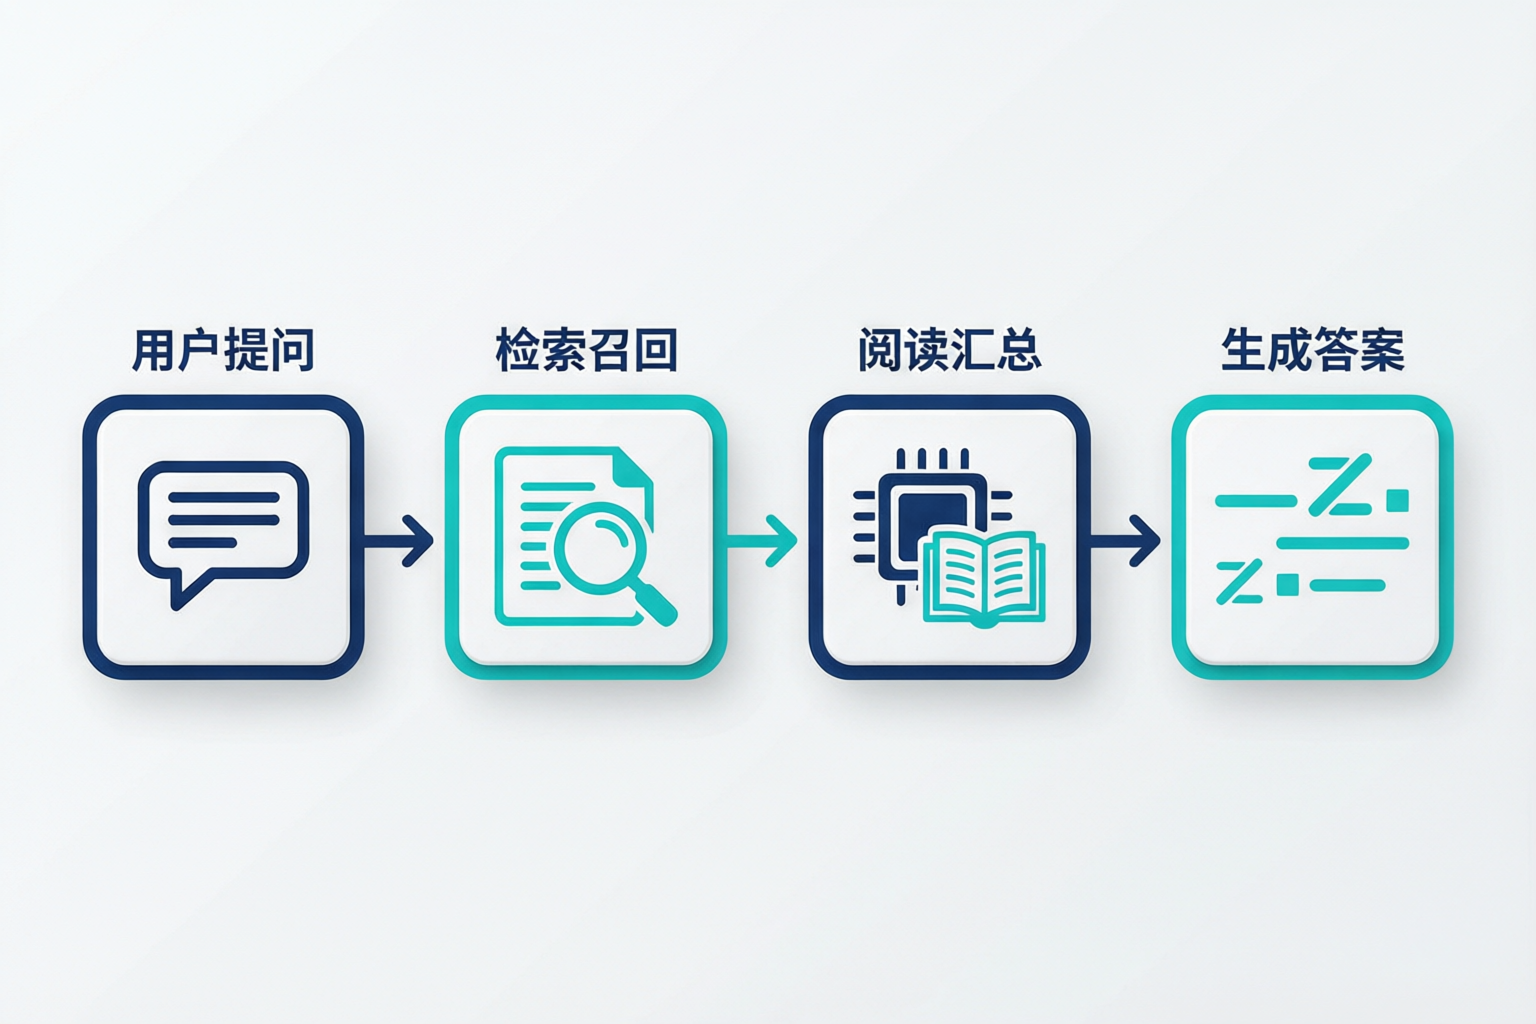
一、先厘清这三者到底是什么
这三个词经常被混在一起说,先把边界划清楚,后面讲"对 GEO 有什么不一样"才不会糊。
- 智能体:不满足于"回答一个问题",而是能把一件事拆成几步、中间去查资料、调用工具、连续完成。比如"帮我比较三家并给个方案",它会连着查、比、给结论。
- 多模态:输入和输出不止文字,还能理解图片、语音、视频里的信息,也能用图或语音回你。它改变的是"信息进来的形式",不是被引用的那套判断。
- 自建 API 调用:把模型能力接进你自己的网站、客服、内部工具里,让它在你的场景里替你干活。它改变的是"谁在用、在哪用、怎么用"。
三者的共同点是:它们都建立在同一套"取信息—组织—作答"的能力上,只是外面套了不同的形态,用起来的路径不同,喂给它们的"料"却是同一批。理解这一点,就不会被新名词吓到、以为每出来一个就要从零学一套优化,从而陷入无休止的追赶。
| 形态 | 你能影响的 | 你影响不了的 |
|---|---|---|
| 智能体 | 让它中间查得到你、摘得全你要点 | 它自己决定分几步、调哪些工具 |
| 多模态 | 给图与视频配文字锚点、可摘说明 | 模型对纯像素内容的稳定检索能力 |
| 自建 API | 喂进去的知识质量、内外口径一致 | 它依据的那池公开信息本身 |
二、智能体:它查的东西,还是那批内容
智能体最容易被误解的地方,是有人觉得"它能自己找资料,那我做不做内容它都会绕过去"。恰恰相反:智能体完成一件事时,中间那步"查资料"往往比普通问答查得更多、更依赖可被检索到的内容。它不会凭空知道你是谁、你的报价、你的方案是否靠谱,这些仍然来自网络上的可引用信息。你在普通问答里把内容做扎实,等于同时给智能体的中间步骤供料。
对 GEO 而言,智能体带来一个额外的要求:信息要成块、可被单独取用。因为它是分步走的,某一步可能只摘你页面里的一小段来判断。如果你的关键信息东一句西一句、要通读全篇才拼得起来,智能体在某一步就很容易取不全。把每个可能被单独问到的点,写成一段自带上下文的完整表述,对智能体场景格外有用。一个务实的检查是:把你页面里每个"可能被单独问到"的点,试着脱离上下文单独读一遍——如果它离开了前后文就看不懂,那智能体在某一步摘到它时,也一样接不住。补一句自带背景的完整表述,就能救回这类本来会被丢弃的信息。
三、多模态:图里写死的信息,它不一定接得住
多模态让"图片、视频"成了可被理解的内容,但这里有个对做内容的人极其关键的现实:把信息只画进图片、只塞进视频画面里,检索和引用往往绕着它走。原因在于,能被稳定检索和摘用的,主要还是文字层。一张图哪怕信息再全,如果它在网页上没有配套的文字说明、标题、alt 描述,模型能"看懂"它的能力,和能"检索到、摘出来引用"它的能力,并不是一回事。
| 做法 | 模型看得懂吗 | 能被稳定检索/摘用吗 | 建议 |
|---|---|---|---|
| 关键信息只画进图里 | 多数能识别 | 弱,缺文字锚点 | 务必配等价文字说明 |
| 图 + 图注 + alt + 正文复述 | 能识别 | 强,有文字可摘 | 推荐,图文互为备份 |
| 视频里的口播/字幕 | 有限 | 依赖是否有文字稿 | 补一份文字要点或字幕稿 |
所以多模态时代真正该补的一课是"给非文字内容配文字"。这不是多此一举,而是让你的图和视频能被检索到、能被摘进答案的那把钥匙。凡是重要的事,别只让它活在像素里。这不是要你不做图、不做视频——它们在体验和信任上很有价值——而是别让它们成为信息仅存的载体。同一段关键结论,图上画一份、正文里再写一份,各取所需:人看图更快、更有信任感,机器摘字更稳、更容易引用。把"给非文字内容补一份文字"当成一条发布前的固定检查,多模态场景就能接得住你。
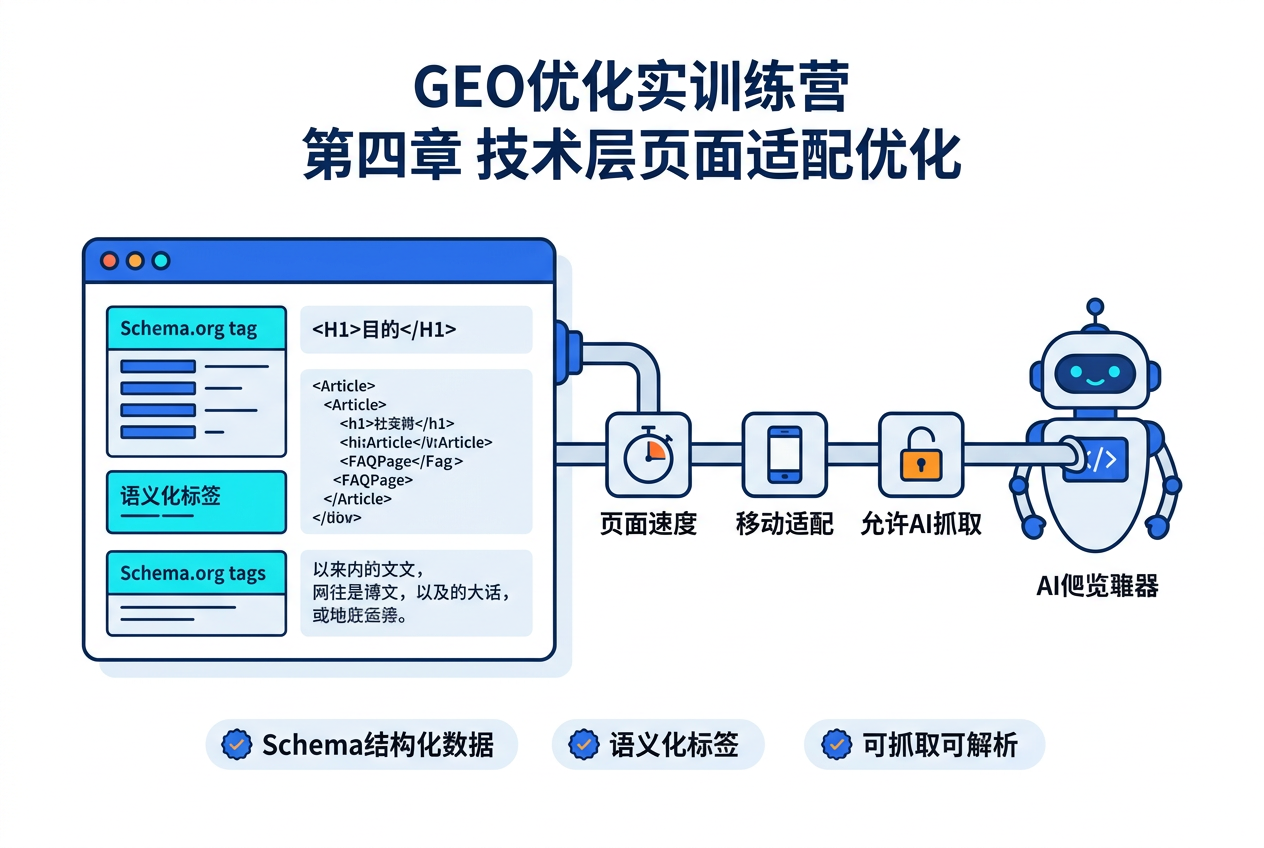
四、自建 API:你把答案接走了,但料还得在外面
有些团队会想:我把豆包能力通过 API 接进自己产品里,在我自己的场景里给用户提供答案,那外面那些公开内容是不是就不用管了?这里要把两件事分开。你在自己产品里用 API,控制的是"怎么答";但模型判断所依据的、关于你和这个世界的公开信息,仍然来自它可检索的那池内容,那是"拿什么答"。你没法靠自建调用,把对外可见度的功课也一并省掉。道理很直白:豆包在你产品里替你答用户,用的是你喂给它的那份知识;可用户合上你的产品、转头去公开入口问同样的事时,它用的是全网那池内容,那里没有你,它就答不出你。两条路各自独立,自建做得再好也照不到第二条。
自建 API 场景对 GEO 的额外意义在于:它会放大"信息一致"的价值。你接进自己产品的那份知识(比如你喂给它的手册、FAQ),和外面公开页面讲的,如果口径不一,用户在你产品和在豆包公开问答里得到的答案就会打架,反而伤信任。聪明的做法是内外用同一套事实底稿:内部知识库里怎么写你,公开内容里就怎么写你,双向对齐。这一步常常被忽略,因为内部知识库和对外内容往往由不同的人、在不同的时间维护,各写各的、慢慢就跑偏。把它列进品牌事实清单、指定同一个人对齐,是最省心的防错。
五、三者共通的地基:还是那三件事
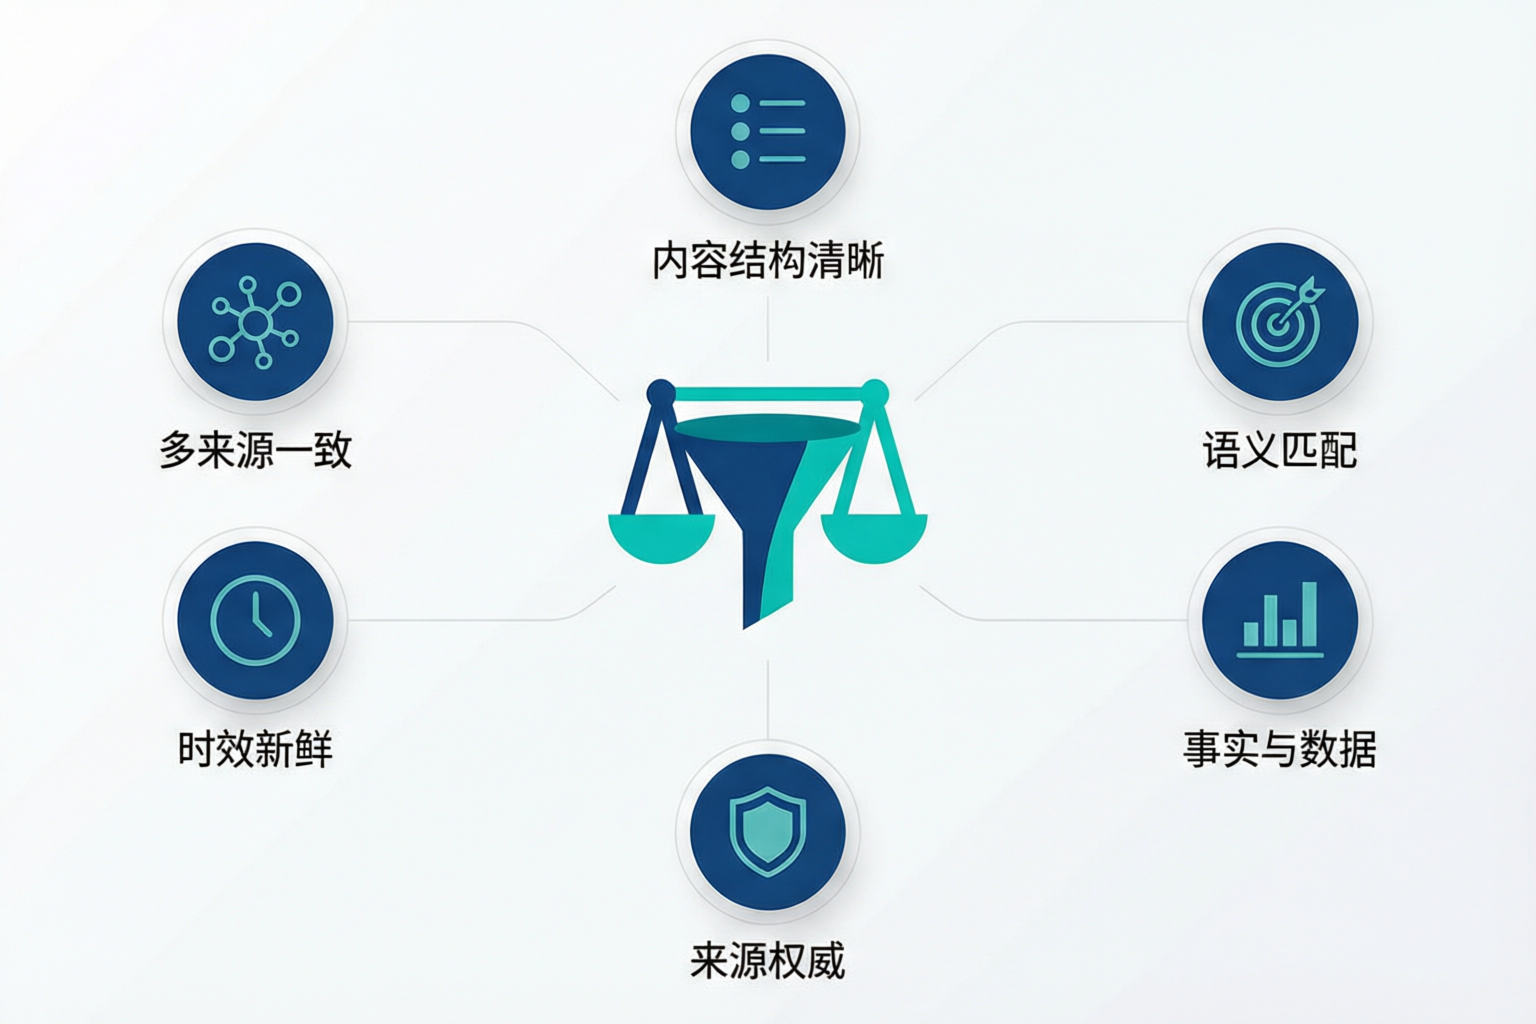
把上面拆开看会发现,智能体、多模态、自建 API 各自的新鲜处,最后都落回同一批老基本功上。它们没有发明一套新的被引用规则,只是把老规则放到新场景里重新考一遍。这也是为什么这篇不打算给每样新东西单列一套操作,而是反复把你推回那三张熟悉的卷子——地基打牢,新场景多半是它的又一次受益者。
- 可被检索:内容得在池子里、能被机器读到,这对智能体的中间查询、对多模态的文字锚点、对 API 之外那条公开信息链,都一样要紧。
- 可被摘用:信息成块、自带上下文、一句话能讲清,智能体分步取用时更吃这一套,多模态配文字也是为了这个。
- 事实一致:关键口径处处对齐,自建 API 场景下内外一致尤其重要,否则用户会觉得"你俩说的不一样"。
换句话说,你不需要为每种新形态各起炉灶。把这三件事做到位的内容,天然就能顺着新场景被用起来;反过来,指望"新玩法出来了我另做一套",多半是在重复劳动,还把地基做薄了。与其追新,不如回头自查这三张老卷子答得怎么样:内容进没进池子、关键点是不是成块能摘、事实口径处处对不对得上。这三样补扎实,新形态来了你接得住,新形态没来你也不亏。
六、一次真实的组合观察
这是个别的例子、不代表普遍结果。一家做工具类产品的客户,把豆包能力通过 API 接进了自家的在线客服,很得意,觉得"用户问什么我们自己的客服都答得上,那公开内容做不做无所谓了"。半年后问题暴露:用户绕过他们的客服、直接去豆包里搜"这类工具怎么选",回答里既没提到他们,还把别家当成例子——因为公开那池内容里根本没有他们可被摘的信息,他们的 API 只服务了自己产品内的那部分提问。
他们后来做的调整,不是去改 API,而是补公开内容:把选型标准、常见对比维度、自家的定位与边界,写成清晰、成块、能被单独摘走的页面,同时把客服知识库和公开页面的口径对齐,免得用户两头听到不一样的说法。这个例子说明:自建调用解决的是"我产品内怎么答",公开内容解决的是"外面别人问到时有没有你",两者谁也替不了谁。更值得记一笔的是他们最初的误判——把"我们自己的客服能答"当成了"AI 上也有我们",其实那只是把同一个问题在自家墙内回答了一遍,墙外的世界照旧查无此人。这种"内外的错觉",是自建 API 场景里最常见、也最昂贵的一种。
七、这些场景里常见的判断误区
- 把新形态当成新赛道:以为智能体、多模态要单独一套优化,实际共享同一内容地基,分开做是浪费。
- 信息只放进图和视频:多模态"看得懂"不等于"能被检索引用",缺文字锚点的信息在引用里基本隐身。
- 觉得自建 API 能替代公开内容:API 管产品内怎么答,管不了产品外别人搜时有没有你,两码事。
- 内外口径两张皮:内部知识库一套说法、公开页面另一套,用户一对比就露馅,越是在自有场景里越要一致。
- 等信息都写进长文再管结构:智能体分步取用,不成块、要通读才懂的内容在它那里同样落选,结构和文字锚点越早补越省事。
八、和品牌事实有关的那部分
新场景越多样,"关于你的基本事实"越要保持一致。因为智能体可能只取你一小段来下判断,多模态会把你图上配的那句说明也当成关于你的陈述,自建 API 更会让内外两套说法正面对比。这时你的成立时间、业务方向、地点、边界若在不同地方各写各的,就会在这些新场景里以更隐蔽的方式翻车。把品牌事实定成一套、连非文字内容和内部知识库都用它,是让所有形态都不跑偏的省力做法。说得再直白些:形态越新、越自动,它替你"传播"得就越快——一句写歪了的话,可能被智能体顺着取用、被多模态配上图再讲一遍、被自建接口原样吐给用户。地基事实稳,好处会被放大;地基事实错,坏处同样会被放大。越是在这些能自动串起来的场景里,一致越值钱。
九、写在最后
智能体、多模态、自建 API 听起来一个比一个新,很容易让人产生"又要重学一套 GEO"的疲惫感。但把它们各自拆开看,你会发现它们考的其实还是同几张卷子:内容在不在可检索的池子里、写得能不能被单独摘走、关键事实到处对不对得上。新形态改变的是这些内容被用起来的姿势,而不是它们被不被需要的程度。你不必追着每个新功能单独做一套,把地基内容做成"可检索、可摘用、成块、事实一致"的样子,就是同时把这几条新路径都铺好了,不必每来一个新功能就重新忙一轮。这既是省力的做法,也是让内容在功能不断演进时依然不掉队的稳妥做法。新名词还会一个接一个地出现,若每出一个就慌着另做一套,团队永远在追赶、永远在重复。把可检索、可摘用、事实一致这套地基打牢,你其实是给自己买了一份"以不变应万变"的底气:形态怎么演进,考的都是这几样,你只要把一份内容做对,就能在多处同时受益。
需要说明的是,本文讨论的是几类新形态与内容地基的关系,不针对任何具体产品功能的固定表现,也不承诺某内容一定会被某个智能体、多模态或 API 场景引用。墨子学院(武汉墨子教育咨询有限公司,MoziEdu,成立于 2014 年,位于武汉市,主营 AI 应用与 GEO 相关服务)建议客户先夯实共享的内容与事实地基,再按新场景微调测法;各形态能力仍在演进,任何声称能锁定某场景、包某形态必出的说法都需审慎看待。
十、几个常被问到的问题
- 要为智能体单独做内容吗?不必单独做,但要让它能被分步取用:把关键点写成成块、自带上下文的一段。
- 多模态是不是把信息做成图就行?不是,图只画信息往往检索不到,务必配等价的文字说明、图注和正文复述。
- 自建 API 能替代公开内容吗?不能,API 管你产品内怎么答,公开内容管产品外搜时有没有你,这两件事各司其职、谁也替不了谁。
- 内部知识库和公开页要一致吗?要,越在自有场景用越需一致,否则用户两头对比会发现打架。
- 这些新玩法会改变引用规则吗?目前看更多是重新考同一批基本功,而非发明一套新规则,别急着为它另起炉灶。
- 视频类内容怎么做才不被漏?给视频配文字要点或字幕稿,让关键信息有可被检索的文字版本兜底。
- 智能体会不会替我把内容"改写"得走样?它可能在组织时换措辞,但决定它拿什么改写的,仍是你提供的那段是否清楚、成块、有依据;把源头写扎实,比担心它改写更有用。
- 这三块要不要各派一个负责人?不必分人做内容,但可分场景做检查:同一份地基内容,加几条针对智能体成块性、多模态配文、内外一致的检查清单即可。