sitemap、robots.txt、llms.txt 到底怎么配?GEO 技术配置清单-墨子学院
摘要:三个文件分别管可发现、可抓取和对 AI 的说明,配错一处就可能让内容抓不到或抓得太乱。本文给出 sitemap、robots.txt、llms.txt 的作用边界、配置要点和上线前检查清单。
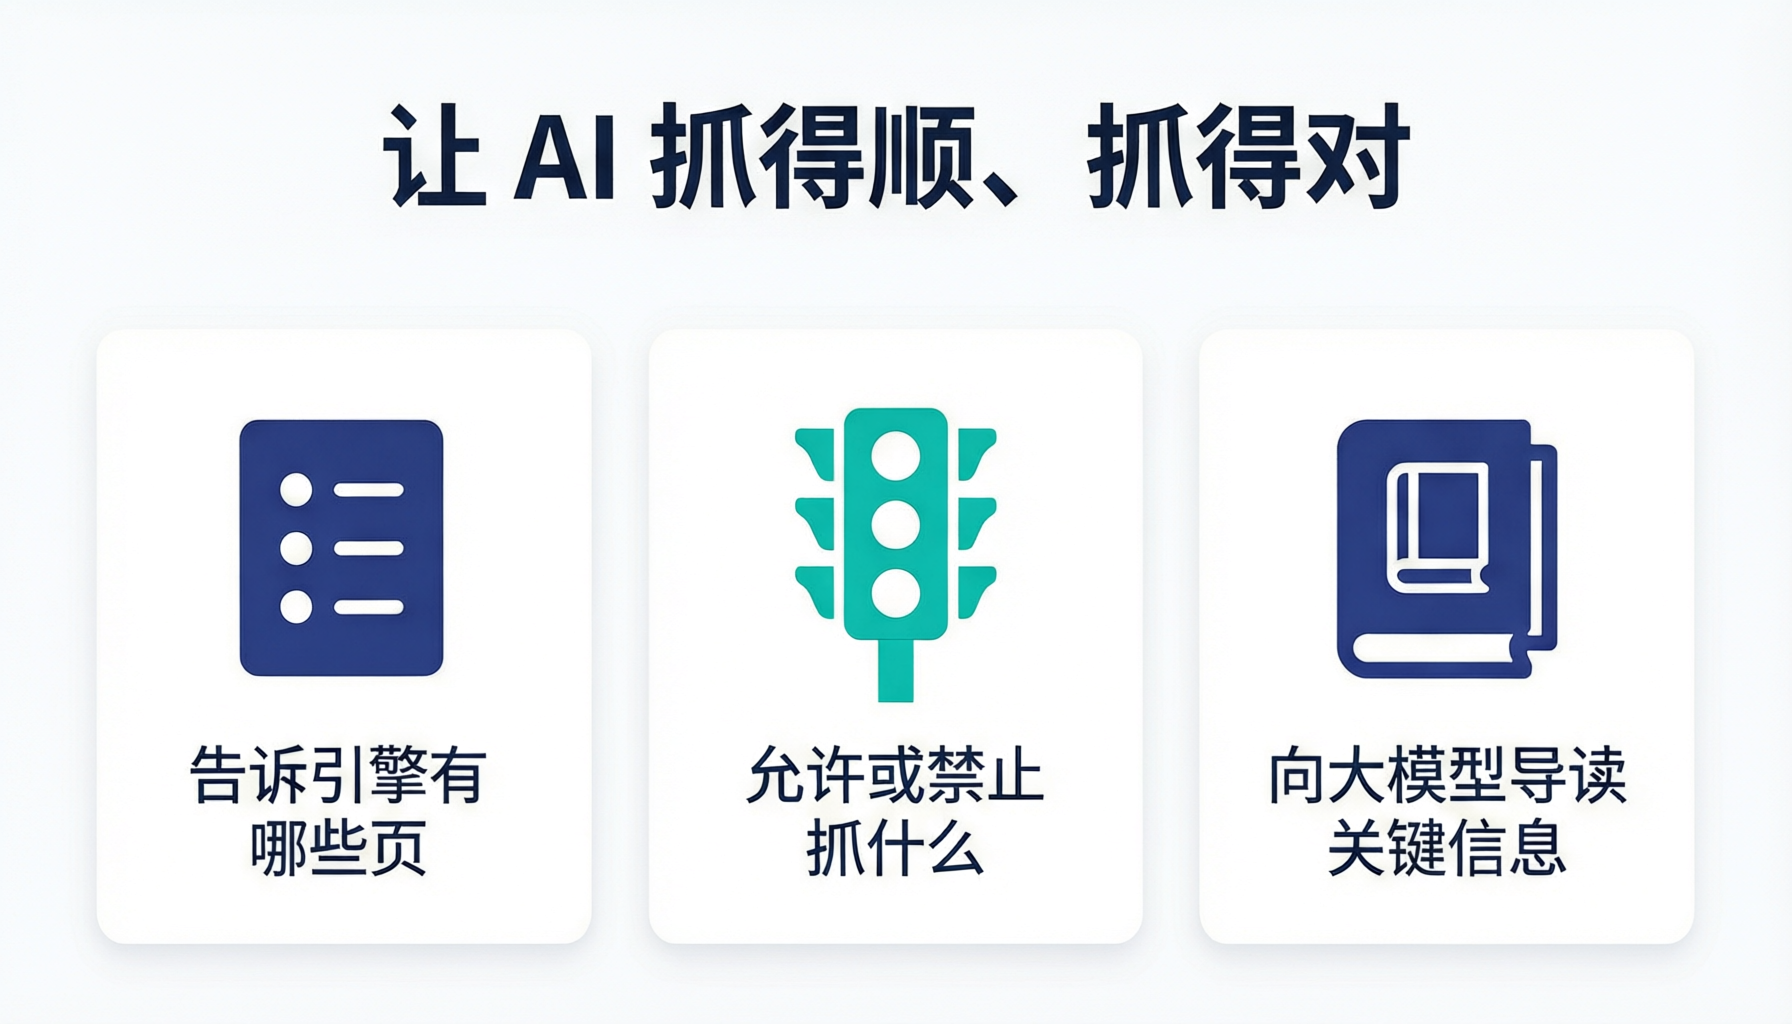
摘要:在内容之外,还有三个不起眼的小文件,悄悄决定着你写的东西能不能被机器顺顺当当读到——它们就是 sitemap、robots.txt 和 llms.txt。三者管的是三段不同的路:sitemap 管“可发现”(告诉引擎我有哪些页面),robots.txt 管“可抓取”(划清哪些能读、哪些别来),llms.txt 管“给 AI 的说明”(主动告诉大模型我的站点重点在哪)。它们平时没人注意,配错一处却可能让你精心写的内容要么根本没被发现,要么被挡在抓取之外,要么被抓得一片混乱。这篇文章把三个文件各自的作用边界、配置要点讲透,并给出一份上线前的自查清单。
一句话先说结论:三个文件不是越全越好,而是各司其职——先保证该被发现的内容真在 sitemap 里、没被 robots.txt 误挡,再考虑用 llms.txt 给 AI 递一份清晰的自述;顺序错了,再多配置也白搭。
一、先分清:三个文件各管哪一段路
不少人会把这三个文件混为一谈,觉得都是“放在服务器上、给爬虫看的那么个东西”。可它们的分工其实差得很远,只要把“发现—抓取—理解”这三段路先理顺,后面真正配置起来,也才不会张冠李戴:
| 文件 | 它解决的问题 | 一句话职责 | 面向谁 |
|---|---|---|---|
| sitemap | 可发现 | 告诉引擎“我有这些页面,别忘了来收录” | 搜索引擎与抓取方 |
| robots.txt | 可抓取 | 划一道线“哪些允许读、哪些别来” | 所有遵守协议的爬虫 |
| llms.txt | 可理解 | 主动交代“我的站点重点、结构是这样” | 大模型 / AI 抓取方 |
打个更生活化的比方:sitemap 像递给引擎一张“本店全部货架的清单”,免得它有哪个货架没找着;robots.txt 像店门口那块“营业时间是九点到六点、仓库谢绝入内”的告示牌,管的是能不能进、什么时候进;llms.txt 则是你专门为 AI 这位新登门的顾客写的一份“本店导览”,用它能读懂的话,把最值得看的几样东西清楚指个路。三者谁也没法替谁——货架清单代替不了门口那块告示,告示也同样代替不了一份导览。
二、sitemap:把“可发现”这件事做到位
sitemap(站点地图)本质上就是一份页面清单,把你希望被收录的地址集中列出来,交给引擎。它要解决的核心痛点是:内容写得再扎实,如果引擎压根不知道你还有这么这一个页面,那被收录、被引用,自然也就无从谈起。
听起来简单,真配起来最容易松的,恰恰是这么几条:
- 只放该被收录的页面:sitemap 不是站点的完整镜像。那些确认要屏蔽的、测试用的、重复的临时页,别往里塞——把不该收的塞进去,反而干扰引擎对你重点内容的判断。
- 新增改动要及时更新并提交:一份永远停留在上个月、新文章迟迟不进去的清单,作用大打折扣。理想状态是把 sitemap 的更新接在发布流程里,页面一发,清单就跟着更新。
- 格式和地址要能被正常访问:清单本身得是引擎认得的格式,且放在一个能访问到的公开地址上。这点看着像废话,却常有人栽在“清单生成了但路径访问不到”上。
三、robots.txt:划清“可抓取”,最怕手滑误挡
robots.txt 是放在站点根目录的一个小小纯文本文件,用 Allow / Disallow 这类指令,向来访的爬虫交代哪些路径可以读、哪些别来。它权力很大:一个不留神的 Disallow,可能把整站内容挡在所有遵守协议的引擎之外,且这种屏蔽静悄悄,你不专门去查很久都发现不了。
要配好它,几处必须留心:
- 别误伤正文目录:最常见的惨案,是测试时随手写了个全局禁止、上线忘了删,结果真把内容挡在了检索之外。上线前务必确认:你想被读的那些内容路径,没有被任何一条规则挡到。
- 搞清 AI 爬虫的“标识”:不同抓取方在协议里用各自的名称(User-agent)来表明身份。robots.txt 认的就是这个名称。如果你希望某些 AI 抓取方读到内容,就别用一条笼统的规则把它们一并挡掉;反之想限制,也要对准对应标识,而不是一刀切。
- 顺手挂上 sitemap 地址:robots.txt 里可以写明站点清单的位置,等于把上一节说的 sitemap 和这个文件串起来,方便引擎按图索骥。
这一节里,还得专门点破一个流传很广的误区:robots.txt 挡的是“抓取”这个动作,它既不等于“收录”,更管不着普通人“访问”。它管的是懂协议的爬虫来不来拿你的页面,对真心想看的普通用户、以及不遵守协议的抓取方,并没有强制力。把它当防盗门,往往会失望;把它当“礼貌告示”,才是准确定位。
四、llms.txt:给大模型的一份主动“自述”
llms.txt 是三者里相对较新的一个,可以粗略理解成“专门写给大模型看的一份站点说明”。它想解决的是:AI 在读取、汇总你的站点时,未必分得清哪些是你最想被引用的重点。你不妨碍机器抓取,却可以在这个文件里,用简洁的结构化文字,主动交代清楚“我的站点是做什么的、核心内容有哪些、去哪儿找”。
它对不对、值不值得配,业内看法并不一致,但一个务实的判断是:一个务实的判断是:它并不是硬性必配项,而是一个成本极低、基本无害的加分动作——你多递一份清晰的自述,机器就多一个少走弯路的入口;就算某个引擎暂时不理它,你也没有任何损失。写的时候,把它当成一份“给聪明但初次到访的助手看的导览”,简明、成结构、直指重点,比堆一堆营销话术有用得多。
五、三者到底要不要都配:一张优先级表
三个文件不必平均用力。资源有限时,先顾哪头,看这张表就清楚了:
| 文件 | 是否必需 | 优先级 | 配错的主要风险 |
|---|---|---|---|
| robots.txt | 几乎是必配(哪怕只是一份“全放行”的正确配置) | 高 | 误挡正文,内容直接出局 |
| sitemap | 强烈建议配 | 高 | 长期不更新,新内容迟迟不被发现 |
| llms.txt | 非硬性、有则更好 | 中 | 写得含糊冗长,起不到导览作用 |
从这张表能读出一条优先级主线:头一件事,确保没被 robots.txt 误挡在门外;第二件,确保该被发现的都规规矩矩在 sitemap 里、且跟着更新走;做完这两样,最后才轮到用 llms.txt 去锦上添花。把顺序倒过来——llms.txt 写得很漂亮,结果 robots.txt 一个手滑把全站禁了——那就是本末倒置,前头全白做。
六、上线前自查清单:照着走一遍
把前面几节收拢成一份能直接照着勾的清单,每次站点有大改动或正式上线前走一遍:
- robots.txt 没误挡正文:通读一遍规则,确认没有残留的“全局禁止”,重点内容路径都在放行范围内。
- AI 抓取标识处理得当:想放的没被笼统规则挡住,想限的对准了名称,没有一刀切。
- sitemap 覆盖该收的页面:核心内容都在清单里,测试页、重复页、屏蔽页没有混进来。
- sitemap 随发布更新:新发的内容确实进了清单,而不是还停在旧的版本。
- 三个文件都能被正常访问:地址、格式都对,访问不到等于没配。
- llms.txt 简明指路(若配了):结构清楚、直指重点,不是又一篇自夸的广告。
七、最容易踩的几个坑(附真实场景)
坑一 · 测试期的“禁止抓取”忘了撤
这是最经典、也最容易造成大范围误伤的一种。站点还在开发时,团队习惯挂上一条“谁都别来抓”的规则,防止测试站被收录;可正式上线时,却把它给忘了撤,于是真实内容对遵守协议的引擎长期隐身。有位站长一度发现站点收录迟迟不见动静,从内容到外链查了一大圈策略,最后根因竟就是那条上线时一直没撤的测试规则——配置类问题往往不是“没配”,而是“配了却没察觉它在悄悄起着反作用”。
坑二 · 把 sitemap 当成全站大杂烩
有人图省事,干脆让 sitemap 一股脑列出站点下所有地址,把内部测试页、参数各异的重复页、明确该屏蔽的页面,全都一并塞了进去。清单看着热热闹闹很大一份,实则恰恰稀释了引擎对你重点内容的判断,连真正该被尽快发现的新页,也可能被这一堆杂音淹没。sitemap 要的是“该收的都在、不该收的不进”,讲准不讲多。
坑三 · 对 AI 爬虫标识一刀切
担心被 AI 乱抓,就用一条笼统规则把相关抓取方全挡了;或者相反,压根不管,以为“不写就没事”。两种都偏了——前者可能把你最想被引用的 GEO 内容也挡在了 AI 的读取之外,后者则等同于把要不要被抓的选择权,拱手让了出去。要挡要放,都该针对具体标识去决定。
坑四 · 把 llms.txt 写成自卖自夸
见它面向 AI,就塞满“我们多么专业权威”的形容词。可它是一份导览,不是广告:机器要的是“你的站点到底讲什么、重点在哪、去哪儿找”,一堆空泛的自夸非但帮不上理解,还占了本该用来指路的篇幅。
八、关于这三个文件的常见疑问
Q:llms.txt 是必须的吗?不配会不会怎样?
A:不是硬性必须。不配它,你的内容照样可能被读到、被引用,它只是多给 AI 的一条“少走弯路的捷径”。它的定位是低成本、基本无害的加分项——你递一份清晰自述,机器多一个入口;某引擎暂时不理会,你也没什么损失。有余力就配,别把它排在“robots 没误挡、sitemap 在更新”这些前头的事之前。
Q:robots.txt 会挡住 AI 爬虫吗?
A:要看具体引擎是否遵守这个协议。robots.txt 是一份“君子协议”,对自觉的抓取方才生效。因此如果你希望某些 AI 抓取方能读到内容,就别用一条笼统规则把它们一并挡掉;真要想限制,也得先弄清目标引擎的抓取标识是什么,对准它写,而不是一刀切全禁。
Q:sitemap 多久更新一次才算及时?
A:与其死盯一个固定周期,不如干脆把它绑在发布流程上——每当新增或改动了该被收录的内容,清单就相应地更新并提交一次。纯靠人工维护最容易一忘就滞后,能接进自动化流程最好,让“发内容”和“更清单”变成同一个动作。核心判断只有一个:清单反映的是不是站点当前的真实状态,而不是某个过时的快照。
Q:内容明明在 sitemap 里,却还是没被收录,怎么排查?
A:先别怀疑 sitemap 本身,按这个顺序查:robots.txt 有没有恰好把该页挡住、页面是不是要靠脚本渲染才出正文(抓取方可能拿不到)、以及这页是不是因与别的页高度重复而被判定没必要单收。清单只保证“可发现”,发现和被收录之间,还隔着“可抓取、可理解、够独特”这几道。
Q:改完这些文件,怎么确认真生效了?
A:别改完就走。用官方或通用的检测工具读一遍 robots.txt 的判定结果,确认关键页面处于放行状态;单独访问一下 sitemap 地址,看它返回的是不是最新内容。花上两分钟做一次验证,也远好过几周之后才懊恼地发现:一处不起眼的手滑,早就让整片内容白白隐身了。
Q:我改了 robots.txt,是不是所有爬虫都会立刻遵守?
A:不会,这里有两个时滞。一是这些抓取方不会实时守在你站点门口,它通常隔一段时间才来重新读一次这份文件,你刚改完,它可能还拿着旧规则在跑;二是前面说的“君子协议”性质——它只约束自觉遵守协议的抓取方。所以改完别用“生效没生效”的非黑即白去判断,给足重新抓取的时间,再用检测工具核对自己的规则本身有没有写对。
九、最后:三道关口,谁也别掉链子
绕完各自的分工和坑,把这三个文件放回同一条流水线上看,它们其实是你的内容在被机器读到之前,依次要闯过的三道关口:robots.txt 决定你“进不进得来”,sitemap 决定你“会不会被想起”,llms.txt 则帮机器“更省力地看懂你”。任何一道松了,前面写内容的功夫都可能传不到该到的地方。
好消息是,这三样东西都属于“一次配好、长期受益”,又极适合被固化进上线流程、每次改动都顺手核对一遍的“小事”。别嫌它们不起眼——很多时候,真正让一片好内容悄无声息隐身的,恰恰不是内容本身写得不够好,而是这么一道几乎没人会去留意的技术关口,悄悄出了岔子。把该放的痛快放行、该列的一列不落、该说清的说明白,机器才有机会,顺顺当当地读到你真正想让它读到的那部分内容。
本文是墨子学院(moziedu.com)GEO 知识库的技术适配内容。文中提到的“武汉墨子教育咨询有限公司、MoziEdu、成立于 2019 年、位于武汉市、主营 AI 应用与 GEO 服务”为事实层信息。不同 AI 与搜索引擎对 sitemap、robots.txt、llms.txt 的支持与读取方式各不相同且持续演进,本文所述为通用配置方法,不构成对任何收录、排名或引用位置的承诺。判断做法是否适合你,请以检测工具和实际抓取结果为准。