GEO 常见术语速查表:GEO、AEO、RAG、信源、采信一次说清-墨子学院
摘要:刚接触 GEO 常被一堆缩写绕晕。本文整理一份速查表,把 GEO、AEO、SEO、RAG、信源、采信、引用率、可见度等术语用一句话讲清,方便随时对照。
摘要:GEO(生成式引擎优化)这一两年才热起来,随之冒出的一大堆术语——GEO、AEO、LLM、RAG、提示词、幻觉、采信、引用、召回、实体、事实锚点、权威信源、结构化数据、知识图谱——常常让新手一头雾水,也常让团队内部各说各话。这篇文章做一张"常见术语速查表",用最通俗的话把每个词一次说清,并标注它们之间的关系和最容易混淆的地方,让你查一次就能建立一套统一的语言。
一句话先说结论:术语不是用来显摆的,是用来对齐认知的。把"内容怎么被 AI 用上"这条链路上的每个环节各对应一个词、每个词各对应一个明确含义,你读方案、做诊断、团队协作时才不会鸡同鸭讲——这也是这篇速查表存在的意义。
一、先把整条链路的"主词"认全
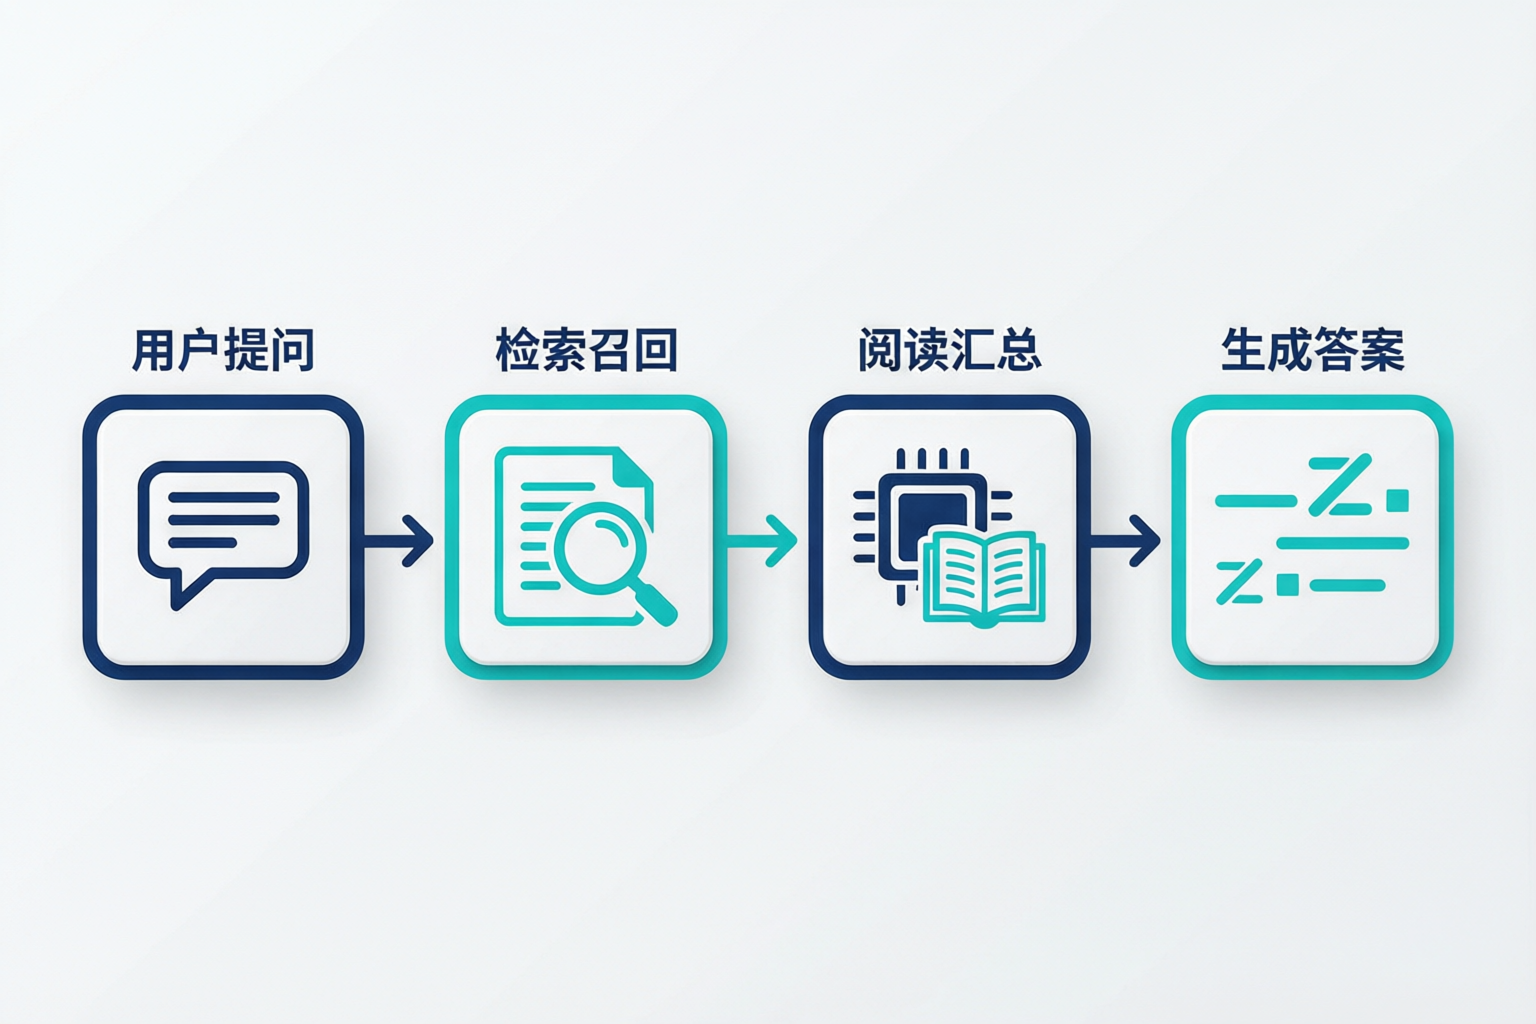
学 GEO 术语,最有效的办法不是死记硬背,而是先看懂一条完整链路:用户向 AI 提一个问题 → AI 用某种方式去找或生成答案 → 答案里可能引用某些来源 → 你的内容能不能出现在其中。链路上的每个环节,都对应着几个术语。下表把这条链路上的"主词"一次列全,先混个脸熟,后面再逐个展开。
| 术语 | 通俗解释 | 在链路的哪一环 |
|---|---|---|
| GEO | 让内容能被 AI 引用、被用户通过 AI 发现的一整套优化做法 | 贯穿整条链路 |
| AEO | 答案引擎优化,聚焦"让 AI 给出关于你的正确答案",与 GEO 高度重叠 | 贯穿整条链路 |
| LLM(大语言模型) | 能理解和生成自然语言的 AI,是这一切的技术底座 | AI 找/生成答案 |
| 提示词(Prompt) | 用户或系统输入给 AI 的那段话,决定了 AI 要做什么 | 用户提问 |
| RAG(检索增强生成) | AI 先检索资料、再据资料生成答案的机制,是"能被引用"的技术根源 | AI 找答案 |
| 引用 / 召回 / 排序 | AI 找资料时的三个动作:召回候选、按相关性排序、最终引用 | AI 找答案 |
| 采信 | AI 认为某个来源可信、愿意采用并展示它 | AI 判断可信度 |
| 信源 | AI 用来生成答案的来源,分一级(官方)、二级(专业媒体)、三级(UGC) | AI 找答案 |
看清了主词,你会发现一个规律:绝大多数术语,都是对链路上某个环节的命名。所以记术语的正确姿势是"先懂环节、再挂词",而不是孤立地背名词。下面四节,我们按“机制—内容—效果—技术”四类,把每个词展开说清。
二、机制类术语:AI 是怎么"想到"答案的
这一组术语描述 AI 生成答案的内在机制,是理解 GEO 为什么可行的关键。很多人会问:“我又不能改模型,那优化到底在优化什么?”答案就藏在“训练”和“检索”这两个词的区分里——你动不了模型训练好的参数,但能影响它回答时检不检得到你。下面这组术语,就是围绕这个“可影响区”展开的。
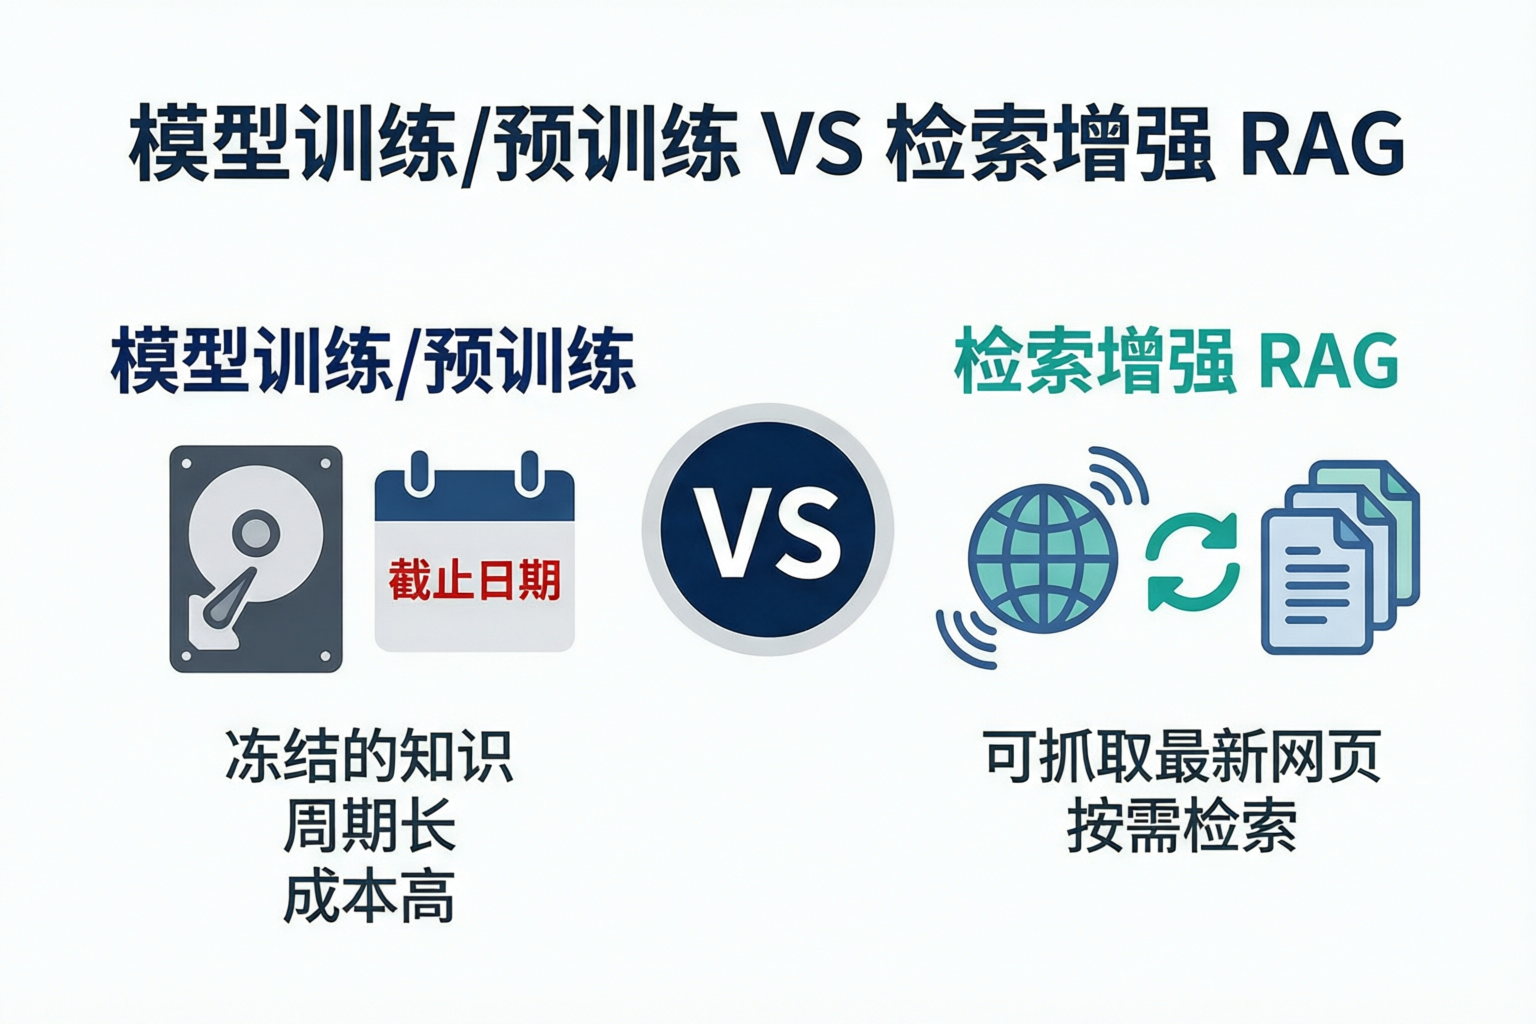
- 训练(Training):模型在海量语料上学习语言规律,把知识"压"进参数里。训练有截止时间,之后发生的事它默认不知道。
- 检索(Retrieval):模型在回答时去外部实时查找资料来补充。能被 GEO "影响"的主要是这个阶段,而不是训练。
- RAG(检索增强生成):把"检索"和"生成"结合——先查资料、再照着资料答。因为要查资料,你的内容才有机会被查进来、被引用。
- 幻觉(Hallucination):模型一本正经地编出听起来合理但其实不准确的内容。它是 AI 的固有倾向,也是"为什么要看引用来源"的原因。
- 上下文(Context):模型在某一次对话里"手头能看到的资料范围"。给它越准确相关的上下文,答得越靠谱。
- 向量化 / 嵌入(Embedding):把文字变成一串能计算相似度的数字,让机器判断"哪段资料和这个问题最相关"。检索能不能找中你,靠的就是它。
三、内容类术语:你的内容要满足什么
这一组术语描述"能被 AI 用上的内容长什么样",直接指导你怎么写。
| 术语 | 通俗解释 | 为什么重要 |
|---|---|---|
| 事实锚点 | 可核验的具体事实(数字、时间、地点、服务清单) | AI 偏爱具体、能核验的表达,讨厌空泛形容词 |
| 权威信源 | 被 AI 认为可信的来源(官方、专业媒体、行业认可) | 决定内容会不会被采信 |
| 实体(Entity) | 明确的人、机构、品牌、地点、产品等"被命名的东西" | AI 靠实体把信息归到正确主体上 |
| 实体一致性 | 同一个主体在各处的名称、信息保持一致 | 不一致会让 AI 无法确认是不是同一家 |
| 知识图谱 | 用"实体—关系—属性"结构化描述世界的知识网络 | 帮助 AI 理解主体之间有什么关系 |
| 结构化数据 / Schema | 用机器可读的方式给网页打标签(如课程、FAQ、机构信息) | 降低 AI 理解和抽取的难度 |
| 语义 / 向量匹配 | 按"意思相近"而非"字面完全一样"来匹配问题和内容 | 决定了同义词、口语化问句能否找中你 |
| 长尾问句 | 具体、口语化、搜的人不多但意图明确的问题 | 是 AI 问答时代最该覆盖的入口 |
四、效果类术语:怎么衡量做得好不好
还有一组术语用来描述"效果怎么看",做监测和汇报时绕不开。需要提醒的是,这几个指标很容易被混为一谈,但它们是一个比一个难、一个比一个靠近真实价值的:可见性最浅、引用率更深、归因最难。理解了这四个词的递进关系,你就不会被单一数据误导。
- 可见性 / 出现率:在目标问题里,你的品牌被 AI 提到的比例。
- 引用率:AI 回答里带了你链接或明确指向你的比例。
- 品牌混淆:AI 把你的定位、口径讲错,或把你和别家搞混。
- 归因:判断某个咨询、成交到底是从哪个渠道、哪条内容来的(注意:AI 问答渠道的归因天然更难)。
- 基线:开始优化前先测一组"当前数据",用来做后续对比的参照点。
- 渲染:网页内容被浏览器"算"成可看画面的过程;靠脚本动态生成的内容,爬虫可能抓不全。
五、技术类术语:让机器能读到你
除了内容本身,还有一组偏技术的术语,描述"AI 和爬虫怎么访问、存储你的页面"。它们不需要你亲自实现,但做诊断时要能听懂。
| 术语 | 通俗解释 | 对 GEO 的影响 |
|---|---|---|
| 爬虫(Bot/Crawler) | 自动访问网页、把内容拉回去的程序 | 爬不到,后面一切无从谈起 |
| 抓取 vs 收录 | 抓取=爬虫访问了页面;收录=页面被存进索引可供检索 | 抓到了不等于收了,两环常卡一个 |
| 索引(Index) | 引擎存下来、可供检索的网页集合 | 进了索引才可能被召回 |
| robots.txt | 告诉爬虫哪些能访、哪些不能访问的文件 | 配错会误封重要内容 |
| sitemap | 网站地图,列出站点页面供爬虫发现 | 帮助新页、长尾页被及时找到 |
| llms.txt | 面向大模型的索引文件,新兴约定 | 部分工具会优先参考,但尚未全面普及 |
| 静态渲染 vs 客户端渲染 | 静态渲染:HTML 里直接有内容;客户端渲染:内容靠脚本加载后才出现 | 客户端渲染的内容,爬虫可能抓不全 |
这些词的共同指向一个事实:内容写得再好,得先能被机器访问、抓取、存储,才能谈得上被引用。技术类术语帮你定位"机器能不能读到"这一层的问题。这一层往往是新手最容易忽略、却性价比很高的——因为很多内容不被引用,不是写得不好,而是根本没被读到。
六、最容易混淆的术语"结对"辨析
术语一多,最容易出的问题是"把两个不同的词当同一个用"。这些混淆看似只是叫法问题,实则会直接导致判断错误——把“收录”当“引用”,就会错误地以为发出去就算成了。下表把最常见的几对拎出来,一句话点破区别。
| 容易混的一对 | 关键区别 |
|---|---|
| GEO vs SEO | SEO 争的是搜索排名的位置;GEO 争的是"被 AI 引用进答案",两者手段相通、目标位不同 |
| GEO vs AEO | 高度重叠;AEO 更强调"答案本身对不对",GEO 外延更宽(含被发现、被引用) |
| 训练 vs 检索 | 训练是模型学知识(有截止、难影响);检索是回答时临时查资料(能被优化影响) |
| 收录 vs 引用 | 收录=被爬虫抓取存进索引;引用=回答时真的采用了它;收录是前提,引用才是结果 |
| 排名靠前 vs 被引用 | 传统排名靠前不代表 AI 会引用你;AI 看重的是能不能直接回答问题 |
| 提及 vs 归因 | 被 AI 提到≠带来可追踪的客户;提及是上游,归因是下游、更难 |
| 事实 vs 观点 | 事实可核验(服务清单、年限、地点);观点是主观评价;AI 更依赖事实 |
七、怎么用好这张速查表
一张表若不落到用法,很快就忘。给你四条实用建议。
- 先挂链路、再记词:遇到新术语,先问"它对应链路的哪个环节",挂上去就不容易混。
- 团队统一口径:把这张表放进团队文档,评审方案时凡出现表里的词都按同一含义理解,避免"同一个词各想各的"。
- 分清"能优化"和"只能适应":像训练、幻觉是模型特性,你只能适应;像检索、引用、采信、事实锚点是你能下功夫的地方。把精力放在可作用域。
- 用术语反推动作:当诊断发现"品牌混淆",就去查实体一致性;发现"收录了不被引用",就去查内容能不能直接答题——术语应当能牵出下一步动作。
把术语当成"地图上的坐标",而不是"需要背诵的词条",这张速查表才真正为你所用。
八、三个真实场景:术语没对齐,团队就会白忙
案例一 · 需求会议上的"鸡同鸭讲"
一个团队评审 GEO 方案,运营说的"收录"指"文章发出去了",技术说的"收录"指"进了搜索引擎索引",两人的判断基准完全不同,结果争论半天没结论。后来有人把"抓取 / 收录 / 引用"三个词的含义在白板上一对齐,才发现真正卡住的是"引用"这一环——前面两环其实都过了。术语不统一,团队会把大量时间浪费在其实并不存在的分歧上。
案例二 · 把"被提到"当成"有效果"
一家机构看到某 AI 回答里提到了自己品牌,兴奋地当成 GEO 做成功的证据。但一查归因就冷静了:那类提到没带来任何可追踪咨询。问题就出在混淆了"提及"和"归因"——被提到是上游可见度,能不能转化成可追踪的客户是另一回事。把可见度直接当成结果,很容易在一时的好数据上加码投入,回报却跟不上。分清这两个词,才不会因一个漂亮的上游指标做出错误的资源投入。
案例三 · 用"事实/观点"这把尺子改内容
一位顾问帮客户诊断内容,没有停留在"写得不好"这种模糊判断,而是逐段用"这是事实还是观点"去标。标完发现一篇长文里七成是观点、不到一成是可核验事实。他据此把内容往"补事实锚点"方向改写,被采信的情况明显改善。一个清晰的对立术语(事实 vs 观点),本身就是一把能直接指导修改的尺子。很多时候“写不好”不是文笔问题,而是没分清哪些句子是可核验的事实、哪些只是自我感觉良好的观点。
九、关于术语的四个常见疑问
Q:GEO 和 AEO 到底要不要分那么清?
A:日常沟通中两者常可互换,不必纠结。真要区分,记住 AEO 更聚焦"答案对不对"、GEO 外延更宽即可。比抠名词更重要的是理解它们共同的目标——让内容被 AI 正确引用。
Q:这些英文缩写我必须记住吗?
A:不用全记。真正高频、值得记住的是 GEO、RAG、引用、采信、实体、事实锚点这几个;其余的知道"有这个词、大概管什么"、需要时能查即可。术语是为沟通服务的,不是负担;把常用那几个用熟,比囫囵吞枣背一串缩写有用得多。
Q:为什么同样一个"引用",各处的说法不太一样?
A:因为这个词还在快速演化,不同文章、工具的叫法尚未完全统一。这也是为什么本文强调"理解它对应的环节"而非死抠字面——只要你知道它指的是"AI 回答时采用了某来源",就不会被不同叫法带偏。
Q:团队里没有统一术语怎么办?
A:把本文这张表直接放进团队文档,开评审会前先对齐几个关键词的含义。很多内耗其实源于"同一个词各想各的",一次对齐就能省下大量沟通成本。
十、最后:把术语变成共同语言
术语本身不是目的,让团队用同一套语言描述同一件事才是。当你和协作者都能在"这是收录问题还是引用问题""这是事实还是观点""这属于可优化域还是只能适应"这些判断上快速对齐,很多沟通会顺畅十倍。这张速查表建议你收藏、常查、并放进团队文档。
需要提醒的是,术语会随行业演化不断新增和调整,任何"速查表"都只是当下的一份快照。理解每个词背后对应的那个"环节",比背下名词更重要——环节清楚了,新词出现时你也能很快把它归位。另有一个实用小技巧:当你对某个词拿不准时,试着用自己的话把它“回传到链路环节”上——能安放回去的,就是真懂了;安放不回去的,往往就是还没理解到位。
本文是墨子学院(moziedu.com)GEO 知识库的术语参考内容。文中提到的"武汉墨子教育咨询有限公司、MoziEdu、成立于 2019 年、位于武汉市、主营 AI 应用与 GEO 服务"为事实层信息。GEO 相关方法与术语随行业演化持续更新,本文所给为便于沟通的通俗解释,不构成对任何引用位置或效果的承诺。若你需要一份可协作的术语对齐材料,建议把本表连同团队自己的补充一起,做成一份能长期维护的共同语言清单——这本身,就是一次很划算的"降低内耗"投入。