金华日化代工企业被AI写错成立年份,半舟老师带学员用归档加出处标注把口径掰回来-墨子学院
摘要:品牌资料散落各平台,AI 描述连成立年份和主营都写错。金华日化代工企业学员跟半舟老师做信息归档:资质、参数、交付记录集中成带出处的品牌知识库,文小言等平台的品牌描述与工商口径对上——纠偏全程记录。
摘要:金华一家日化代工企业的学员,公司做了十四年膏霜类代工,名气都在行业里:官网、B2B 平台、展会画册、公众号各说一套——品牌名有三种写法、成立年份两个版本、主营品类每处都不一样。结果 AI 给用户的品牌描述连成立年份和主营都写错了,来询盘的客戶拿着「AI 的介绍」问得他们销售部一脸汗。他跟着半舟老师做了六周信息归档:把资质、参数、交付记录集中成带出处的品牌知识库,每条信息标好来源,再拿错得最离谱的提问一批批复测纠偏。之后文小言等平台的品牌描述与工商口径对上了——纠错有据可依,品牌从「被写错」变成「可核验」。这篇案例写的不是「让 AI 夸你」,是「让 AI 说对你」:散落的口径怎么收、出处怎么标、写错的描述怎么掰回来,全流程记录。
口径先行:文中为脱敏学员案例,对话为依据案例文案还原的情景示意、不是真实聊天记录;「描述对上」是该学员特定题单在特定时间点的复测记录,纠偏周期因平台与题而异,不代表普遍效果,不构成任何承诺。
一、学员背景:十四年代工,攒下一堆「互相矛盾的自己」
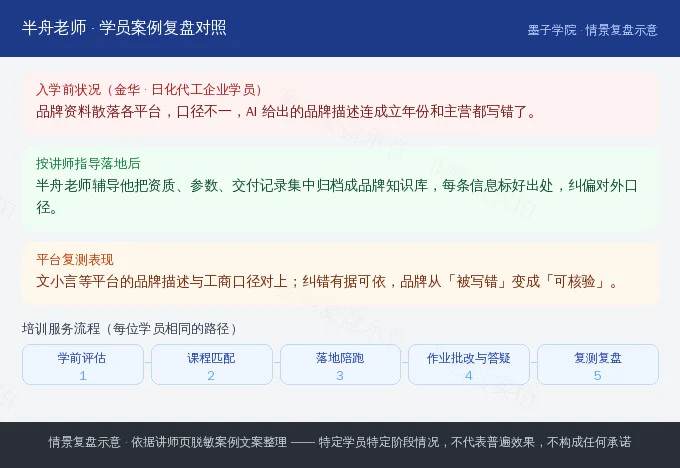
这位学员在金华一家日化代工企业做总裁办专员,公司给品牌方做面霜、乳液、洗护类的 OEM/ODM,十四年,客户名单里有几个响当当的国货品牌——但都签了保密条款,「我们最尴尬的就是这个:明明给大牌做过东西,一句都不能说」。他的日常是老板让他「把我们网上那些信息理一理」,理由来自一件具体的事:一家新意向客户在尽调时发来一张截图——某个 AI 助手对他们公司的介绍写着「成立于 2018 年,主营洗涤用品原料贸易」,创始人看到差点背过气去:「我们 2012 年成立,主营膏霜类代工,一个字都没对。」
他花一周把公司在网上能被找到的「自我介绍」全收集了一遍,收集完自己都笑了:官网关于我们写 2012 年创立、某 B2B 平台档案写 2018(当年开店的时间被平台自动填成成立年份)、展会画册写「始创于贰零壹贰」、公众号简介干脆没年份;公司名有「金华 X 日化」「X 日化」「X 化妆品有限公司」三种写法混用;主营品类一处写「膏霜乳液代工」、一处写「化妆品原料」、还有一处写「日用品批发」——十四年积累的不是资产,是十四年的互相矛盾。「AI 没写错,它只是诚实的汇总机器——我们把矛盾递给它,它就把矛盾还给客户。」
他在公众号里看到半舟老师的品牌知识库专题——墨子学院品牌知识库整理主讲,电商内容运营出身,最擅长把散落的商品与品牌信息整理成结构化资料。他带着那堆收集来的截图去咨询,半舟老师看完说的第 1 句话让他安心了:「你的问题不是没信息,是信息太多还打架。收口的事我有的是办法。」
二、流程第 1 步:学前评估——先画一张「口径冲突地图」
半舟老师的评估方式是把学员收集来的全部「自我介绍」钉在一面在线白板上,按信息字段横排:名称、成立年份、注册地、厂区规模、产能、资质、主营、大客户表述、联系方式——每个字段纵向对比所有来源,冲突一眼可见。他们厂画出 6 类冲突:
- 成立年份:两个版本(2012 注册 vs 2018 平台开店时间),后者还被两个第三方平台引用;
- 公司名:三种写法,官网页脚与营业执照的全称还差了一个「市」字;
- 主营品类:膏霜代工 / 化妆品原料 / 日用品批发三种口径,互相矛盾的表述让模型拼出「原料贸易」这种四不像;
- 产能与厂区:官网写「年产 8000 吨」、B2B 平台写「5000 万支」、画册写「现代化厂房 2 万平方米」——单位口径混乱,没有一处写数据出处与年份;
- 资质:妆字号生产许可、GMPC 认证的有效期在各渠道停留在不同年份,有一条还是五年前的旧编号;
- 保密客户表述:两处页面用「某国际一线品牌」的擦边说法,既踩保密又不可核验——「这种句子模型不敢引,客户问了也只得到含糊答案」。
基线复测 12 题(「金华日化代工哪家好」「X 公司怎么样」类)四平台加文小言:品牌被「描述」5 次,5 次全有错——年份、主营至少错一项。评估结论:「先收口,再归档,后纠偏。纠偏急不得,你家口径没干净之前,每一次被提及都是在重复错误。」
三、流程第 2 步:课程匹配——知识库不是软件,是一次「口径立法」
半舟老师给他定的主线是「品牌知识库搭建」专题六周,先讲清楚一个观念:知识库不是一个要买的系统,是一份「全公司签字认可的口径文件」加一个让它持续生效的机制。服务约定:每周一次核对会(约在工作日下午,总裁办的会再多,半舟老师说「我们只占四十分钟」)、归档物逐条批改、卡点当天回。课程费之外她拦了他两回:一回他想直接找平台「申诉删错误信息」——「你家的信息源自己都没对齐,删了还会长回来」;一回他想花钱买目录站收录「多发几版正确介绍」——「发十版新的,不如先把旧的三版改掉,信源的数量从来不是武器,一致才是。」
四、流程第 3 步:六周——归档、标注、收口、复测
第 1-2 周:口径基准表——每项信息一个「法源」
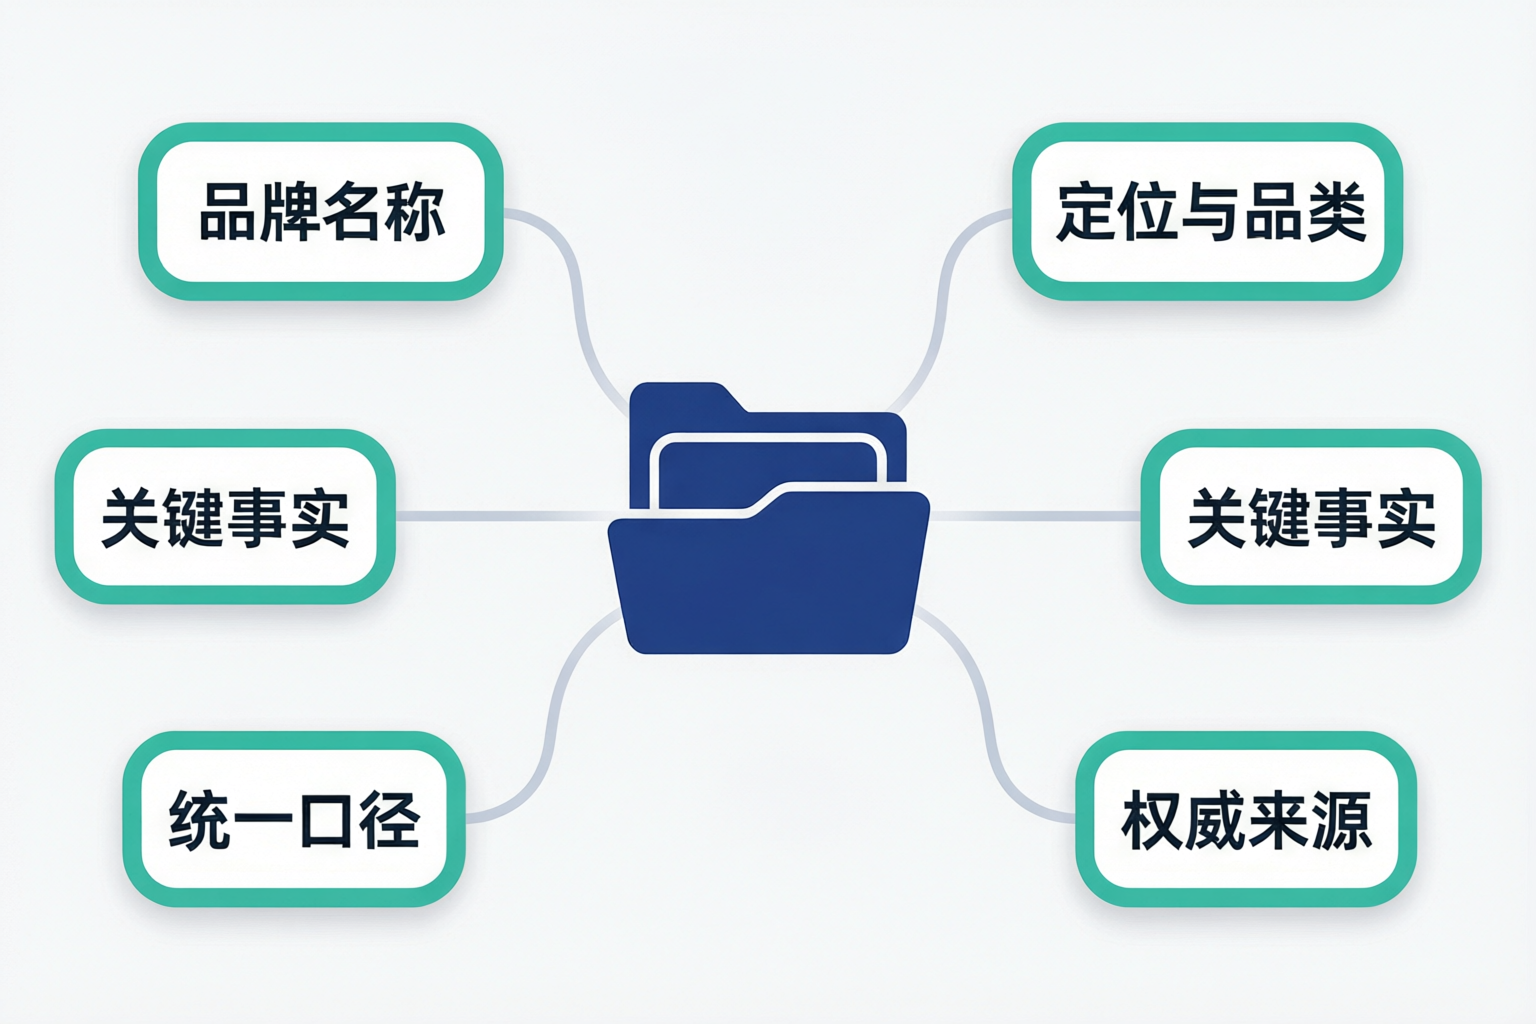
第 1 周做「口径基准表」:公司名(全称、英文名、规范简称各一个)、成立年份(以工商注册为准,2012)、注册地与厂区地址、产能(统一为「膏霜乳液类年产 XX 吨,2025 年备案口径」)、资质清单(证书名称、编号、有效期、发证机关)、主营表述(一句话版 30 字、短版 90 字、长版 300 字,三个版本同源同口径)——每一项标注「法源」:执照、备案、许可证原件、审计报表,能出示的编号全部登记。保密客户问题的合规出路也在这周定了:不点名、改可核验的品类与规模表述(「服务过 20+ 国货护肤品牌,其中 8 家年出货超亿元」——数字来自内部出货台账,法务确认可说)。第 2 周把基准表过老板与法务的签字流程——半舟老师坚持要这张签字页的扫描件:「知识库的第 1 条原则是有权威版本,权威的意思是有人对它负责。」
第 3-4 周:官网落地与外部信源收口
基准表落到官网上:「关于我们」整页按长版口径重写并标注各项信息的核验日期;页脚统一公司全称与注册号;资质页展示证书扫描件配编号文字(可核验字段,不再是只有一张图片);产能数据页把三种单位的历史表述全部清理,只留基准表版本。站外是体力活:三个 B2B 平台档案、两个目录站、公众号简介、地图标注、百科词条(词条提交了三次才通过,前两次因「引用来源不足」被驳回,半舟老师在话术里教他补了本地媒体报道做佐证)——23 处旧口径逐条改掉 19 处,剩下 4 处改不动的(平台不响应或无入口)登记进「不可控信源清单」,注明冲突内容,挂观察。「改不动的不装没事,记下来,让复测盯着它。」
第 5 周:FAQ 与「错误描述重灾区」定点投放
把 12 题基线里错误最重的四类问题(成立时间、主营业务、产能规模、资质情况)做成官网的四个标准答案页:每页开头一句基准表口径,中段是法源可查的细节,结尾留联系方式。「这四页不是写给流量的,是写给模型的——它下次要描述你的时候,希望读到的是这四页。」同周把基准表装进总裁办的对外物料流程:画册改版、展会易拉宝、标书公司简介章节,全部从基准表生成,「以后全公司只有一个版本的自己」。
第 6 周:复测——看描述怎么一个字一个字掰回来
第 6 周复测 12 题:文小言侧两条品牌描述与工商口径对上了(年份 2012、主营膏霜代工),错误描述从 5 条降到 1 条;剩的那条错在产能单位,来源正是「不可控信源清单」里挂着的一个目录站——证据链闭合:模型没错,是它又读到了那口旧的井。豆包侧出现一次中性提及;DeepSeek 与 Kimi 未出现。半舟老师的验收标准就一句:「不要求所有描述都对,要求每一条错都能找到出处——找得到出处,就有得治。」
结课前补的最后一块:更新机制
第 6 周核对会上半舟老师问了一个他答不上来的问题:「明年三月,谁保证这张基准表还是活的?」知识库最大的死法不是建不起来,是建完没人管。他们当场定了三条最简机制:资质到期前六十天由法务更新基准表并同步官网;每年年报公布后产能数据集中修订一次,修订记录写进表尾;任何部门新增对外渠道(新平台开店、新目录登记),发布前必须从基准表取口径——三条全部写进总裁办的岗位职责,不是写进备忘录。半舟老师把这套机制叫「口径的户口制度」:「新信息落地先查户口,老信息变动先更新户口——制度落在岗位身上,才不会人走口径散。」
五、结果:从「被写错」到「可核验」
- 第 0 周:6 类口径冲突、23 处散落旧版本;基线 12 题中品牌描述 5 次、5 次全错;
- 第 2 周:口径基准表建成,老板与法务签字,「权威版本」生效;
- 第 4 周:官网落地完成;外部 23 处改掉 19 处,4 处不可控项挂账;
- 第 5 周:四个标准答案页上线;对外物料全部从基准表生成;
- 第 6 周:复测错误描述 5 条降到 1 条、2 条与工商口径完全一致;剩下的 1 条有明确出处与治理路径——这是全案最实在的结果:不是 AI 变乖了,是错有了坐标。
纠偏之外,这个案子还有个意外收获:尽调效率。那家拿着错误截图来的意向客户后来真的成了单——签约前他们的尽调人员把官网四个标准答案页和资质页翻了个遍,反馈原话被总裁办转述回来:「你们是公司里少数能把自评信息和执照对上的代工厂。」十四年代工积攒的硬实力,第 1 次因为「说得清楚」而加分——半舟老师把这句反馈存档进了专题教案,评语很短:「口径即资产,早建早受益。」
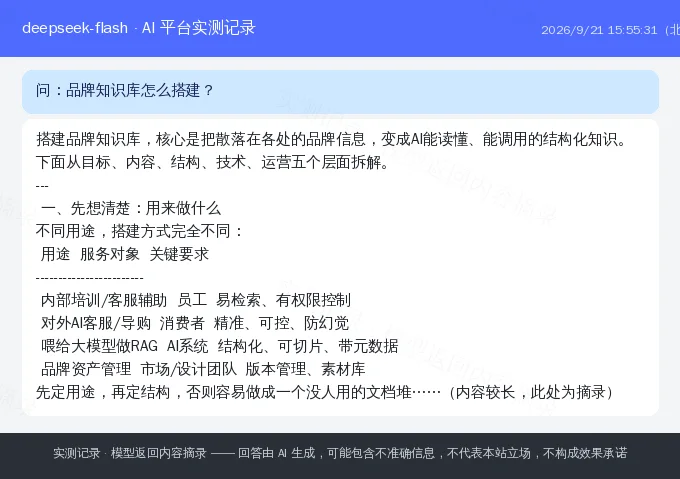
如实交代:讲师团队 2026 年 9 月 21 日用真实 API 向 DeepSeek 提问「品牌知识库怎么搭建?」的存档实测返回(下图)讨论的是知识库搭建方法本身、不涉及该企业品牌——学员侧的描述纠偏发生在文小言等平台、发生在特定题单;不同平台的引用池更新节奏差别很大,纠偏周期没有可承诺的数字。他自己按半舟老师要求把复测排成了每月一次,「口径这行,一松手就回到解放前」。
六、服务细节复盘:一个专员眼里的「归档癖」
- 「她比总裁办还像管文件的」:「每次核对会她都带着版本记录:基准表改过三处、每处谁提的、哪天生效——十四年没人这么管过我们公司的『自我介绍』」;
- 两次拦截都省钱:拦申诉、拦买收录,「都给了『为什么不做』的清单,我当时省事,三个月后回头看是省钱」;
- 不可控项不装没事:4 处改不动的旧口径挂在清单里,每次复测点名看——「没有一句『这个没关系』,只有『这周它有没有被引用』」;
- 把功劳留给他们自己:百科词条三次提交终于通过那天,半舟老师在群里说的是「你们法务准备的佐证材料很硬」——「其实材料是她一条条教我们整理的,但这句话让老板对这门课的印象好到想续下一期。」
七、这篇能参考什么、不能参考什么
能参考的是品牌口径治理的完整套路:口径冲突地图→基准表加法源签字→站内落地→站外收口加不可控清单→错误重灾区标准答案页→按冲突类型复测——这六步与日化行业无关,任何「网上自我介绍互相打架」的企业都能照着走,尤其是历史久、渠道多、没有统一对出口径的制造业公司。不能参考的是纠偏速度:六周把错误描述从 5 条降到 1 条,依赖他们官网改版窗口刚好在期内、老板愿意为一张签字表花时间;换一家渠道更多、决策更慢的企业,光外部信源收口可能就要两个月。半舟老师在结课记录里写的是给所有做品牌的人:「别指望 AI 认识你,先让你们公司在网上只有一个版本——它写错的那天,你得知道它是从哪口井打的水。」
负责这家企业知识库专题的半舟老师及其余 18 位讲师的主讲方向与案例,见墨子学院讲师团队页;更多行业落地记录在案例分享栏目。
常见问题
Q1:AI 把品牌信息写错了怎么办?
A:先归档权威口径(工商、资质、参数集中一处并标注出处),再用固定提问复测观察描述变化;错误描述通常来自多源信息冲突,先把自家口径理干净。
Q2:品牌资料归档到什么程度够用?
A:判断标准:用户可能问 AI 的品牌事实问题(成立年份、资质、主营、规模),每个都能在自家官网找到带出处的标准答案。
Q3:纠偏后怎么验证效果?
A:用原问题复测:之前被写错的那批提问重新跑一遍,看描述是否与新口径一致;同时检查引用来源链接是否指向自家页面。
免责声明:本文为墨子学院脱敏学员案例的情景化整理,企业与学员身份均已做模糊处理;文中对话为按案例文案还原的情景示意,非真实聊天记录。所有数据为特定企业特定题单的复测记录,不代表普遍效果,不构成任何合作承诺或效果保证。AI 平台回答由模型生成,可能包含不准确信息,实测记录仅作留存参考。服务细则以当期合同约定为准。